模型更新
GPT-6 評測:發布日期、獨立測試與選用結論
GPT-6 已經發布,但並非所有任務都值得立即升級。 OpenAI 於 2026 年 9 月 3 日發布 GPT-6 Astra。發布首周的獨立測試表明,它在複雜且相互關聯的工作上確有進步,但也存在延遲高、費用貴、一般提示詞收益不穩定的問題。API 模型識別碼為 gpt-6-astra。
我們的判斷是:Astra 更適合長流程、強關聯任務中的高難度工作,不適合作為日常對話或批次產生的預設選擇。 當一個模型需要理解大型系統、跨工具操作、同時遵守多個約束,並交付出錯代價很高的結果時,它的優勢最明顯。對於邊界清晰的任務,GPT-5.6 級別的模型仍更經濟。
來源: 發布公告; 模型文件; 開發者指南; 安全概覽; 可用性指南; Artificial Analysis; 源自實際專案任務的程式開發對比; API 實測; Axios 報道; 安全專家評論。核對日期:2026 年 9 月 7 日。
快速解答
| 問題 | 截至 2026 年 9 月 7 日的答案 |
|---|---|
| GPT-6 發布了嗎? | 是。OpenAI 於 2026 年 9 月 3 日發布 GPT-6 Astra。 |
| API 模型識別碼是什麼? | gpt-6-astra |
| ChatGPT 可以使用 GPT-6 嗎? | GPT-6 Pro 正陸續向符合條件的 Pro、Business 和 Enterprise 方案開放,具體取決於產品及工作區設定。 |
| Codex 和 ChatGPT Work 可以使用嗎? | 正在陸續開放。OpenAI 表示 Plus 包含 Work 和 Codex 中的存取權限,Chat 的存取規則有所不同。 |
| API 如何收費? | Standard 模式每百萬輸入 token 10 美元、每百萬輸出 token 50 美元;快取讀取和寫入另有費率。 |
| 上下文視窗有多大? | 1,050,000 token,最多輸出 128,000 token。 |
| 現在應遷移所有任務嗎? | 不應。先做任務級評估,只遷移收益足以覆蓋新增成本和執行風險的工作。 |
獨立測試說明瞭什麼
早期外部證據比發布時的宣傳更克制。它們佐證了能力提升,但不能證明 Astra 在所有任務上都勝出,或預設就是成本效益最高的選擇。
| 外部測試 | 結果 | 實際意義 |
|---|---|---|
| Artificial Analysis Intelligence Index | 目前快照中 Astra max 得分 55,在 202 個模型中排名第 3 | 屬於第一梯隊,但並非毫無爭議的第一名 |
| Artificial Analysis 速度 | 每秒輸出 64.3 token,在 202 個模型中排名第 93 | 低於對比組中位數,也慢於同一平台中的 GPT-5.6 Sol max |
| Artificial Analysis 每項指數任務成本 | Astra max 為 2.57 美元,Sol max 為 1.25 美元 | 指數提高 4 分,但每項測試任務的成本約翻倍 |
| ComputingForGeeks 除錯測試 | Astra、Sol、Terra 和 Luna 找到了相同的三個根因 | Astra 的優勢是更好的限制說明和驗證步驟,而非不同的診斷 |
| 源自實際專案任務的程式開發對比 | Astra 和 Terra 都通過了現有測試,只有 Astra 保留了關聯分頁狀態並增加相應測試 | 測試全綠仍可能掩蓋行為契約錯誤;Astra 在這一個任務中展現了更好的跨元件推理 |
Artificial Analysis 還測得,Astra 在 max 推理強度下首次輸出 token 的等待時間約為 355 秒。這是極端設定,並非一般對話的預期體驗,但它強化了一條實用原則:最高推理強度應按需用於研究,而不應預設開啓。
源自實際專案任務的程式開發測試尤其值得參考。兩個 AI 代理都通過 712 個測試檔案,但 Terra 的實作仍在一次互動中遺失了另一分頁控制項的狀態;Astra 保留了兩個狀態,並專門測試了二者的關係。這表明可在強關聯實作任務中評估 Astra,但它仍只是廠商公布的一個案例,不代表普遍勝率。
實際體驗文章發現了什麼
Claire Vo 9 月 3 日的提前體驗評測列出了具體任務:此前模型難以完成的 ChatPRD 功能、瀏覽器 QA、硬體整合以及 3D 工作。節目頁面提供了演示時間戳。這是一位有經驗的開發者對部分成功案例的介紹,並說明瞭提前體驗背景,但沒有提供重複試驗或平均失敗率。它最有價值的地方,是為讀者設計自己的對比測試提供真實任務。
Matt Shumer 9 月 3 日的評測對日常使用的態度比我們偏重成本的建議更積極:他把 Astra 作為預設模型,肯定其後端工程能力和易於理解的進度彙報。他也指出,其視覺效果遜於 Claude、回應較慢,一些宏大專案會停止取得有效進展。他的大型演示依賴大量協調和現有素材。理解所謂“一條提示詞啓動的專案”時,這些前提很重要。
這些評測者的體驗,與部分早期社區使用者對意圖理解和任務範圍的抱怨並不一致。現有證據建議使用自己的任務測試這些行為,但無法證明哪一種體驗具有代表性。
ComputingForGeeks 通過在線 API,讓四個 OpenAI 模型處理同一條除錯提示詞。四者都識別出了相同的三個原因。Astra 所需時間 75.5 秒,成本約 0.194 美元;Sol 所需時間 39.3 秒,成本約 0.048 美元。評測者認為 Astra 補充的限制說明有助於避免過度泛化的診斷,但一般確認類問題不足以證明這筆溢價合理。
這個結果改變了購買時應問的問題。Astra 不必給出完全不同的答案才有價值;在高風險故障中,遺漏一條限制說明就可能造成影響。但如果所有正確答案最終都指向同一個行動,更便宜的模型就更合適。
早期社區回饋有好有壞。一位資深 Codex 使用者回饋,模型有巧妙解法,但對範圍的判斷較弱,甚至在確定方向前提出不必要的基礎設施方案。另一位開發者認為 Astra 能力強卻容易過度設計簡單任務。也有使用者表示困難儲存庫任務的完成速度明顯加快。這些非受控體驗受提示詞、儲存庫、產品限制和預期影響,更適合用來發現待測的失敗模式,而非得出可靠的滿意度評分。
一份詳細社區報告稱,8 個工作階段中的 12 輪普通儲存庫任務執行較長時間後,被網路安全策略標記並中止。該報告未經獨立驗證,但與 OpenAI 關於額外防護可能暫停或停止正常工作的提醒一致。評估 Astra 的團隊應將執行後期的策略中止納入可靠性和成本指標。
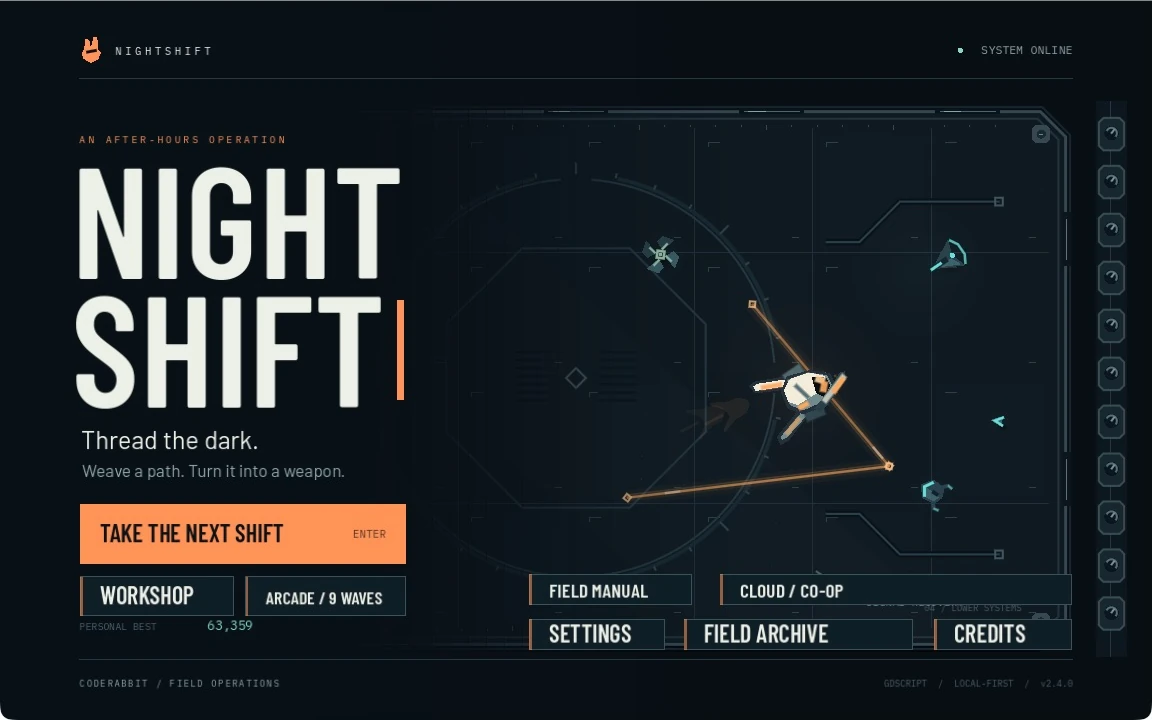
CodeRabbit 展示的 NIGHTSHIFT:在人類指導與反覆迭代下,使用 GPT-6 製作的遊戲。
GPT-6 Astra 有哪些變化
長上下文更實用
模型頁面列出 1,050,000 token 的上下文視窗,以及 128,000 token 的最大輸出。OpenAI 報告,在 512K 至 1M 區間的 MRCR v2 八針測試中,Astra 得分為 96.3%,GPT-5.6 Sol 為 73.8%。窗口大並不意味著應把所有檔案都發送給模型。檢索品質、來源日期、衝突處理和審核可見性仍由應用負責。
電腦操作更接近實際工作
OpenAI 報告,Astra 在 OSWorld 2.0 離線集上得分 72.6%,GPT-5.6 Sol 為 65.7%。在該公司的延遲模擬中,Astra 完成任務約需 40 分鐘,而非 75 分鐘。公告展示的用途包括更新記錄、填寫表單、操作試算表、製作文件和檢查網站。
正確的解讀是“更多任務在技術上可行”,而非“已經能安全自治”。系統仍需要細緻的權限、操作預覽、重要變更確認、冪等處理以及可用於復原的審計記錄。AI Agent 安全檢查清單更詳細地介紹了這些邊界。
開發者可以在執行中調整方向
GPT-6 Astra 在 Responses API 中增加了非同步工具呼叫和回合內引導。慢速工具執行時,應用程式可以繼續獨立工作,再透過呼叫 ID 回傳結果。使用者也可以在 WebSocket 工作階段中發出修正,而不丟棄已完成工作。這些能力有利於長任務,但應用必須跟蹤待處理呼叫、取消、逾時和延遲回傳的結果。
無須重建提示詞即可調整推理
API 支援 low、medium、high、xhigh 和 max 推理強度。工作階段可以通過設定更新調整強度,同時保留已快取的提示詞前綴。Astra 不支援 none 推理設定。
安全表現改善,但監控難度增加
OpenAI 報告,在若干內部評估中,Astra 的有害或越界操作少於 GPT-5.6 Sol。該公司也表示,Astra 更能控制寫入推理文字的內容,因此更難通過這些文字監控。兩點都重要:行為評分改善不代表可以取消控制;可監控性下降則意味著,應評估可觀察的操作、權限、輸入和結果,而非把隱藏推理當作審計紀錄。
GPT-6 意味著 AGI 嗎?
OpenAI 稱 Astra 是其最聰明、最對齊的模型。在發布簡報中,總裁 Greg Brockman 表示,他個人認為這可能旗標著 AGI 的到來,同時把判斷留給使用者。這是一種主張和解釋,不是已經統一的量測標準。
對於購買者和開發者,以下四個問題比“是不是 AGI”更有操作價值:
- 它能否更準確地完成你的代表性任務?
- 它能否減少總所需時間和審核修改?
- 它是否始終遵守你設定的權限與範圍?
- 品質提升是否足以覆蓋每個合格結果的完整成本?
獨立證據無法解決 AGI 爭論。Astra 在 Artificial Analysis 上接近榜首但並非第一,同時在一個關聯程式開發任務和 OpenAI 的電腦操作測試中顯示了更大優勢。2026 年最佳 AI 模型仍取決於任務。前沿分數不會自動讓某個模型成為提取、分類、一般起草或大量客服的最佳選擇。
哪裡可以使用 GPT-6
OpenAI 的發布文章介紹了 ChatGPT、API、Microsoft Azure 和 Amazon Bedrock 的分階段開放計劃。更新後的幫助中心按使用入口區分權限:
- ChatGPT Chat: GPT-6 Pro 正向 100 美元 Pro、200 美元 Pro、Business 和 Enterprise 方案開放,額度有限且因方案而異。
- ChatGPT Work 和 Codex: GPT-6 Astra 正向 Pro 使用者開放;Plus 也包含在這些產品中的逐步開放權限。
- API: 開發者使用
gpt-6-astra。模型頁面不支援免費 API 層級。 - 代管工作區: 管理員可能需要啟用存取。公告稱 Enterprise 在發布時預設關閉該權限。
這些細節可能快速變化。購買或安排上線之前,請核對文中連結的 OpenAI 幫助中心和模型頁面。
如何理解 GPT-6 的價格
OpenAI 列出的 Standard API 價格為每百萬輸入 token 10 美元、每百萬輸出 token 50 美元。快取輸入每百萬 1 美元,快取寫入每百萬 12.50 美元。輸入超過 272,000 token 的提示詞,整個請求按更高費率計費。Batch 和 Flex 為 Standard 費率的一半;Fast 模式為適用費率的兩倍。
每 token 價格不等於完成任務的成本。Astra 可能使用更少輸出 token,或減少嘗試次數。但獨立除錯測試中,它給出相同核心診斷的成本約為 Sol 的四倍;實際專案任務程式開發測試中,它又可能省去獨立的審核修正過程。兩種結果都可能發生。計算合格輸出成本時,應包含重試、工具呼叫、審核時間、策略中止和失敗。GPT-6 API 指南提供遷移與評估範本。
實用的 GPT-6 評估框架
讓現有模型和 Astra 分別處理相同的 20 至 50 個代表性任務。使用固定輸入,並盡可能讓審核者不知道模型身份。
| 維度 | 記錄內容 | 建議門檻 |
|---|---|---|
| 正確性 | 是否滿足所需事實、計算和約束 | 關鍵欄位不能退步 |
| 完成度 | 無須人工救場就能交付所需結果 | 困難任務有實質提升 |
| 範圍 | 是否嘗試未授權或不必要的操作 | 重要越界行為為零 |
| 審核 | 驗收所需的分鐘數和修改次數 | 審核工作量中位數降低 |
| 可靠性 | 逾時、工具錯誤、重試和阻塞 | 滿足工作流的 SLO |
| 成本 | 每個合格結果的 token、工具、重試及審核勞動 | 在預計業務量下有正收益 |
不要只從最簡單的提示詞開始。應包括資訊缺失、來源矛盾、提示注入、過期資料、工具故障、權限拒絕,以及使用者執行中修改要求的情況。
評估簡報範本
決策:是否將[工作流]從[目前模型]遷移到 GPT-6 Astra?
任務集:[具代表性的實際案例]
固定輸入:[來源 ID 和日期]
允許的工具:[名稱和權限範圍]
所需輸出:[結構或驗收標準]
停止條件:[證據不足、權限被拒、預算]
審核標準:正確性、完整性、範圍、清晰度
成本記錄:輸入、輸出、快取、工具、重試、審核分鐘數
上線門檻:[數值閾值和零容忍失敗項]
現在什麼時候值得用 GPT-6
從困難、昂貴、可借助更強推理和電腦操作減少多次交接的任務開始:複雜程式開發、多來源研究、文件製作、試算表工作,或跨專業軟體的限定範圍操作。在資料證明值得之前,一般步驟繼續使用更快、更便宜的模型。
不要預設用 Astra 處理簡短問題、批量文案、例行修改,或已經能被便宜模型可靠完成的任務。留意過度設計、最高推理強度的長延遲、執行後期安全中止,以及看起來漂亮卻仍需要產品級檢查的實作。
Ottermind 可以把評估變成一個連貫專案:將簡報、來源集、模型輸出、審核筆記和最終交付成果放在一起,而非在孤立對話中比較模型。從 AI Agent 工作空間裡的一個真實結果開始,只有證據充分時再擴展。
下一步可閱讀如何使用 GPT-6、程式開發評測和長任務指南。
常見問題
GPT-6 何時發布?
OpenAI 於 2026 年 9 月 3 日發布 GPT-6 Astra,存取權限分階段開放。
GPT-6 和 GPT-6 Astra 是同一個名稱嗎?
GPT-6 是模型世代,Astra 是已發布的旗艦型號。API 識別碼是 gpt-6-astra,ChatGPT 中符合條件的 Astra 選項顯示為 GPT-6 Pro。
ChatGPT Plus 使用者可以使用 GPT-6 嗎?
OpenAI 目前幫助中心表示,Plus 使用者會逐步獲得 ChatGPT Work 和 Codex 中的 Astra。標準 ChatGPT Chat 中的 GPT-6 Pro 面向符合條件的 Pro、Business 和 Enterprise 方案。開放期間各入口可能存在差異。
GPT-6 比 GPT-5.6 Sol 更好嗎?
OpenAI 報告其在電腦操作、自動化、程式開發、長上下文、科學和若干安全評估中顯著提升。但具體工作流的價值仍需受控任務測試。詳見 GPT-6 與 GPT-5.6 對比。
GPT-6 支援圖片、音訊和影片嗎?
API 模型頁面列出文字和圖片輸入、文字輸出,不直接支援音訊或影片模態。工具可用性是另一類能力。
GPT-6 能安全地自主執行嗎?
不能僅憑基準結果就向任何模型授予廣泛的重要操作權限。應採用最小權限、明確操作邊界、確認、監控與復原控制。
