クリップを支えるトリガーを選ぶ
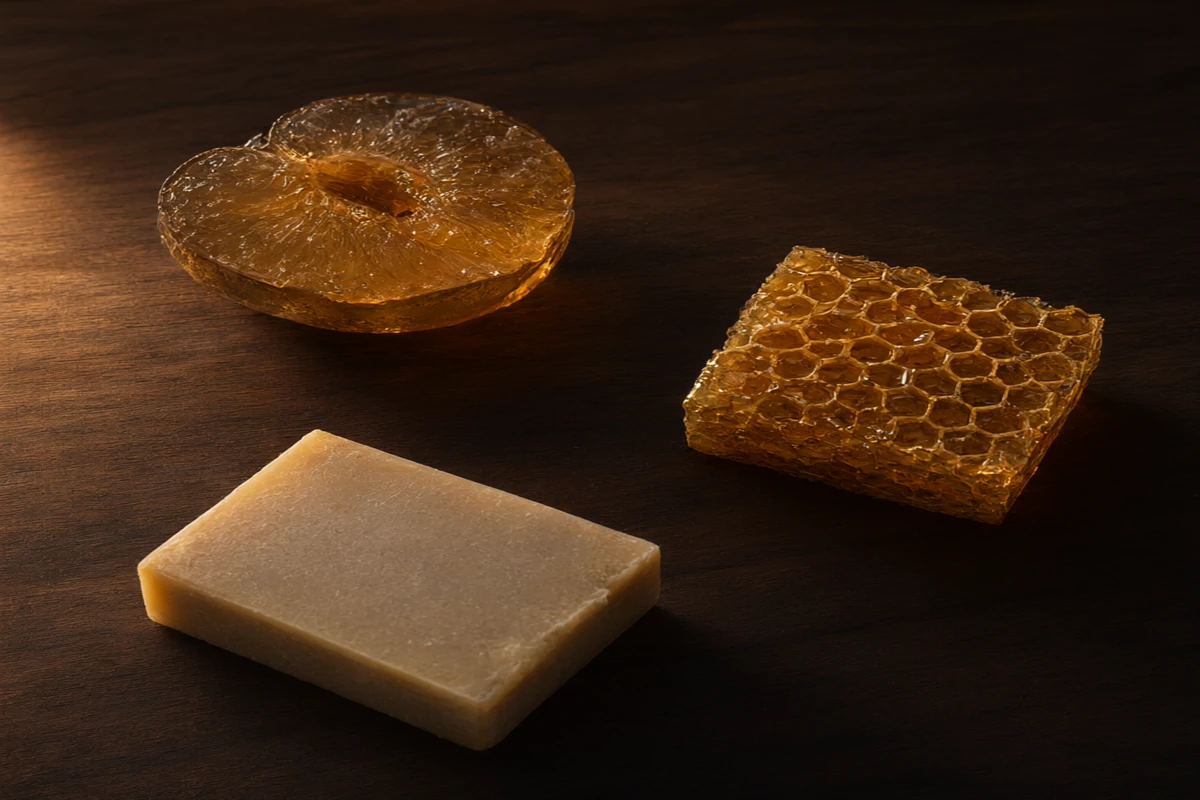
ガラスの果実、ハニカムキーボード、石けん、シーツ、注ぐスムージー。トリガーは物体・動作・音の三点セットで、三つが揃わないと成立しません。ガラスには刃とクランチ、ハニカムにはゆっくりした押し込み、ベッドには布と手が必要です。1クリップ1トリガー。テイクが決まったら、AIリール作成ツールが投稿用の縦型に切ります。
物体、動作、音を書いてください。ガラスの果実を切る、ハニカムを押す、石けんを割る。Ottermind がプロンプトを書き、モデルが対応していれば音声付きで生成し、次のためのセットを残します。
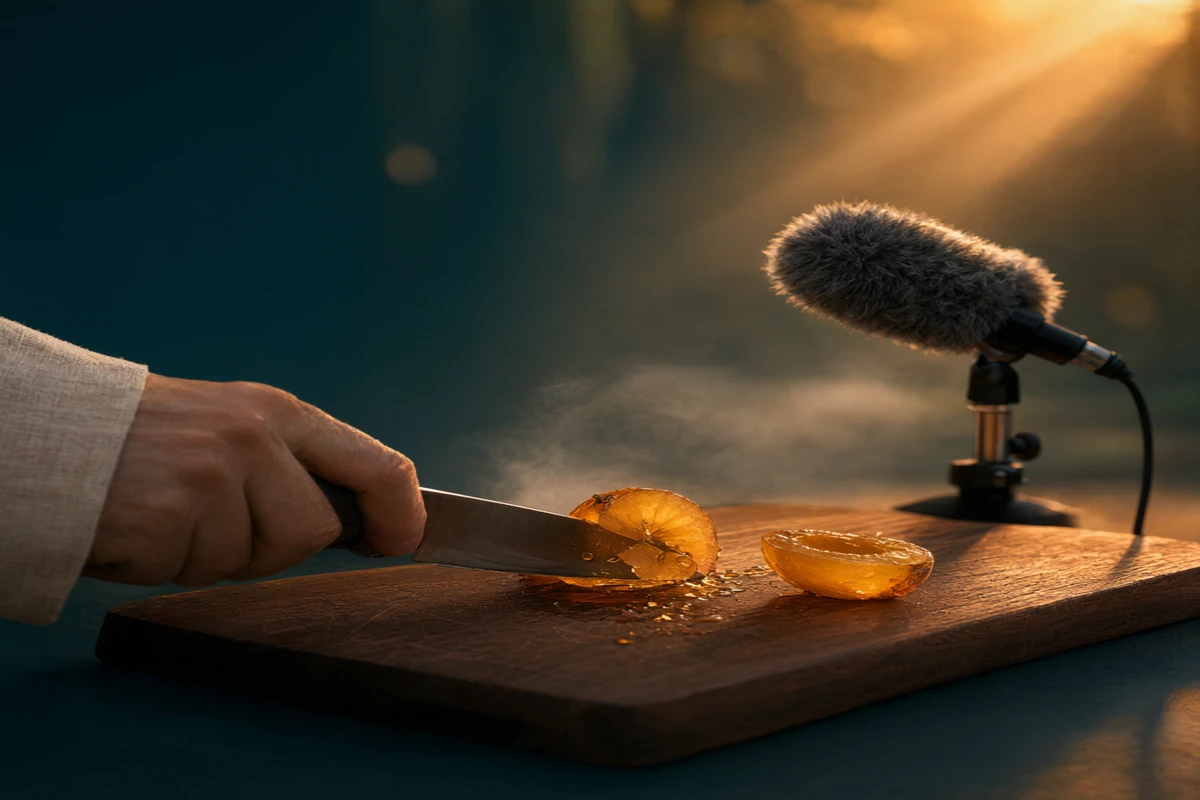


音が主役です。視聴者は最初の1.5秒で、その切れ方が切れ方に聞こえるかを判断します。映像が美しくても音が薄い汎用クランチならスクロールされます。物体、道具、マイクとの距離、室内の響きをまとめて書き、映像と音を一度に生成してください。見た目を先に決めるなら、AI画像ジェネレーターでクリップの前に画を固められます。
ガラスの果実、ハニカムキーボード、石けん、シーツ、注ぐスムージー。トリガーは物体・動作・音の三点セットで、三つが揃わないと成立しません。ガラスには刃とクランチ、ハニカムにはゆっくりした押し込み、ベッドには布と手が必要です。1クリップ1トリガー。テイクが決まったら、AIリール作成ツールが投稿用の縦型に切ります。
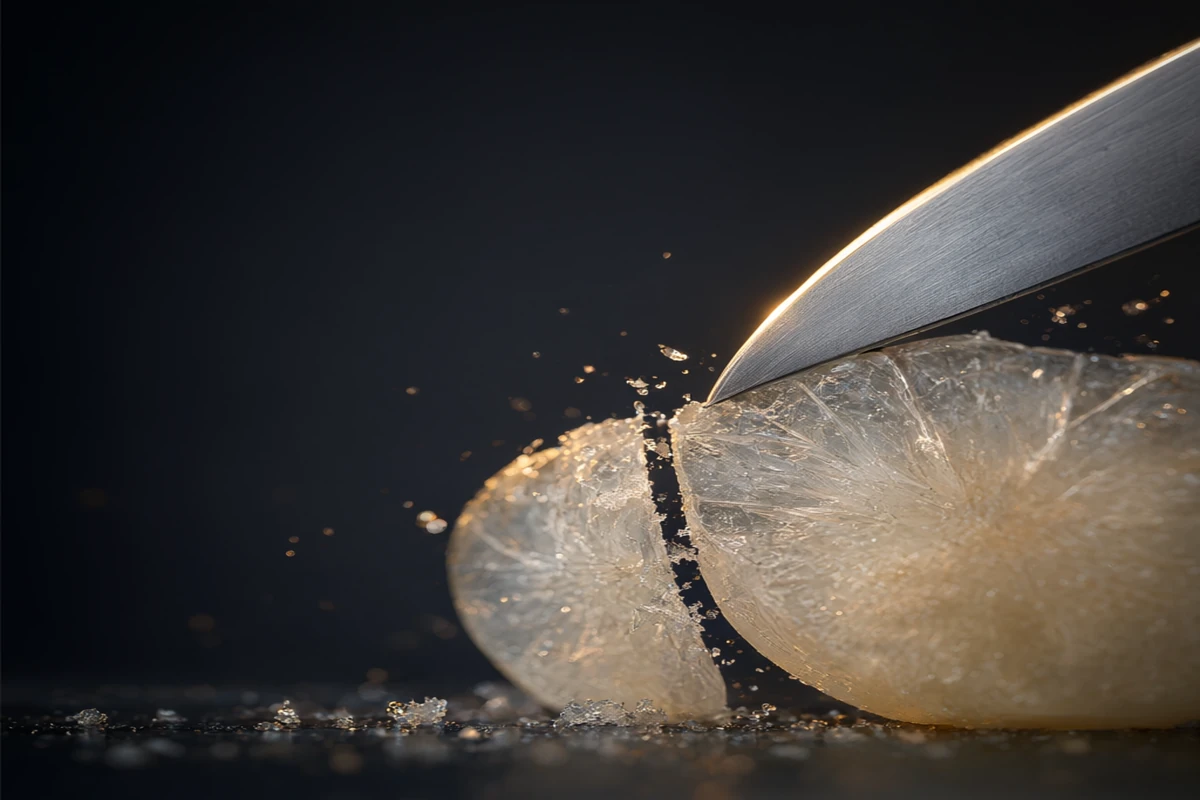
AI ASMRでよくある失敗は、完璧なカットの下に音がない、またはクランチが半秒遅れて着地することです。ネイティブ音声を出す動画モデルで生成し、素材とマイク距離をプロンプトに書き、小さい音量のヘッドホンで確認します。動作に声の層を重ねたいときは、AIリップシンクツールが同じテイクに顔と声を載せます。
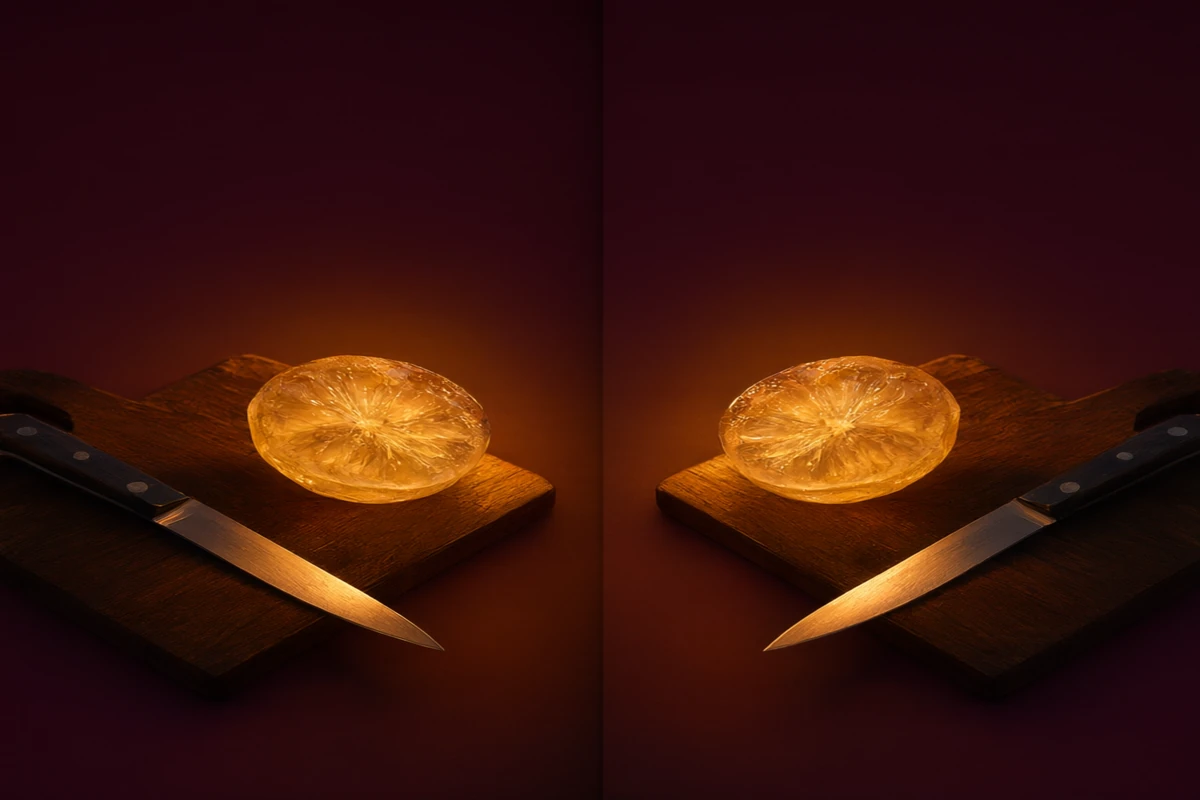
シリーズには同じ板、同じナイフ、同じランプが必要です。違えば2本目は別チャンネルに見えます。見た目の参照と効いたプロンプトをタスクに残せば、次のクリップは同じセットから始まります。音は良いのに長さが合わないときは、AI動画編集で切ってループさせます。
ステップ 01
1物体、1動作、1音。素材(ガラス、ハニカム、石けん、布)、触れる道具、切れ目の位置を書きます。曖昧な「満足感のあるASMR」では、モデルに動かす対象が残りません。
ステップ 02
クランチ、押し込み、注ぐ音、マイク距離、室内を指定します。同じパスでネイティブ音声を頼み、音楽は外します。ASMRではトリガーがBGMで、他の音はすべて競合です。
ステップ 03
小さい音量のヘッドホンで判断します。スマホのスピーカーはクランプを成立させる層を消します。参照とプロンプトを残し、次のクリップを新しい実験ではなくシリーズにします。
物体・道具・音を名指しするので、切れ目とクランチがずれず同時に着地します。
ネイティブ音声の動画モデルは映像と音を一緒に出します。無音クリップを音源ライブラリで埋める必要はありません。
参照がタスクに残るので、2本目も板・ナイフ・ランプが揃います。
9:16、6〜10秒で書くので、フィードで気持ちよくループします。
公開版は無料の回数が限られていますが、トリガーを一つ試して音を判断できます。
無音のテイクは同じワークスペースでのプロンプト修正です。音が決まったらAI動画編集で仕上げます。
書いたプロンプトからASMR動画を作るツールです。トリガーの音、映像、対応モデルなら音声まで一度に生成します。物体と動作を書き、モデルがテイクを出し、残すか直すかを選びます。ASMRライブラリではなく、他人の録音を流すものでもありません。
物体と音がはっきりしたものです。ガラスの果実を切る、ハニカムキーボードを押す、石けんを割る、シーツを動かす、飲み物を注ぐ。1クリップに1つ。8秒に2つ入れると競合し、何を聞いているのか分からなくなります。
ページを使うのに特定のモデルは不要です。クリップを書けば、Studio が利用可能な動画モデルで生成します。Kling 3.0 のようにネイティブ音声を出すモデルなら映像と音が一緒に届きます。無音モデルなら映像だけを受け取り、あとで音を足します。
6〜10秒、トリガー一つ、ループ。長い作品は1拍ごとに表面が変わると機能します。同じ切れ目の繰り返しは数秒で認識されなくなります。長くしたいときは、長いテイクを生成せず、採用テイクをAI動画編集でループさせます。
公開版は登録なしで無料の回数分だけ使え、1本生成して音を判断できます。無制限の無料利用は約束していません。声の層が必要なら、AIリップシンクツールがポートレートに声を当てます。
保てます。採用テイクを作った参照画像とプロンプトをタスクに残せば、次の生成は同じ板、ナイフ、ランプから始まります。これがシリーズとクリップの山の違いです。