Actualité des modèles
Test de GPT-6 : lancement, évaluations indépendantes et verdict
GPT-6 est disponible, mais toutes les tâches ne justifient pas une migration immédiate. OpenAI a lancé GPT-6 Astra le 3 septembre 2026. Les tests indépendants publiés pendant sa première semaine indiquent de réels progrès sur les travaux difficiles et interdépendants, mais aussi une latence élevée, un tarif premium et un intérêt variable pour les requêtes courantes. Son identifiant dans l'API est gpt-6-astra.
Notre avis : Astra convient surtout aux travaux exigeants dans des processus longs et interdépendants, plutôt qu'aux conversations quotidiennes ou à la génération en masse. Il est particulièrement pertinent lorsqu'un modèle doit comprendre un grand système, utiliser plusieurs outils, respecter différentes contraintes et produire un résultat dont les erreurs seraient coûteuses. Les modèles de la classe GPT-5.6 restent plus économiques pour les tâches bien délimitées.
Sources: annonce du lancement; documentation du modèle; guide développeur; présentation de la sécurité; guide de disponibilité; Artificial Analysis; comparatif de programmation issu d'un cas de production; essais pratiques de l'API; reportage d'Axios; avis de spécialistes en sécurité. Consultées le 7 septembre 2026.
Réponse rapide
| Question | Réponse au 7 septembre 2026 |
|---|---|
| GPT-6 est-il sorti ? | Oui. OpenAI a lancé GPT-6 Astra le 3 septembre 2026. |
| Quel est son identifiant dans l'API ? | gpt-6-astra |
| GPT-6 est-il dans ChatGPT ? | GPT-6 Pro arrive progressivement dans les offres Pro, Business et Enterprise éligibles. L'accès dépend du produit et des paramètres de l'espace de travail. |
| Est-il disponible dans Codex et ChatGPT Work ? | Le déploiement est en cours. Selon OpenAI, Plus inclut l'accès dans Work et Codex, tandis que Chat suit des règles différentes. |
| Combien coûte l'API ? | En Standard : 10 $ US par million de tokens en entrée et 50 $ US par million en sortie. La lecture et l'écriture du cache ont leurs propres tarifs. |
| Quelle est la fenêtre de contexte ? | 1 050 000 tokens, avec jusqu'à 128 000 tokens en sortie. |
| Faut-il tout migrer maintenant ? | Non. Évaluez les tâches réelles et migrez celles dont les bénéfices compensent le coût et le risque opérationnel supplémentaires. |
Ce que montrent les tests indépendants
Les premières données externes sont plus nuancées que le discours du lancement. Elles confirment des progrès, sans démontrer qu'Astra gagne sur toutes les tâches ou offre systématiquement le meilleur rapport qualité-prix.
| Test externe | Résultat | Lecture pratique |
|---|---|---|
| Artificial Analysis Intelligence Index | Astra max obtient 55 points et se classe 3e sur 202 modèles dans le relevé actuel | Un modèle de premier plan, sans première place incontestable |
| Vitesse mesurée par Artificial Analysis | 64,3 tokens de sortie par seconde, soit la 93e place sur 202 | Sous la médiane du groupe et plus lent que GPT-5.6 Sol max dans le même suivi |
| Coût par tâche de l'indice Artificial Analysis | 2,57 $ US pour Astra max, contre 1,25 $ US pour Sol max | Quatre points supplémentaires pour environ deux fois le coût par tâche testée |
| Test de débogage de ComputingForGeeks | Astra, Sol, Terra et Luna identifient les trois mêmes causes | Astra se distingue par les réserves et la vérification, pas par un diagnostic différent |
| Comparatif de programmation issu de la production | Astra et Terra passent la suite existante ; seul Astra conserve les états de pagination liés et ajoute un test | Des tests au vert peuvent masquer une violation du contrat fonctionnel ; Astra a mieux relié les composants dans ce cas |
Artificial Analysis mesure également environ 355 secondes avant le premier token d'Astra avec l'effort max. Il s'agit d'une configuration extrême, et non du délai normal d'une conversation, mais ce résultat rappelle une règle utile : le raisonnement maximal doit être un choix délibéré pour la recherche, pas le réglage par défaut.
Le test de programmation issu de la production est particulièrement instructif. Les deux agents ont passé 712 fichiers de test. Pourtant, l'implémentation de Terra perdait l'état de l'autre contrôle de pagination lors d'une interaction. Astra a conservé les deux états et testé explicitement leur relation. Ce cas plaide pour l'évaluer sur des implémentations fortement interdépendantes, mais il reste un exemple publié par un fournisseur, pas un taux de réussite général.
Ce que rapportent les essais pratiques
Le retour d'accès anticipé de Claire Vo du 3 septembre cite des tâches concrètes : une fonctionnalité de ChatPRD qui résistait aux modèles précédents, de la QA dans le navigateur, une intégration matérielle et de la 3D. La page de l'épisode donne les repères temporels des démonstrations. Une développeuse expérimentée y présente une sélection de réussites en précisant son accès anticipé, mais sans essais répétés ni taux moyen d'échec. Ces tâches réelles constituent surtout une base pour concevoir votre propre comparaison.
L'analyse de Matt Shumer du 3 septembre est plus favorable à l'usage quotidien que notre recommandation attentive aux coûts. Il a adopté Astra par défaut et apprécie son travail backend ainsi que ses comptes rendus compréhensibles. Il rapporte aussi des résultats visuels inférieurs à Claude, des réponses plus lentes et des projets ambitieux qui cessent de progresser utilement. Ses grandes démonstrations reposaient sur une coordination importante et des ressources existantes. Ces conditions comptent lorsqu'un projet est présenté comme démarrant avec un seul prompt.
Ces auteurs ne partagent pas certains premiers avis négatifs de la communauté sur la compréhension de l'intention et du périmètre. Les éléments disponibles invitent à tester ces comportements sur vos propres tâches ; ils ne permettent pas de dire quelle expérience est la plus courante.
ComputingForGeeks a envoyé le même prompt de débogage à quatre modèles OpenAI via l'API. Tous ont identifié les trois mêmes causes. Astra a pris 75,5 secondes pour environ 0,194 $ US ; Sol, 39,3 secondes pour environ 0,048 $ US. L'auteur juge utile la réserve supplémentaire d'Astra, qui évite un diagnostic trop général, mais estime que les questions de confirmation habituelles ne justifient pas ce surcoût.
Ce résultat change la question d'achat. Astra n'a pas besoin de produire une réponse radicalement différente pour être utile : une réserve omise peut compter dans un incident à haut risque. Mais lorsque toutes les bonnes réponses conduisent à la même action, le modèle le moins cher l'emporte.
Les premiers avis de la communauté sont partagés. Un utilisateur expérimenté de Codex rapporte des solutions astucieuses, mais un jugement moins sûr sur le périmètre, avec des propositions d'infrastructure inutiles avant même d'avoir fixé la direction. Un autre développeur décrit un Astra puissant mais enclin à surconcevoir les tâches simples. D'autres signalent des réalisations beaucoup plus rapides sur des dépôts difficiles. Ces témoignages non contrôlés dépendent des prompts, dépôts, limites du produit et attentes. Ils révèlent des problèmes à tester, pas un score fiable de satisfaction.
Un témoignage détaillé indique que 12 tours de travail ordinaire sur un dépôt, répartis sur huit sessions, ont été arrêtés pour des raisons de politique de cybersécurité après une longue exécution. Ce récit n'est pas vérifié indépendamment, mais rejoint l'avertissement d'OpenAI : les protections peuvent suspendre ou arrêter des travaux légitimes. Les équipes devraient suivre ces arrêts tardifs dans leurs mesures de fiabilité et de coût.
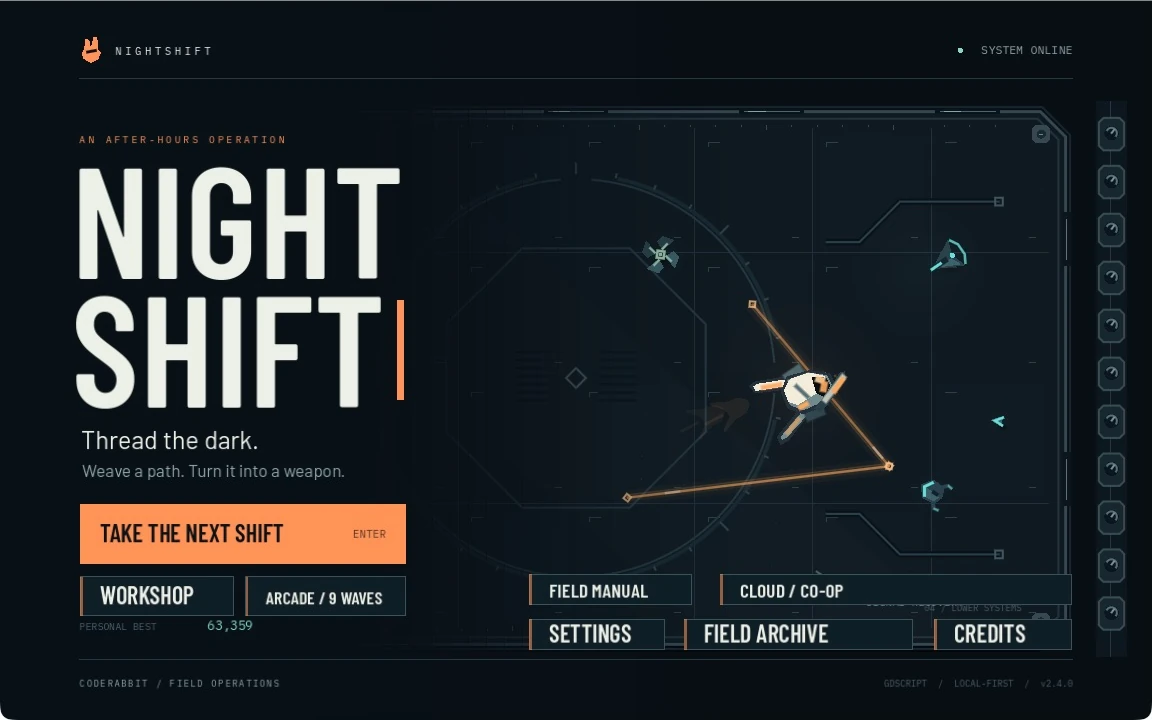
NIGHTSHIFT, créé avec GPT-6 sous direction humaine et par itérations, présenté par CodeRabbit.
Les nouveautés de GPT-6 Astra
Un contexte long plus exploitable
La fiche annonce 1 050 000 tokens de contexte et 128 000 tokens de sortie maximum. OpenAI rapporte 96,3 % au test MRCR v2 à huit aiguilles dans la plage de 512K à 1M, contre 73,8 % pour GPT-5.6 Sol. Une grande fenêtre ne justifie toujours pas l'envoi de tous les fichiers disponibles. Qualité de la recherche, dates des sources, conflits et visibilité pour la révision restent à la charge de l'application.
L'utilisation de l'ordinateur se rapproche du travail réel
OpenAI rapporte 72,6 % pour Astra sur son jeu hors ligne OSWorld 2.0, contre 65,7 % pour GPT-5.6 Sol. Dans sa simulation de latence, Astra termine ces tâches en environ 40 minutes au lieu de 75. Les usages présentés incluent la mise à jour de fiches, les formulaires, les tableurs, les documents et la vérification de sites.
Il faut comprendre que davantage de tâches deviennent techniquement possibles, et non que l'autonomie est désormais sûre. Les systèmes ont encore besoin de permissions limitées, d'aperçus des actions, de confirmations pour les modifications importantes, d'idempotence et de traces permettant une restauration. Notre checklist de sécurité des agents IA détaille ces limites.
Les développeurs peuvent réorienter le travail en cours
GPT-6 Astra ajoute les appels d'outils asynchrones et le pilotage en cours de tour à la Responses API. L'application peut poursuivre les tâches indépendantes pendant l'exécution d'un outil lent, puis rendre son résultat avec l'identifiant de l'appel. L'utilisateur peut aussi corriger une session WebSocket sans jeter le travail accompli. Ces fonctions sont utiles pour les tâches longues, mais l'application doit suivre appels en attente, annulations, délais dépassés et résultats tardifs.
Le raisonnement change sans reconstruire le prompt
L'API prend en charge les efforts low, medium, high, xhigh et max. Une conversation peut recevoir une mise à jour de configuration qui modifie l'effort tout en conservant le préfixe du prompt en cache. Astra n'accepte pas le réglage none.
Plus de sécurité, mais un raisonnement plus difficile à surveiller
OpenAI rapporte moins d'actions nuisibles ou hors périmètre qu'avec GPT-5.6 Sol dans plusieurs évaluations internes. L'entreprise indique aussi qu'Astra est plus difficile à surveiller par son raisonnement écrit, car il maîtrise davantage ce qui y apparaît. Les deux constats comptent. Un meilleur comportement mesuré ne supprime pas les contrôles ; une moindre observabilité invite à juger actions, permissions, entrées et résultats observables, plutôt qu'à traiter le raisonnement caché comme un journal d'audit.
GPT-6 marque-t-il l'arrivée de l'AGI ?
OpenAI présente Astra comme son modèle le plus intelligent et le mieux aligné. Lors du point presse, son président Greg Brockman a dit croire personnellement qu'il pouvait marquer l'arrivée de l'AGI, tout en laissant les utilisateurs en juger. C'est une affirmation et une interprétation, pas une norme de mesure établie.
Pour les acheteurs et les développeurs, quatre questions sont plus concrètes :
- Réalise-t-il vos tâches représentatives avec plus de précision ?
- Réduit-il le temps total et les corrections de révision ?
- Respecte-t-il les permissions et le périmètre définis ?
- Le gain de qualité justifie-t-il le coût complet par résultat accepté ?
Les données indépendantes ne tranchent pas l'AGI. Astra se situe près du sommet, sans être premier chez Artificial Analysis, tout en montrant un écart plus net sur une tâche de programmation interdépendante et les tests d'usage de l'ordinateur d'OpenAI. Les meilleurs modèles d'IA en 2026 dépendent toujours de l'usage. Un score de pointe ne désigne pas automatiquement le meilleur modèle pour l'extraction, la classification, la rédaction courante ou le support à grand volume.
Où utiliser GPT-6
L'annonce décrit un déploiement progressif dans ChatGPT, l'API, Microsoft Azure et Amazon Bedrock. Le centre d'aide actualisé distingue les points d'accès :
- ChatGPT Chat : GPT-6 Pro arrive dans les offres Pro à 100 $ US, Pro à 200 $ US, Business et Enterprise. Les quotas sont limités et varient selon l'offre.
- ChatGPT Work et Codex : GPT-6 Astra est en cours de déploiement pour Pro, et Plus inclut l'accès dans ces produits pendant le déploiement.
- API : les développeurs utilisent
gpt-6-astra. La fiche n'indique aucun accès au niveau gratuit de l'API. - Espaces gérés : un administrateur peut devoir activer l'accès. Selon l'annonce, il est désactivé par défaut au lancement pour Enterprise.
Ces détails évoluent vite. Vérifiez le centre d'aide et la fiche du modèle avant un achat ou un engagement de déploiement.
Comprendre le prix de GPT-6
OpenAI affiche 10 $ US par million de tokens d'entrée et 50 $ US par million de tokens de sortie en API Standard. La lecture du cache coûte 1 $ US par million, son écriture 12,50 $ US. Au-delà de 272 000 tokens d'entrée, les tarifs augmentent pour toute la requête. Batch et Flex sont à moitié prix du Standard ; Fast coûte le double du tarif applicable.
Le prix par token n'est pas le coût d'une tâche achevée. Astra peut consommer moins de tokens de sortie ou réussir en moins de tentatives. Toutefois, dans l'essai indépendant de débogage, il a coûté environ quatre fois plus que Sol pour le même diagnostic central. Dans le test de programmation issu de la production, il a peut-être évité une phase distincte de révision et de réparation. Les deux scénarios sont plausibles. Mesurez le coût par résultat accepté, en incluant tentatives, outils, temps de révision, arrêts de politique et échecs. Le guide de l'API GPT-6 propose une trame de migration et d'évaluation.
Un cadre pratique pour évaluer GPT-6
Soumettez les mêmes 20 à 50 tâches représentatives à votre modèle actuel et à Astra. Figez les entrées et masquez si possible l'identité du modèle aux évaluateurs.
| Dimension | À consigner | Seuil conseillé |
|---|---|---|
| Exactitude | Faits, calculs et contraintes respectés | Aucune régression sur les champs critiques |
| Achèvement | Livrable obtenu sans intervention de sauvetage | Gain significatif sur les tâches difficiles |
| Périmètre | Actions inutiles ou non autorisées tentées | Aucune violation lourde de conséquences |
| Révision | Minutes et corrections avant acceptation | Effort médian de révision réduit |
| Fiabilité | Délais dépassés, erreurs d'outils, reprises et blocages | Respect du SLO du processus |
| Coût | Tokens, outils, reprises et travail de révision par résultat | Valeur positive au volume prévu |
Ne commencez pas seulement par les prompts faciles. Incluez informations manquantes, sources contradictoires, injection de prompt, données périmées, erreurs d'outils, refus de permission et changements de consigne en cours de travail.
Modèle de fiche d'évaluation
Décision : faut-il migrer [processus] de [modèle actuel] vers GPT-6 Astra ?
Tâches : [cas de production représentatifs]
Entrées figées : [identifiants et dates des sources]
Outils autorisés : [noms et périmètres de permission]
Sortie attendue : [schéma ou critères d'acceptation]
Arrêts : [preuve manquante, permission refusée, budget]
Critères de révision : exactitude, exhaustivité, périmètre, clarté
Coûts : entrée, sortie, cache, outils, reprises, minutes de révision
Seuil de déploiement : [valeurs et échecs à tolérance zéro]
Quand adopter GPT-6 aujourd'hui
Commencez par les tâches difficiles et coûteuses où de meilleurs raisonnements et outils peuvent supprimer plusieurs relais : programmation complexe, recherche multisource, documents, tableurs ou opérations délimitées dans des logiciels professionnels. Gardez les modèles rapides et économiques pour les étapes courantes jusqu'à ce que les données justifient un changement.
Évitez de choisir Astra automatiquement pour les questions courtes, la rédaction en masse, les modifications mécaniques ou les tâches déjà acceptables avec un modèle moins cher. Surveillez la surconception, la latence au raisonnement maximal, les interruptions tardives et les implémentations impressionnantes qui nécessitent encore une vérification fonctionnelle.
Ottermind permet de réunir cette évaluation dans un projet : brief, sources, sorties des modèles, notes de révision et livrable final restent ensemble, au lieu de comparer des conversations isolées. Commencez par un résultat réel dans un espace de travail pour agents IA, puis élargissez si les preuves le justifient.
Pour passer à la pratique, consultez comment utiliser GPT-6, l'évaluation du code et le guide des tâches longues.
Questions fréquentes
Quelle est la date de sortie de GPT-6 ?
OpenAI a lancé GPT-6 Astra le 3 septembre 2026, avec un accès ouvert par étapes.
GPT-6 et GPT-6 Astra désignent-ils la même chose ?
GPT-6 désigne la génération ; Astra est le nom du modèle phare lancé. Son identifiant API est gpt-6-astra, tandis que ChatGPT propose une option fondée sur Astra sous le nom GPT-6 Pro aux utilisateurs éligibles.
Les abonnés ChatGPT Plus peuvent-ils utiliser GPT-6 ?
Le centre d'aide indique actuellement que Plus reçoit Astra dans ChatGPT Work et Codex au fil du déploiement. GPT-6 Pro dans le Chat standard est annoncé pour les offres Pro, Business et Enterprise éligibles. L'accès peut différer pendant le déploiement.
GPT-6 est-il meilleur que GPT-5.6 Sol ?
OpenAI rapporte des gains importants en usage de l'ordinateur, automatisation, programmation, contexte long, science et sécurité. La valeur d'un processus précis doit encore être vérifiée par un test contrôlé. Consultez le comparatif GPT-6 et GPT-5.6.
GPT-6 accepte-t-il images, audio et vidéo ?
La fiche API indique des entrées texte et image, une sortie texte et aucun support direct de l'audio ou de la vidéo. Les outils constituent une capacité distincte.
Peut-on laisser GPT-6 agir seul en toute sécurité ?
Aucun modèle ne devrait recevoir de larges pouvoirs d'action sur la seule foi des benchmarks. Appliquez le moindre privilège, des limites explicites, des confirmations, une surveillance et des mécanismes de restauration.
