Atualização de modelos
Análise do GPT-6: lançamento, testes independentes e avaliação
O GPT-6 chegou, mas não é uma atualização automática para toda tarefa. A OpenAI lançou o GPT-6 Astra em 3 de setembro de 2026. Os testes independentes disponíveis na primeira semana apontam avanços reais em trabalhos difíceis e interligados, mas também mostram latência alta, custo elevado e benefícios irregulares em solicitações rotineiras. O identificador do modelo na API é gpt-6-astra.
Nossa avaliação: o Astra faz mais sentido como executor de trabalhos complexos em fluxos longos e interdependentes do que como padrão para conversas cotidianas ou geração em massa. Seu melhor cenário é aquele em que um único modelo precisa entender um sistema grande, operar várias ferramentas, preservar restrições e entregar algo cujo erro sairia caro. Modelos da classe GPT-5.6 continuam mais econômicos para trabalhos bem delimitados.
Fontes: anúncio de lançamento; documentação do modelo; orientações para desenvolvedores; visão geral de segurança; guia de disponibilidade; Artificial Analysis; comparação de programação baseada em uma tarefa de produção; testes práticos da API; reportagem da Axios; comentários de especialistas em segurança. Consultadas em 7 de setembro de 2026.
Resposta rápida
| Pergunta | Resposta em 7 de setembro de 2026 |
|---|---|
| O GPT-6 já foi lançado? | Sim. A OpenAI lançou o GPT-6 Astra em 3 de setembro de 2026. |
| Qual é o identificador na API? | gpt-6-astra |
| O GPT-6 está no ChatGPT? | O GPT-6 Pro está sendo liberado para planos Pro, Business e Enterprise elegíveis. O acesso varia conforme o produto e as configurações do workspace. |
| Está disponível no Codex e no ChatGPT Work? | A liberação está em andamento. A OpenAI informa que o Plus inclui acesso no Work e no Codex, enquanto o Chat tem regras diferentes. |
| Quanto custa a API? | No modo Standard, US$ 10 por milhão de tokens de entrada e US$ 50 por milhão de tokens de saída, com tarifas separadas para leitura e gravação de cache. |
| Qual é a janela de contexto? | 1.050.000 tokens, com até 128.000 tokens de saída. |
| É hora de migrar todas as tarefas? | Não. Avalie tarefas reais e migre apenas o trabalho cujo benefício compense o custo e o risco operacional adicionais. |
O que dizem os testes independentes
As primeiras evidências externas são mais moderadas do que a linguagem do lançamento. Elas sustentam um ganho de capacidade, mas não a ideia de que o Astra vence em todas as tarefas ou oferece o melhor custo-benefício por padrão.
| Teste externo | Resultado | Interpretação prática |
|---|---|---|
| Artificial Analysis Intelligence Index | Astra max obteve 55 pontos, em 3º lugar entre 202 modelos no recorte atual | Está na fronteira, mas não é um primeiro lugar incontestável |
| Velocidade na Artificial Analysis | 64,3 tokens de saída por segundo, em 93º lugar entre 202 | Abaixo da mediana do grupo e mais lento que GPT-5.6 Sol max no mesmo serviço |
| Custo por tarefa do índice na Artificial Analysis | US$ 2,57 para Astra max e US$ 1,25 para Sol max | O ganho de quatro pontos custou aproximadamente o dobro por tarefa de teste |
| Teste de depuração da ComputingForGeeks | Astra, Sol, Terra e Luna encontraram as mesmas três causas | A vantagem do Astra estava nas ressalvas e na verificação, não em outro diagnóstico |
| Comparação de programação baseada em produção | Astra e Terra passaram na suíte existente; apenas Astra preservou estados de paginação interdependentes e acrescentou um teste | Uma suíte verde pode ocultar um erro de contrato; nessa tarefa, Astra raciocinou melhor entre componentes |
A Artificial Analysis também mediu aproximadamente 355 segundos até o primeiro token do Astra no esforço max. É uma configuração extrema, não a expectativa normal para uma conversa, mas reforça uma regra útil: raciocínio máximo deve ser uma escolha deliberada para pesquisa, não o padrão.
O teste de programação baseado em produção é especialmente esclarecedor. Os dois agentes passaram em 712 arquivos de teste. Mesmo assim, a implementação do Terra perdeu o estado do outro controle de paginação em uma interação; o Astra preservou os dois estados e testou explicitamente essa relação. É uma evidência favorável ao Astra em implementações com forte interdependência, mas continua sendo um caso publicado por um fornecedor, não uma taxa geral de vitória.
O que encontraram os autores de testes práticos
A análise de acesso antecipado de Claire Vo, publicada em 3 de setembro, apresenta tarefas concretas: uma funcionalidade do ChatPRD que resistira a modelos anteriores, QA no navegador, integração de hardware e trabalho em 3D. A página do episódio traz marcações de tempo das demonstrações. É o relato de uma desenvolvedora experiente sobre sucessos selecionados, com o acesso antecipado informado; não há ensaios repetidos nem taxa média de falha. Sua maior contribuição é oferecer tarefas reais para o leitor montar sua própria comparação.
A análise de Matt Shumer, de 3 de setembro, é mais favorável ao uso cotidiano do que nossa recomendação orientada a custos: ele adotou o Astra como padrão e elogia a engenharia de backend e as atualizações de progresso compreensíveis. Também relata resultados visuais inferiores aos do Claude, respostas mais lentas e projetos ambiciosos que deixam de avançar de forma útil. Suas grandes demonstrações dependiam de bastante coordenação e de recursos existentes. Essas condições importam ao interpretar um projeto descrito como iniciado por um único prompt.
Esses autores divergem de algumas reclamações iniciais da comunidade sobre intenção e escopo. As evidências justificam testar esses comportamentos nas suas próprias tarefas; não estabelecem qual experiência é a mais comum.
A ComputingForGeeks enviou o mesmo prompt de depuração a quatro modelos da OpenAI pela API. Todos identificaram as mesmas três causas. O Astra levou 75,5 segundos e custou cerca de US$ 0,194; o Sol levou 39,3 segundos e custou aproximadamente US$ 0,048. O autor considerou útil a ressalva adicional do Astra por evitar um diagnóstico amplo demais, mas concluiu que perguntas rotineiras de confirmação não justificavam o preço maior.
Esse resultado muda a pergunta de compra. O Astra não precisa produzir uma resposta inteiramente diferente para gerar valor: uma ressalva ausente pode fazer diferença em um incidente de alto risco. Porém, quando todas as respostas corretas levam à mesma ação, o modelo mais barato é a melhor escolha.
O retorno inicial da comunidade é misto. Um usuário experiente do Codex relatou soluções criativas, mas decisões piores sobre escopo, incluindo infraestrutura desnecessária antes de alinhar a direção. Outro desenvolvedor descreveu o Astra como potente, mas propenso a complicar demais tarefas simples. Outros usuários relataram conclusão muito mais rápida de trabalhos difíceis em repositórios. São relatos sem controle experimental, influenciados por prompts, repositórios, limites do produto e expectativas. Servem para identificar falhas a testar, não para calcular uma nota confiável de satisfação.
Um relato detalhado da comunidade afirmou que 12 turnos de trabalho comum em repositórios, distribuídos por oito sessões, terminaram com um bloqueio de política de cibersegurança após bastante tempo de execução. Não houve verificação independente, mas o caso é compatível com o aviso da OpenAI de que proteções adicionais podem pausar ou interromper trabalho legítimo. Equipes que avaliam o Astra devem registrar bloqueios tardios como uma métrica de confiabilidade e custo.
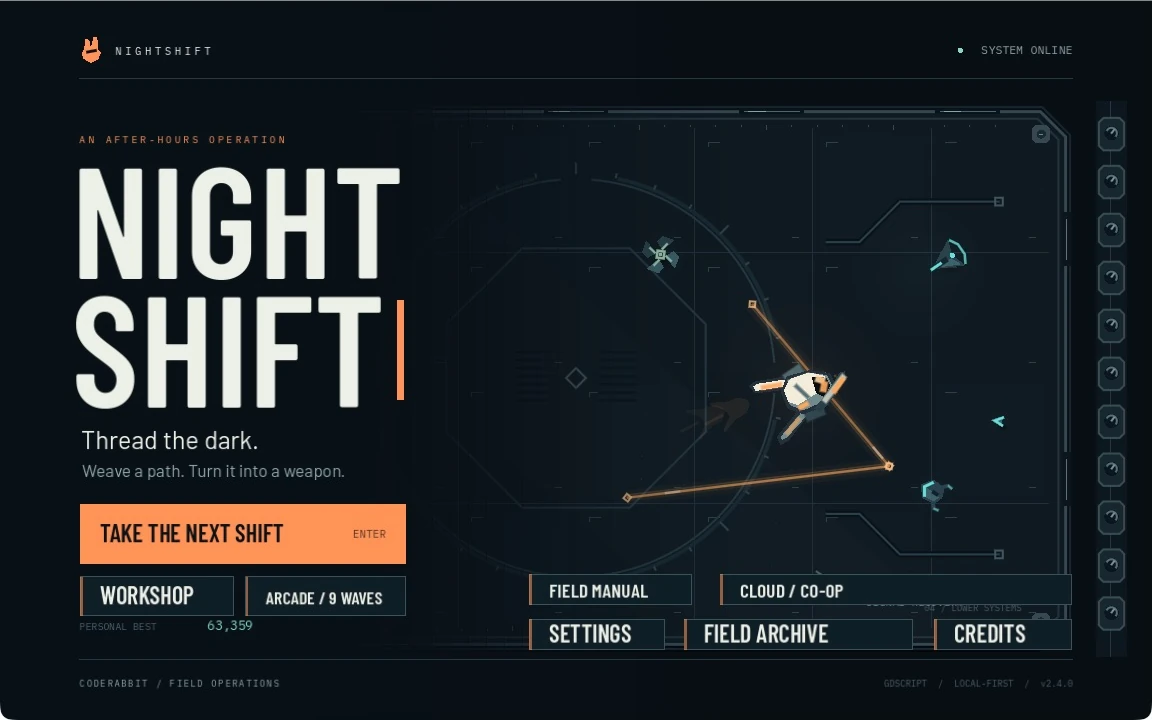
NIGHTSHIFT, criado com GPT-6 por meio de orientação humana e iteração, conforme apresentado pela CodeRabbit.
O que mudou no GPT-6 Astra
O contexto longo ficou mais útil
A página do modelo informa uma janela de 1.050.000 tokens e saída máxima de 128.000 tokens. A OpenAI reporta 96,3% no teste MRCR v2 de oito agulhas, na faixa de 512K a 1M, contra 73,8% do GPT-5.6 Sol. Ainda assim, uma janela grande não justifica enviar todos os arquivos disponíveis. Qualidade da recuperação, datas das fontes, conflitos e visibilidade para revisão continuam sendo responsabilidades da aplicação.
O uso do computador se aproximou do trabalho real
A OpenAI reporta 72,6% para Astra no conjunto offline do OSWorld 2.0, contra 65,7% para GPT-5.6 Sol. Na simulação de latência da empresa, Astra concluiu essas tarefas em cerca de 40 minutos, em vez de 75. O anúncio apresenta usos como atualizar registros, preencher formulários, trabalhar em planilhas, preparar documentos e verificar sites.
A interpretação correta é que mais tarefas se tornaram tecnicamente possíveis, não que a autonomia já seja segura. Os sistemas ainda precisam de permissões restritas, prévia das ações, confirmação de mudanças importantes, idempotência e registros de auditoria que permitam recuperação. Nosso checklist de segurança para agentes de IA detalha esses limites.
Desenvolvedores podem redirecionar o trabalho em andamento
GPT-6 Astra acrescenta chamadas assíncronas de ferramentas e direcionamento durante o turno à Responses API. Uma aplicação pode avançar em atividades independentes enquanto uma ferramenta lenta executa e devolver seu resultado usando o ID da chamada. O usuário também pode corrigir uma sessão WebSocket sem descartar o trabalho concluído. São recursos úteis para tarefas longas, mas a aplicação precisa acompanhar chamadas pendentes, cancelamentos, timeouts e resultados atrasados.
O raciocínio pode mudar sem reconstruir o prompt
A API aceita os níveis low, medium, high, xhigh e max. Uma conversa pode receber uma atualização de configuração que altera o esforço e preserva o prefixo do prompt em cache. Astra não aceita o nível de raciocínio none.
A segurança melhorou, mas o monitoramento ficou mais difícil
A OpenAI reporta menos ações prejudiciais ou fora do escopo que no GPT-5.6 Sol em diversas avaliações internas. A empresa também afirma que é mais difícil monitorar o Astra pelo raciocínio escrito, pois o modelo tem maior controle sobre o que aparece nesse texto. Os dois pontos importam. Melhor comportamento medido não elimina controles; menor capacidade de monitoramento favorece avaliar ações, permissões, entradas e resultados observáveis, em vez de tratar raciocínio oculto como registro de auditoria.
GPT-6 significa AGI?
A OpenAI apresenta Astra como seu modelo mais inteligente e alinhado. Na apresentação à imprensa, o presidente Greg Brockman disse acreditar pessoalmente que ele poderia marcar a chegada da AGI, deixando a avaliação para os usuários. Trata-se de uma afirmação e de uma interpretação, não de um padrão de medição estabelecido.
Para quem compra ou desenvolve, quatro perguntas são mais úteis do que decidir se é AGI:
- Ele conclui suas tarefas representativas com mais precisão?
- Reduz o tempo total e as correções na revisão?
- Respeita as permissões e o escopo definidos?
- O ganho de qualidade justifica o custo completo por resultado aprovado?
As evidências independentes não resolvem a questão da AGI. Astra ficou perto do topo, mas não em primeiro na Artificial Analysis, e mostrou vantagem maior em uma tarefa de programação interdependente e nos testes de uso de computador da OpenAI. Os melhores modelos de IA em 2026 ainda dependem da tarefa. Um resultado de fronteira não torna automaticamente um modelo a melhor opção para extração, classificação, redação rotineira ou atendimento em grande volume.
Onde o GPT-6 está disponível
O anúncio da OpenAI descreve uma liberação gradual no ChatGPT, na API, no Microsoft Azure e no Amazon Bedrock. A Central de Ajuda atualizada diferencia os ambientes:
- ChatGPT Chat: GPT-6 Pro está sendo liberado para Pro de US$ 100, Pro de US$ 200, Business e Enterprise. As cotas são limitadas e variam por plano.
- ChatGPT Work e Codex: GPT-6 Astra está chegando aos usuários Pro; o Plus também inclui acesso nesses produtos durante a liberação.
- API: desenvolvedores usam
gpt-6-astra. A página do modelo não oferece suporte ao nível gratuito da API. - Workspaces gerenciados: administradores podem precisar habilitar o acesso. Segundo o anúncio, no Enterprise ele vem desativado no lançamento.
Esses detalhes podem mudar rapidamente. Confira os links da Central de Ajuda e da página do modelo antes de contratar ou assumir um compromisso de implantação.
Como interpretar o preço do GPT-6
A OpenAI informa US$ 10 por milhão de tokens de entrada e US$ 50 por milhão de tokens de saída na API Standard. Entrada em cache custa US$ 1 por milhão; gravações no cache, US$ 12,50. Prompts com mais de 272.000 tokens de entrada recebem tarifas maiores na solicitação inteira. Batch e Flex custam metade das tarifas Standard; o modo Fast custa o dobro da tarifa aplicável.
Preço por token não é custo por tarefa concluída. Astra pode usar menos tokens de saída ou concluir o fluxo em menos tentativas. No teste independente de depuração, porém, custou aproximadamente quatro vezes mais que Sol para o mesmo diagnóstico central. Já no teste de programação baseado em produção, pode ter evitado um ciclo separado de revisão e reparo. Ambos os resultados são plausíveis. Meça o custo por saída aprovada incluindo novas tentativas, ferramentas, revisão humana, bloqueios de política e falhas. O guia da API do GPT-6 traz um modelo de migração e avaliação.
Um framework prático de avaliação do GPT-6
Execute as mesmas 20 a 50 tarefas representativas no modelo atual e no Astra. Fixe as entradas e, quando possível, não informe ao avaliador qual modelo produziu cada resultado.
| Dimensão | O que registrar | Critério sugerido |
|---|---|---|
| Correção | Fatos, cálculos e restrições atendidos | Nenhuma regressão em campos críticos |
| Conclusão | Entrega solicitada sem intervenção de resgate | Ganho relevante nas tarefas difíceis |
| Escopo | Tentativas de ações não autorizadas ou desnecessárias | Nenhuma violação com consequências importantes |
| Revisão | Minutos e alterações até a aprovação | Menor esforço mediano de revisão |
| Confiabilidade | Timeouts, erros de ferramentas, tentativas e bloqueios | Dentro do SLO do fluxo |
| Custo | Tokens, ferramentas, tentativas e revisão por resultado aprovado | Valor positivo no volume esperado |
Não comece apenas pelos prompts mais fáceis. Inclua informações ausentes, fontes contraditórias, injeção de prompt, dados desatualizados, falhas de ferramentas, negação de permissão e mudanças de requisitos durante a execução.
Modelo de briefing de avaliação
Decisão: migrar [fluxo] de [modelo atual] para GPT-6 Astra?
Conjunto de tarefas: [casos representativos de produção]
Entradas fixadas: [IDs e datas das fontes]
Ferramentas permitidas: [nomes e escopos de permissão]
Saída exigida: [esquema ou critérios de aceitação]
Condições de parada: [falta de evidência, permissão negada, orçamento]
Critérios de revisão: correção, completude, escopo e clareza
Custos: entrada, saída, cache, ferramentas, tentativas, minutos de revisão
Critério de implantação: [limites numéricos e falhas de tolerância zero]
Quando usar o GPT-6 agora
Comece por tarefas difíceis e caras em que raciocínio e uso do computador mais fortes possam eliminar várias passagens de trabalho: programação complexa, pesquisa com diversas fontes, produção de documentos, planilhas ou operações delimitadas em software profissional. Mantenha modelos mais rápidos e baratos nas etapas rotineiras até os dados indicarem outra escolha.
Evite adotar Astra automaticamente para perguntas curtas, textos em massa, alterações mecânicas ou tarefas que já passam na revisão com um modelo mais barato. Observe complexidade desnecessária, alta latência no esforço máximo, interrupções tardias de segurança e implementações que impressionam, mas ainda exigem verificação do comportamento do produto.
O Ottermind ajuda a organizar essa avaliação como um projeto conectado: reúna briefing, fontes, saídas dos modelos, notas de revisão e entrega final, em vez de comparar conversas isoladas. Comece por um resultado real em um workspace de agentes de IA e amplie apenas quando houver evidências favoráveis.
Para os próximos passos, veja como usar GPT-6, a avaliação de programação e o guia de tarefas longas.
Perguntas frequentes
Qual é a data de lançamento do GPT-6?
A OpenAI lançou o GPT-6 Astra em 3 de setembro de 2026, com acesso liberado em etapas.
GPT-6 e GPT-6 Astra são a mesma coisa?
GPT-6 é a geração do modelo; Astra é o nome do modelo principal lançado. Na API, o identificador é gpt-6-astra; no ChatGPT, uma opção baseada no Astra aparece como GPT-6 Pro para usuários elegíveis.
Usuários do ChatGPT Plus podem acessar o GPT-6?
A Central de Ajuda atual informa que o Plus recebe Astra no ChatGPT Work e no Codex durante a liberação. O GPT-6 Pro no ChatGPT Chat está listado para planos Pro, Business e Enterprise elegíveis. O acesso pode variar durante essa fase.
GPT-6 é melhor que GPT-5.6 Sol?
A OpenAI reporta ganhos importantes em uso do computador, automação, programação, contexto longo, ciência e várias avaliações de segurança. O valor em um fluxo específico ainda precisa de um teste controlado por tarefa. Veja a comparação completa entre GPT-6 e GPT-5.6.
GPT-6 aceita imagens, áudio e vídeo?
A página da API lista entrada de texto e imagem, saída de texto e nenhum suporte direto às modalidades de áudio ou vídeo. A disponibilidade de ferramentas é uma capacidade separada.
É seguro deixar o GPT-6 operar sozinho?
Nenhum modelo deve receber amplo acesso a ações importantes apenas com base em benchmarks. Use privilégio mínimo, limites explícitos de ação, confirmação, monitoramento e mecanismos de recuperação.
