Comparatif de modèles
GPT-6 ou GPT-5.6 : comparer Astra et Sol pour le travail réel
GPT-6 Astra est le meilleur candidat pour les travaux les plus complexes en plusieurs étapes ; GPT-5.6 Sol reste un choix par défaut plus pratique lorsque latence, disponibilité et coût priment sur la puissance maximale. Les résultats d'OpenAI montrent les plus grands gains d'Astra en usage de l'ordinateur, automatisation, recherche dans un contexte long, science et cybersécurité. La migration n'apporte pas la même valeur à chaque prompt.
Choisissez selon le coût du résultat accepté, pas le numéro du modèle. Si GPT-5.6 répond déjà correctement, rapidement et à faible coût à une demande courante, passer à GPT-6 peut simplement alourdir la facture. Si votre processus échoue souvent sur la coordination des outils, le raisonnement complexe, le contexte long ou les livrables professionnels, Astra mérite une évaluation contrôlée.
Sources: annonce GPT-6; fiche du modèle; guide développeur; présentation de la sécurité; Astra chez Artificial Analysis; comparatif GPT-5.6 Sol; test de débogage via l'API; comparatif de programmation issu de la production. Consultées le 7 septembre 2026.
Comparaison rapide
| Critère | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| Usage privilégié | Travaux difficiles de bout en bout | Travail général performant à moindre coût |
| Fenêtre de contexte | 1 050 000 tokens | Vérifier la fiche actuelle de la variante déployée |
| Sortie maximale | 128 000 tokens | Vérifier la fiche actuelle de la variante déployée |
| Effort de raisonnement | De low à max ; pas de none | Plusieurs réglages, selon les options du produit |
| Nouveautés de fonctionnement | Outils asynchrones, pilotage pendant un tour, modification du raisonnement en conversation | Processus établis avec outils et Responses API |
| Prix d'entrée API Standard | 10 $ US par million de tokens | Inférieur ; vérifier le tarif actuel |
| Prix de sortie API Standard | 50 $ US par million de tokens | Inférieur ; vérifier le tarif actuel |
| Disponibilité | Déploiement progressif ; pas de niveau gratuit API | Plus étendue dans les produits OpenAI éligibles |
| Score indépendant d'intelligence | 55 à l'effort max | 51 à l'effort max |
| Vitesse de sortie mesurée indépendamment | 64,3 tokens/seconde au max | Environ 76 tokens/seconde au max |
| Coût indépendant par tâche de l'indice | 2,57 $ US au max | 1,25 $ US au max |
| Stratégie d'adoption | Réserver d'abord aux travaux difficiles à forte valeur | Garder comme référence pour les tâches courantes et mixtes |
Ces mesures sont des relevés d'Artificial Analysis ; elles évoluent avec les services et les tests. Elles indiquent un gain modéré d'intelligence générale, une sortie plus lente et un coût par tâche environ doublé, sans prouver un bond universel. Consultez les tarifs actuels pour vos calculs d'achat.
Tests indépendants et discours du lancement
Le témoignage d'accès anticipé de Claire Vo décrit des progrès sur une fonction de ChatPRD qu'elle peinait à achever avec Sol et Fable. Il encourage à essayer Astra sur des travaux bloqués, mais une sélection de succès ne mesure pas le gain typique face à Sol. Gardez la même tâche, le même état du dépôt et les mêmes critères pour reproduire la comparaison.
L'analyse de Matt Shumer privilégie Astra pour l'ingénierie quotidienne et conserve Claude pour le visuel. Elle montre pourquoi un modèle peut devenir un choix par défaut malgré son prix : une bonne communication et moins de supervision peuvent compter davantage que la vitesse de génération. Cela reste une appréciation personnelle, pas un test contrôlé entre Astra et Sol.
Notre recommandation concerne donc les équipes qui disposent d'un budget défini : conservez une référence fonctionnelle, puis testez Astra là où les interventions sont actuellement les plus fréquentes. Des particuliers ayant d'autres usages peuvent raisonnablement choisir autrement.
Les plus grands écarts annoncés par OpenAI concernent les agents, l'usage de l'ordinateur et le contexte long. Artificial Analysis montre un résultat général plus limité : Astra max obtient 55 points à son Intelligence Index, contre 51 pour Sol max. Astra génère moins de tokens de sortie que la médiane du service, mais sa vitesse de sortie est inférieure à Sol et l'attente du premier token au max est élevée.
Un test de débogage par API a montré qu'Astra et trois variantes GPT-5.6 trouvaient la même cause. Astra fournissait la meilleure réserve et le meilleur plan de confirmation, mais prenait environ deux fois plus de temps et coûtait près de quatre fois plus cher que Sol. Il devient intéressant si une réserve oubliée peut provoquer une erreur coûteuse, moins si l'on cherche seulement une commande ou une cause probable.
Un autre test de programmation, issu de la production, comparait Astra à GPT-5.6 Terra plutôt qu'à Sol. Les deux versions passaient les tests existants, mais Terra cassait un état de pagination lié. Astra le conservait et ajoutait le test correspondant. L'auteur a alors confié à Astra les tâches interdépendantes touchant plusieurs domaines, tout en gardant des modèles économiques pour les changements courants et mécaniques. Cette approche est plus défendable qu'un remplacement général.
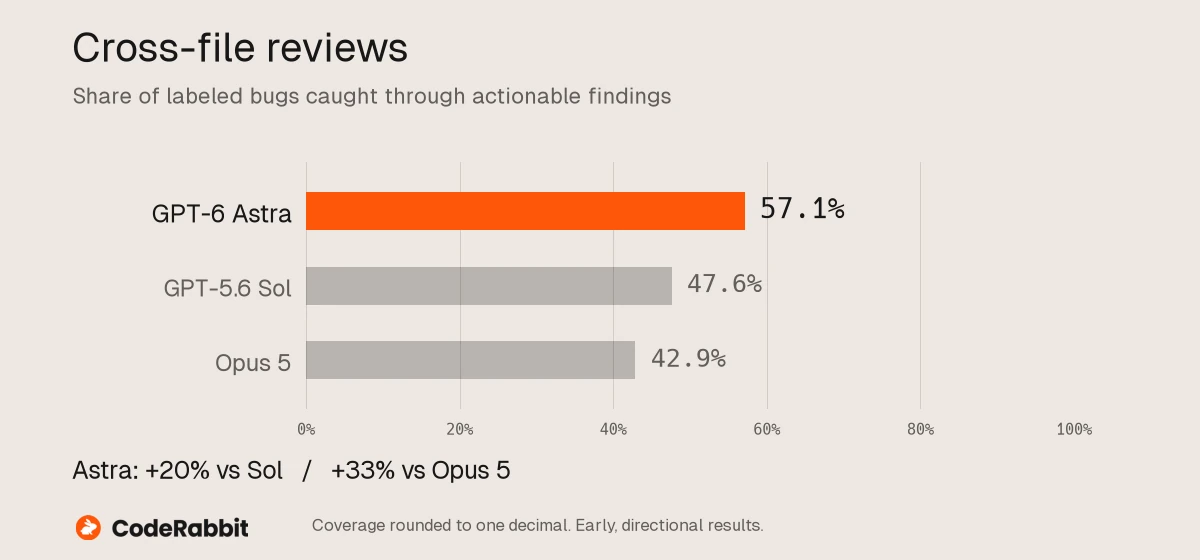
Résultats de revue entre fichiers publiés par CodeRabbit. Ces premiers constats ne mesurent pas la qualité globale d'une revue.
Les gains les plus nets de GPT-6
Les évaluations de lancement d'OpenAI sont utiles pour comparer les deux modèles testés par un même organisme. Elles restent à lire avec prudence : certaines sont internes, les scores correspondent aux efforts donnant les meilleurs résultats, et les outils ou prompts système de production peuvent modifier les performances.
| Évaluation | GPT-6 Astra | GPT-5.6 Sol | Ce que cela peut indiquer |
|---|---|---|---|
| OSWorld 2.0 hors ligne | 72,6 % | 65,7 % | Meilleure manipulation d'environnements de bureau |
| AutomationBench | 41,4 % | 18,1 % | Fort gain en automatisation à plusieurs étapes |
| Terminal-Bench 4.0 | 57,9 % | 37,3 % | Meilleur travail d'ingénierie dans le terminal |
| Migrations internes de bases de données | 63,9 % | 42,7 % | Potentiel sur les modifications longues avec gestion d'état |
| FrontierMath Tier 4 v2 | 97,6 % | 83,0 % | Raisonnement mathématique avancé plus solide |
| MRCR v2, 512K à 1M | 96,3 % | 73,8 % | Meilleure recherche dans les très longs contextes |
| ARC-AGI-3 | 99,9 % | 7,8 % | Fort progrès annoncé sur de nouvelles tâches interactives |
Astra ne domine pas tous les concurrents sur tous les tests. L'analyse de DataCamp souligne qu'il reste derrière Claude Fable 5.1 sur Humanity's Last Exam avec outils, et que les 99,9 % d'ARC-AGI-3 dépendent d'un environnement d'exécution avec état et adaptateur du fournisseur. Une requête API sans état ne doit pas être supposée reproduire ce score. Utilisez ces données pour choisir vos tests, pas directement votre déploiement.
Usage de l'ordinateur et processus avec agents
C'est le principal motif pour évaluer GPT-6. OpenAI a conçu Astra pour naviguer entre code, navigateurs, documents, tableurs, présentations et logiciels professionnels. Les appels asynchrones permettent de poursuivre un raisonnement indépendant pendant qu'un outil lent travaille. Le pilotage en cours de tour permet à l'utilisateur de corriger une session longue sans la relancer.
GPT-5.6 Sol dispose déjà d'outils et de fonctions d'agent. Gardez-le si la séquence est courte, les droits restreints et les critères atteints. Essayez Astra si le processus perd sa progression, gère mal les nouvelles consignes, peine à passer entre logiciels ou exige trop de tentatives.
Un modèle plus puissant ne remplace pas l'architecture. Authentification, schémas d'outils, autorisations, état, audit, approbations et retour arrière relèvent de l'application. Le guide d'architecture des agents IA décrit cette limite.
Contexte et mémoire sont différents
La fenêtre de 1,05 million de tokens d'Astra peut contenir beaucoup de sources, mais reste une capacité temporaire de requête. Elle ne constitue pas automatiquement une mémoire durable et exacte d'un client, d'un projet ou d'une politique. Cette mémoire nécessite identifiants de sources, règles de mise à jour, résolution des conflits, suppression, contrôle d'accès et visibilité pour l'utilisateur.
Utilisez le contexte long pour un corpus délimité à examiner ensemble, la recherche pour un corpus plus vaste et changeant, et un état de projet durable pour les décisions et livrables validés qui doivent persister entre exécutions. Le guide de gestion des connaissances par IA explique comment conserver la provenance au lieu de considérer les résumés générés comme faisant foi.
Comparer le coût du travail achevé
GPT-6 Astra coûte 10 $ US par million de tokens d'entrée et 50 $ US par million de sortie en Standard. Au-delà de 272 000 tokens d'entrée, toute la requête est facturée à un tarif supérieur. Cache, outils, Fast, Batch et Flex ont leurs propres tarifs.
Astra peut revenir moins cher sur un cas difficile s'il réduit tokens, tentatives ou révision humaine. Inversement, une réponse même parfaite peut être peu rentable pour une classification à grand volume qui ne bénéficie pas du raisonnement avancé.
L'essai de débogage illustre concrètement le compromis : environ 0,194 $ US et 75,5 secondes pour Astra, contre 0,048 $ US et 39,3 secondes pour Sol. Le diagnostic central était identique ; Astra apportait une limite plus précise et un plan de vérification. Ce seul prompt ne donne pas une moyenne, mais nuance utilement les annonces d'efficacité en tokens.
Vous pouvez calculer ainsi :
coût par tâche acceptée =
  entrée du modèle + sortie du modèle + cache + appels d'outils
  + tentatives échouées + temps de révision + corrections

valeur de la migration =
  erreurs évitées + travail économisé + réduction du délai
  - surcoût par tâche acceptée
Mesurez les deux modèles sur les mêmes entrées. Ne comptez pas le temps de révision comme nul : c'est souvent le principal coût caché.
Sécurité et contrôle
OpenAI affirme qu'Astra résiste mieux que GPT-5.6 Sol aux jailbreaks, injections de prompt et sorties de périmètre. Dans une simulation interne de plus de 54 000 tâches Codex, il a reçu environ deux fois moins de signalements de désalignement grave. OpenAI rapporte aussi une diminution de la capacité à surveiller son raisonnement écrit par rapport à Sol.
Les spécialistes interrogés par TechRadar recommandent de surveiller les actions observables et de pouvoir arrêter un agent en cours d'action, plutôt que de se fier au raisonnement écrit. Un premier témoignage communautaire décrit des sessions de programmation ordinaires bloquées après une longue exécution par des classifieurs de cybersécurité. C'est un témoignage isolé, mais OpenAI confirme que les protections peuvent interrompre du travail légitime. Intégrez les faux positifs et le temps perdu à la comparaison.
Ces éléments appellent une évaluation adaptée :
- Testez les actions et résultats réels, pas le caractère rassurant du raisonnement.
- Définissez un schéma restreint et une autorisation claire pour chaque outil.
- Ajoutez des sources adverses et des tâches impossibles aux tests.
- Exigez une confirmation avant envoi, suppression, achat, publication ou modification des accès.
- Conservez un journal indépendant des entrées, appels, approbations, sorties et décisions de révision.
Consultez la checklist de sécurité des agents IA avant d'accorder des droits d'écriture à l'un ou l'autre modèle.
Quel modèle choisir ?
Choisissez GPT-6 Astra lorsque
- La tâche est assez complexe pour nécessiter habituellement plusieurs tentatives ou relais humains.
- L'usage de l'ordinateur ou la coordination d'outils est au cœur du résultat.
- Les sources sont très longues et une information manquée coûte cher.
- Le livrable est un document, une analyse, une présentation ou une modification de code à forte valeur.
- Vos tests montrent une amélioration mesurable des résultats acceptés.
Conservez GPT-5.6 Sol lorsque
- Le processus actuel atteint déjà les objectifs de qualité et de fiabilité.
- La rapidité ou le coût à grand volume domine la décision.
- Le travail est court, répétitif, structuré ou facile à vérifier.
- La disponibilité ou les limites de GPT-6 ne répondent pas à vos besoins de service.
- L'équipe n'a pas encore de processus d'évaluation et de révision.
Quand répartir les tâches entre les deux
La plupart des systèmes n'ont pas besoin d'une migration binaire. Commencez avec la référence économique, puis montez en gamme selon des signaux observables : volume des sources, risque, validation échouée, nombre d'outils ou qualité demandée. Gardez la règle assez simple pour pouvoir l'auditer.
Modèle d'évaluation côte à côte
Processus : [nom]
Modèle actuel : GPT-5.6 Sol
Candidat : GPT-6 Astra
Cas : [20-50 tâches représentatives]

Notez chaque critère de 0 à 2 :
- Exactitude des faits et calculs
- Respect des contraintes requises
- Livrable complet et utilisable
- Respect du périmètre autorisé
- Sources et incertitudes visibles

Consignez séparément :
- Temps écoulé
- Coûts d'entrée/sortie/cache/outils
- Tentatives et échecs
- Minutes de révision et modifications

Déployez uniquement si :
- Aucune régression critique de sécurité ou de périmètre
- Gain de qualité significatif en pratique et statistiquement
- Coût par tâche acceptée compatible avec le volume prévu
Un plan de déploiement concret
- Figez les entrées représentatives et les critères d'acceptation.
- Exécutez les deux modèles avec des outils et droits équivalents.
- Masquez si possible l'identité du modèle aux évaluateurs.
- Examinez les échecs, pas seulement les moyennes.
- Confiez à Astra une petite part du travail éligible.
- Suivez coût par tâche acceptée, corrections, incidents et interventions utilisateur.
- Étendez seulement les segments qui continuent à apporter de la valeur.
Ottermind peut réunir sources, résultats comparatifs, décisions de révision et livrables dans un même projet. Utilisez un espace de travail pour agents IA pour évaluer le processus complet plutôt que collectionner des captures de conversations séparées.
Questions fréquentes
GPT-6 Astra est-il toujours meilleur que GPT-5.6 Sol ?
Non. Astra est plus capable dans de nombreuses évaluations, mais Sol peut être plus rapide, moins cher, plus disponible et suffisant pour le quotidien.
Le tarif supérieur de GPT-6 vaut-il la peine ?
Il peut se justifier si les tâches difficiles nécessitent moins de reprises, de révision ou d'échecs. Calculez le coût par tâche acceptée en incluant outils et travail humain.
GPT-6 remplace-t-il GPT-5.6 ?
Pas automatiquement. OpenAI continue de proposer GPT-5.6 dans ses produits. Un système raisonnable peut lui confier le travail courant et réserver GPT-6 aux cas difficiles.
Lequel choisir pour coder ?
OpenAI rapporte des scores supérieurs d'Astra sur Terminal-Bench 4.0 et plusieurs évaluations de code, avec un gain particulièrement net sur ses migrations internes de bases de données. Testez les deux sur vos dépôts, instructions et contrôles CI.
Lequel choisir pour les longs documents ?
Astra offre 1,05 million de tokens de contexte et une meilleure recherche sur contexte long selon OpenAI. Cela ne remplace pas la sélection des documents, les citations, la gestion des conflits ou la révision humaine.
Peut-on conserver les mêmes prompts pendant la migration ?
Partez du même contrat de tâche pour établir une référence équitable, puis ajustez après avoir examiné les échecs. Le guide de l'API GPT-6 inclut une checklist de migration.
