Modellneuigkeiten
GPT-6 im Test: Veröffentlichung, unabhängige Ergebnisse und Fazit
GPT-6 ist da, doch nicht jede Aufgabe profitiert automatisch vom Umstieg. OpenAI hat GPT-6 Astra am 3. September 2026 veröffentlicht. Die unabhängigen Tests der ersten Woche zeigen Fortschritte bei schwierigen, zusammenhängenden Arbeiten, aber auch hohe Latenz, einen höheren Preis und einen uneinheitlichen Nutzen bei Routineanfragen. Die Modellkennung in der API lautet gpt-6-astra.
Unsere Einschätzung: Astra eignet sich vor allem für anspruchsvolle Arbeit in langen, eng verzahnten Abläufen, nicht als Standard für Alltagschats oder Massengenerierung. Besonders überzeugend ist der Einsatz, wenn ein Modell ein großes System verstehen, mehrere Werkzeuge bedienen, verschiedene Vorgaben einhalten und ein Ergebnis mit hohen Fehlerkosten liefern muss. Für klar begrenzte Aufgaben bleiben Modelle der GPT-5.6-Klasse wirtschaftlicher.
Quellen: Veröffentlichungsankündigung; Modelldokumentation; Entwicklerleitfaden; Sicherheitsübersicht; Verfügbarkeit; Artificial Analysis; Coding-Vergleich anhand einer Produktionsaufgabe; API-Praxistests; Axios-Bericht; Stimmen von Sicherheitsexperten. Geprüft am 7. September 2026.
Die wichtigsten Antworten
| Frage | Stand: 7. September 2026 |
|---|---|
| Ist GPT-6 veröffentlicht? | Ja. OpenAI veröffentlichte GPT-6 Astra am 3. September 2026. |
| Wie lautet die API-Modellkennung? | gpt-6-astra |
| Gibt es GPT-6 in ChatGPT? | GPT-6 Pro wird für berechtigte Pro-, Business- und Enterprise-Tarife freigeschaltet. Der Zugang hängt vom Produkt und den Workspace-Einstellungen ab. |
| Gibt es das Modell in Codex und ChatGPT Work? | Die Freischaltung läuft. Laut OpenAI enthält Plus den Zugang in Work und Codex; für Chat gelten andere Regeln. |
| Was kostet die API? | Standard: 10 US-Dollar je Million Eingabetokens und 50 US-Dollar je Million Ausgabetokens. Für Cache-Lese- und Schreibzugriffe gelten separate Preise. |
| Wie groß ist das Kontextfenster? | 1.050.000 Tokens, mit bis zu 128.000 Ausgabetokens. |
| Sollte jetzt jede Aufgabe umziehen? | Nein. Prüfen Sie konkrete Aufgaben und migrieren Sie nur dort, wo der Nutzen Mehrkosten und Betriebsrisiken rechtfertigt. |
Was unabhängige Tests zeigen
Die ersten externen Ergebnisse fallen zurückhaltender aus als die Ankündigung. Sie belegen Fortschritte, aber nicht, dass Astra jede Aufgabe gewinnt oder grundsätzlich das beste Preis-Leistungs-Verhältnis bietet.
| Externer Test | Ergebnis | Praktische Einordnung |
|---|---|---|
| Artificial Analysis Intelligence Index | Astra max erreicht 55 Punkte und Platz 3 von 202 Modellen im aktuellen Stand | Spitzenklasse, aber kein unangefochtener erster Platz |
| Geschwindigkeit bei Artificial Analysis | 64,3 Ausgabetokens pro Sekunde, Platz 93 von 202 | Unter dem Median der Vergleichsgruppe und langsamer als GPT-5.6 Sol max im selben Dienst |
| Kosten je Index-Aufgabe bei Artificial Analysis | 2,57 US-Dollar für Astra max gegenüber 1,25 US-Dollar für Sol max | Vier zusätzliche Punkte bei ungefähr doppelten Kosten je Testaufgabe |
| Debugging-Test von ComputingForGeeks | Astra, Sol, Terra und Luna finden dieselben drei Ursachen | Astras Vorteil liegt in Einschränkungen und Prüfungen, nicht in einer anderen Diagnose |
| Coding-Vergleich aus der Produktion | Beide Modelle bestehen die vorhandenen Tests; nur Astra erhält gekoppelte Seitennavigationszustände und ergänzt einen Test | Grüne Tests können Vertragsverletzungen verdecken; in diesem Fall verknüpft Astra Komponenten besser |
Artificial Analysis misst bei Astra mit max-Aufwand außerdem rund 355 Sekunden bis zum ersten Token. Das ist eine Extremkonfiguration und keine normale Chaterwartung. Dennoch unterstreicht sie eine nützliche Regel: Maximaler Denkaufwand sollte bewusst für Forschung gewählt werden, nicht standardmäßig.
Der produktionsnahe Coding-Test ist besonders aufschlussreich. Beide Agenten bestanden 712 Testdateien. Trotzdem verlor Terras Implementierung in einer Interaktion den Zustand der anderen Seitennavigation. Astra bewahrte beide Zustände und prüfte ihre Beziehung ausdrücklich. Das spricht für Tests mit Astra bei stark verzahnten Implementierungen, bleibt aber ein vom Anbieter veröffentlichter Einzelfall und keine allgemeine Erfolgsquote.
Was Praxistester berichten
Claire Vos Early-Access-Bericht vom 3. September nennt konkrete Aufgaben: eine ChatPRD-Funktion, an der frühere Modelle scheiterten, Browser-QA, Hardwareintegration und 3D-Arbeit. Die Episodenseite enthält Zeitmarken zu den Vorführungen. Eine erfahrene Entwicklerin schildert ausgewählte Erfolge und legt den frühen Zugang offen; wiederholte Versuche oder eine durchschnittliche Fehlerquote fehlen. Besonders hilfreich sind die realen Aufgaben als Grundlage für eigene Vergleiche.
Matt Shumers Bericht vom 3. September beurteilt den täglichen Einsatz positiver als unsere kostenorientierte Empfehlung. Er nutzt Astra standardmäßig und lobt Backend-Entwicklung sowie verständliche Fortschrittsmeldungen. Zugleich nennt er schwächere visuelle Ergebnisse als bei Claude, langsamere Antworten und ambitionierte Projekte, die nicht mehr sinnvoll vorankommen. Seine großen Demonstrationen nutzten umfangreiche Koordination und vorhandene Assets. Diese Bedingungen sind wichtig, wenn ein Projekt als Ergebnis eines einzigen Prompts beschrieben wird.
Diese Tester widersprechen manchen frühen Community-Beschwerden über Absichtserkennung und Umfang. Die verfügbaren Belege sprechen dafür, das Verhalten an eigenen Aufgaben zu prüfen. Sie zeigen nicht, welche Erfahrung typisch ist.
ComputingForGeeks ließ denselben Debugging-Prompt über die API von vier OpenAI-Modellen bearbeiten. Alle fanden dieselben drei Ursachen. Astra benötigte 75,5 Sekunden und etwa 0,194 US-Dollar; Sol 39,3 Sekunden und etwa 0,048 US-Dollar. Der Tester hielt Astras zusätzliche Einschränkung für hilfreich, weil sie eine zu pauschale Diagnose verhinderte. Für alltägliche Bestätigungsfragen rechtfertigte das den Aufpreis aus seiner Sicht jedoch nicht.
Damit verändert sich die Kaufentscheidung. Astra muss keine völlig andere Antwort liefern, um wertvoll zu sein: Bei einem kritischen Vorfall kann eine fehlende Einschränkung entscheidend sein. Führen dagegen alle richtigen Antworten zur gleichen Handlung, gewinnt das günstigere Modell.
Die ersten Nutzerberichte sind gemischt. Ein erfahrener Codex-Nutzer berichtet von cleveren Lösungen, aber schwächerem Urteil zum Umfang, einschließlich unnötiger Infrastruktur vor einer Richtungsentscheidung. Ein anderer Entwickler beschreibt Astra als leistungsfähig, aber zu aufwendigen Lösungen neigend. Andere melden deutlich schnellere Abschlüsse schwieriger Repository-Arbeit. Diese unkontrollierten Erfahrungen hängen von Prompts, Codebasis, Produktlimits und Erwartungen ab. Sie liefern mögliche Fehlerszenarien, keine belastbare Zufriedenheitsnote.
Ein detaillierter Community-Bericht beschreibt 12 gewöhnliche Repository-Arbeitsschritte in acht Sitzungen, die nach längerer Laufzeit durch eine Cybersicherheitsrichtlinie beendet wurden. Das ist nicht unabhängig bestätigt, passt aber zu OpenAIs Hinweis, dass Schutzmaßnahmen legitime Arbeit pausieren oder stoppen können. Solche späten Abbrüche gehören in die Zuverlässigkeits- und Kostenmessung.
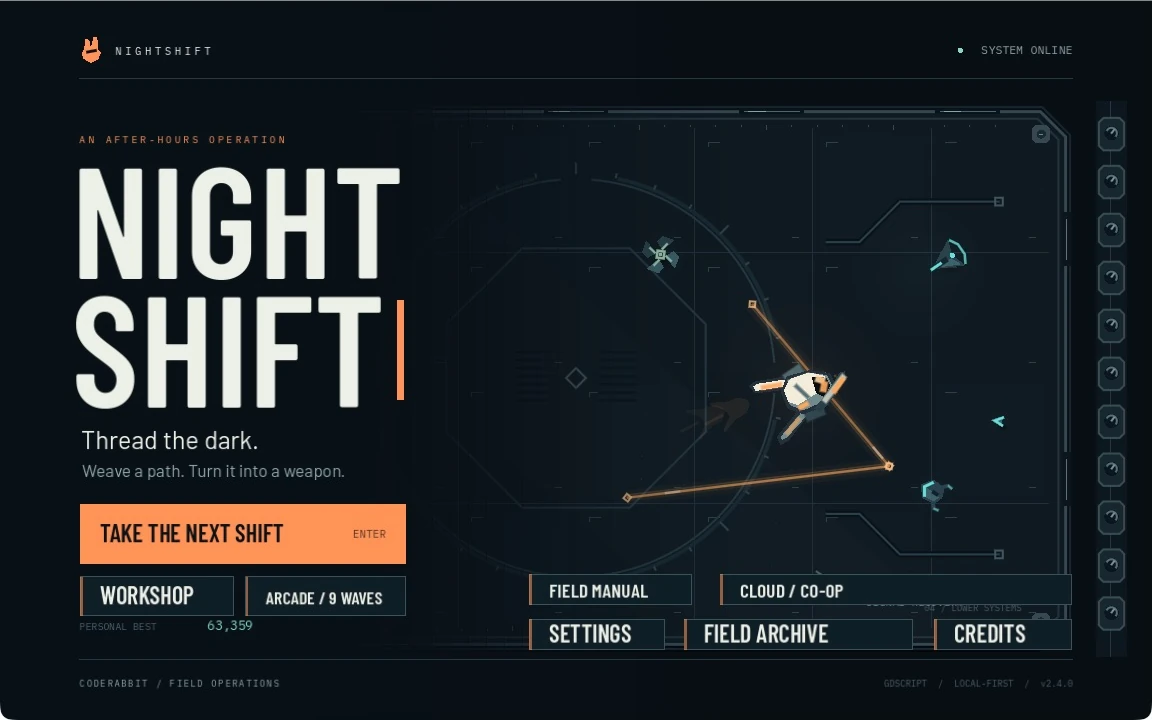
NIGHTSHIFT, mit GPT-6 unter menschlicher Anleitung und durch Iterationen entwickelt; veröffentlicht von CodeRabbit.
Was sich mit GPT-6 Astra ändert
Langer Kontext wird besser nutzbar
Die Modellseite nennt 1.050.000 Kontexttokens und maximal 128.000 Ausgabetokens. OpenAI meldet 96,3 % im MRCR-v2-Test mit acht Nadeln im Bereich 512K bis 1M, gegenüber 73,8 % für GPT-5.6 Sol. Ein großes Fenster ist trotzdem kein Grund, sämtliche Dateien zu senden. Suchqualität, Quelldaten, Konflikte und Einblick für Prüfer bleiben Aufgaben der Anwendung.
Computernutzung nähert sich realen Aufgaben
OpenAI meldet 72,6 % für Astra auf dem Offline-Datensatz von OSWorld 2.0 und 65,7 % für GPT-5.6 Sol. In der Latenzsimulation der Firma brauchte Astra etwa 40 statt 75 Minuten. Gezeigte Anwendungen sind Datensätze aktualisieren, Formulare ausfüllen, Tabellen bearbeiten, Dokumente erstellen und Websites prüfen.
Die richtige Schlussfolgerung lautet, dass mehr Aufgaben technisch möglich werden, nicht dass Autonomie nun sicher ist. Eng begrenzte Rechte, Aktionsvorschauen, Bestätigungen wichtiger Änderungen, Idempotenz und wiederherstellbare Auditspuren bleiben nötig. Unsere Sicherheitscheckliste für KI-Agenten beschreibt diese Grenzen genauer.
Laufende Arbeit lässt sich umsteuern
GPT-6 Astra ergänzt asynchrone Werkzeugaufrufe und Steuerung während eines Turns in der Responses API. Die Anwendung kann unabhängige Arbeit fortsetzen, während ein langsames Werkzeug läuft, und dessen Ergebnis über die Aufruf-ID zurückgeben. Nutzer können auch eine WebSocket-Sitzung korrigieren, ohne abgeschlossene Arbeit zu verwerfen. Dafür muss die Anwendung offene Aufrufe, Abbrüche, Zeitüberschreitungen und verspätete Ergebnisse verwalten.
Denkaufwand ändern, ohne den Prompt neu aufzubauen
Die API unterstützt low, medium, high, xhigh und max. Eine Konversation kann eine Konfigurationsänderung erhalten, die den Aufwand anpasst und den gecachten Prompt-Präfix bewahrt. Astra unterstützt die Einstellung none nicht.
Bessere Sicherheit, schwierigeres Monitoring
OpenAI meldet in mehreren internen Tests weniger schädliche oder außerhalb des Auftrags liegende Aktionen als bei GPT-5.6 Sol. Zugleich sei Astra anhand seines geschriebenen Denkprozesses schwerer zu überwachen, da es stärker kontrolliert, was darin erscheint. Beides ist relevant. Bessere Messwerte ersetzen keine Kontrollen; geringere Überwachbarkeit spricht dafür, beobachtbare Aktionen, Rechte, Eingaben und Ergebnisse zu bewerten, statt verborgenes Denken als Auditprotokoll zu behandeln.
Bedeutet GPT-6 AGI?
OpenAI bezeichnet Astra als sein intelligentestes und am besten ausgerichtetes Modell. Präsident Greg Brockman sagte bei der Pressevorstellung, er glaube persönlich, es könne die Ankunft von AGI markieren, überließ das Urteil aber den Nutzern. Das ist eine Behauptung und Interpretation, kein allgemein geklärter Messstandard.
Für Käufer und Entwickler sind vier Fragen konkreter:
- Erledigt das Modell repräsentative Aufgaben genauer?
- Sinkt der Gesamtaufwand einschließlich Prüfung und Korrektur?
- Bleibt es innerhalb vorgegebener Rechte und Grenzen?
- Rechtfertigt die Qualität die gesamten Kosten je akzeptiertem Ergebnis?
Die unabhängige Datenlage entscheidet die AGI-Frage nicht. Bei Artificial Analysis liegt Astra nahe der Spitze, aber nicht auf Platz eins; bei einer gekoppelten Coding-Aufgabe und OpenAIs Computertests fällt der Vorsprung größer aus. Die besten KI-Modelle 2026 hängen weiterhin von der Aufgabe ab. Ein Spitzenwert macht ein Modell nicht automatisch zur besten Wahl für Extraktion, Klassifizierung, Routineentwürfe oder Support in großem Umfang.
Wo GPT-6 verfügbar ist
OpenAI beschreibt eine schrittweise Einführung in ChatGPT, API, Microsoft Azure und Amazon Bedrock. Das aktualisierte Hilfezentrum unterscheidet die Zugangswege:
- ChatGPT Chat: GPT-6 Pro wird für Pro zu 100 US-Dollar, Pro zu 200 US-Dollar, Business und Enterprise eingeführt. Kontingente sind begrenzt und tarifabhängig.
- ChatGPT Work und Codex: Astra wird für Pro freigeschaltet; Plus enthält während der Einführung ebenfalls Zugang zu diesen Produkten.
- API: Entwickler verwenden
gpt-6-astra. Der kostenlose API-Tarif wird laut Modellseite nicht unterstützt. - Verwaltete Workspaces: Administratoren müssen den Zugang gegebenenfalls aktivieren. Bei Enterprise ist er laut Ankündigung zum Start standardmäßig aus.
Diese Angaben können sich rasch ändern. Prüfen Sie Hilfezentrum und Modellseite vor einer Buchung oder festen Einführungsplanung.
GPT-6-Preise richtig einordnen
Die Standard-API kostet laut OpenAI 10 US-Dollar je Million Eingabetokens und 50 US-Dollar je Million Ausgabetokens. Gecachte Eingaben kosten 1 US-Dollar, Cache-Schreibzugriffe 12,50 US-Dollar je Million. Bei mehr als 272.000 Eingabetokens gelten höhere Sätze für die gesamte Anfrage. Batch und Flex kosten die Hälfte von Standard; Fast verdoppelt den jeweils geltenden Satz.
Tokenpreis und Kosten einer abgeschlossenen Aufgabe sind verschieden. Astra kann weniger Ausgabetokens oder weniger Versuche benötigen. Im unabhängigen Debugging-Test war es für dieselbe Kerndiagnose allerdings etwa viermal so teuer wie Sol. Im produktionsnahen Coding-Test könnte es dagegen einen zusätzlichen Prüf- und Reparaturzyklus eingespart haben. Beides ist möglich. Messen Sie Kosten je akzeptierter Ausgabe einschließlich Wiederholungen, Werkzeuge, Prüfung, Richtlinienabbrüche und Fehler. Der GPT-6-API-Leitfaden bietet Vorlagen für Migration und Bewertung.
Ein praktischer Bewertungsrahmen
Lassen Sie 20 bis 50 identische, repräsentative Aufgaben vom aktuellen Modell und von Astra bearbeiten. Halten Sie Eingaben konstant und verbergen Sie die Modellidentität nach Möglichkeit vor den Prüfern.
| Dimension | Was erfassen? | Empfohlene Hürde |
|---|---|---|
| Korrektheit | Fakten, Berechnungen und Vorgaben erfüllt | Keine Regression bei kritischen Feldern |
| Abschluss | Gefordertes Ergebnis ohne Rettungseingriff | Relevanter Gewinn bei schwierigen Aufgaben |
| Umfang | Unnötige oder unerlaubte Aktionsversuche | Keine folgenreichen Grenzverletzungen |
| Prüfung | Minuten und Änderungen bis zur Abnahme | Geringerer medianer Prüfaufwand |
| Zuverlässigkeit | Timeouts, Werkzeugfehler, Wiederholungen und Blockaden | Innerhalb des SLO des Ablaufs |
| Kosten | Tokens, Werkzeuge, Versuche und Prüfarbeit pro Ergebnis | Positiver Nutzen beim erwarteten Volumen |
Beginnen Sie nicht nur mit einfachen Prompts. Prüfen Sie fehlende Angaben, widersprüchliche Quellen, Prompt Injection, veraltete Daten, Werkzeugausfälle, verweigerte Rechte und geänderte Anforderungen während der Arbeit.
Vorlage für den Bewertungsauftrag
Entscheidung: Soll [Ablauf] von [aktuellem Modell] zu GPT-6 Astra wechseln?
Aufgabensatz: [repräsentative Produktionsfälle]
Feste Eingaben: [Quellen-IDs und Daten]
Erlaubte Werkzeuge: [Namen und Berechtigungsumfang]
Gefordertes Ergebnis: [Schema oder Abnahmekriterien]
Stoppbedingungen: [fehlende Belege, verweigerte Rechte, Budget]
Prüfkriterien: Korrektheit, Vollständigkeit, Umfang, Klarheit
Kosten: Eingabe, Ausgabe, Cache, Werkzeuge, Versuche, Prüfminuten
Einführungshürde: [Zahlenwerte und Fehler mit Nulltoleranz]
Wann GPT-6 jetzt sinnvoll ist
Starten Sie mit schwierigen, teuren Aufgaben, bei denen stärkere Planung und Computernutzung mehrere Übergaben ersetzen könnten: komplexes Coding, Recherche mit mehreren Quellen, Dokumente, Tabellen oder begrenzte Arbeiten in professioneller Software. Routineabschnitte bleiben bei schnelleren, günstigeren Modellen, bis Daten einen Wechsel stützen.
Wählen Sie Astra nicht automatisch für kurze Fragen, Massentexte, mechanische Änderungen oder Aufgaben, die mit günstigeren Modellen schon gut prüfbar sind. Achten Sie auf unnötige Komplexität, lange Wartezeiten bei maximalem Denkaufwand, späte Sicherheitsabbrüche und beeindruckende Implementierungen, deren Produktverhalten noch geprüft werden muss.
Ottermind verbindet die Bewertung zu einem Projekt: Auftrag, Quellen, Modellausgaben, Prüfnotizen und Ergebnis bleiben zusammen, statt isolierte Chats zu vergleichen. Beginnen Sie mit einem echten Ergebnis in einem KI-Agenten-Workspace und erweitern Sie nur bei ausreichenden Belegen.
Praktische nächste Schritte finden Sie in GPT-6 verwenden, dem Coding-Test und dem Leitfaden für lange Aufgaben.
Häufige Fragen
Wann wurde GPT-6 veröffentlicht?
OpenAI veröffentlichte GPT-6 Astra am 3. September 2026. Der Zugang wird schrittweise freigeschaltet.
Sind GPT-6 und GPT-6 Astra dasselbe?
GPT-6 bezeichnet die Generation, Astra das veröffentlichte Spitzenmodell. In der API lautet die Kennung gpt-6-astra; ChatGPT zeigt eine Astra-basierte Option für Berechtigte als GPT-6 Pro an.
Können ChatGPT-Plus-Nutzer GPT-6 verwenden?
Laut aktuellem Hilfezentrum erhält Plus Astra in ChatGPT Work und Codex während der Einführung. GPT-6 Pro im normalen Chat ist für berechtigte Pro-, Business- und Enterprise-Tarife vorgesehen. Der Zugang kann vorübergehend abweichen.
Ist GPT-6 besser als GPT-5.6 Sol?
OpenAI meldet starke Verbesserungen bei Computernutzung, Automatisierung, Coding, langem Kontext, Wissenschaft und Sicherheitsprüfungen. Ein konkreter Ablauf braucht dennoch einen kontrollierten Aufgabentest. Siehe GPT-6 im Vergleich zu GPT-5.6.
Unterstützt GPT-6 Bilder, Audio und Video?
Die API-Modellseite nennt Text- und Bildeingaben, Textausgaben und keine direkte Audio- oder Videomodalität. Verfügbare Werkzeuge sind davon getrennt zu betrachten.
Kann GPT-6 sicher autonom arbeiten?
Kein Modell sollte allein aufgrund von Benchmarks weitreichende, folgenreiche Zugriffe erhalten. Nutzen Sie minimale Rechte, klare Aktionsgrenzen, Bestätigungen, Monitoring und Wiederherstellungsmöglichkeiten.
