
三條可以直接複製的 Sora 提示詞
這類提示詞已發布的範例都是同一個形狀:一句話說清發生什麼、在哪裡、怎麼打光、怎麼拍。下面三條按這個形狀分別寫了一個運動鏡頭、一個單一動作和一個雙取景段落。
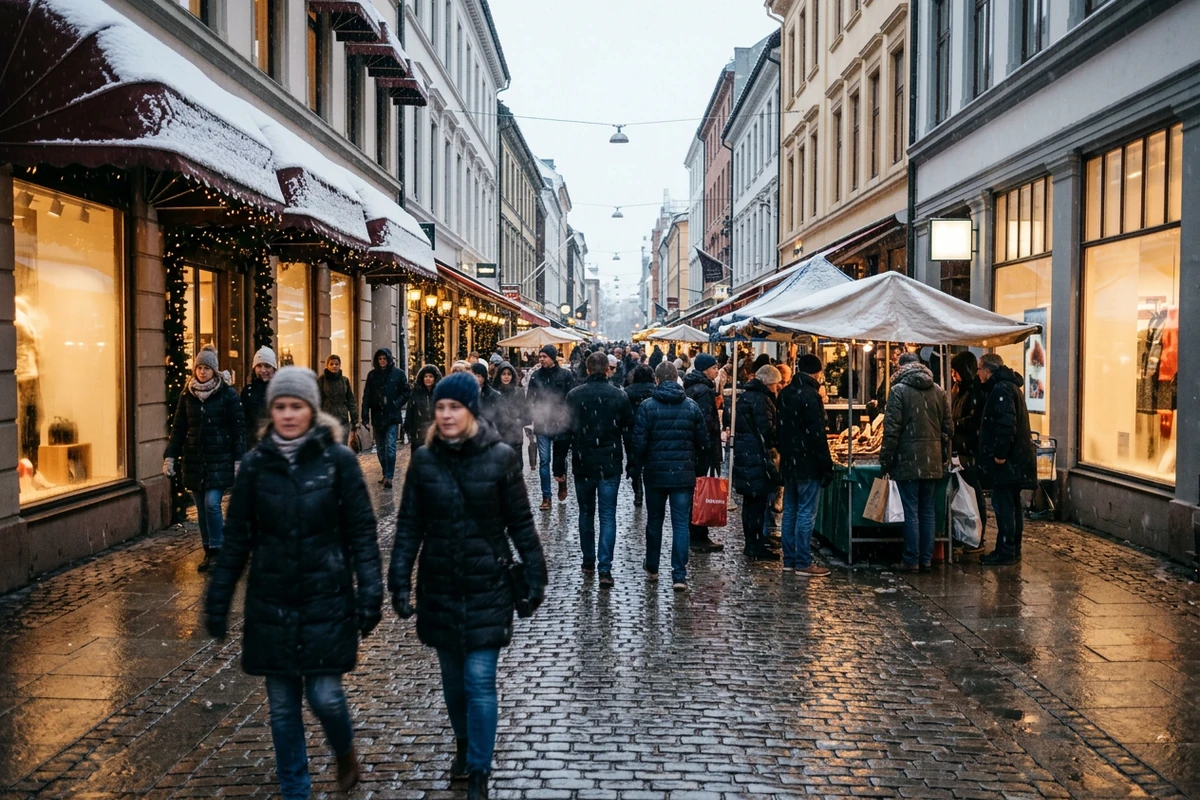
運動鏡頭
鏡頭向前推進,穿過一條下著小雪的繁忙商業街。幾個穿冬衣的人從攤位旁慢慢走過,呼出的白氣可見,雪積在遮陽篷和潮濕的鵝卵石路面上,店鋪暖光透過起霧的玻璃亮著。陰天的傍晚光線,店面是唯一的暖色點綴。廣角鏡頭,深焦,自然色彩,照片級寫實,畫面中不要出現可讀文字或浮水印。
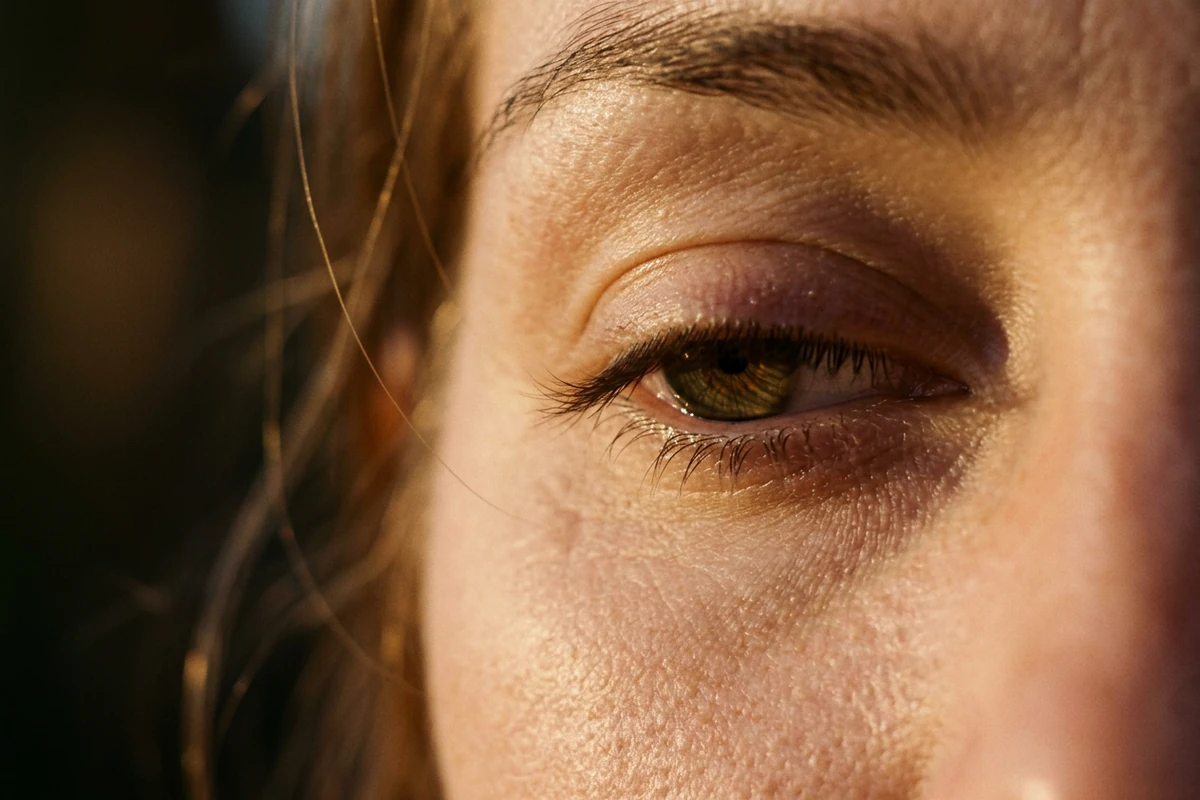
單一動作
一位女性眼睛眨到一半的極近特寫,睫毛停在開合之間,側面照來低而暖的黃昏陽光,虹膜裡有一個小反光點,其餘部分落進柔和陰影。微距鏡頭,極淺景深,真實皮膚質感。只做一個動作,就是這次眨眼,畫面裡沒有其他運動。自然色彩,不要出現可讀文字或浮水印。
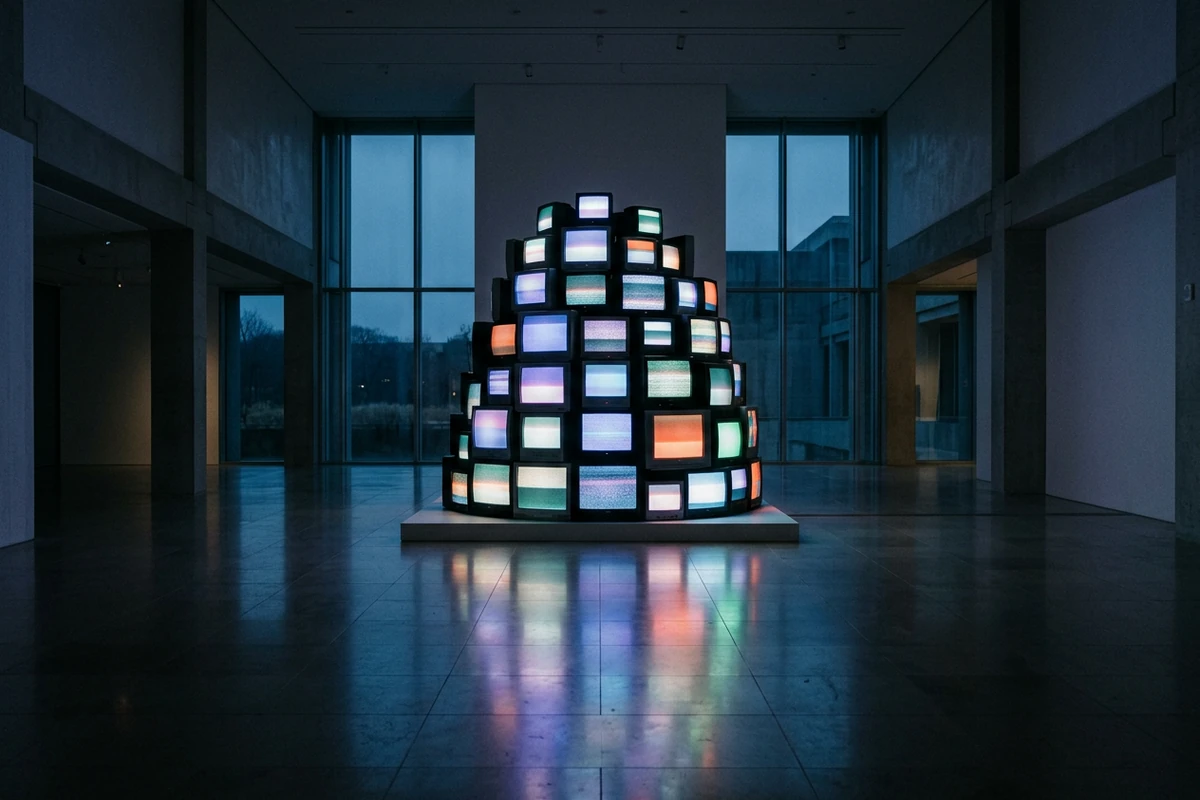
雙取景段落
夜晚一座大型美術館,房間中央的基座上堆著一疊高高的老式電視機,每塊螢幕都亮著,但只顯示抽象的色彩輝光和輕微雜訊。鏡頭先以全景開場,再向那疊電視推近,兩個取景保持同樣的冷藍環境光和同樣的觀感。抛光地面映出輝光,畫面裡沒有人,螢幕上沒有可讀內容,也沒有浮水印。
一句話,按主體到鏡頭的順序來讀
這個模型配用的提示詞風格不是參數清單,而是一句描述性的話;出問題的地方,正是那些要求模型自述有困難的內容。
按主體、動作、地點、光線、鏡頭的順序寫
先主體,再發生什麼,再在哪裡,再怎麼打光,最後怎麼拍。已發布的範例都按這個順序,而不是堆一串逗號分隔的風格詞,順序也讓「該改哪一句」變得一目了然。AI 提示詞產生器 能把碎片清單重排成這句話。
鏡頭只留一個平實運動
鏡頭指令是最常被誤讀的部分:有描述的運鏡軌跡被指出是模型容易理解錯的東西,所以一個清楚的運動——比如向前推進或環繞一圈——勝過一串方位。圖片轉影片 從一張已經定住這個運動的畫面開始。
繞開公開報導的短處寫
公開綜述提到它在物理模擬和因果關係上較吃力,空間與事件細節也偏弱。所以動作只留一件事,把空間寫實而不是暗示,也不要串聯互相依賴的事件。免費 AI 照片轉影片 可以低成本試這樣一個鏡頭。
在 Ottermind 裡怎麼寫一條 Sora 提示詞
第 1 步:寫成一句話
按順序點明主體、那一個動作、地點、光線和鏡頭,然後停手。如果需要第二個動作,那其实是兩個鏡頭。AI 提示詞產生器 能撐住這個結構。
第 2 步:先把開場那一格渲染出來
把鏡頭先當一張靜格生成,確認光線和鏡頭之後再花一次影片渲染。圖片轉影片 會把這張確認過的格動起來,並保留你認可的觀感。
第 3 步:只動一個運鏡,然後對比幾條
給短片一個運鏡,其餘措辭在各條之間保持不變,這樣一條不理想的結果就能歸因到某一句話。AI Reel 產生器 會把幾條按順序留好。
第二次提問在哪裡划算
當一個鏡頭必須描述得夠清楚、讓別人或另一個模型也能重現時,一句話的影片提示詞才開始回本。
社群平台短片
一個清楚的動作放在一個清楚的空間裡,是能扛住豎版短切片的形狀,因為提示詞裡沒有留給模型含糊處理的東西。寫好那一句話,再讓 AI Reel 產生器 把幾條排好。
正式渲染前先做分鏡
影片渲染是貴的那一步,所以先把鏡頭當靜格搭出來,確認光線和取景確實是你的意思。AI 影片示範產生器 是完整渲染前的那次快速過一遍。
要交接出去的鏡頭
當需求交給另一個人或另一個模型時,一條點名了光線和鏡頭的一句話提示詞,對方不用問你想表達什麼就能直接跑。免費 AI 照片轉影片 會把這張靜格留作共同起點。
Sora 提示詞常見問題
一條 Sora 提示詞能描述多長的片段?
公開綜述稱影片大約可達一分鐘,但一個清楚的動作放在一個清楚的空間裡,比一分鐘的事件長鏈更容易保持連貫。寫你能用一句話說清的鏡頭。圖片轉影片 會把每一條錨定在你確認過的格上。
為什麼我的鏡頭指令被忽略了?
因為有描述的運鏡軌跡被指出是模型容易讀錯的東西。把一串方位換成一個平實運動,比如向前推進,其餘部分不要動,這樣鏡頭那句話就是唯一的變數。AI 提示詞產生器 只重寫那一句。
這個模型哪裡比較弱?
公開綜述提到物理和因果關係較吃力,空間與事件細節也偏弱。把動作收斂成一件事,把空間寫清楚,並避開後半段依賴前半段的提示詞。免費 AI 照片轉影片 可以低成本試出來。
提示詞應該寫一句還是幾句?
一句話是已發布範例的慣例,也和鏡頭的讀法對應:主體、動作、地點、光線、鏡頭。要寫一段取景序列時可以用幾句,模型能把它當作多個鏡頭並保持一致觀感。AI 影片產生器 負責這些渲染。
可以免費先試一試嗎?
Ottermind 的公開體驗無需登入即可使用,並包含有限次數的免費回合;帳戶額度和方案限制仍可能適用。先把鏡頭當靜格試一次,這樣一次回合就能告訴你行不行,再去 AI 圖像生成。
這一頁是官方的嗎?這些說法從哪來?
不是,本頁與模型廠商無關聯,也未獲其背書,這裡不複製任何廠商文件。工藝說明描述的是已發布範例庫裡共有的提示詞形狀,限制類說明則轉述公開綜述已經報導的內容。
你可能也喜歡的提示詞主題
把這句話變成一個鏡頭
寫下那一句話,渲染出格,然後只動一個運鏡,並且之後只改那一句,直到鏡頭讀起來和你描述的一樣。