Comparação de modelos
GPT-6 vs GPT-5.6: Astra e Sol no trabalho real
GPT-6 Astra é a opção mais forte para os trabalhos mais difíceis com várias etapas; GPT-5.6 Sol continua sendo um padrão mais prático quando latência, disponibilidade e custo pesam mais do que capacidade de ponta. Os resultados divulgados pela OpenAI mostram os maiores ganhos do Astra em uso do computador, automação, recuperação em contexto longo, ciência e cibersegurança. A atualização não tem o mesmo valor para todo prompt.
Escolha pelo custo do trabalho aprovado, não pelo número do modelo. Se uma solicitação rotineira já é correta, rápida e barata no GPT-5.6, migrá-la para GPT-6 pode aumentar a conta sem melhorar o resultado. Se o fluxo falha repetidamente em coordenação de ferramentas, raciocínio complexo, contexto longo ou criação de entregas profissionais, vale avaliar Astra de forma controlada.
Fontes: anúncio do GPT-6; página do modelo; orientações para desenvolvedores; visão geral de segurança; Astra na Artificial Analysis; comparação do GPT-5.6 Sol; teste de depuração pela API; comparação de programação baseada em produção. Consultadas em 7 de setembro de 2026.
Comparação rápida
| Fator de decisão | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| Melhor uso | Fluxos difíceis de ponta a ponta | Trabalho geral com menor custo operacional |
| Janela de contexto | 1.050.000 tokens | Confira a página atual da variante implantada |
| Saída máxima | 128.000 tokens | Confira a página atual da variante implantada |
| Esforço de raciocínio | De low a max; sem none | Diversos controles, incluindo opções específicas de cada produto |
| Novidades para fluxos | Ferramentas assíncronas, direcionamento durante o turno e atualização de raciocínio na conversa | Fluxos consolidados com ferramentas e Responses API |
| Entrada na API Standard | US$ 10 por milhão de tokens | Menor; confirme o preço atual |
| Saída na API Standard | US$ 50 por milhão de tokens | Menor; confirme o preço atual |
| Disponibilidade | Liberação gradual; sem nível gratuito na API | Mais ampla nos produtos elegíveis da OpenAI |
| Pontuação independente de inteligência | 55 no esforço max | 51 no esforço max |
| Velocidade independente de saída | 64,3 tokens por segundo no max | Cerca de 76 tokens por segundo no max |
| Custo independente por tarefa do índice | US$ 2,57 no max | US$ 1,25 no max |
| Postura operacional | Priorizar trabalhos difíceis e de alto valor | Manter como referência para trabalhos rotineiros e mistos |
As medições independentes são recortes da Artificial Analysis e mudam conforme os provedores e testes são atualizados. Mostram um ganho moderado em inteligência geral, saída mais lenta e custo por tarefa de benchmark aproximadamente dobrado, não um salto universal. Use as páginas atuais dos modelos ao calcular uma contratação.
Testes independentes e a narrativa do lançamento
O relato de acesso antecipado de Claire Vo descreve avanços em uma funcionalidade do ChatPRD que ela não conseguia concluir com Sol e Fable. Isso justifica testar Astra em trabalhos antes bloqueados, mas sucessos selecionados não mostram o ganho típico sobre Sol. Preserve tarefa, estado do repositório e critérios de aceitação ao reproduzir uma comparação.
A análise de Matt Shumer favorece Astra na engenharia cotidiana e mantém Claude para trabalho visual. Sua preferência mostra por que um modelo pode virar padrão mesmo com tokens caros: comunicação e menor necessidade de supervisão podem importar mais do que velocidade de geração. Continua sendo uma avaliação pessoal, não um resultado controlado entre Astra e Sol.
Nossa recomendação, portanto, se aplica a equipes com orçamento definido: mantenha uma referência que funciona e teste Astra nos casos que hoje exigem mais intervenção. Pessoas com outros tipos de trabalho podem, com razão, escolher de forma diferente.
Os maiores ganhos reportados pela OpenAI aparecem em avaliações de agentes, uso do computador e contexto longo. A Artificial Analysis apresenta um resultado geral mais limitado: Astra max marcou 55 no Intelligence Index, contra 51 de Sol max. Astra gerou menos tokens de saída do que a mediana do serviço, mas sua velocidade de saída foi inferior à de Sol e o tempo até o primeiro token no max foi alto.
Um teste de depuração pela API constatou que Astra e três variantes do GPT-5.6 diagnosticaram o mesmo problema. Astra ofereceu a melhor ressalva e o melhor plano de confirmação, mas levou aproximadamente o dobro do tempo e custou cerca de quatro vezes mais que Sol. Isso favorece Astra quando a ressalva ausente poderia causar um erro caro, não quando a tarefa consiste apenas em indicar um comando ou uma causa provável.
Outro teste, baseado em uma tarefa de produção, comparou Astra com GPT-5.6 Terra, não com Sol. As duas implementações passaram na suíte existente, mas Terra quebrou estados de paginação interdependentes; Astra preservou a relação e acrescentou um teste. O autor passou a encaminhar trabalho interdependente em múltiplos domínios para Astra, mantendo modelos mais baratos nas mudanças comuns e mecânicas. Esse padrão é mais defensável do que substituir todos os modelos.
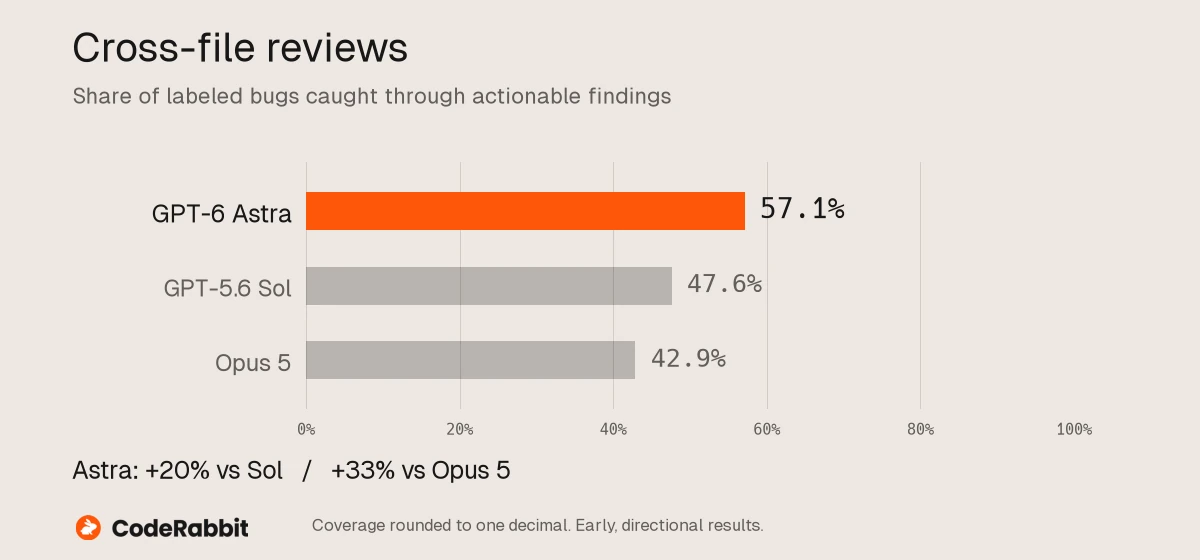
Resultados de revisão entre arquivos publicados pela CodeRabbit. São dados iniciais, não uma medida da qualidade geral de revisão.
Onde os ganhos do GPT-6 são mais claros
As avaliações de lançamento da OpenAI oferecem uma comparação útil em condições semelhantes, pois os dois modelos foram testados pelo mesmo responsável. Ainda exigem cautela: algumas são internas, as pontuações usam o melhor esforço e os prompts de sistema e ferramentas de produção podem alterar os resultados.
| Avaliação | GPT-6 Astra | GPT-5.6 Sol | Possível significado |
|---|---|---|---|
| OSWorld 2.0 offline | 72,6% | 65,7% | Melhor operação de ambientes de desktop |
| AutomationBench | 41,4% | 18,1% | Grande avanço em automações com várias etapas |
| Terminal-Bench 4.0 | 57,9% | 37,3% | Melhor trabalho de engenharia pelo terminal |
| Tarefas internas de migração de banco de dados | 63,9% | 42,7% | Potencial ganho em mudanças longas e com estado |
| FrontierMath Tier 4 v2 | 97,6% | 83,0% | Raciocínio matemático avançado mais forte |
| MRCR v2, 512K a 1M | 96,3% | 73,8% | Melhor recuperação em contextos muito longos |
| ARC-AGI-3 | 99,9% | 7,8% | Grande ganho reportado em tarefas interativas novas |
Astra não domina toda comparação publicada contra todos os concorrentes. A análise de benchmarks da DataCamp observa que ele fica atrás do Claude Fable 5.1 no Humanity's Last Exam com ferramentas e que o resultado de 99,9% no ARC-AGI-3 depende de um ambiente de execução com estado e adaptador do provedor. Uma chamada de API sem estado não deve reproduzir automaticamente essa manchete. Use os resultados para decidir o que testar, não o que implantar.
Uso do computador e fluxos com agentes
Esse é o motivo mais forte para avaliar GPT-6. A OpenAI projetou Astra para trabalhar com código, navegadores, documentos, planilhas, apresentações e software profissional. Chamadas assíncronas permitem continuar o raciocínio independente enquanto a aplicação executa uma ferramenta lenta. O direcionamento durante o turno permite corrigir uma sessão longa sem reiniciá-la.
GPT-5.6 Sol já aceita ferramentas e fluxos com agentes. Mantenha Sol quando a sequência for curta, as permissões restritas e o resultado atingir os critérios de aceitação. Teste Astra quando o fluxo perder o fio da tarefa, interpretar mal instruções novas, tiver dificuldade entre interfaces ou exigir tentativas demais.
A arquitetura ao redor não desaparece com um modelo melhor. Autenticação, esquemas de ferramentas, autorização, estado, auditoria, aprovação e rollback pertencem à aplicação. Veja esses limites no guia de arquitetura de agentes de IA.
Contexto e memória não são a mesma coisa
A janela de 1,05 milhão de tokens do Astra comporta muitas fontes, mas é uma capacidade temporária da solicitação. Ela não se torna automaticamente uma memória durável e correta de cliente, projeto ou política. Memória de longo prazo exige identificação de fontes, regras de atualização, resolução de conflitos, exclusão, controle de acesso e visibilidade para o usuário.
Use contexto longo para um acervo delimitado que precisa ser considerado em conjunto. Use recuperação para um acervo maior e mutável. Mantenha estado durável de projeto para decisões e entregas aprovadas que precisam sobreviver entre execuções. O guia de gestão de conhecimento com IA explica como preservar a procedência, em vez de tratar resumos gerados como fonte da verdade.
Custo: compare trabalho concluído, não apenas tokens
A API Standard do GPT-6 Astra custa US$ 10 por milhão de tokens de entrada e US$ 50 por milhão de tokens de saída. Prompts acima de 272.000 tokens de entrada recebem tarifas maiores para toda a solicitação. Cache, ferramentas, Fast, Batch e Flex têm tarifas próprias.
Astra ainda pode sair mais barato em uma tarefa difícil se consumir menos tokens, evitar tentativas ou reduzir a revisão humana. Por outro lado, até uma resposta perfeita pode ser pouco econômica em uma classificação de alto volume que não ganha nada com raciocínio de ponta.
O teste prático de depuração dá uma escala concreta: aproximadamente US$ 0,194 e 75,5 segundos para Astra, contra US$ 0,048 e 39,3 segundos para Sol. Todos chegaram ao mesmo diagnóstico central; Astra agregou uma limitação mais precisa e um plano de verificação. Um prompt não estabelece uma média, mas oferece um contraponto útil às alegações de eficiência em tokens.
Use este cálculo:
custo por tarefa aprovada =
  entrada do modelo + saída do modelo + cache + ferramentas
  + tentativas malsucedidas + revisão humana + correções

valor da atualização =
  erros evitados + trabalho poupado + redução do ciclo
  - custo adicional por tarefa aprovada
Meça os dois modelos com as mesmas entradas. Não considere o tempo de revisão como zero; muitas vezes ele é o maior custo oculto.
Segurança e controle
A OpenAI afirma que Astra é mais resistente a jailbreaks, injeção de prompt e comportamento fora do escopo que GPT-5.6 Sol. Em uma simulação interna com mais de 54.000 tarefas do Codex, Astra recebeu aproximadamente metade dos alertas de desalinhamento de maior gravidade. A empresa também reporta menor capacidade de monitorar seu raciocínio escrito em comparação com Sol.
Especialistas ouvidos pela TechRadar defenderam monitorar ações observáveis e manter a capacidade de interromper o agente durante uma ação, em vez de confiar no raciocínio escrito. Um relato inicial da comunidade também descreve sessões comuns de programação interrompidas por classificadores de cibersegurança após execuções longas. É um relato individual, mas a própria OpenAI alerta para interrupções de trabalho legítimo. Inclua falsos positivos e tempo perdido na comparação.
Esse conjunto de fatores muda a forma de avaliar:
- Teste ações e resultados reais, não apenas se o raciocínio parece tranquilizador.
- Dê a cada ferramenta um esquema restrito e um limite explícito de autorização.
- Inclua fontes adversariais e tarefas impossíveis no conjunto de avaliação.
- Exija confirmação para enviar, excluir, comprar, publicar ou alterar acesso.
- Mantenha um registro independente de entradas, chamadas, aprovações, saídas e decisões de revisão.
Consulte o checklist de segurança para agentes de IA antes de conceder escrita a qualquer um dos modelos.
Qual modelo escolher?
Escolha GPT-6 Astra quando
- A tarefa for complexa a ponto de normalmente exigir várias tentativas ou passagens para pessoas.
- O uso do computador ou a coordenação entre ferramentas for central para o resultado.
- O conjunto de fontes for muito longo e omissões na recuperação forem caras.
- A entrega for um documento, análise, apresentação ou alteração de código de alto valor.
- Sua avaliação mostrar ganho mensurável nos resultados aprovados.
Mantenha GPT-5.6 Sol quando
- O fluxo atual já atingir suas metas de qualidade e confiabilidade.
- Velocidade ou economia em grande volume dominarem a decisão.
- A tarefa for curta, repetitiva, bem estruturada ou fácil de verificar.
- A disponibilidade ou os limites do GPT-6 não atenderem ao serviço.
- A equipe ainda não tiver um processo de avaliação e revisão.
Quando distribuir tarefas entre os dois
A maioria dos sistemas de produção não precisa fazer uma migração binária. Comece com a referência mais barata e escale conforme sinais observáveis: volume de fontes, risco da tarefa, falha de validação, número de ferramentas ou qualidade solicitada pelo usuário. Mantenha a regra simples o bastante para ser auditada.
Modelo de avaliação lado a lado
Fluxo: [nome]
Modelo atual: GPT-5.6 Sol
Candidato: GPT-6 Astra
Casos: [20-50 tarefas representativas]

Pontue cada item de 0 a 2:
- Fatos e cálculos corretos
- Restrições exigidas atendidas
- Entrega completa e utilizável
- Escopo autorizado respeitado
- Fontes e incertezas visíveis

Registre separadamente:
- Tempo decorrido
- Custo de entrada/saída/cache/ferramentas
- Tentativas e falhas
- Minutos de revisão e alterações

Implante somente se:
- Não houver regressão crítica de segurança ou escopo
- O ganho de qualidade for relevante na prática e estatisticamente
- O custo por tarefa aprovada couber na previsão de volume
Um plano prático de implantação
- Fixe entradas representativas de produção e critérios de aceitação.
- Execute os dois modelos com ferramentas e permissões equivalentes.
- Oculte a identidade do modelo do avaliador quando possível.
- Inspecione falhas, não apenas médias.
- Encaminhe uma pequena parcela de trabalho elegível ao Astra.
- Acompanhe custo por tarefa aprovada, correções, incidentes e intervenções do usuário.
- Amplie apenas os segmentos que continuarem gerando valor.
O Ottermind pode reunir arquivos de origem, resultados comparativos, decisões de revisão e entregas finais em um projeto. Use um workspace de agentes de IA para avaliar o fluxo completo, em vez de colecionar capturas de conversas desconectadas.
Perguntas frequentes
GPT-6 Astra é sempre melhor que GPT-5.6 Sol?
Não. Astra é mais capaz em muitas avaliações publicadas, mas Sol pode ser mais rápido, mais barato, mais disponível e já suficiente para tarefas rotineiras.
O GPT-6 compensa o preço maior da API?
Pode compensar em tarefas difíceis se reduzir tentativas, revisão ou falhas. Calcule o custo por tarefa aprovada incluindo ferramentas e trabalho humano.
GPT-6 substitui GPT-5.6?
Não automaticamente. A OpenAI continua oferecendo modelos GPT-5.6 em seus produtos. Um sistema bem planejado pode enviar trabalho rotineiro ao GPT-5.6 e reservar GPT-6 aos casos mais difíceis.
Qual é melhor para programação?
A OpenAI reporta pontuações maiores do Astra no Terminal-Bench 4.0 e em várias avaliações de programação, especialmente nas tarefas internas de migração de banco de dados. Teste ambos nos seus repositórios, instruções e critérios de CI.
Qual é melhor para documentos longos?
Astra tem janela de 1,05 milhão de tokens e melhor recuperação em contexto longo segundo a OpenAI. Isso não substitui seleção de documentos, citações, tratamento de conflitos ou revisão humana.
Posso manter os mesmos prompts na migração?
Comece com o mesmo contrato de tarefa para obter uma referência justa e ajuste após examinar as falhas. O guia da API do GPT-6 inclui um checklist de migração.
