Guide technique
API GPT-6 : guide des tarifs, du contexte, des outils et de la migration
Utilisez gpt-6-astra dans la Responses API d'OpenAI pour développer avec GPT-6. Le modèle accepte le texte et les images en entrée, produit du texte et prend en charge les appels de fonctions, Structured Outputs, le streaming et les outils hébergés par OpenAI. Sa fenêtre de contexte atteint 1 050 000 tokens, sa sortie maximale 128 000 tokens. Le tarif Standard est de 10 $ US par million de tokens d'entrée et de 50 $ US par million de sortie.
Une migration en production ne se résume pas à changer le nom du modèle. GPT-6 ajoute les appels d'outils asynchrones, le pilotage pendant un tour et les mises à jour du raisonnement dans une conversation. Ces fonctions touchent l'état de session, les appels en attente, les annulations, l'observabilité et les coûts. Commencez avec un jeu d'évaluation figé et une petite part des tâches confiée au nouveau modèle.
Sources: fiche du modèle; guide du modèle; migration vers Responses API; annonce; présentation de la sécurité; Artificial Analysis; tests pratiques des coûts et de l'effort; test de programmation issu de la production. Consultées le 7 septembre 2026.
Fiche pratique
| Paramètre | Valeur actuelle |
|---|---|
| Identifiant du modèle | gpt-6-astra |
| API recommandée | Responses API |
| Fenêtre de contexte | 1 050 000 tokens |
| Sortie maximale | 128 000 tokens |
| Date limite des connaissances | 30 avril 2026 |
| Effort de raisonnement | low, medium, high, xhigh, max |
| Texte | Entrée et sortie |
| Images | Entrée uniquement |
| Modalités audio et vidéo | Pas de prise en charge directe |
| Appels de fonctions | Pris en charge |
| Structured Outputs | Pris en charge |
| Ajustement fin | Non pris en charge |
| Niveau gratuit de l'API | Non pris en charge |
Ce que montrent les tests d'API externes
La première leçon est claire : la configuration compte autant que le nom du modèle.
Artificial Analysis a testé Astra max via l'API d'OpenAI. Dans son relevé actuel, il obtient 55 à l'Intelligence Index, produit 64,3 tokens par seconde, coûte 2,57 $ US par tâche de l'indice et met environ 355 secondes à produire son premier token au raisonnement maximal. Max est un réglage volontairement coûteux, mais ces résultats montrent pourquoi l'intégration doit rendre visibles effort, latence et coût, au lieu de les masquer derrière l'étiquette gpt-6-astra.
ComputingForGeeks a confirmé les tarifs annoncés par un appel réel, puis soumis le même problème de débogage à différents modèles et efforts. Dans cette comparaison, Astra consomme 3 525 tokens de raisonnement, prend 75,5 secondes et coûte environ 0,194 $ US. Sol prend 39,3 secondes pour environ 0,048 $ US. Le diagnostic est identique, mais Astra ajoute une réserve et de meilleures étapes de confirmation.
L'auteur rapporte aussi que passer de low à max sur la même question à Astra multiplie presque par 10 le coût et par huit la latence. Low avait déjà trouvé les trois causes ; l'effort supérieur fournit un plan plus complet, puis atteint la limite de sortie de 6 000 tokens fixée pour l'essai. Ce cas unique soutient un réglage initial prudent : commencer à medium, augmenter l'effort pour une raison mesurée et plafonner la sortie.
Le test de programmation issu de la production illustre l'autre côté du bilan. Astra a évité un défaut d'état entre composants qu'un modèle moins cher avait livré malgré des tests au vert. L'appel d'API isolé peut coûter plus cher alors que la tâche acceptée coûte moins après révision et réparation. Votre évaluation doit mesurer les deux.
La fiche mentionne aussi la recherche web et documentaire, la génération d'images, l'interpréteur de code, le shell hébergé, l'application de correctifs, les skills, l'usage de l'ordinateur, MCP et la recherche d'outils dans Responses API. La compatibilité d'un outil ne signifie pas qu'il est activé, autorisé ou adapté à votre application.
Ce qu'une démonstration ne prouve pas sur l'API
Le récit de Matt Shumer indique que ses plus grands essais reposaient sur des sessions coordonnées et une forte consommation de tokens ; les longues exécutions pouvaient plafonner. Il faut donc mesurer l'avancement vers l'acceptation, pas seulement le temps écoulé. Un processus peut continuer à produire du texte sans améliorer le livrable.
Les notes de l'épisode de Claire Vo mettent en avant la QA dans le navigateur en plus de l'implémentation. Pour une application API, la question est de savoir si l'environnement peut inspecter le résultat final. Prévoyez des tests de comportement pour le code et de sources pour les documents : une simple réponse textuelle ne reproduit pas une démonstration riche en outils.
Ces retours orientent la conception des tests. Ils ne valident ni paramètres API, ni facturation, ni taux général de réussite.
Requête minimale avec Responses API
Utilisez la version du SDK officiel recommandée par le guide de démarrage actuel. Une requête JavaScript minimale a cette forme :
import OpenAI from "openai";

const client = new OpenAI();

const response = await client.responses.create({
  model: "gpt-6-astra",
  reasoning: { effort: "medium" },
  input: [
    {
      role: "developer",
      content: "Return a concise, source-grounded decision brief.",
    },
    {
      role: "user",
      content: "Compare the attached proposals against the approval criteria.",
    },
  ],
});

console.log(response.output_text);
Conservez les clés API dans les secrets gérés par l'environnement, jamais dans les prompts, le code source, le code client ou les journaux. Validez l'objet réellement renvoyé : output_text n'est pas forcément la seule sortie, car des appels d'outils et éléments structurés peuvent être présents.
Choisir l'effort de raisonnement
GPT-6 Astra n'accepte pas none. Évaluez d'abord low ou medium, puis augmentez seulement là où la qualité compense la latence et le coût. Les tableaux d'OpenAI affichent les meilleurs scores obtenus parmi les efforts ; un benchmark mis en avant ne garantit donc pas le même résultat avec votre réglage.
Vous pouvez partir de cette répartition :
| Signal de la tâche | Effort initial |
|---|---|
| Transformation courte et délimitée | Low |
| Analyse multisource avec critères clairs | Medium |
| Planification, code ou coordination difficiles | High |
| Problème rare à forte valeur après échec d'un effort inférieur | Xhigh ou max |
Enregistrez l'effort de chaque exécution. Sinon, une régression pourra sembler venir du modèle alors qu'elle provient d'une configuration différente. Fixez aussi un budget de sortie : le raisonnement caché est facturé comme sortie, et un effort élevé peut coûter beaucoup avant que la réponse visible soit terminée.
Modifier le raisonnement pendant une conversation
OpenAI documente les éléments d'entrée configuration_update, qui modifient l'effort tout en préservant le préfixe en cache. C'est utile lorsqu'une session simple rencontre une exception difficile, ou quand une phase complexe cède la place à des suites courantes.
L'application doit enregistrer la chronologie des réglages, pas seulement le dernier. Une exécution passant de low à max n'a pas le même coût ou la même latence attendue qu'une exécution restant en low.
Appels d'outils asynchrones
Avec une fonction asynchrone ou un outil personnalisé, Astra peut continuer le travail indépendant du résultat pendant que l'application effectue l'appel. Renvoyez le résultat prêt avec l'identifiant original de l'appel.
Cette exécution introduit les problèmes classiques des systèmes distribués :
- Un résultat peut arriver après l'annulation ou la modification de la tâche.
- Deux appels peuvent finir dans un ordre différent.
- Le délai peut être dépassé après une écriture externe réussie.
- Répéter un appel non idempotent peut dupliquer une action.
- Le modèle peut achever tout le travail indépendant alors qu'un appel nécessaire reste en attente.
Conservez une machine à états comprenant pending, completed, failed, cancelled et expired. Utilisez des clés d'idempotence pour les écritures, consultez le système de référence avant de recommencer et rejetez les résultats tardifs d'une version obsolète de la tâche.
Pilotage en cours de tour
Une connexion WebSocket permet à l'application d'envoyer de nouvelles consignes utilisateur pendant le travail. Les tâches longues deviennent plus faciles à corriger sans redémarrer, mais l'intention doit être versionnée.
Horodatez chaque changement de direction et indiquez les actions pendantes qu'il invalide. Un changement de public pour un rapport peut laisser la rédaction continuer. Un changement de compte ou de destination d'une action externe impose une pause jusqu'à validation et approbation du nouveau périmètre.
Sorties structurées et outils
Utilisez Structured Outputs lorsque le code en aval exige un schéma. Celui-ci valide la forme, pas la vérité. Vérifiez les identifiants autorisés, recalculez les totaux indépendamment et contrôlez les sources citées avant d'accepter l'objet.
Préférez des outils à fonction limitée :
Préférer : create_draft_invoice(customer_id, line_items)
Éviter :   run_shell(command)

Préférer : search_approved_project_sources(query, project_id)
Éviter :   browse_any_url(url)
C'est l'application, pas le prompt, qui doit faire respecter l'identité, le périmètre du tenant, les arguments autorisés, les budgets et les confirmations. Consultez l'architecture des agents IA avant de connecter des systèmes de production.
Usage de l'ordinateur
GPT-6 Astra est le meilleur modèle d'usage de l'ordinateur selon OpenAI, mais les interfaces visuelles ne sont pas déterministes et peuvent changer entre observation et action. Traitez clics et frappes comme des opérations proposées :
- Limitez l'application, le compte et le périmètre disponibles.
- Capturez l'état ayant servi à la décision.
- Présentez les modifications importantes avant exécution.
- Exigez une confirmation pour envoyer, supprimer, publier, acheter ou changer des droits.
- Vérifiez le nouvel état par une lecture indépendante.
- Gardez assez de preuves pour diagnostiquer et annuler un échec.
Le guide des agents IA de bureau explique comment l'accès local à l'ordinateur modifie les risques.
Tarifs de l'API GPT-6
OpenAI affiche les tarifs suivants pour un million de tokens de texte :
| Poste | Tarif Standard |
|---|---|
| Entrée | 10,00 $ US |
| Entrée en cache | 1,00 $ US |
| Écriture du cache | 12,50 $ US |
| Sortie | 50,00 $ US |
Au-delà de 272 000 tokens d'entrée, les tarifs d'entrée et de cache sont doublés, et celui de sortie multiplié par 1,5, pour toute la requête. L'écriture du cache coûte 1,25 fois l'entrée sans cache. Batch et Flex sont à 50 % du Standard ; Fast double le tarif applicable. Les outils peuvent entraîner des frais distincts.
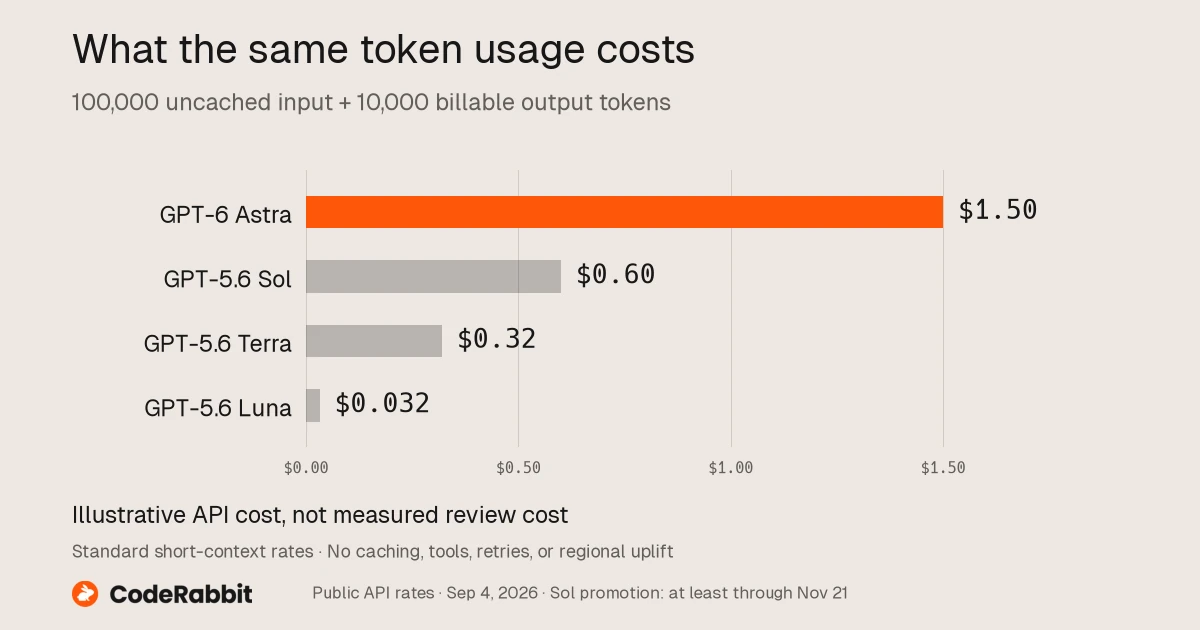
Illustration de CodeRabbit, à volume de tokens fixe et aux tarifs du 4 septembre 2026. Ce n'est pas un coût mesuré par tâche achevée.
Exemple de coût
Une requête Standard de 80 000 tokens d'entrée sans cache et 8 000 tokens de sortie revient approximativement à :
entrée : 80 000 / 1 000 000 x 10 $ US = 0,80 $ US
sortie :  8 000 / 1 000 000 x 50 $ US = 0,40 $ US
sous-total du modèle : 1,20 $ US
Cet exemple exclut outils, écritures du cache, reprises et révision. Au-delà du seuil de prompt long, les multiplicateurs modifient le calcul de la requête entière.
Organiser le cache des prompts
Placez les consignes stables, schémas et sources partagées avant le contenu utilisateur qui change souvent, afin de réutiliser un préfixe commun. Suivez séparément les tokens lus et écrits dans le cache. Ne gardez pas d'informations inutiles uniquement pour augmenter le taux de cache : elles peuvent distraire le modèle et compliquer les droits d'accès.
Versionnez ce préfixe. Si une politique, une source ou un schéma change, la trace doit indiquer précisément la version utilisée.
Limites de débit et disponibilité
La fiche GPT-6 donne les limites selon le niveau d'usage et exclut l'offre gratuite de l'API. Les limites peuvent augmenter avec l'utilisation et les dépenses. Prévoyez les réponses 429, la régulation de la file d'attente, l'annulation et un modèle de repli choisi explicitement. Pour une tâche critique ou sensible au schéma, ne basculez jamais silencieusement sans enregistrer le changement et revalider la sortie.
Le lancement annonce Zero Data Retention pour les clients API éligibles. Éligibilité, résidence des données et traitement de sécurité sont des exigences distinctes ; vérifiez chacune pour votre compte et votre région.
OpenAI avertit aussi que les protections renforcées peuvent arrêter du travail légitime. Un premier témoignage Codex décrit des tâches ordinaires sur un dépôt interrompues tardivement par la politique cyber. Considérez ce récit comme un cas à tester, pas un taux mesuré : enregistrez arrêts, temps perdu, configuration et capacité du repli à finir correctement.
Checklist de migration
- Figez 20 à 50 tâches représentatives et les résultats attendus.
- Notez modèle actuel, prompts, outils, effort, latence et coût par tâche acceptée.
- Changez d'abord uniquement le modèle pour obtenir une référence comparable.
- Examinez le nouveau comportement avant de réécrire les prompts.
- Testez le contexte long avec des preuves absentes, contradictoires ou périmées.
- Testez refus d'outil, délai dépassé, résultat dupliqué et annulation.
- Testez l'injection de prompt dans les fichiers et pages web.
- Validez Structured Outputs au-delà du simple schéma.
- Ajoutez budgets et conditions d'arrêt à chaque exécution.
- Orientez une petite part des tâches éligibles avant d'élargir.
- Fixez un snapshot lorsque la reproductibilité importe et qu'une version adaptée existe.
- Gardez un repli et un retour arrière testés.
Pour choisir le modèle, lisez le comparatif GPT-6 et GPT-5.6.
Modèle d'évaluation en production
Processus : [nom et responsable]
Modèle : gpt-6-astra
Effort de raisonnement : [low/medium/high/xhigh/max]
Version du prompt : [ID]
Sources : [identifiants, droits, date de recherche]
Outils : [schémas, périmètres, délais, idempotence]
Contrat de sortie : [schéma et contrôles sémantiques]
Validations humaines : [actions nécessitant une confirmation]
Budgets : [tokens, outils, coût, temps]
Échecs : [réessayer, repli, arrêt, escalade]
Acceptation : [seuils de qualité, sécurité, latence et coût]
Audit : [entrées, appels, approbations, sorties, décision du relecteur]
Ottermind peut conserver brief d'évaluation, sources, résultats, décisions de révision et livrable final dans un même espace. Commencez par un processus délimité et utilisez le guide d'ingénierie des prompts pour préciser le contrat avant d'ajouter des outils.
Questions fréquentes
Quel nom de modèle utiliser dans l'API GPT-6 ?
Utilisez gpt-6-astra dans l'API OpenAI.
Faut-il choisir Chat Completions ou Responses API ?
La fiche liste les deux, mais le guide GPT-6 utilise Responses API et les nouveaux mécanismes de travail dépendent de cette interface. Préférez Responses pour les nouvelles applications avec outils.
GPT-6 permet-il l'ajustement fin ?
La fiche actuelle indique qu'il n'est pas pris en charge.
GPT-6 peut-il traiter des images ?
Oui, l'entrée image est annoncée. La sortie image directe n'est pas une modalité du modèle, mais la génération d'images existe comme outil.
Combien coûte une requête GPT-6 ?
Cela dépend des entrées, sorties, cache, majorations de contexte long, mode, outils et reprises. Au 7 septembre 2026, les tarifs Standard de base sont de 10 $ US par million de tokens d'entrée et 50 $ US par million de sortie.
Peut-on envoyer un million de tokens à chaque appel ?
La fenêtre est de 1,05 million de tokens, mais cette capacité n'est pas une recommandation. Au-delà de 272 000 tokens d'entrée, les tarifs changent ; le choix des sources et l'évaluation restent essentiels.
GPT-6 peut-il utiliser des outils en autonomie sans risque ?
Aucun modèle ne doit disposer d'outils sans restriction. Appliquez le moindre privilège, validez les arguments, demandez confirmation pour les actions importantes et auditez les comportements observables. Commencez par la checklist de sécurité des agents IA.
