Comparativa de modelos
GPT-6 frente a GPT-5.6: Astra y Sol para el trabajo real
GPT-6 Astra es la opción más potente para trabajos complejos de varias etapas; GPT-5.6 Sol sigue siendo más práctico por defecto cuando pesan más la latencia, la disponibilidad y el coste. Los resultados de OpenAI muestran los mayores avances de Astra en uso del ordenador, automatización, recuperación en contextos largos, ciencia y ciberseguridad. La mejora no aporta lo mismo a cada prompt.
Elige por el coste de una tarea aceptada, no por el número del modelo. Si GPT-5.6 ya resuelve una petición habitual de forma correcta, rápida y barata, pasarla a GPT-6 puede aumentar la factura sin mejorar el resultado. Si el proceso falla en coordinación de herramientas, razonamiento complejo, contexto largo o entregas profesionales, Astra merece una evaluación controlada.
Fuentes: anuncio de GPT-6; ficha del modelo; guía para desarrolladores; resumen de seguridad; Astra en Artificial Analysis; comparativa de GPT-5.6 Sol; prueba de depuración con la API; comparativa de programación basada en producción. Consultadas el 7 de septiembre de 2026.
Comparación rápida
| Criterio | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| Mejor encaje | Procesos difíciles de principio a fin | Trabajo general con menor coste operativo |
| Ventana de contexto | 1.050.000 tokens | Consulta la ficha actual de la variante desplegada |
| Salida máxima | 128.000 tokens | Consulta la ficha actual de la variante desplegada |
| Esfuerzo de razonamiento | De low a max, sin none | Controles variados según el producto |
| Novedades de proceso | Herramientas asíncronas, instrucciones durante el turno y cambios de razonamiento en conversación | Procesos consolidados con herramientas y Responses API |
| Entrada de API Standard | 10 USD por millón de tokens | Inferior; comprueba el precio actual |
| Salida de API Standard | 50 USD por millón de tokens | Inferior; comprueba el precio actual |
| Disponibilidad | Despliegue gradual; sin nivel gratuito de API | Más amplia en los productos elegibles |
| Índice independiente de inteligencia | 55 con esfuerzo max | 51 con esfuerzo max |
| Velocidad de salida independiente | 64,3 tokens por segundo con max | Unos 76 tokens por segundo con max |
| Coste independiente por tarea del índice | 2,57 USD con max | 1,25 USD con max |
| Enfoque operativo | Reservar primero para trabajos difíciles y valiosos | Mantener como referencia para tareas habituales y mixtas |
Estas mediciones son capturas de Artificial Analysis y cambian con los proveedores y las pruebas. Muestran una mejora moderada de inteligencia general, salida más lenta y aproximadamente el doble de coste por tarea, no un salto universal. Para decidir una compra, usa las fichas actuales.
Pruebas independientes y discurso del lanzamiento
El relato anticipado de Claire Vo describe avances en una función de ChatPRD que se le resistía con Sol y Fable. Justifica probar Astra en trabajos bloqueados, pero una selección de éxitos no mide la mejora típica frente a Sol. Conserva tarea, estado del repositorio y criterios de aceptación al repetir la comparación.
La evaluación de Matt Shumer favorece Astra para ingeniería cotidiana y mantiene Claude para lo visual. Explica por qué un modelo puede convertirse en habitual pese al precio: una mejor comunicación y menos supervisión pueden importar más que la velocidad de generación. Sigue siendo una valoración personal, no un resultado controlado Astra-Sol.
Nuestra recomendación se dirige, por tanto, a equipos con presupuesto definido: conserva una referencia que funcione y prueba Astra donde hoy haga falta más intervención. Usuarios particulares con otras necesidades pueden elegir de otra forma con buenos motivos.
Los mayores avances anunciados por OpenAI aparecen en pruebas de agentes, ordenador y contexto largo. Artificial Analysis ofrece un resultado general más limitado: Astra max obtiene 55 puntos frente a 51 de Sol max. Astra generó menos tokens de salida que la mediana, pero tuvo menor velocidad de salida que Sol y una espera elevada hasta el primer token con max.
Una prueba de depuración por API encontró el mismo diagnóstico en Astra y tres variantes GPT-5.6. Astra aportó la mejor salvedad y plan de confirmación, pero tardó aproximadamente el doble y costó unas cuatro veces más que Sol. Esto favorece Astra si una salvedad ausente puede causar un error caro, no si solo necesitas una orden o causa probable.
Otra prueba, derivada de producción, comparó Astra con GPT-5.6 Terra, no con Sol. Ambas implementaciones pasaron los tests existentes, pero Terra rompió estados de paginación relacionados. Astra los preservó y añadió una prueba. El autor pasó a asignarle tareas interdependientes en varios ámbitos, manteniendo modelos más baratos para cambios ordinarios y mecánicos. Ese reparto es más defendible que sustituir todos los modelos.
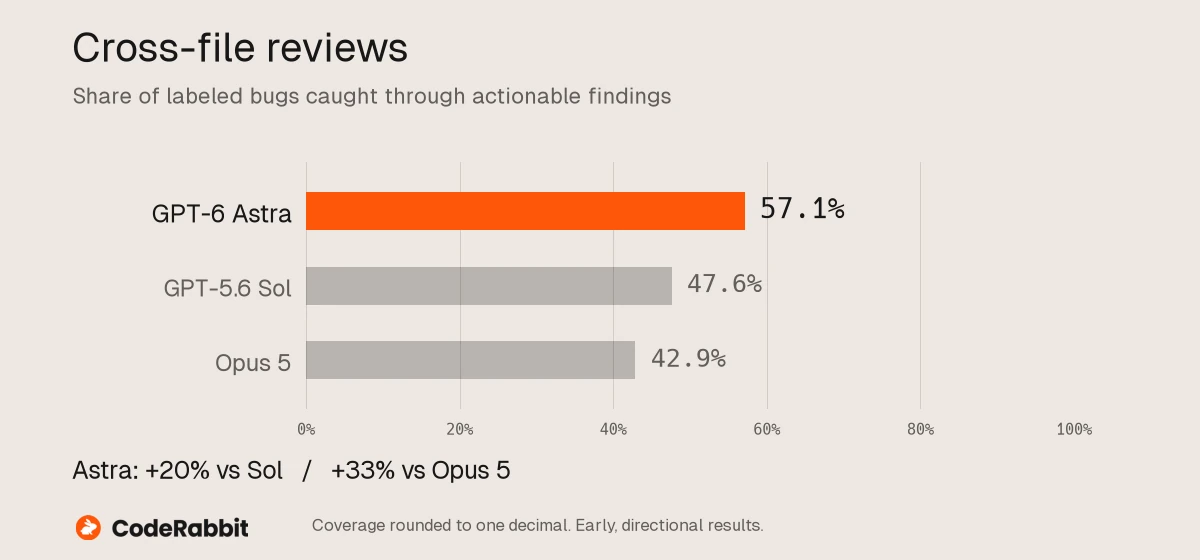
Resultados entre archivos publicados por CodeRabbit. Son hallazgos iniciales, no una medida de la calidad global de revisión.
Dónde mejora más GPT-6
Las evaluaciones de lanzamiento de OpenAI permiten una comparación útil, al probar ambos modelos el mismo responsable. Aun así, algunas son internas, se publican las mejores puntuaciones según el esfuerzo y las instrucciones o herramientas de producción pueden cambiar el resultado.
| Evaluación | GPT-6 Astra | GPT-5.6 Sol | Posible interpretación |
|---|---|---|---|
| OSWorld 2.0 offline | 72,6 % | 65,7 % | Mejor manejo del escritorio |
| AutomationBench | 41,4 % | 18,1 % | Gran avance en automatización de varias etapas |
| Terminal-Bench 4.0 | 57,9 % | 37,3 % | Mejor ingeniería en terminal |
| Migraciones internas de bases de datos | 63,9 % | 42,7 % | Potencial en cambios largos con estado |
| FrontierMath Tier 4 v2 | 97,6 % | 83,0 % | Razonamiento matemático avanzado más sólido |
| MRCR v2, 512K-1M | 96,3 % | 73,8 % | Mejor recuperación en contextos muy largos |
| ARC-AGI-3 | 99,9 % | 7,8 % | Gran mejora declarada en nuevas tareas interactivas |
Astra no domina todas las comparativas frente a todos los competidores. El análisis de DataCamp señala que queda por detrás de Claude Fable 5.1 en Humanity's Last Exam con herramientas y que el 99,9 % de ARC-AGI-3 depende de un entorno con estado y adaptador del proveedor. No esperes reproducirlo con una petición sin estado. Usa los datos para decidir qué probar, no qué desplegar directamente.
Ordenador y procesos con agentes
Este es el argumento más sólido para evaluar GPT-6. OpenAI diseñó Astra para trabajar entre código, navegadores, documentos, hojas de cálculo, presentaciones y software profesional. Las llamadas asíncronas permiten razonar de forma independiente mientras se ejecuta una herramienta lenta. Las nuevas instrucciones durante el turno permiten corregir una sesión sin reiniciarla.
GPT-5.6 Sol ya admite herramientas y procesos con agentes. Consérvalo si la secuencia es corta, los permisos son limitados y el resultado cumple los criterios. Prueba Astra si el flujo pierde el hilo, interpreta mal los cambios de instrucciones, se atasca entre interfaces o necesita demasiados reintentos.
Un modelo mejor no elimina la arquitectura que lo rodea. Autenticación, esquemas de herramientas, autorización, estado, auditoría, aprobación y reversión corresponden a la aplicación. Consulta estos límites en la arquitectura de agentes de IA.
Contexto y memoria no son lo mismo
La ventana de 1,05 millones de tokens de Astra puede contener muchas fuentes, pero es capacidad temporal de una petición. No se convierte automáticamente en memoria persistente y correcta de un cliente, proyecto o política. Esa memoria requiere identificadores, reglas de actualización, resolución de conflictos, borrado, control de acceso y visibilidad para el usuario.
Usa contexto largo para un corpus limitado que deba analizarse en conjunto, recuperación para otro mayor y cambiante, y estado persistente de proyecto para decisiones y entregas aprobadas que deban sobrevivir entre ejecuciones. La guía de gestión del conocimiento con IA explica cómo preservar la procedencia en vez de tratar los resúmenes generados como fuente de verdad.
Compara el coste del trabajo terminado
GPT-6 Astra cuesta 10 USD por millón de tokens de entrada y 50 USD por millón de salida en Standard. Los prompts de más de 272.000 tokens de entrada reciben tarifas mayores en toda la solicitud. Caché, herramientas, Fast, Batch y Flex tienen precios propios.
Astra puede resultar más barato para una tarea difícil si consume menos tokens, evita reintentos o reduce la revisión humana. En cambio, incluso una respuesta perfecta puede ser poco rentable para una clasificación masiva que no gana nada con razonamiento avanzado.
El ensayo de depuración concreta el intercambio: unos 0,194 USD y 75,5 segundos para Astra frente a 0,048 USD y 39,3 segundos para Sol. Todos llegaron al mismo diagnóstico; Astra añadió una limitación más precisa y un plan de verificación. Un único prompt no establece una media, pero sirve de contrapunto a las afirmaciones de eficiencia.
Utiliza este cálculo:
coste por tarea aceptada =
  entrada del modelo + salida del modelo + caché + herramientas
  + intentos fallidos + tiempo de revisión + correcciones

valor de la actualización =
  errores evitados + trabajo ahorrado + reducción del ciclo
  - coste adicional por tarea aceptada
Mide los modelos con las mismas entradas. No consideres nulo el tiempo de revisión: a menudo es el mayor coste oculto.
Seguridad y control
OpenAI afirma que Astra resiste mejor los jailbreaks, la inyección de prompts y las acciones fuera de alcance que GPT-5.6 Sol. En una simulación interna con más de 54.000 tareas de Codex recibió aproximadamente la mitad de alertas por desalineación grave. La empresa también señala que su razonamiento escrito es menos fácil de supervisar que el de Sol.
Los expertos entrevistados por TechRadar recomiendan observar las acciones y poder detener al agente mientras actúa, en lugar de confiar en su razonamiento escrito. Un relato inicial describe sesiones ordinarias de programación detenidas por clasificadores de ciberseguridad tras ejecuciones largas. Es anecdótico, pero OpenAI confirma que sus protecciones pueden interrumpir trabajo legítimo. Incluye falsos positivos y tiempo perdido en la comparación.
Esto cambia cómo conviene evaluar:
- Comprueba acciones y resultados, no si el razonamiento suena tranquilizador.
- Define un esquema limitado y una autorización clara para cada herramienta.
- Añade contenido adversario y tareas imposibles al conjunto de pruebas.
- Pide confirmación antes de enviar, borrar, comprar, publicar o modificar accesos.
- Mantén un registro independiente de entradas, llamadas, aprobaciones, salidas y decisiones del revisor.
Consulta la lista de seguridad para agentes de IA antes de conceder escritura a cualquiera de los modelos.
Qué modelo elegir
Elige GPT-6 Astra cuando
- El trabajo es tan complejo que suele requerir varios intentos o traspasos humanos.
- El ordenador o la coordinación entre herramientas son esenciales.
- Las fuentes son muy extensas y recuperar información incompleta resulta caro.
- La entrega es un documento, análisis, presentación o cambio de código de alto valor.
- Tus pruebas muestran una mejora medible en resultados aceptados.
Mantén GPT-5.6 Sol cuando
- El proceso actual cumple sus objetivos de calidad y fiabilidad.
- La velocidad o la economía a gran escala son prioritarias.
- La tarea es corta, repetitiva, estructurada o fácil de verificar.
- La disponibilidad o los límites de GPT-6 no cubren tus necesidades.
- El equipo aún no tiene un proceso de evaluación y revisión.
Cuándo repartir las tareas
En producción, la decisión no tiene por qué ser binaria. Empieza con la referencia más económica y escala según señales observables: volumen de fuentes, riesgo, validación fallida, número de herramientas o calidad exigida. Mantén la regla suficientemente sencilla para auditarla.
Plantilla de evaluación paralela
Proceso: [nombre]
Modelo actual: GPT-5.6 Sol
Candidato: GPT-6 Astra
Casos: [20-50 tareas representativas]

Puntúa cada criterio de 0 a 2:
- Hechos y cálculos correctos
- Restricciones obligatorias satisfechas
- Entrega completa y utilizable
- Alcance autorizado respetado
- Fuentes e incertidumbres visibles

Registra por separado:
- Tiempo transcurrido
- Coste de entrada/salida/caché/herramientas
- Reintentos y fallos
- Minutos de revisión y modificaciones

Despliega solo si:
- No hay regresiones críticas de seguridad o alcance
- La mejora es relevante estadística y prácticamente
- El coste por tarea aceptada encaja con el volumen previsto
Un plan práctico de despliegue
- Fija entradas representativas y criterios de aceptación.
- Ejecuta ambos modelos con herramientas y permisos equivalentes.
- Oculta al revisor el modelo cuando sea posible.
- Examina los fallos, no solo las medias.
- Envía una pequeña parte del trabajo elegible a Astra.
- Supervisa costes, correcciones, incidentes e intervenciones del usuario.
- Amplía únicamente los segmentos que sigan aportando valor.
Ottermind puede reunir archivos originales, comparativas, decisiones de revisión y entregas finales en un proyecto. Usa un espacio de trabajo con agentes de IA para evaluar todo el proceso en vez de guardar capturas de conversaciones separadas.
Preguntas frecuentes
¿Astra siempre es mejor que GPT-5.6 Sol?
No. Es más capaz en muchas evaluaciones, pero Sol puede ser más rápido, barato, accesible y suficiente para el trabajo habitual.
¿Merece la pena pagar más por la API de GPT-6?
Puede compensar en tareas difíciles si reduce reintentos, revisión o fallos. Incluye herramientas y trabajo humano en el coste por tarea aceptada.
¿GPT-6 reemplaza a GPT-5.6?
No automáticamente. OpenAI sigue ofreciendo GPT-5.6 en sus productos. Un sistema puede asignarle lo rutinario y reservar GPT-6 para lo más difícil.
¿Cuál es mejor para programar?
OpenAI publica mejores resultados de Astra en Terminal-Bench 4.0 y otras evaluaciones, con un avance destacado en sus migraciones internas de bases de datos. Pruébalos en tus repositorios, instrucciones y controles de CI.
¿Cuál es mejor con documentos largos?
Astra ofrece 1,05 millones de tokens de contexto y mejor recuperación según OpenAI. No sustituye la selección documental, las citas, la gestión de conflictos ni la revisión humana.
¿Puedo conservar los prompts al migrar?
Empieza con el mismo contrato de tarea para una referencia justa y ajusta después de examinar fallos. La guía de la API de GPT-6 incluye una lista de migración.
