مستجدات النماذج
مراجعة GPT-6: موعد الإطلاق والاختبارات المستقلة والتقييم
أصبح GPT-6 متاحًا، لكن الانتقال إليه ليس تحسينًا تلقائيًا لكل مهمة. أطلقت OpenAI نموذج GPT-6 Astra في 3 سبتمبر 2026. تشير الاختبارات المستقلة المنشورة في أسبوعه الأول إلى تقدم حقيقي في الأعمال الصعبة والمترابطة، لكنها تكشف أيضًا عن تأخر الاستجابة وارتفاع التكلفة وتفاوت الفائدة في الطلبات المعتادة. معرّف النموذج في الواجهة البرمجية هو gpt-6-astra.
تقييمنا هو أن Astra أنسب لتنفيذ الأعمال المعقدة ضمن مسارات طويلة ومترابطة، وليس ليكون الخيار الافتراضي للدردشة اليومية أو الإنتاج بكميات كبيرة. تبرز قيمته عندما يحتاج نموذج واحد إلى فهم نظام كبير واستخدام أدوات متعددة والحفاظ على القيود وتسليم نتيجة تكون أخطاؤها مكلفة. أما الأعمال المحددة بوضوح فتبقى نماذج فئة GPT-5.6 أكثر اقتصادية لها.
المصادر: إعلان الإطلاق; وثائق النموذج; دليل المطورين; ملخص الأمان; شروط الإتاحة; Artificial Analysis; مقارنة برمجية مستمدة من مهمة إنتاج فعلية; اختبارات عملية للواجهة البرمجية; تقرير Axios; آراء خبراء الأمان. روجعت في 7 سبتمبر 2026.
إجابة سريعة
| السؤال | الإجابة حتى 7 سبتمبر 2026 |
|---|---|
| هل أُطلق GPT-6؟ | نعم، أطلقت OpenAI نموذج GPT-6 Astra في 3 سبتمبر 2026. |
| ما معرّف النموذج البرمجي؟ | gpt-6-astra |
| هل يوجد في ChatGPT؟ | تُتاح نسخة GPT-6 Pro تدريجيًا للمشتركين المؤهلين في Pro وBusiness وEnterprise، بحسب المنتج وإعدادات مساحة العمل. |
| هل يتوفر في Codex وChatGPT Work؟ | يجري توفيره تدريجيًا. تقول OpenAI إن Plus يشمل الوصول عبر Work وCodex، بينما تختلف شروط Chat. |
| ما تكلفة الواجهة البرمجية؟ | في Standard: 10 دولارات لكل مليون رمز إدخال و50 دولارًا لكل مليون رمز إخراج، مع أسعار منفصلة لقراءة الذاكرة المؤقتة والكتابة فيها. |
| ما حجم السياق؟ | 1,050,000 رمز، مع إخراج يصل إلى 128,000 رمز. |
| هل ينبغي نقل جميع الأعمال الآن؟ | لا. قيّم المهام الفعلية، وانقل فقط ما تبرر فائدته التكلفة والمخاطر التشغيلية الإضافية. |
ما تقوله الاختبارات المستقلة
الأدلة الخارجية المبكرة أكثر تحفظًا من لغة الإعلان. إنها تدعم وجود تقدم في القدرة، لكنها لا تثبت أن Astra يتفوق في كل مهمة أو يقدم أفضل قيمة دائمًا.
| الاختبار الخارجي | النتيجة | الدلالة العملية |
|---|---|---|
| Artificial Analysis Intelligence Index | سجل Astra max 55 نقطة، وحل ثالثًا بين 202 نموذج في الرصد الحالي | من النماذج المتقدمة، لكنه ليس متصدرًا بلا منافس |
| سرعة Artificial Analysis | 64.3 رمز إخراج في الثانية، في المرتبة 93 من 202 | دون وسيط مجموعة المقارنة وأبطأ من GPT-5.6 Sol max في الخدمة نفسها |
| تكلفة مهمة المؤشر | 2.57 دولار لـAstra max مقابل 1.25 دولار لـSol max | أربع نقاط إضافية مقابل ضعف التكلفة تقريبًا لكل مهمة اختبار |
| اختبار تصحيح الأخطاء لدى ComputingForGeeks | حددت Astra وSol وTerra وLuna الأسباب الثلاثة نفسها | تفوق Astra في التحفظات والتحقق، لا في تشخيص مختلف |
| مقارنة برمجية من واقع الإنتاج | اجتاز النموذجان الاختبارات القائمة؛ وحده Astra حافظ على حالات ترقيم الصفحات المرتبطة وأضاف اختبارًا | قد تخفي الاختبارات الناجحة خطأ في العقد الوظيفي؛ ربط Astra المكونات بصورة أفضل في هذه الحالة |
قاس Artificial Analysis كذلك نحو 355 ثانية حتى أول رمز عند أقصى جهد استدلال. هذه إعدادات متطرفة وليست توقعًا للدردشة العادية، لكنها تؤكد قاعدة مفيدة: ينبغي اختيار الاستدلال الأقصى عمدًا للبحث، لا تفعيله تلقائيًا.
اختبار البرمجة المستمد من الإنتاج مهم بصورة خاصة. نجح الوكيلان في 712 ملف اختبار، لكن تنفيذ Terra فقد حالة أداة ترقيم الصفحات الأخرى في أحد التفاعلات. حافظ Astra على الحالتين واختبر علاقتهما صراحة. هذا دليل لصالح تجربته في التنفيذ شديد الترابط، لكنه يظل حالة واحدة نشرها مزود، لا نسبة تفوق عامة.
ما توصل إليه أصحاب التجارب العملية
تسمي مراجعة Claire Vo المبكرة في 3 سبتمبر مهام محددة: ميزة في ChatPRD استعصت على نماذج سابقة، وفحصًا في المتصفح، وربطًا بأجهزة، وعملًا ثلاثي الأبعاد. تتضمن صفحة الحلقة توقيتات العروض. إنها تجارب نجاح مختارة لمطوّرة خبيرة توضّح حصولها على وصول مبكر، لكنها لا تقدم تجارب متكررة أو متوسط فشل. أهم ما توفره مهام حقيقية لتصميم مقارنتك الخاصة.
تبدو مراجعة Matt Shumer في 3 سبتمبر أكثر إيجابية للاستخدام اليومي من توصيتنا التي تراعي التكلفة. فقد اتخذ Astra خيارًا افتراضيًا وأشاد بتطوير الأنظمة الخلفية ووضوح تحديثات التقدم. لكنه ذكر أيضًا ضعف النتائج البصرية مقارنة بـClaude، وبطء الاستجابات، ومشاريع كبيرة يتوقف تقدمها المفيد. اعتمدت عروضه الكبيرة على تنسيق واسع وموارد موجودة. هذه الشروط مهمة عند قراءة أن مشروعًا بدأ بطلب واحد.
تختلف هذه التقييمات عن بعض الشكاوى المبكرة بشأن فهم النية والنطاق. تبرر الأدلة اختبار السلوك في مهامك، لكنها لا تحدد أي التجارب هو الأكثر شيوعًا.
أرسلت ComputingForGeeks طلب تصحيح الأخطاء نفسه إلى أربعة نماذج عبر الواجهة البرمجية الفعلية. حددت جميعها الأسباب الثلاثة نفسها. استغرق Astra 75.5 ثانية وكلف قرابة 0.194 دولار، مقابل 39.3 ثانية و0.048 دولار لـSol. رأى الكاتب أن التحفظ الإضافي منع تعميمًا مفرطًا في التشخيص، لكنه لم يجد علاوة السعر مبررة لأسئلة التأكيد المعتادة.
هذا يغير سؤال الشراء. لا يحتاج Astra إلى إجابة مختلفة تمامًا كي يقدم قيمة؛ فقد يكون تحفظ واحد غائب مهمًا في حادثة عالية المخاطر. لكن عندما تقود كل الإجابات الصحيحة إلى الإجراء نفسه، يتفوق الخيار الأرخص اقتصاديًا.
آراء المجتمع الأولية متباينة. وصف مستخدم خبير في Codex حلولًا ذكية مع حكم أضعف على النطاق، مثل اقتراح بنية غير لازمة قبل الاتفاق على الاتجاه. واعتبر مطوّر آخر Astra قويًا لكنه يميل إلى الإفراط في التصميم في المهام البسيطة. وأبلغ آخرون عن إنجاز أسرع بكثير في مستودعات صعبة. تتأثر هذه الروايات غير المضبوطة بالتعليمات والمستودعات والحدود والتوقعات؛ فهي سيناريوهات للاختبار وليست مقياس رضا موثوقًا.
ذكر تقرير مجتمعي مفصل أن 12 جولة عمل عادية ضمن ثماني جلسات انتهت بإشارة من سياسة الأمن السيبراني بعد وقت طويل. لم يُتحقق منه مستقلًا، لكنه ينسجم مع تحذير OpenAI من إيقاف العمل المشروع أحيانًا. ينبغي احتساب التوقفات المتأخرة ضمن مقاييس الاعتمادية والتكلفة.
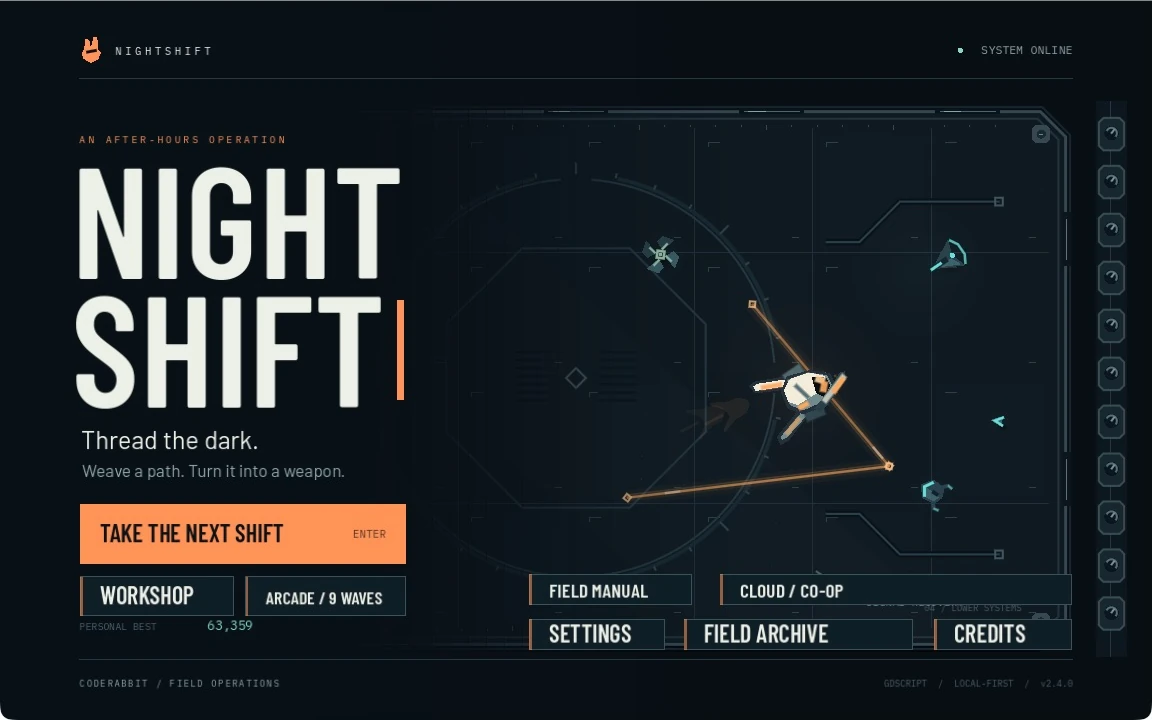
لعبة NIGHTSHIFT التي تعرضها CodeRabbit، وطُورت باستخدام GPT-6 مع توجيه بشري وتحسينات متكررة.
ما الذي تغير في GPT-6 Astra؟
أصبح السياق الطويل أكثر قابلية للاستفادة
تعرض صفحة النموذج سياقًا من 1,050,000 رمز وحد إخراج 128,000 رمز. وتنشر OpenAI نتيجة 96.3% في MRCR v2 ذي الإبر الثماني بين 512K و1M، مقابل 73.8% لـGPT-5.6 Sol. مع ذلك، لا يبرر الحجم إرسال كل الملفات. جودة الاسترجاع وتواريخ المصادر وحل التضارب وإتاحة المراجعة مسؤوليات التطبيق.
اقترب استخدام الحاسوب من العمل الفعلي
تذكر OpenAI نتيجة 72.6% لـAstra على مجموعة OSWorld 2.0 غير المتصلة مقابل 65.7% لـSol. وفي محاكاة التأخر أنهى العمل في نحو 40 دقيقة بدلًا من 75. وتشمل الاستخدامات تحديث السجلات والنماذج والجداول والمستندات وفحص المواقع.
المعنى هو أن مهام إضافية أصبحت ممكنة تقنيًا، لا أن الاستقلالية أصبحت آمنة تلقائيًا. لا تزال الصلاحيات المحدودة ومعاينات الأفعال وتأكيد التغييرات المهمة ومنع تكرار الأثر وسجل التدقيق القابل للاستعادة مطلوبة. تشرح قائمة أمان وكلاء الذكاء الاصطناعي هذه الحدود.
يمكن تعديل الاتجاه أثناء التنفيذ
يضيف Astra استدعاءات أدوات غير متزامنة وتوجيهًا أثناء الجولة في Responses API. يستطيع التطبيق مواصلة العمل المستقل أثناء تشغيل أداة بطيئة ثم إعادة نتيجتها بمعرّف الاستدعاء. ويمكن تصحيح جلسة WebSocket دون إلغاء ما أُنجز. لكن متابعة الاستدعاءات المعلقة والإلغاء وانتهاء المهلة والنتائج المتأخرة تبقى على التطبيق.
تعديل الاستدلال دون إعادة بناء الطلب
تدعم الواجهة مستويات low وmedium وhigh وxhigh وmax. يمكن تحديث إعدادات المحادثة لتغيير الجهد مع الحفاظ على مقدمة الطلب المحفوظة مؤقتًا. لا يدعم Astra الخيار none.
تحسن الأمان وصعوبة أكبر في المراقبة
تبلغ OpenAI عن أفعال ضارة أو خارج النطاق أقل من Sol في اختبارات داخلية. وتقول أيضًا إن مراقبة Astra عبر الاستدلال المكتوب أصعب لأنه يتحكم أكثر فيما يظهر فيه. كلا الأمرين مهم. تحسن السلوك المقاس لا يلغي الضوابط، وصعوبة المراقبة تدعو إلى تقييم الأفعال والصلاحيات والمدخلات والنتائج المرئية بدل اعتبار التفكير الخفي سجل تدقيق.
هل يعني GPT-6 الوصول إلى AGI؟
تصف OpenAI النموذج بأنه الأذكى والأكثر توافقًا مع النية البشرية لديها. وقال رئيسها Greg Brockman في الإحاطة إنه يعتقد شخصيًا أن النموذج قد يمثل وصول الذكاء الاصطناعي العام، تاركًا الحكم للمستخدمين. هذه دعوى وتفسير، لا معيار قياس محسوم.
للمشترين والمطورين، أربع أسئلة أكثر قابلية للتطبيق:
- هل ينجز مهامك الممثلة بدقة أعلى؟
- هل يقلل الوقت الإجمالي وتصحيحات المراجعة؟
- هل يلتزم بالصلاحيات والنطاق المحددين؟
- هل تبرر الجودة التكلفة الكاملة لكل نتيجة مقبولة؟
لا تحسم الصورة المستقلة مسألة AGI. احتل Astra مكانًا قريبًا من القمة وليس الأول لدى Artificial Analysis، مع تفوق أكبر في مهمة برمجية مترابطة واختبارات OpenAI للحاسوب. تظل أفضل نماذج الذكاء الاصطناعي لعام 2026 مرتبطة بالمهمة. النتيجة المتقدمة لا تجعله تلقائيًا الأنسب للاستخراج والتصنيف والصياغة اليومية والدعم واسع الحجم.
أين يتوفر GPT-6؟
تصف OpenAI طرحًا تدريجيًا في ChatGPT والواجهة البرمجية وMicrosoft Azure وAmazon Bedrock. ويميز مركز المساعدة بين البيئات:
- ChatGPT Chat: يُطرح GPT-6 Pro لخطط Pro بسعر 100 دولار وPro بسعر 200 دولار وBusiness وEnterprise. الحصص محدودة وتختلف حسب الخطة.
- ChatGPT Work وCodex: يجري توفير Astra لمشتركي Pro، وتشمل Plus الوصول في هذين المنتجين أثناء الطرح.
- الواجهة البرمجية: يستخدم المطورون
gpt-6-astra، ولا تدعم صفحة النموذج المستوى المجاني. - مساحات العمل المُدارة: قد يلزم أن يفعّل المسؤول الوصول. وتقول الإحاطة إن Enterprise يبدأ بوصول معطل افتراضيًا.
قد تتغير التفاصيل بسرعة. راجع مركز المساعدة وصفحة النموذج قبل الشراء أو الالتزام بخطة نشر.
فهم أسعار GPT-6
سعر Standard هو 10 دولارات لكل مليون رمز إدخال و50 دولارًا لكل مليون إخراج. الإدخال المخزن مؤقتًا بدولار واحد والكتابة المؤقتة بـ12.50 دولارًا لكل مليون. الطلبات التي تتجاوز 272,000 رمز إدخال تُحسب بسعر أعلى بالكامل. Batch وFlex بنصف Standard، وFast بضعف السعر المطبق.
سعر الرمز ليس تكلفة إنجاز المهمة. قد يستخدم Astra مخرجات أقل أو محاولات أقل. لكنه في اختبار التصحيح المستقل كلف نحو أربعة أمثال Sol للتشخيص الأساسي نفسه. وفي اختبار البرمجة ربما منع دورة مراجعة وإصلاح منفصلة. الحالتان ممكنتان. احسب المحاولات والأدوات ووقت المراجع وتوقفات السياسة والإخفاقات ضمن تكلفة النتيجة المقبولة. يقدم دليل API لـGPT-6 قالبًا للهجرة والتقييم.
إطار عملي لتقييم GPT-6
شغّل المهام الممثلة نفسها، وعددها من 20 إلى 50، على نموذجك الحالي وعلى Astra. ثبّت المدخلات وأخفِ هوية النموذج عن المراجع متى أمكن.
| البعد | ما تسجله | معيار مقترح |
|---|---|---|
| الصحة | الوفاء بالحقائق والحسابات والقيود | لا تراجع في الحقول الحرجة |
| الإكمال | الوصول للتسليم دون إنقاذ بشري | تحسن مهم في المهام الصعبة |
| النطاق | محاولات غير مصرح بها أو غير لازمة | صفر مخالفات ذات أثر مهم |
| المراجعة | الدقائق والتعديلات حتى القبول | انخفاض وسيط جهد المراجعة |
| الاعتمادية | انتهاء المهلة والأخطاء والتكرار والتوقف | ضمن هدف SLO للعملية |
| التكلفة | رموز وأدوات ومحاولات ومراجعة لكل نتيجة | قيمة موجبة عند الحجم المتوقع |
لا تبدأ بأسهل الطلبات فقط. أدرج معلومات مفقودة ومصادر متعارضة وحقن تعليمات وبيانات قديمة وتعطل أدوات ورفض صلاحيات وتغيير المتطلبات أثناء التشغيل.
قالب موجز التقييم
القرار: هل ننقل [العملية] من [النموذج الحالي] إلى GPT-6 Astra؟
المهام: [حالات إنتاج ممثلة]
مدخلات ثابتة: [معرّفات المصادر وتواريخها]
الأدوات المسموحة: [الأسماء ونطاق الصلاحيات]
المخرج المطلوب: [المخطط أو معايير القبول]
شروط التوقف: [دليل ناقص، صلاحية مرفوضة، ميزانية]
المراجعة: الصحة والاكتمال والنطاق والوضوح
التكاليف: إدخال، إخراج، تخزين مؤقت، أدوات، محاولات، دقائق مراجعة
شرط النشر: [حدود رقمية وإخفاقات لا تُقبل]
متى تستخدم GPT-6 الآن؟
ابدأ بمهام صعبة ومكلفة قد يقل فيها تسليم العمل بين الأطراف بفضل الاستدلال والأدوات: البرمجة المعقدة، البحث متعدد المصادر، المستندات، الجداول أو العمليات المحدودة داخل برامج احترافية. أبقِ الخطوات المعتادة على نماذج أسرع وأرخص حتى تثبت البيانات خلاف ذلك.
لا تختَر Astra تلقائيًا للأسئلة القصيرة أو النصوص الجماعية أو التغييرات الآلية أو العمل الذي يجتاز المراجعة بنموذج أرخص. راقب الإفراط في التصميم والتأخر عند أقصى استدلال والتوقفات المتأخرة والتطبيقات المبهرة التي تحتاج فحصًا وظيفيًا.
يساعد Ottermind على جمع الموجز والمصادر ومخرجات النماذج وملاحظات المراجعة والتسليم النهائي في مشروع واحد بدل المقارنة بين محادثات منفصلة. ابدأ بنتيجة حقيقية داخل مساحة عمل لوكلاء الذكاء الاصطناعي، ثم توسع عندما تدعم الأدلة ذلك.
للخطوة التالية، اقرأ كيفية استخدام GPT-6 وتقييمه في البرمجة ودليل المهام الطويلة.
الأسئلة الشائعة
متى صدر GPT-6؟
أطلقت OpenAI نموذج GPT-6 Astra في 3 سبتمبر 2026، مع إتاحة الوصول تدريجيًا.
هل GPT-6 هو نفسه GPT-6 Astra؟
GPT-6 هو الجيل، وAstra اسم النموذج الرئيسي الصادر. معرّف API هو gpt-6-astra، وتظهر نسخة مبنية عليه في ChatGPT باسم GPT-6 Pro للمؤهلين.
هل يمكن لمشتركي Plus استخدامه؟
يقول مركز المساعدة الحالي إن Plus يحصل على Astra في Work وCodex تدريجيًا. أما GPT-6 Pro في Chat العادي فهو للخطط المؤهلة من Pro وBusiness وEnterprise. قد يختلف الوصول أثناء الطرح.
هل هو أفضل من GPT-5.6 Sol؟
تبلغ OpenAI عن تقدم في استخدام الحاسوب والأتمتة والبرمجة والسياق الطويل والعلم والأمان. لكن قيمة العملية المحددة تحتاج اختبارًا مضبوطًا. انظر مقارنة GPT-6 وGPT-5.6.
هل يدعم الصور والصوت والفيديو؟
تذكر الواجهة إدخال النص والصور وإخراج النص، دون دعم مباشر للصوت أو الفيديو. توفر الأدوات قدرة منفصلة.
هل التشغيل الذاتي آمن؟
لا تمنح أي نموذج وصولًا واسعًا لإجراءات مهمة بناء على الاختبارات وحدها. استخدم أقل الصلاحيات وحدودًا واضحة وتأكيدًا ومراقبة وإمكانات استعادة.
