
三條可以直接複製的水果短劇提示詞
每條提示詞都先固定一個水果角色、它所在的世界,再只給一個動作,這樣首幀就已經接近你想拍的那個鏡頭。
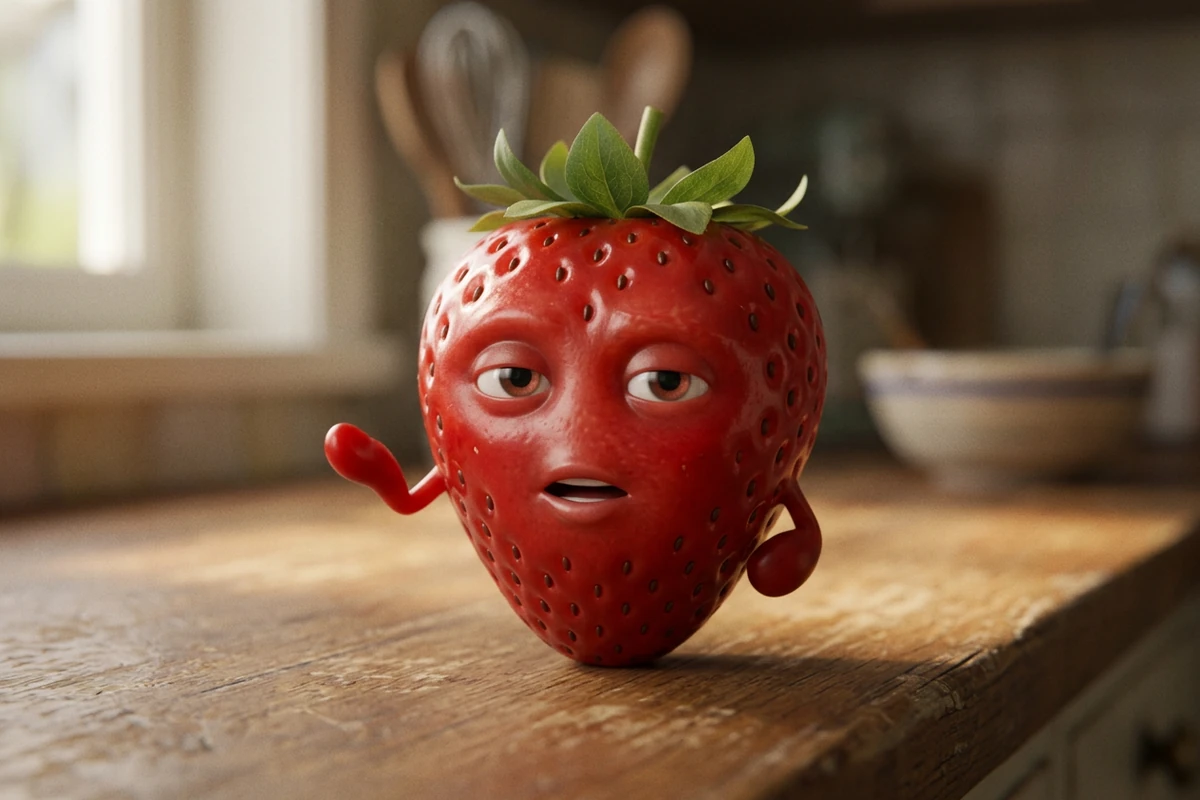
單人說話鏡頭
一個草莓角色,臉是它自己果皮的一部分,站在做舊的木廚房檯面上,傍晚的光線裡轉身對著鏡頭說話,說到一半,一隻小手臂抬起做了個克制的動作。綠色葉冠,果皮上的籽反著光,嘴是一道軟縫,說話時把果皮壓出皺褶。左側溫暖的窗光,背後虛化的廚房,一只陶瓷碗在焦外。四分之三近景,與視線齊平,淺景深,安靜的 3D 動畫質感,適合全年齡。每段影片裡臉、葉冠和籽的位置保持一致,一個鏡頭只做這一個動作,畫面裡不要出現文字、字母、數字、標誌、浮水印或簽名。
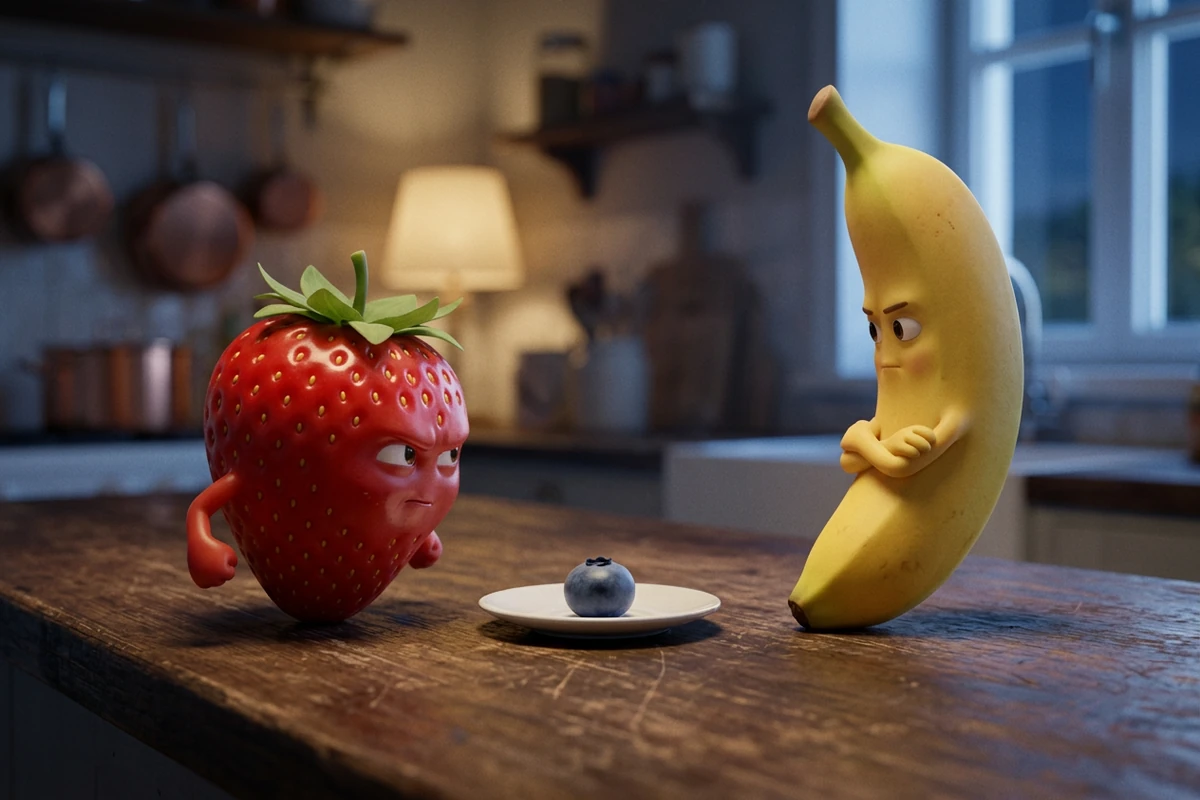
兩個水果的衝突鏡頭
兩個水果角色在傍晚的做舊木檯面上對峙:左邊一顆光澤飽滿的草莓身子前傾,正在爭執;右邊一根霧面的香蕉側過身、抱著手臂,中間的小碟子上放著一顆藍莓。兩張臉都是果皮本身的一部分,反光和次表面散射與整塊表皮完全一致。右側是偏冷的傍晚光,左後方有一點暖色餘光,背後是虛化的層架。檯面高度的雙人鏡頭,淺景深,3D 動畫質感,適合全年齡。鎖死兩個角色的設定和檯面,讓整段影片裡它們不發生變化,畫面裡不要出現文字、字母、數字、標誌、浮水印或簽名。
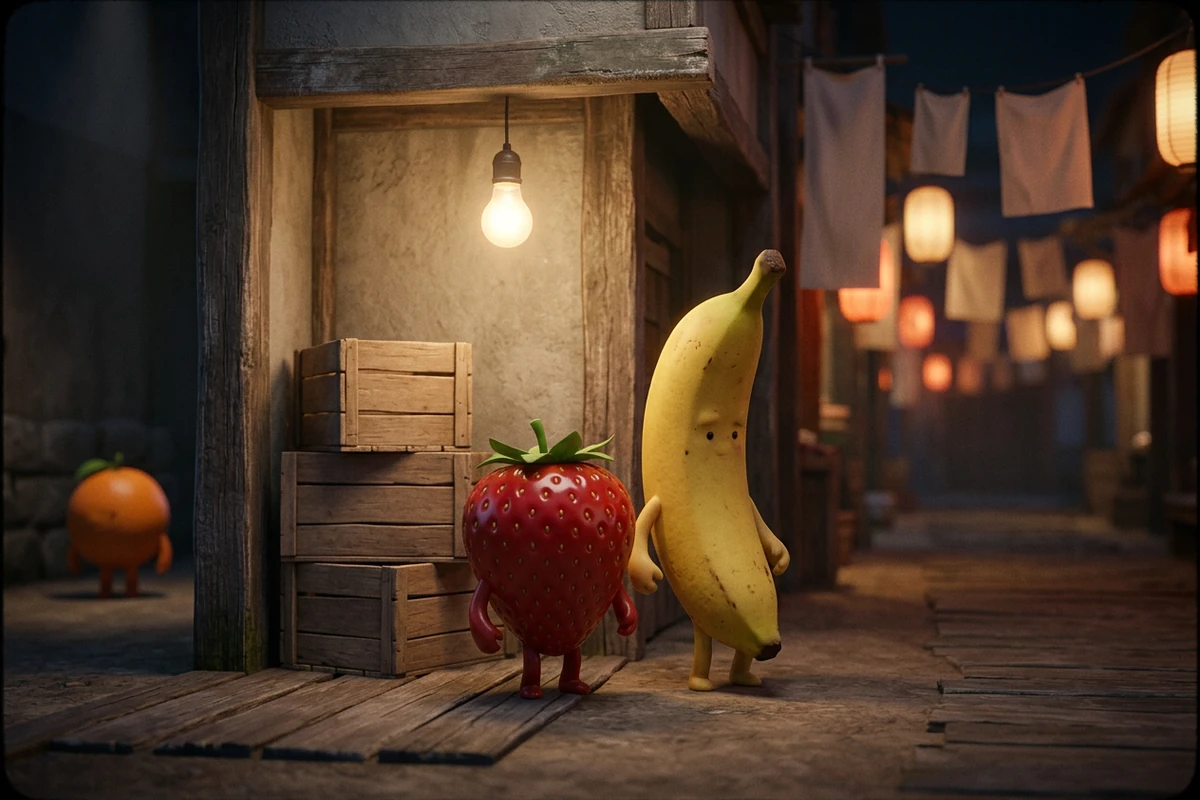
老角色回歸鏡頭
同樣的草莓和香蕉回到一個新地方:夜晚市集小巷的木門口,頭頂吊著一只燈泡,旁邊堆著木箱,左後方還有一個橘色小角色在等。草莓站在前面正在解釋,香蕉帶著懷疑的表情在聽。兩個角色的設定、比例、眼睛風格和顏色要和前幾段影片完全一致,門口和光線在整段影片裡保持不變。中景,暖色燈泡和身後的深色陰影,3D 動畫質感,適合全年齡,只做一個動作,畫面裡不要出現文字、字母、數字、標誌、浮水印或簽名。
大多數水果提示詞為什麼做不成
問題幾乎從來不在提示詞本身。臉像貼上去的、角色到第三集就變樣、一段影片想講完整段劇情,這才是浪費生成次數的原因。
臉必須長在水果上
水果角色和「照片上貼了一張臉」的差別在質感。明確寫出:嘴是一道把果皮壓出皺褶的軟縫,眼睛嵌在果皮裡、和整塊表皮有同樣的高光與次表面散射,而且只有一束光照在臉和果皮上、把它們當成同一個物件。這一句通常就能避開貼紙感;結果還是平的時候,要改的是這一句,而不是鏡頭或劇情。
兩句固定,只換第三句
給水果寫一句「角色句」,給表面、光線和時刻寫一句「世界句」,然後把這兩句原封不動貼進每一條提示詞,只讓「劇情句」變化。角色能活到第二集靠的就是這個:換了地方,草莓的葉冠、籽的排列和嘴還是原來那樣,因為描述裡沒有任何一處動過。每次都重寫角色,才會讓一部劇看起來像一堆互不相干的影片。圖片轉影片 可以讓已經確認的首幀接著往下做。
一段影片只做一個動作,故事放在影片之間
四到六秒的一段影片只承載一個動作,而且要有看得見的結束:它探身、它別過臉、它注意到空碟子。把故事放進順序裡——起、衝突、反應——每段影片只給其中一個。一條提示詞同時要求吵架、揭曉和反應,等於一次給模型三個難題,道具開始漂移、結尾消失就發生在這裡。免費 AI 照片轉影片 能把每段渲染好的影片並排放在一起看。
在 Ottermind 裡做一集水果短劇
第 1 步:先寫角色,再寫世界
先給水果、臉和質感命名,再寫它站在什麼表面上、光線如何、是什麼時刻。把這兩句存在隨手能貼上的筆記裡。圖片轉 AI 藝術產生器 負責渲染首幀,後面每一集要重複用的就是這兩句。
第 2 步:確認首幀之後再去動它
盯著這張靜帧看幾秒。如果水果的臉像貼上去的,或者香蕉的渲染和草莓對不上,任何運鏡都救不了這段影片。把確認過的首幀帶進 圖片轉影片,動態只描述「會變化的部分」,不要重複畫面裡已經有的東西。
第 3 步:把一集拆成鏡頭,每次只改一行
把起、衝突、反應拆成各自獨立的影片段落,每段只做一個動作。同一顆鏡頭渲染兩三個版本,比較之後再改其中一行——先改劇情,再改光線,最後改鏡頭——角色句和世界句保持不動。
水果短劇提示詞真正有用的地方
當同一批角色需要在下一集回來,或者當一個荒謬鏡頭就足以撐起一則內容時,這些提示詞才值得花時間。
有固定班底的連載
草莓和香蕉每週都回來。因為角色句和世界句從不改動,第二集只需要寫一句新的劇情,而不是重做設計,觀眾在劇情開始前就能認出還是那兩個角色。
給店鋪或果汁吧的一顆鏡頭
攤位、市集檔口或果汁吧由一個水果角色和一個清楚的動作帶出來。守住「只做一顆鏡頭」,這則內容就仍然能當單篇發布用,而不是一集。 圖片轉影片 可以把確認過的靜帧變成這一顆鏡頭。
屬於你自己的梗,而不是複製
自己設定班底、名字和前提,不要去重做一個已經在更新的劇集角色;同時讓內容遠離這個題材後來滑向的暴力或暗示方向。平台要求時標註這是 AI 生成內容,商用之前先看清所用工具的使用條款。
水果 AI 短劇常見問題
怎麼讓同一個水果角色出現在每一集裡?
把描述凍結下來,並重複使用已經確認的首幀。寫一句角色句——外形、臉、質感、顏色——再寫一句世界句交代表面和光線,兩句原封不動貼進每條提示詞,只讓劇情句變化。如果某段影片還是漂移,改角色句而不是改運鏡,並且下一段從已經確認過的首幀開始,接進 圖片轉影片。
一定要用專門的水果短劇生成器嗎?
不需要。無論是一則水果梗還是一整部連載,流程都一樣:寫場景、生成首幀、把首幀動起來。通用的圖像加影片流程就夠用,只要它能從參考幀開始、並且能比較多個版本。這套結構並不專屬於水果,更通用的寫法在 如何用 Ottermind 將圖片生成影片:動作與運鏡提示詞。
該用文生影片還是圖生影片?
用一個問題決定:這個角色需要回來嗎?單獨的鏡頭可以直接用文字提示詞生成,更快也更自由。有固定班底的連載需要先確認一張首幀,因為承擔臉和質感、要被動畫保留下來的正是這張首幀。實際做的時候兩者都會用到:先用文字找到鏡頭,再用 圖片轉影片 處理必須保持一致的鏡頭。
每段水果影片應該多長?
目標是四到六秒,一個動作,一個看得見的結束。更長的鏡頭要求模型同時解決好幾件事,臉、道具和結尾開始漂移就出現在這裡。如果某顆鏡頭確實需要更長時間,把它拆成兩段影片,並在兩段裡保持角色句完全一致。
為什麼我的水果看起來像照片上貼了一張臉?
因為臉被寫成了「外加上的東西」,而不是表面的一部分。要求嘴是一道把果皮壓出皺褶的軟縫、眼睛嵌在果皮裡、而且只有一束光把臉和果皮照成同一個物件。這樣寫,質感通常會穿過表情,結果也就不再像貼紙。
鏡頭一動,背景為什麼會變?
因為地點從來沒有被固定,取景一變模型就重建一次。把表面、物件和光線寫成一句固定的話,再讓鏡頭在這句話裡移動。如果你已經有一張背景滿意的首幀,免費 AI 照片轉影片 會從那張背景出發,而不是重新編一個。
水果應該說話,還是只做動作?
生成之前先定下來。要說話的鏡頭需要穩定、偏近的取景,一句短台詞,以及一張讀得清楚的嘴;動作鏡頭可以用更寬的景別,也完全不需要動嘴。長台詞配上移動鏡頭是最容易崩的組合,所以這一頁的提示詞把說話的鏡頭壓到一句台詞,把動作鏡頭留成無聲。
不抄那些爆紅的劇集,也能做水果連載嗎?
可以,而且更安全。自己設計班底、名字和前提,不要重複使用別的劇集的角色、場景或台詞,讓笑點遠離暴力和暗示的方向,平台要求時標註為 AI 生成內容。有自己邏輯的固定班底,才會讓一部劇看起來像一部劇而不是一堆影片;照搬別人的劇集,繼承來的主要是下架風險。
把同一條提示詞換到別的影片模型
把一個鏡頭接成下一集
把剛寫好的角色句和世界句拿過來,兩句都保持不動,繼續生成下一個鏡頭,直到這一集是你真的會發出去的樣子。