技術指南
GPT-6 程式開發評測:跨檔案缺陷、小修改與真實測試
GPT-6 Astra 最值得關注的程式開發優勢,是將程式碼庫中分散的資訊關聯起來的能力。早期測試表明,相比簡單修改,它在困難的跨檔案審查中收益更大。因此,它適合用來調查一項變更的連帶影響;一般實作則仍需比較成本和速度。
兩項有參考價值的外部評估回答了不同問題:CodeRabbit 量測審查發現能否找出已標注缺陷,Real Python 用五條固定提示詞檢查行為。二者結合,比單看一個程式開發排行榜更有實踐意義。
來源: CodeRabbit 評估; Real Python 測試; OpusBooster 程式開發對比。核對日期:2026 年 9 月 7 日。下文中的測試結果和體驗均注明作者。
CodeRabbit 量測了什麼
CodeRabbit 在其 9 月 4 日的評估中,報告了以下可採取行動的缺陷覆蓋率:
| 審查集 | Astra | Sol | 差值 |
|---|---|---|---|
| 整體 | 61.3% | 59.0% | 2.3 個百分點 |
| 更困難的跨檔案子集 | 57.1% | 47.6% | 9.5 個百分點 |
困難子集上約 20% 的相對提升,不等於提高了 20 個百分點,也不意味著每個團隊交付的缺陷都會減少 20%。該指標量測的是這項評估中識別出的缺陷,兩行資料對應不同的難度分布。
結果顯示可在影響分散於多個檔案的變更中測試 Astra,但不能證明每條審查意見都正確、所有重要缺陷都能發現,或小幅修補也需要最昂貴的模型。
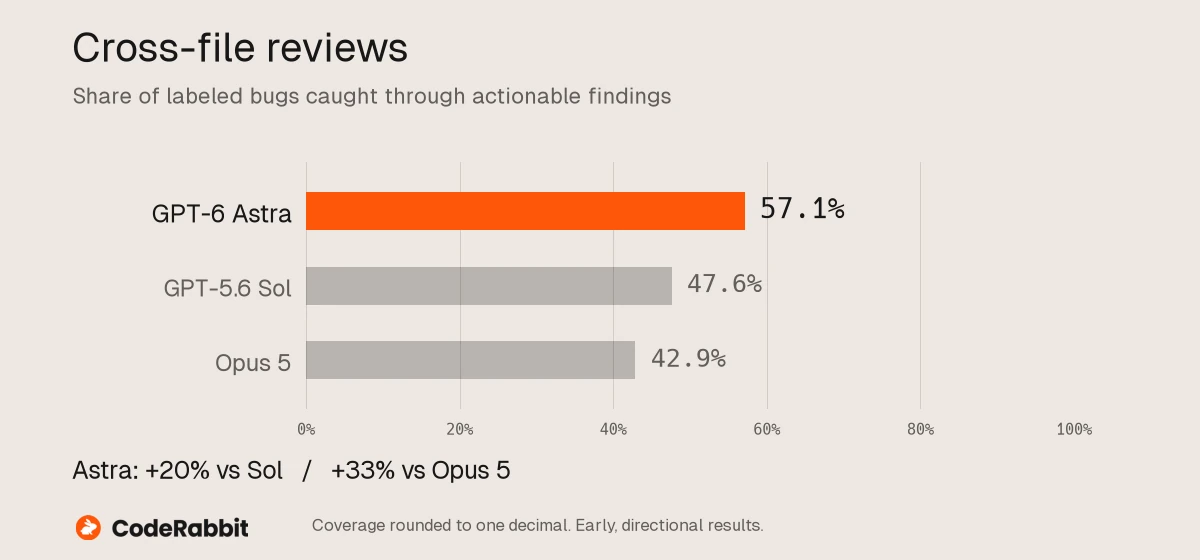
CodeRabbit 公布的跨檔案審查結果。屬於初期評估,不代表整體程式碼審查品質。
Real Python 測試了什麼
Real Python 的五題測試透過 OpenRouter 使用 Astra,採用預設推理設定,每題只嘗試一次,不提供系統提示詞,並公開了可供讀者檢查的輸出。
模型識別出一個虛構的標準庫函式並不存在。添加一個簡單命令行旗標時,它改動了 11 行,而最小改動為 7 行。那次執行中,五個任務共花費 0.31 美元。這提供了實用的測試方式:檢查虛構 API、修補程式規模和執行情況,而不是僅因程式碼看起來合理就接受。
五條提示詞不足以預測模型在整個儲存庫的表現,卻能揭示大型基準可能忽略的細微行為。
為什麼測試通過仍可能遺漏功能問題
一項源自實際專案任務的 Astra 與 Terra 對比發現,兩種實作都通過現有測試,但其中一種仍錯誤處理了相關分頁狀態。Astra 保留了狀態關係,並增加對應檢查。
普遍適用的經驗是,應審核任務改變的行為契約。現有測試可能從未覆蓋使新功能真正有用的互動。要問的是測試是否覆蓋使用者流程,而不只是新寫的函式。
看分數,也要看實際修補程式
Real Python 同時公開了小修改的差異和行數。額外行中包含參數定義的格式調整,因此超出最小行數本身並不能證明有害的過度設計。真正應問的是:修補程式是否改變了請求範圍之外的行為?核對時,其真實工作體驗部分仍未完成,因此五條固定提示詞應按自身證據評價。查看測試與修補程式。
評估任何程式開發 AI 代理時,這一區分都重要。較長修補程式可能更清晰,短修補程式也可能隱藏相容性破壞。應檢查新增程式碼的作用、改變了哪些既有行為,以及沒有修正時新增測試是否會失敗。
用基準挑選候選模型,再檢查交付成果是否適合你的儲存庫。產品演示、缺陷覆蓋評估和固定提示詞測試,各自回答不同的問題。
完整示例:審查共享分頁變更
假設一個頁面有兩組獨立分頁的列表。使用者先將第一組切到第 3 頁,再翻動第二組。預期第一組仍停留在第 3 頁。兩個分頁器單獨使用都可能正常,組合行為卻可能出錯。
審核者應追蹤 URL 構造、查詢參數解析、元件狀態和瀏覽器導航。如果新連結只包含第二組列表的參數,就可能清除第一組的選擇。單獨測試任一分頁器,都可能遺漏這一問題。
初始 URL:/results?customersPage=3&invoicesPage=1
操作:將發票列表翻到第 2 頁
預期:/results?customersPage=3&invoicesPage=2
同時檢查:重新載入、瀏覽器上一頁和無效頁碼
OpusBooster 案例說明,這類關聯值得重點檢查。它也提醒我們,應在實作之前寫出驗收示例。示例為 AI 代理和審核者提供具體目標,同時保留使用儲存庫既有輔助函式的空間。
區分缺陷覆蓋率與審查品質
找到更多已知缺陷的審核者,仍可能產生令人分心的誤報。本地評估應記錄維護者接受和拒絕的發現,以及驗證這兩類發現花費的時間。沒有具體觸發條件的模糊擔憂,消耗的注意力可能比節省的還多。
| 審查結果 | 記錄內容 | 為什麼重要 |
|---|---|---|
| 已確認缺陷 | 重現步驟及受影響行為 | 表明發現有實際價值 |
| 錯誤發現 | 為什麼現有程式碼成立 | 衡量審查噪聲 |
| 待確認問題 | 缺失的證據或環境 | 避免把不確定性直接說成缺陷 |
| 遺漏缺陷 | 歷史問題或後續重現 | 暴露覆蓋缺口 |
條件允許時,讓維護者在不知道模型名稱的情況下判斷發現。保留任務難度資訊:小設定修改與跨服務遷移,不應混成一個沒有解釋的平均分。
提供足夠上下文,才能審查連帶影響
從變更請求和程式碼差異開始,再提供受影響的呼叫方與測試。補充容易遺漏的相容性要求,例如舊版 API 用戶端、持久化資料格式,或輸出會被指令碼解析的公開命令。
不要將無關儲存庫資料全部塞入提示詞。讓模型追蹤受影響路徑,並解釋讀了哪些必要檔案。這樣的審查更容易檢查,也有助於發現某個重要依賴是否根本沒有被考慮。
修改共享類型時,要求同時檢查產生端和使用端;資料庫遷移時,說明升級和回復假設;介面修改時,列出使用者預期的狀態轉換。AI Agent 架構指南介紹了上下文和工具如何配合模型工作。
讓測試範圍匹配改動
OpenAI 的 GPT-6 提示詞指南提到,程式開發任務可能觸發超過小修改實際需要的測試。執行前先定義相關驗證:聚焦測試是什麼、證明哪項行為,以及什麼情況下需要擴大測試範圍。
拼寫修正與共享身份驗證邏輯變更,需要不同的驗證。小幅修補反覆跑完整測試可能增加不了多少證據;共享行為變化時,一個單元測試又可能不夠。讓模型圍繞受影響行為解釋檢查範圍。
先執行覆蓋變更行為的測試。
如果改動影響共享契約,
或聚焦測試暴露更廣泛的迴歸,再擴大檢查範圍。
說明每項檢查驗證了什麼行為。
如果某項檢查無法執行,提供命令和阻礙原因。
不要讓 AI 代理通過削弱與請求無關的斷言,把失敗測試改成通過。修補程式審查應包括被刪除的測試和被修改的預期。只有測試仍表達正確契約,通過狀態才有意義。
比較一項變更驗收通過的成本
每個案例都應記錄模型用量、工具所需時間、重試,以及維護者審核時間,再比較達到合格修補程式的總成本。便宜的首次嘗試,經過兩輪修正後可能變貴;昂貴模型也可能在不必要的重構上浪費時間。
先做小規模分配實驗:將困難跨檔案審查交給 GPT-6,普通修補程式仍使用現有模型。只有有效發現增加或修正工作減少,才擴大範圍。未經分別測試,不應把程式碼審查的優勢直接外推到實作、文件或視覺設計。
四類本地程式開發評估案例
| 案例 | 任務 | 驗收檢查 |
|---|---|---|
| 小修改 | 為現有命令增加選項 | 不使用選項時,既有輸出不變 |
| 跨檔案修改 | 修改共享資料欄位 | 所有產生端和使用端遵守新契約 |
| 除錯 | 調查可重現故障 | 修正能解決重現問題,並保留相鄰行為 |
| 審查 | 檢查一個歷史缺陷變更 | 找出真實缺陷,不產生猜測性噪聲 |
為每個候選模型使用乾淨的起始快照,保持指令、允許工具和預算相同。記錄實際修補程式、測試變化、審核修正及驗收所需時間。模型層面的取捨可參考 GPT-6 與 GPT-5.6 對比。
程式碼審查提示詞範本
根據預期行為審核這項變更:[目標]。
追蹤受影響的呼叫方、資料使用端和錯誤路徑。
每項發現需提供:
- 觸發缺陷的具體條件
- 受影響行為及佐證判斷的檔案引用
- 可暴露問題的重現步驟或測試
優先報告可採取行動的缺陷,明確標注不確定性。
本次審查不要修改檔案。
實作提示詞範本
沿用儲存庫既有模式實作[行為]。
選擇方案之前,先閱讀相關程式碼和測試。
保留[不變條件和相容性要求]。
除聚焦測試外,還要驗證[具體使用者流程]。
回傳改動、驗證結果和仍存在的限制。
把不變條件寫具體:保留另一篩選條件、不改變命令原有輸出,或保持公共回應結構不變。具體約束比“寫出正式環境等級程式碼”更容易驗證。
什麼時候升級值得
當任務需要跨模組認真推理,或審核時間佔主要成本時,可以嘗試 Astra。重複且容易驗證的修改則保留便宜基線。不要用產生的程式碼行數或評論數量衡量生產率:不必要的變化可能增加審核負擔。
對於同時涉及研究、需求和實作規劃的專案,可將簡報和佐證資料整理到 Ottermind 中。程式碼驗證仍在儲存庫完成,再將結果關聯到整體專案決策。
常見問題
GPT-6 更擅長程式碼審查嗎?
CodeRabbit 的早期評估發現,可採取行動的缺陷覆蓋率更高,在更難的跨檔案子集中優勢更大。應在自己的程式碼上測試相同行為。
分數更高,是否就能省去人工審查?
不能。覆蓋仍不完整,有價值的發現也需要先驗證,再修改程式碼。
小幅修補總是用 Astra 最好嗎?
公開證據不能證明這一點。應比較正確性、不必要改動、速度和成本。
除測試通過外還要測什麼?
檢查功能契約、迴歸風險、被移除的覆蓋、審核修正,以及達到合格修補程式的時間。
開發者應該從哪裡開始?
先使用上述任務案例,再參考 GPT-6 API 指南了解整合細節。
