Model Karşılaştırması
GPT-6 mı GPT-5.6 mı? Gerçek İşlerde Astra ve Sol Karşılaştırması
En zor çok adımlı işler için GPT-6 Astra daha güçlü bir seçenek; gecikme, erişim ve maliyetin öncelikli olduğu durumlarda GPT-5.6 Sol daha pratik bir varsayılan. OpenAI sonuçlarında en büyük ilerleme bilgisayar kullanımı, otomasyon, uzun bağlamdan bilgi getirme, bilim ve siber güvenlikte görülüyor. Her istem aynı ölçüde yararlanmıyor.
Model numarasına değil, kabul edilmiş görev maliyetine göre seçin. GPT-5.6 ile doğru, hızlı ve ucuz çalışan rutin bir isteği taşımak sadece masrafı artırabilir. Araç koordinasyonu, karmaşık düşünme, uzun bağlam veya profesyonel çıktı üretiminde sürekli başarısız olan işlerde ise Astra kontrollü bir değerlendirmeyi hak ediyor.
Kaynaklar: GPT-6 duyurusu; model sayfası; geliştirici rehberi; güvenlik özeti; Artificial Analysis Astra verileri; GPT-5.6 Sol karşılaştırması; canlı API hata ayıklama testi; üretimden türetilen kodlama karşılaştırması. 7 Eylül 2026'da kontrol edildi.
Hızlı karşılaştırma
| Karar ölçütü | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| En uygun iş | Baştan sona zor süreçler | Daha düşük işletim maliyetiyle genel işler |
| Bağlam penceresi | 1.050.000 token | Kullanılan sürümün güncel sayfasını kontrol edin |
| Azami çıktı | 128.000 token | Kullanılan sürümün güncel sayfasını kontrol edin |
| Akıl yürütme çabası | Low–max; none yok | Ürüne özgü seçeneklerle geniş kontrol |
| Yeni süreç özellikleri | Asenkron araçlar, tur içi yönlendirme, konuşmada çaba güncelleme | Yerleşik araç ve Responses API süreçleri |
| Standard API giriş fiyatı | Milyon token başına 10 ABD doları | Daha düşük; güncel tarifeyi kontrol edin |
| Standard API çıkış fiyatı | Milyon token başına 50 ABD doları | Daha düşük; güncel tarifeyi kontrol edin |
| Erişim | Aşamalı dağıtım; ücretsiz API katmanı yok | Uygun OpenAI ürünlerinde daha yaygın |
| Bağımsız zekâ puanı | Max düzeyinde 55 | Max düzeyinde 51 |
| Bağımsız çıktı hızı | Max düzeyinde saniyede 64,3 token | Max düzeyinde yaklaşık 76 token |
| Bağımsız endeks görevi maliyeti | Max düzeyinde 2,57 ABD doları | Max düzeyinde 1,25 ABD doları |
| Kullanım yaklaşımı | Önce yüksek değerli zor işlere ayırın | Rutin ve karma işler için temel model olarak tutun |
Bağımsız ölçümler Artificial Analysis anlık görüntüleridir; sağlayıcı ve test güncellemeleriyle değişir. Genel zekâda sınırlı artış, daha yavaş çıktı ve yaklaşık iki kat test maliyeti gösterir; her alanda nesil sıçraması değil. Satın alma hesabında güncel model sayfalarını kullanın.
Bağımsız testler ve çıkış anlatısı
Claire Vo'nun erken erişim yazısı, Sol ve Fable ile bitiremediği bir ChatPRD özelliğinde ilerlemeyi anlatıyor. Önceden tıkanan işlerde Astra'yı denemeyi destekler; seçilmiş başarılar tipik Sol farkını göstermez. Tekrar testte görevi, depo durumunu ve kabul ölçütlerini koruyun.
Matt Shumer'ın incelemesi, günlük mühendislikte Astra'yı, görsel işlerde Claude'u tercih ediyor. İletişim ve daha az gözetim, üretim hızından önemliyse pahalı modelin neden varsayılan olabileceğini gösteriyor. Yine de kişisel değerlendirme; kontrollü Astra-Sol testi değil.
Bu nedenle önerimiz bütçeli ekip kullanımı içindir: çalışan temel modeli koruyun ve bugün en çok müdahale isteyen işlerde Astra'yı deneyin. Farklı iş yükü olan bireyler makul olarak farklı seçim yapabilir.
OpenAI'ın en büyük kazanımları ajan, bilgisayar ve uzun bağlam testlerinde. Artificial Analysis daha sınırlı genel sonuç gösteriyor: Astra max 55, Sol max 51 puan. Astra izleyici medyanından az çıktı tokenı üretse de Sol'dan yavaş ve max düzeyinde ilk token beklemesi yüksek.
Bir canlı API testinde Astra ile üç GPT-5.6 sürümü aynı sorunu teşhis etti. Astra en iyi sınırlama ve doğrulama planını sundu; ancak yaklaşık iki kat sürdü, dört kat pahalıydı. Eksik bir uyarı pahalı hata doğuracaksa anlamlı; yalnızca komut veya muhtemel neden aranıyorsa daha az.
Ayrı bir üretim görevi testi Astra'yı Sol değil, GPT-5.6 Terra ile karşılaştırdı. İkisi de mevcut testleri geçti, fakat Terra ilişkili sayfalama durumunu bozdu. Astra koruyup test ekledi. Yazar bunun ardından sıkı bağlantılı, çok alanlı işleri Astra'ya, sıradan ve mekanik değişiklikleri ucuz modellere yönlendirdi. Bu, her modeli değiştirmekten daha savunulabilir bir dağıtım biçimi.
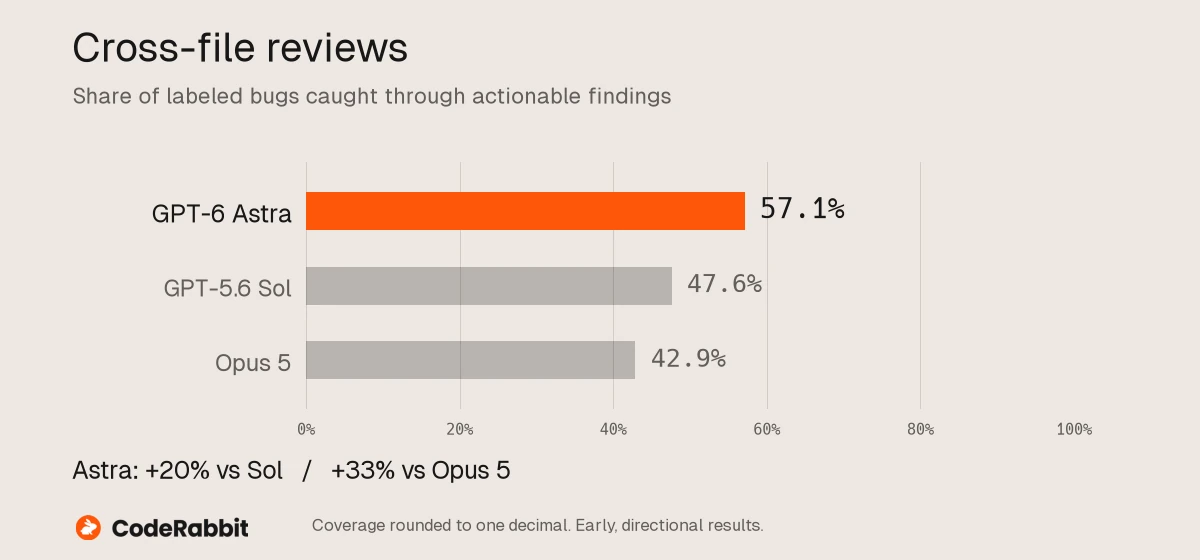
CodeRabbit tarafından yayımlanan dosyalar arası inceleme sonuçları. İlk bulgulardır; genel inceleme kalitesinin ölçüsü değildir.
GPT-6 nerede daha belirgin ilerliyor?
OpenAI'ın çıkış değerlendirmeleri iki modeli aynı yayıncının test etmesi sayesinde yararlı bir karşılaştırma sağlar. Yine de bazıları iç testtir, puanlar en iyi çaba seviyelerini yansıtır; üretim sistem istemleri ve araçları sonucu değiştirebilir.
| Değerlendirme | GPT-6 Astra | GPT-5.6 Sol | Olası anlam |
|---|---|---|---|
| OSWorld 2.0 çevrimdışı | %72,6 | %65,7 | Masaüstü ortamını daha iyi kullanma |
| AutomationBench | %41,4 | %18,1 | Çok adımlı otomasyonda büyük artış |
| Terminal-Bench 4.0 | %57,9 | %37,3 | Terminal mühendisliğinde daha iyi sonuç |
| İç veritabanı geçiş görevleri | %63,9 | %42,7 | Uzun ve durum tutan kod değişikliklerinde potansiyel |
| FrontierMath Tier 4 v2 | %97,6 | %83,0 | İleri matematikte daha güçlü muhakeme |
| MRCR v2, 512K–1M | %96,3 | %73,8 | Çok uzun bağlamdan daha iyi bilgi getirme |
| ARC-AGI-3 | %99,9 | %7,8 | Yeni etkileşimli görevlerde bildirilen büyük artış |
Astra bütün rakipleri her testte geçmiyor. DataCamp'in değerlendirmesi, araçlı Humanity's Last Exam'de Claude Fable 5.1'in gerisinde olduğunu ve ARC-AGI-3'te %99,9'un durum tutan sağlayıcı adaptörlü çalışma düzeneğine bağlı olduğunu belirtiyor. Durumsuz API çağrısından aynı sonucu beklemeyin. Bu veriler neyi test edeceğinizi seçtirir, doğrudan neyi kullanacağınızı değil.
Bilgisayar kullanımı ve ajan süreçleri
GPT-6'yı değerlendirmenin en güçlü nedeni bu. Astra; kod, tarayıcı, belge, tablo, sunum ve profesyonel yazılımlar arasında çalışmak için tasarlandı. Araç asenkronken bağımsız düşünme devam edebilir; tur içi yönlendirme uzun oturumu yeniden başlatmadan düzeltir.
GPT-5.6 Sol zaten araç ve ajan süreçlerini destekliyor. Adımlar kısa, yetkiler sınırlı ve kabul standardı karşılanıyorsa Sol'u tutun. İş akışı ilerlemeyi kaybediyor, yeni talimatları yanlış işliyor, yazılımlar arasında zorlanıyor veya çok tekrar istiyorsa Astra'yı deneyin.
Daha güçlü model çevre mimarisini ortadan kaldırmaz. Kimlik doğrulama, araç şemaları, yetki, durum, denetim, onay ve geri dönüş uygulamanın sorumluluğudur. Yapay zekâ ajanı mimarisi bu sınırı açıklar.
Bağlam ve bellek aynı şey değil
Astra'nın 1,05 milyon token penceresi büyük kaynak kümesi alır, ancak bu istek için geçici kapasitedir. Müşteri, proje veya politika hakkında kendiliğinden kalıcı ve doğru belleğe dönüşmez. Uzun ömürlü bellek; kaynak kimlikleri, güncelleme kuralları, çelişki çözümü, silme, erişim kontrolü ve kullanıcı görünürlüğü ister.
Birlikte değerlendirilmesi gereken sınırlı bir külliyat için uzun bağlam, daha büyük ve değişken külliyat için bilgi getirme, çalıştırmalar arasında yaşaması gereken karar ve onaylı çıktılar için kalıcı proje durumu kullanın. Yapay zekâ ile bilgi yönetimi rehberi, üretilmiş özetleri doğruluk kaynağı saymak yerine kökeni korumayı açıklar.
Tokenı değil, tamamlanmış işi fiyatlayın
GPT-6 Astra Standard API, milyon giriş tokenı başına 10, çıkış başına 50 ABD dolarıdır. 272.000 giriş tokenından büyük istemlerde tüm isteğin tarifesi artar. Önbellek, araçlar, Fast, Batch ve Flex ayrı ücretlendirilir.
Zor işte daha az token, tekrar veya insan incelemesi gerekiyorsa Astra toplamda ucuz olabilir. Buna karşılık yüksek hacimli sınıflandırma ileri muhakemeden yararlanmıyorsa kusursuz cevap bile ekonomik olmayabilir.
Hata ayıklama testi bunu somutlaştırıyor: Astra yaklaşık 0,194 ABD doları ve 75,5 saniye, Sol 0,048 ABD doları ve 39,3 saniye. Ana teşhis aynıydı; Astra daha kesin sınır ve doğrulama planı ekledi. Tek istem ortalama kurmaz, ama token verimliliği iddialarına yararlı denge sağlar.
Şu hesabı kullanın:
kabul edilen görev maliyeti =
  model girişi + model çıkışı + önbellek + araç çağrıları
  + başarısız denemeler + inceleme süresi + düzeltme işi

geçiş değeri =
  önlenen hatalar + kazanılan emek + kısalan çevrim
  - kabul edilen görev başına ek maliyet
İki modeli aynı girdilerle ölçün. İnceleme süresini sıfır saymayın; çoğu zaman en büyük gizli maliyettir.
Güvenlik ve kontrol
OpenAI, Astra'nın GPT-5.6 Sol'a göre jailbreak, istem enjeksiyonu ve kapsam dışı davranışa daha dayanıklı olduğunu söylüyor. 54.000'den fazla Codex görevi içeren iç simülasyonda, ciddi uyumsuz davranış işaretleri yaklaşık yarıya indi. Yazılı muhakemenin izlenebilirliği ise Sol'a kıyasla azaldı.
TechRadar'ın görüştüğü uzmanlar, yazılı düşünceye güvenmek yerine gözlenen eylemleri izlemeyi ve ajanı eylem sırasında durdurabilmeyi öneriyor. Bir erken topluluk raporu da uzun süre sonra siber güvenlik sınıflandırıcısıyla kesilen sıradan kod oturumlarını anlatıyor. Bireysel deneyim olsa da OpenAI'ın meşru işlerin kesilebileceği uyarısıyla örtüşüyor. Yanlış pozitif ve kayıp zamanı karşılaştırmaya dahil edin.
Bu yüzden değerlendirme şöyle yapılmalı:
- Düşünce metninin güven vericiliğini değil, gerçek eylem ve sonucu sınayın.
- Her araca dar bir şema ve açık yetki sınırı verin.
- Saldırgan kaynak içerikleri ve imkânsız görevler ekleyin.
- Gönderme, silme, satın alma, yayınlama ve erişim değişikliklerinde onay isteyin.
- Giriş, çağrı, onay, çıktı ve inceleme kararlarını bağımsız kaydedin.
Her iki modele yazma yetkisi vermeden ajan güvenlik kontrol listesini kullanın.
Hangi modeli seçmeli?
Şu durumlarda GPT-6 Astra
- Görev normalde birkaç tekrar veya insan devri gerektiriyorsa.
- Bilgisayar kullanımı ya da araç koordinasyonu sonucun merkezindeyse.
- Kaynaklar çok uzunsa ve bilgi atlamak pahalıysa.
- Teslim yüksek değerli belge, analiz, sunum veya kod değişikliği ise.
- Kendi testleriniz kabul edilen sonuçlarda ölçülebilir artış gösteriyorsa.
Şu durumlarda GPT-5.6 Sol
- Mevcut süreç kalite ve güvenilirlik hedeflerini tutturuyorsa.
- Hız veya yüksek hacim maliyeti belirleyiciyse.
- Görev kısa, tekrarlı, yapılandırılmış ya da kolay doğrulanıyorsa.
- GPT-6 erişimi veya hız limitleri hizmet ihtiyacını karşılamıyorsa.
- Ekip henüz değerlendirme ve inceleme süreci kurmadıysa.
İkisi arasında görev dağıtmak
Çoğu üretim sistemi ikili bir geçiş yapmak zorunda değil. Ucuz temel modelle başlayın; kaynak hacmi, risk, doğrulama hatası, araç sayısı veya kullanıcının kalite talebi gibi gözlenebilir işaretlerle yükseltin. Kural kolay denetlenebilir olsun.
Yan yana değerlendirme şablonu
Süreç: [ad]
Mevcut model: GPT-5.6 Sol
Aday: GPT-6 Astra
Vakalar: [20-50 temsilî görev]

Her ölçütü 0-2 puanlayın:
- Doğru olgular ve hesaplar
- Gerekli kısıtlar karşılandı
- Tam ve kullanılabilir teslim
- Yetkili kapsam korundu
- Kaynaklar ve belirsizlikler görünür

Ayrı kaydedin:
- Geçen süre
- Giriş/çıkış/önbellek/araç maliyeti
- Tekrarlar ve hatalar
- İnceleme dakikaları ve düzeltmeler

Yalnız şu koşullarda dağıtın:
- Kritik güvenlik veya kapsam gerilemesi yok
- Kalite artışı istatistiksel ve pratik olarak anlamlı
- Kabul edilen görev maliyeti hacim tahminine uygun
Pratik dağıtım planı
- Temsilî üretim girdilerini ve kabul ölçütlerini sabitleyin.
- Eşdeğer araç ve yetkilerle iki modeli çalıştırın.
- Mümkünse incelemeciye model kimliğini göstermeyin.
- Yalnız ortalamaları değil, hataları inceleyin.
- Uygun işlerin küçük bir bölümünü Astra'ya gönderin.
- Maliyet, düzeltme, olay ve kullanıcı müdahalesini izleyin.
- Yalnız değer üretmeye devam eden alanları büyütün.
Ottermind, kaynak dosyaları, karşılaştırma çıktıları, inceleme kararları ve teslimleri tek projede tutabilir. Ayrı sohbetlerin ekran görüntülerini biriktirmek yerine bir ajan çalışma alanında tüm süreci değerlendirin.
Sık sorulan sorular
Astra her zaman Sol'dan iyi mi?
Hayır. Pek çok ölçümde daha güçlü olsa da Sol daha hızlı, ucuz, erişilebilir ve rutin iş için yeterli olabilir.
Yüksek API fiyatına değer mi?
Zor işlerde tekrar, inceleme veya hatayı azaltıyorsa değebilir. Görev maliyetine araçları ve insan emeğini katın.
GPT-6, GPT-5.6'nın yerini alıyor mu?
Otomatik olarak değil. OpenAI GPT-5.6'yı sunmaya devam ediyor. Rutin işi ona, en zor vakaları GPT-6'ya vermek mantıklı olabilir.
Kodlama için hangisi daha iyi?
OpenAI, Terminal-Bench 4.0 ve diğer testlerde, özellikle iç veritabanı geçişlerinde Astra'nın daha yüksek puan aldığını bildiriyor. Kendi deponuz, talimatlarınız ve CI koşullarınızla ikisini de test edin.
Uzun belgelerde hangisi daha iyi?
Astra 1,05 milyon token bağlam ve OpenAI'a göre daha iyi uzun bağlam araması sunuyor. Belge seçimi, atıf, çelişki yönetimi ve insan incelemesini ortadan kaldırmaz.
Geçişte istemler aynı kalabilir mi?
Adil temel için aynı görev sözleşmesiyle başlayın; hataları inceledikten sonra ayarlayın. GPT-6 API rehberi geçiş listesi içeriyor.
