Guia técnico
Guia da API do GPT-6: preço, contexto, ferramentas e migração
Use gpt-6-astra na Responses API da OpenAI para desenvolver com GPT-6. O modelo aceita entrada de texto e imagem, saída de texto, chamadas de funções, Structured Outputs, streaming e ferramentas hospedadas pela OpenAI. Oferece janela de contexto de 1.050.000 tokens, saída máxima de 128.000 tokens e tarifas Standard de US$ 10 por milhão de tokens de entrada e US$ 50 por milhão de tokens de saída.
Não comece uma migração de produção trocando apenas o nome do modelo. GPT-6 acrescenta chamadas assíncronas de ferramentas, direcionamento durante o turno e mudanças de raciocínio na conversa. Esses recursos afetam estado da sessão, chamadas pendentes, cancelamento, observabilidade e custo. Comece com um conjunto fixo de avaliação e uma pequena parcela de tarefas encaminhadas ao novo modelo.
Fontes: página do modelo; orientações do modelo; guia de migração para Responses API; anúncio; visão geral de segurança; Artificial Analysis; testes de custo e esforço na API; teste de programação baseado em produção. Consultadas em 7 de setembro de 2026.
Referência rápida
| Configuração | Valor atual |
|---|---|
| ID do modelo | gpt-6-astra |
| API recomendada | Responses API |
| Janela de contexto | 1.050.000 tokens |
| Saída máxima | 128.000 tokens |
| Limite de conhecimento | 30 de abril de 2026 |
| Esforço de raciocínio | low, medium, high, xhigh, max |
| Texto | Entrada e saída |
| Imagens | Apenas entrada |
| Modalidades de áudio e vídeo | Sem suporte direto |
| Chamadas de funções | Com suporte |
| Structured Outputs | Com suporte |
| Ajuste fino | Sem suporte |
| Nível gratuito da API | Sem suporte |
O que os testes externos da API encontraram
A lição inicial mais clara é que a configuração importa tanto quanto o nome do modelo.
A Artificial Analysis testou Astra max pela API da própria OpenAI. No recorte atual, Astra marcou 55 no Intelligence Index, gerou 64,3 tokens de saída por segundo, custou US$ 2,57 por tarefa do índice e levou cerca de 355 segundos até o primeiro token no esforço máximo. Max é uma escolha intencionalmente cara, mas esses números mostram por que uma integração deve tornar esforço, latência e custo visíveis, em vez de escondê-los sob o rótulo gpt-6-astra.
A ComputingForGeeks confirmou as tarifas anunciadas com uma solicitação real e executou o mesmo problema de depuração com diferentes modelos e esforços. Na comparação, Astra usou 3.525 tokens de raciocínio, levou 75,5 segundos e custou cerca de US$ 0,194. Sol levou 39,3 segundos e custou aproximadamente US$ 0,048. Ambos chegaram ao mesmo diagnóstico; Astra acrescentou uma ressalva e etapas de confirmação mais fortes.
O autor também relatou que passar de low para max na mesma pergunta ao Astra multiplicou o custo por quase 10 e a latência por aproximadamente oito. Low já havia encontrado as três causas; o esforço maior trouxe um plano mais completo e acabou atingindo o limite de saída de 6.000 tokens usado no teste. É um único teste, mas favorece um padrão conservador: começar em medium, aumentar o esforço com base em resultados medidos e limitar a saída.
O teste de programação baseado em produção mostra o outro lado da conta. Astra evitou um erro de estado entre componentes que um modelo mais barato entregou mesmo com a suíte verde. Uma chamada de API pode custar mais isoladamente e, ainda assim, a tarefa aprovada sair mais barata após contabilizar revisão e reparo. Sua avaliação precisa dos dois números.
A página do modelo também lista busca na web, busca em arquivos, geração de imagens, interpretador de código, shell hospedado, aplicação de patches, skills, uso do computador, MCP e busca de ferramentas como recursos da Responses API. Uma ferramenta compatível não está automaticamente habilitada, autorizada ou adequada à sua aplicação.
O que uma demonstração de criador não comprova sobre a API
O relato de Matt Shumer diz que seus maiores experimentos exigiram sessões coordenadas e grande consumo de tokens, e que execuções longas podiam estagnar. Uma integração deve medir o avanço até a aceitação, além do tempo decorrido. Um processo que continua gerando saída pode já ter parado de melhorar a entrega.
As notas do episódio de Claire Vo destacam QA no navegador além da implementação. Para uma aplicação de API, a pergunta equivalente é se o ambiente consegue inspecionar o artefato pronto. Dê a tarefas de código verificações de comportamento e a tarefas de documentos verificações de fontes; uma resposta de texto sem ferramentas não reproduz uma demonstração que depende delas.
Esses relatos ajudam a projetar testes. Não validam parâmetros da API, comportamento de cobrança nem uma taxa geral de conclusão.
Solicitação mínima à Responses API
Use a versão oficial do SDK da OpenAI recomendada no guia de início rápido atual. Uma solicitação mínima em JavaScript tem esta estrutura:
import OpenAI from "openai";

const client = new OpenAI();

const response = await client.responses.create({
  model: "gpt-6-astra",
  reasoning: { effort: "medium" },
  input: [
    {
      role: "developer",
      content: "Return a concise, source-grounded decision brief.",
    },
    {
      role: "user",
      content: "Compare the attached proposals against the approval criteria.",
    },
  ],
});

console.log(response.output_text);
Mantenha chaves de API em segredos gerenciados pelo ambiente, nunca em prompts, arquivos de código, código do cliente ou logs. Valide o objeto de resposta real, sem presumir que output_text seja a única saída: chamadas de ferramentas e itens estruturados também podem aparecer.
Escolha o esforço de raciocínio com intenção
GPT-6 Astra não aceita none. Comece em low ou medium na avaliação e aumente apenas onde a melhoria de qualidade justificar latência e custo. As tabelas da OpenAI mostram a pontuação máxima obtida entre os esforços, portanto um benchmark de destaque não garante o mesmo resultado na configuração escolhida.
Considere uma política de encaminhamento como esta:
| Sinal da tarefa | Esforço inicial |
|---|---|
| Transformação curta e delimitada | Low |
| Análise de várias fontes com critérios claros | Medium |
| Planejamento, programação ou coordenação de ferramentas difíceis | High |
| Problema raro e de alto valor após falha em esforços menores | Xhigh ou max |
Registre o esforço em cada execução. Caso contrário, uma regressão posterior pode parecer mudança de modelo quando, na verdade, foi mudança de configuração. Defina também um limite de saída: o raciocínio oculto é cobrado como saída, e uma execução de alto esforço pode gastar bastante antes de terminar a resposta visível.
Atualize o raciocínio durante a conversa
A OpenAI documenta itens de entrada configuration_update para alterar o esforço preservando o prefixo em cache. Isso é útil quando uma sessão simples encontra uma exceção difícil ou quando uma fase complexa termina e o trabalho seguinte se torna rotineiro.
A aplicação deve registrar o histórico das configurações, não apenas o valor final. Uma execução que passa de low para max tem expectativa de custo e latência diferente de outra que permanece em low.
Chamadas assíncronas de ferramentas
Com uma função assíncrona ou ferramenta personalizada, Astra pode continuar atividades que não dependem do resultado enquanto sua aplicação executa a chamada. Quando o resultado estiver pronto, devolva-o com o ID original.
A execução assíncrona introduz problemas comuns de sistemas distribuídos:
- Um resultado pode chegar depois de o usuário cancelar ou alterar a tarefa.
- Duas chamadas podem terminar fora de ordem.
- Um timeout pode ocorrer depois de uma gravação externa bem-sucedida.
- Repetir uma chamada não idempotente pode duplicar a ação.
- O modelo pode terminar todo o trabalho independente enquanto uma chamada necessária permanece pendente.
Persista uma máquina de estados com pending, completed, failed, cancelled e expired. Use chaves de idempotência em gravações, consulte o sistema oficial de registro antes de repetir e rejeite resultados tardios de versões obsoletas da tarefa.
Direcionamento durante o turno
Por uma conexão WebSocket, a aplicação pode enviar instruções adicionais enquanto Astra trabalha. Isso facilita corrigir tarefas longas sem reiniciá-las, mas exige versionar a intenção do usuário.
Registre cada mudança com data e hora e identifique quais ações pendentes ela invalida. Se o público de um relatório mudar, a redação pode continuar. Se o usuário alterar a conta ou o destino de uma ação externa, pause até validar e aprovar o novo escopo.
Saídas estruturadas e ferramentas
Use Structured Outputs quando o código seguinte precisar de um esquema. O esquema valida a forma, não a veracidade. Confira identificadores contra os valores permitidos, calcule totais de maneira independente e verifique as fontes antes de aceitar o objeto.
Projete ferramentas restritas:
Prefira: create_draft_invoice(customer_id, line_items)
Evite:   run_shell(command)

Prefira: search_approved_project_sources(query, project_id)
Evite:   browse_any_url(url)
A aplicação, e não o prompt, deve impor identidade, escopo do tenant, argumentos permitidos, orçamento e confirmação. Consulte o guia de arquitetura de agentes de IA antes de conectar sistemas de produção.
Uso do computador
GPT-6 Astra é o modelo de uso do computador mais forte reportado pela OpenAI, mas interfaces visuais não são determinísticas e podem mudar entre observação e ação. Trate cliques e teclas como operações propostas:
- Restrinja aplicação, conta e escopo disponíveis.
- Capture o estado usado para tomar a decisão.
- Mostre uma prévia de mudanças importantes antes de executá-las.
- Exija confirmação para enviar, excluir, publicar, comprar ou alterar permissões.
- Verifique o estado resultante com uma leitura independente.
- Guarde evidências suficientes para diagnosticar e desfazer uma falha.
O guia de agentes de IA para desktop explica como o acesso ao computador local muda o modelo de risco.
Preços da API do GPT-6
A OpenAI informa estas tarifas do GPT-6 Astra por milhão de tokens de texto:
| Item | Tarifa Standard |
|---|---|
| Entrada | US$ 10,00 |
| Entrada em cache | US$ 1,00 |
| Gravações no cache | US$ 12,50 |
| Saída | US$ 50,00 |
Prompts acima de 272.000 tokens de entrada são cobrados pelo dobro das tarifas de entrada e cache e por 1,5 vez a tarifa de saída, na solicitação inteira. Gravações no cache custam 1,25 vez a entrada sem cache. Batch e Flex custam 50% de Standard; Fast custa o dobro da tarifa aplicável. Ferramentas podem gerar cobranças adicionais.
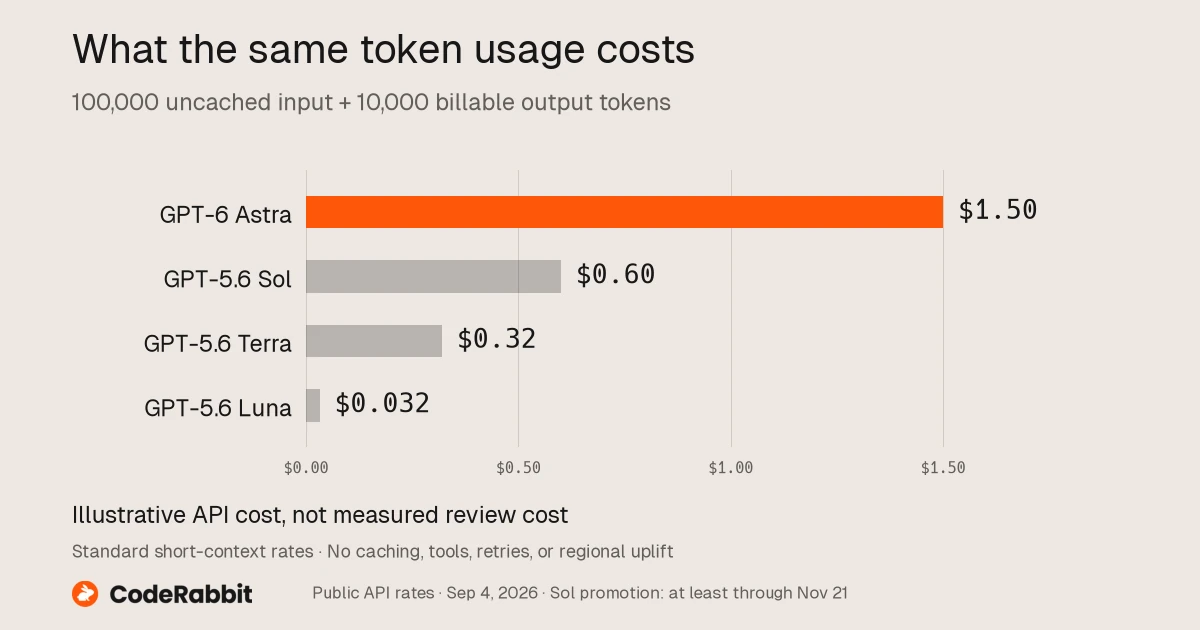
Exemplo de custo da CodeRabbit, com tokens fixos e tarifas de 4 de setembro de 2026. Não é o custo medido por tarefa concluída.
Exemplo de custo
Uma solicitação Standard com 80.000 tokens de entrada sem cache e 8.000 tokens de saída custa aproximadamente:
entrada: 80.000 / 1.000.000 x US$ 10 = US$ 0,80
saída:    8.000 / 1.000.000 x US$ 50 = US$ 0,40
subtotal do modelo: US$ 1,20
O exemplo não inclui ferramentas, gravações no cache, tentativas ou revisão. Acima do limite de prompts longos, os multiplicadores alteram o cálculo da solicitação inteira.
Use o cache de prompts de forma planejada
Coloque instruções estáveis, esquemas e fontes compartilhadas antes do conteúdo do usuário que muda com frequência, permitindo reaproveitar um prefixo comum. Registre separadamente tokens de leitura e de gravação no cache. Não mantenha material irrelevante apenas para aumentar a taxa de acerto do cache: ele ainda pode distrair o modelo e complicar o controle de acesso.
Versione o prefixo em cache. Quando uma política, fonte ou esquema mudar, o registro da execução deve mostrar exatamente qual versão foi usada.
Limites de uso e disponibilidade
A página do GPT-6 lista limites por nível de uso e informa que o nível gratuito da API não é compatível. Os limites podem aumentar com uso e gastos. Prepare a aplicação para respostas 429, controle de pressão na fila, cancelamento e um modelo alternativo definido. Em tarefas críticas de segurança ou sensíveis ao esquema, nunca troque silenciosamente de modelo sem registrar a mudança e revalidar a saída.
Segundo o anúncio, clientes elegíveis da API podem usar Zero Data Retention. Elegibilidade, residência de dados e processamento de segurança são requisitos distintos; confirme cada um para sua conta e região.
A OpenAI também alerta que as proteções adicionais podem interromper trabalho legítimo. Um relato inicial da comunidade Codex documentou tarefas comuns de repositório encerradas repetidamente por política de cibersegurança perto do fim da execução. Trate isso como um caso de falha a investigar, não uma taxa medida: registre bloqueios, tempo perdido, configuração e se a alternativa concluiu o trabalho com segurança.
Checklist de migração
- Fixe 20 a 50 tarefas representativas e seus resultados esperados.
- Registre modelo atual, prompts, ferramentas, esforço, latência e custo por tarefa aprovada.
- Troque apenas o modelo primeiro para criar uma referência comparável.
- Observe os novos comportamentos antes de reescrever prompts.
- Teste contexto longo com evidências ausentes, conflitantes e desatualizadas.
- Teste negação de ferramentas, timeout, resultado duplicado e cancelamento.
- Teste injeção de prompt em arquivos e páginas da web.
- Valide Structured Outputs além da conformidade com o esquema.
- Acrescente orçamento e condições de parada a cada execução.
- Encaminhe uma pequena porcentagem de tarefas elegíveis antes de ampliar.
- Fixe um snapshot do modelo quando a reprodução for importante e houver uma versão adequada.
- Mantenha uma alternativa e um caminho de rollback testados.
Para decidir entre modelos, leia GPT-6 vs GPT-5.6.
Modelo de avaliação para produção
Fluxo: [nome e responsável]
Modelo: gpt-6-astra
Esforço de raciocínio: [low/medium/high/xhigh/max]
Versão do prompt: [ID]
Fontes: [IDs, permissões, data de recuperação]
Ferramentas: [esquemas, escopos, timeouts, idempotência]
Contrato de saída: [esquema e verificações semânticas]
Confirmações humanas: [ações que exigem confirmação]
Orçamentos: [tokens, ferramentas, custo, tempo]
Tratamento de falhas: [repetir, usar alternativa, parar, escalar]
Aceitação: [limites de qualidade, segurança, latência e custo]
Auditoria: [entradas, chamadas, aprovações, saídas, decisão do revisor]
O Ottermind pode reunir briefing de avaliação, fontes, saídas dos testes, decisões de revisão e entrega final em um workspace conectado. Comece com um fluxo delimitado e use o guia de engenharia de prompts para explicitar o contrato da tarefa antes de acrescentar ferramentas.
Perguntas frequentes
Qual é o nome do modelo GPT-6 na API?
Use gpt-6-astra na API da OpenAI.
Devo usar Chat Completions ou Responses API?
A página do modelo lista os dois endpoints, mas o guia do GPT-6 usa Responses API e seus recursos mais novos dependem dessa interface. Prefira Responses em novas aplicações com ferramentas.
GPT-6 aceita ajuste fino?
A página atual do modelo informa que não há suporte a ajuste fino.
GPT-6 pode processar imagens?
Sim, a página lista entrada de imagens. Não há saída direta de imagens como modalidade, embora a geração de imagens esteja disponível como ferramenta.
Quanto custa uma solicitação à API do GPT-6?
Depende de entrada, saída, cache, multiplicadores para prompts longos, modo de processamento, ferramentas e tentativas. Em 7 de setembro de 2026, as tarifas básicas Standard são US$ 10 por milhão de tokens de entrada e US$ 50 por milhão de tokens de saída.
Posso enviar um milhão de tokens em toda solicitação?
A janela é de 1,05 milhão de tokens, mas capacidade não é recomendação de uso. Prompts acima de 272.000 tokens de entrada recebem outro preço e continuam exigindo seleção cuidadosa de fontes e avaliação.
GPT-6 é seguro para uso autônomo de ferramentas?
Nenhum modelo deve receber ferramentas irrestritas. Imponha privilégio mínimo, valide argumentos, peça confirmação em ações importantes e audite o comportamento observável. Comece pelo checklist de segurança para agentes de IA.
