Guide technique
GPT-6 pour coder : bugs entre fichiers, petits correctifs et tests réels
L'atout le plus intéressant de GPT-6 Astra pour le code est sa capacité à relier des informations réparties dans un dépôt. Les premiers tests montrent un bénéfice plus net sur les revues difficiles entre fichiers que sur les petites modifications. Il mérite donc d'être évalué pour comprendre les conséquences d'un changement, tandis que les implémentations courantes nécessitent encore une comparaison de coût et de rapidité.
Deux évaluations externes posent des questions différentes : CodeRabbit mesure les bugs connus détectés par les commentaires de revue ; Real Python examine cinq prompts fixes. Ensemble, elles donnent une base plus concrète qu'un seul classement de programmation.
Sources: évaluation CodeRabbit; tests Real Python; comparatif OpusBooster. Consultées le 7 septembre 2026. Les résultats et expériences sont attribués à leurs auteurs dans le texte.
Ce que CodeRabbit a mesuré
Dans son évaluation du 4 septembre, CodeRabbit rapporte la couverture suivante des bugs par des constats exploitables :
| Ensemble de revue | Astra | Sol | Écart |
|---|---|---|---|
| Ensemble complet | 61,3 % | 59,0 % | 2,3 points de pourcentage |
| Sous-ensemble difficile entre fichiers | 57,1 % | 47,6 % | 9,5 points de pourcentage |
Le progrès relatif d'environ 20 % sur les cas difficiles n'est pas une hausse de 20 points. Il ne signifie pas non plus que chaque équipe livrera 20 % de bugs en moins. La mesure porte sur les bugs identifiés dans cette évaluation, et les deux lignes correspondent à des difficultés différentes.
Ce résultat incite à essayer Astra sur des changements dont les effets sont répartis entre fichiers. Il ne prouve pas que chaque commentaire est juste, que tous les défauts importants sont trouvés ou qu'un petit correctif exige le modèle le plus cher.
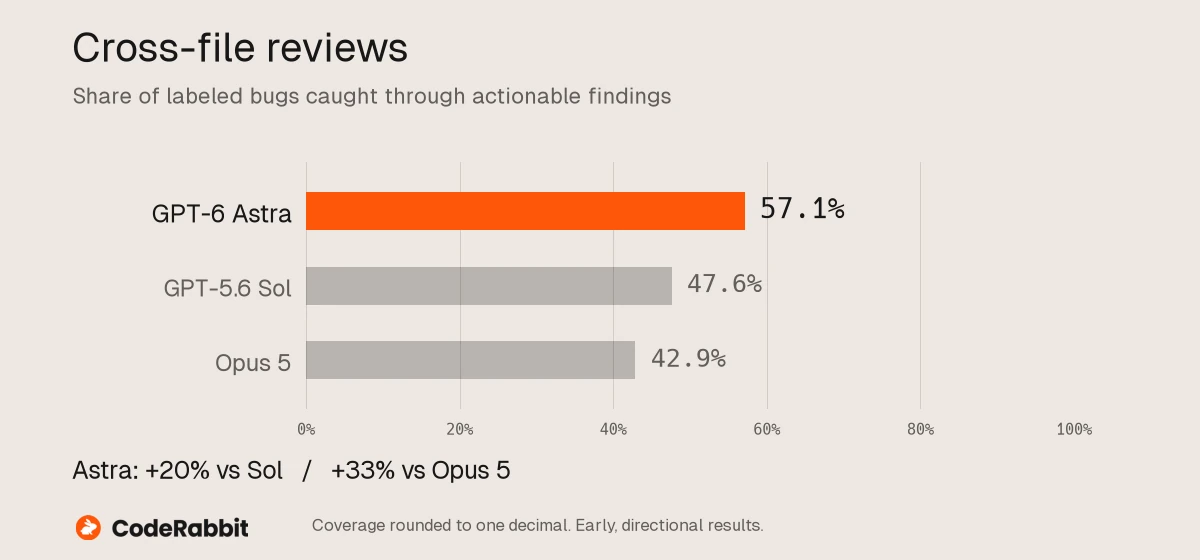
Résultats de revue entre fichiers publiés par CodeRabbit. Ces premiers constats ne mesurent pas la qualité globale d'une revue.
Ce que Real Python a testé
Le test de cinq prompts de Real Python utilise Astra via OpenRouter, au raisonnement par défaut, avec un essai par prompt et sans instruction système. Les sorties sont publiées et consultables.
Le modèle a reconnu qu'une fonction inventée de la bibliothèque standard n'existait pas. Pour ajouter une petite option, il a modifié 11 lignes contre un minimum de sept. Les cinq tâches ont coûté 0,31 $ US dans cet essai. C'est une trame utile : tester les API fictives, la taille des correctifs et leur exécution, au lieu d'accepter du code parce qu'il paraît plausible.
Cinq prompts ne prédisent pas la performance de tout votre dépôt. Ils peuvent toutefois révéler des comportements fins que les grands benchmarks ignorent.
Pourquoi des tests au vert peuvent manquer la fonctionnalité
Un comparatif Astra-Terra issu d'une tâche de production a trouvé deux implémentations passant les tests existants, mais l'une gérait mal des états de pagination liés. Astra conservait cette relation et ajoutait une vérification correspondante.
La leçon consiste à examiner le contrat fonctionnel modifié. Les tests existants n'exercent peut-être jamais l'interaction qui rend la nouvelle fonction utile. Demandez s'ils couvrent le parcours utilisateur, pas seulement la fonction ajoutée.
Lire le correctif derrière le score
Real Python publie le diff de la petite modification et le nombre de lignes. Les lignes supplémentaires incluent la mise en forme de l'argument ; dépasser le minimum ne démontre donc pas une surconception nuisible. Il faut vérifier si le correctif change un comportement hors de la demande. Le suivi en conditions de travail réelles était encore inachevé lors de la consultation : les cinq prompts doivent être jugés pour ce qu'ils mesurent. Voir le test et le correctif.
Cette distinction vaut pour tout agent de code. Un correctif plus long peut être plus clair ; un petit peut cacher une rupture de compatibilité. Examinez ce que fait le code ajouté, les comportements qu'il modifie et si les nouveaux tests échoueraient sans la correction.
Servez-vous des benchmarks pour sélectionner des candidats, puis inspectez leurs livrables pour déterminer leur adéquation au dépôt. Démonstration de produit, couverture des bugs et prompts fixes répondent à des questions différentes.
Exemple complet : revoir une pagination partagée
Prenons une page illustrative comportant deux listes paginées indépendamment. L'utilisateur place la première à la page trois, puis avance la seconde. La première doit rester à la page trois. Chaque pagination peut fonctionner isolément tandis que leur combinaison échoue.
Le relecteur doit suivre la construction de l'URL, l'analyse des paramètres, l'état des composants et la navigation. Si le nouveau lien contient uniquement le paramètre de la seconde liste, il peut supprimer le choix de la première. Un test unitaire isolé de l'une ou l'autre pagination peut le manquer.
URL initiale : /results?customersPage=3&invoicesPage=1
Action : avancer les factures à la page 2
Attendu : /results?customersPage=3&invoicesPage=2
Vérifier aussi : rechargement, retour navigateur et numéro de page invalide
C'est ce type de relation que le cas OpusBooster invite à examiner. Il rappelle aussi l'intérêt d'un exemple d'acceptation avant l'implémentation. L'agent et le relecteur disposent ainsi d'une cible précise, tout en pouvant utiliser les utilitaires existants du dépôt.
Distinguer couverture et qualité de revue
Un relecteur qui trouve plus de bugs connus peut encore produire des faux positifs gênants. Votre évaluation doit consigner les constats acceptés, ceux rejetés et le temps passé à vérifier les deux. Une inquiétude vague sans condition de déclenchement peut consommer plus d'attention qu'elle n'en économise.
| Résultat | À noter | Intérêt |
|---|---|---|
| Défaut confirmé | Reproduction et comportement touché | Identifie un constat utile |
| Faux positif | Pourquoi le code est valide | Mesure le bruit de la revue |
| Question non résolue | Preuve ou environnement manquant | Évite de transformer une incertitude en bug affirmé |
| Défaut manqué | Bug historique ou reproduction ultérieure | Révèle un manque de couverture |
Faites juger les constats sans montrer le nom du modèle lorsque possible. Gardez la difficulté visible : une petite configuration et une migration multiservice ne doivent pas être fondues dans une moyenne inexpliquée.
Fournir le contexte nécessaire aux conséquences
Partez de la demande et du diff, puis rendez accessibles les appelants et tests touchés. Incluez les compatibilités faciles à oublier : ancien client API, format persistant ou commande publique dont des scripts analysent la sortie.
Évitez de verser des documents sans rapport dans le prompt. Demandez au modèle de suivre les chemins affectés et d'expliquer les lectures nécessaires. La revue devient vérifiable, et vous pouvez repérer une dépendance importante jamais examinée.
Pour un type partagé, vérifiez producteurs et consommateurs. Pour une migration de base, indiquez les hypothèses de mise à niveau et de retour arrière. Pour une interface, précisez les transitions attendues. Le guide d'architecture des agents IA explique le rôle du contexte et des outils autour du modèle.
Adapter les tests au changement
Les conseils de prompting GPT-6 d'OpenAI signalent que les tâches de code peuvent provoquer plus de tests qu'un petit changement ne l'exige. Définissez en amont le test ciblé, le comportement qu'il prouve et les conditions justifiant une suite plus large.
Une correction orthographique et une modification de l'authentification partagée nécessitent des validations différentes. Sur un petit correctif, relancer plusieurs fois toute la suite apporte parfois peu de preuves. Sur un comportement partagé, un test unitaire peut être insuffisant. Demandez d'expliquer la portée des contrôles par les comportements affectés.
Commencez par les tests couvrant le comportement modifié.
Élargissez les contrôles si un contrat partagé est touché
ou si les premiers résultats révèlent une régression plus large.
Expliquez quel comportement chaque contrôle vérifie.
Si un test ne peut être lancé, donnez sa commande et l'obstacle.
Ne laissez pas l'agent rendre une suite verte en affaiblissant des assertions sans rapport avec la demande. Examinez les tests supprimés et les attentes modifiées dans la revue du correctif. Un statut positif n'est utile que si les tests expriment encore le contrat attendu.
Comparer le coût d'une modification acceptée
Consignez consommation du modèle, temps des outils, tentatives et révision humaine pour chaque cas. Comparez ensuite le coût jusqu'au correctif accepté. Un premier essai bon marché peut devenir cher après deux réparations ; un modèle coûteux peut aussi perdre du temps dans une refonte inutile.
Essayez une répartition limitée : confiez à GPT-6 les revues difficiles entre fichiers et gardez les correctifs courants sur le modèle actuel. Élargissez si les constats acceptés augmentent ou les corrections diminuent. N'extrapolez pas un succès en revue au développement, à la documentation ou au visuel sans les tester séparément.
Quatre cas pour votre propre évaluation
| Cas | Tâche | Critère d'acceptation |
|---|---|---|
| Petite modification | Ajouter une option à une commande | Sans cette option, la sortie existante reste identique |
| Changement entre fichiers | Modifier un champ partagé | Tous les producteurs et consommateurs suivent le nouveau contrat |
| Débogage | Enquêter sur une panne reproductible | La correction résout le cas et préserve les comportements voisins |
| Revue | Examiner une ancienne modification défectueuse | Les constats trouvent des défauts réels sans spéculation inutile |
Utilisez un état de départ propre pour chaque candidat, avec les mêmes consignes, outils et budgets. Conservez correctif réel, changements de tests, corrections humaines et délai d'acceptation. Pour les compromis entre modèles, consultez GPT-6 face à GPT-5.6.
Modèle de prompt pour la revue de code
Examinez ce changement au regard du comportement attendu : [objectif].
Suivez les appelants, consommateurs de données et chemins d'erreur affectés.
Pour chaque constat, fournissez :
- La condition précise qui déclenche le défaut
- Le comportement touché et les références de fichiers à l'appui
- Une reproduction ou un test révélant le problème
Priorisez les défauts exploitables et signalez explicitement l'incertitude.
Ne modifiez aucun fichier pendant cette revue.
Modèle de prompt d'implémentation
Implémentez [comportement] selon les conventions du dépôt.
Lisez le code et les tests pertinents avant de choisir l'approche.
Préservez [invariants et exigences de compatibilité].
Vérifiez [parcours utilisateur précis] ainsi que les tests ciblés.
Renvoyez le changement, les vérifications et les limites restantes.
Rendez les invariants concrets : garder l'autre filtre, préserver la sortie d'une commande ou ne pas modifier le schéma public de réponse. Ces contraintes se testent mieux que « écrire du code de qualité production ».
Quand la migration est rentable
Essayez Astra si la tâche exige un raisonnement soigneux entre modules ou si la revue humaine représente l'essentiel du coût. Gardez une référence économique pour les modifications répétitives et faciles à vérifier. Ne mesurez pas la productivité en lignes ou commentaires générés : les changements inutiles peuvent accroître la charge de revue.
Pour un projet mêlant recherche, exigences et planification du développement, organisez brief et pièces justificatives dans Ottermind. Conservez la vérification du code dans le dépôt et reliez ses résultats à la décision globale.
Questions fréquentes
GPT-6 est-il meilleur en revue de code ?
CodeRabbit observe une meilleure couverture par des constats exploitables, surtout dans son sous-ensemble difficile entre fichiers. Testez ce comportement sur votre propre code.
Un score supérieur permet-il de supprimer la revue ?
Non. La couverture demeure incomplète et un constat utile doit être validé avant de modifier le code.
Astra est-il toujours préférable pour un petit correctif ?
Les résultats publiés ne le prouvent pas. Comparez exactitude, changements inutiles, vitesse et coût.
Que mesurer en plus des tests réussis ?
Le contrat fonctionnel, le risque de régression, la couverture supprimée, les corrections humaines et le délai jusqu'au correctif accepté.
Par où commencer pour les développeurs ?
Utilisez les cas ci-dessus, puis consultez le guide de l'API GPT-6 pour l'intégration.
