Guía técnica
Guía de la API de GPT-6: precios, contexto, herramientas y migración
Usa gpt-6-astra en la Responses API de OpenAI para desarrollar con GPT-6. El modelo admite texto e imágenes de entrada, texto de salida, llamadas a funciones, Structured Outputs, streaming y herramientas alojadas por OpenAI. Tiene una ventana de 1.050.000 tokens, una salida máxima de 128.000 tokens y tarifas Standard de 10 USD por millón de tokens de entrada y 50 USD por millón de salida.
No inicies una migración a producción cambiando solo el nombre del modelo. GPT-6 incorpora herramientas asíncronas, instrucciones durante el turno y ajustes de razonamiento en la conversación. Afectan al estado de sesión, llamadas pendientes, cancelación, observabilidad y coste. Empieza con un conjunto de evaluación fijo y una pequeña parte del trabajo asignada al nuevo modelo.
Fuentes: ficha del modelo; guía del modelo; migración a Responses API; anuncio; resumen de seguridad; Artificial Analysis; pruebas de coste y esfuerzo de la API; prueba de programación basada en producción. Consultadas el 7 de septiembre de 2026.
Referencia rápida
| Parámetro | Valor actual |
|---|---|
| Identificador del modelo | gpt-6-astra |
| API recomendada | Responses API |
| Ventana de contexto | 1.050.000 tokens |
| Salida máxima | 128.000 tokens |
| Límite de conocimiento | 30 de abril de 2026 |
| Esfuerzo de razonamiento | low, medium, high, xhigh, max |
| Texto | Entrada y salida |
| Imágenes | Solo entrada |
| Modalidades de audio y vídeo | Sin soporte directo |
| Llamadas a funciones | Compatibles |
| Structured Outputs | Compatible |
| Ajuste fino | No compatible |
| Nivel gratuito de API | No compatible |
Qué encontraron los ensayos externos de la API
La lección inicial más clara es que la configuración importa tanto como el nombre del modelo.
Artificial Analysis probó Astra max mediante la API de OpenAI. En su captura actual obtuvo 55 en el Intelligence Index, generó 64,3 tokens por segundo, costó 2,57 USD por tarea y necesitó unos 355 segundos hasta el primer token con esfuerzo máximo. Max es deliberadamente costoso, pero estas mediciones explican por qué la integración debe mostrar esfuerzo, latencia y coste en vez de ocultarlos bajo gpt-6-astra.
ComputingForGeeks verificó las tarifas anunciadas con una petición real y ejecutó el mismo problema de depuración con varios modelos y esfuerzos. Astra utilizó 3.525 tokens de razonamiento, tardó 75,5 segundos y costó aproximadamente 0,194 USD. Sol tardó 39,3 segundos por unos 0,048 USD. Ambos llegaron al mismo diagnóstico; Astra añadió una salvedad y una confirmación más completa.
El autor también señaló que pasar de low a max en la misma pregunta multiplicó casi por 10 el coste y por ocho la latencia. Low ya había encontrado las tres causas; más esfuerzo produjo un plan más exhaustivo y acabó alcanzando el límite de salida de 6.000 tokens del ensayo. Es un solo caso, pero respalda una opción prudente: comenzar con medium, aumentar por un motivo medido y limitar la salida.
La prueba de programación basada en producción muestra la otra cara. Astra evitó un error de estado entre componentes que un modelo económico entregó pese a superar los tests. Una llamada puede ser más cara y la tarea completa, incluyendo revisión y reparación, resultar más barata. La evaluación necesita ambos datos.
La ficha enumera también búsqueda web y de archivos, generación de imágenes, intérprete de código, shell alojado, aplicación de parches, skills, uso del ordenador, MCP y búsqueda de herramientas como funciones compatibles con Responses API. Que una herramienta sea compatible no significa que esté activada, autorizada o sea adecuada para tu aplicación.
Qué no demuestra una demo sobre la API
El relato de Matt Shumer dice que sus mayores experimentos dependían de sesiones coordinadas y mucho consumo de tokens, y que podían estancarse. La integración debe medir el avance hacia la aceptación además del tiempo transcurrido. Un proceso que sigue generando salida quizá ya no esté mejorando la entrega.
Las notas del episodio de Claire Vo destacan la QA de navegador junto a la implementación. Para una aplicación API, la pregunta equivalente es si el entorno puede inspeccionar el artefacto terminado. Asigna pruebas de comportamiento al código y controles de fuentes a los documentos: una respuesta puramente textual no reproduce una demo con muchas herramientas.
Estas experiencias orientan el diseño de pruebas; no validan parámetros, facturación ni una tasa general de finalización.
Petición mínima a Responses API
Usa la versión del SDK oficial que recomienda la guía de inicio actual. Una petición mínima de JavaScript tiene esta forma:
import OpenAI from "openai";

const client = new OpenAI();

const response = await client.responses.create({
  model: "gpt-6-astra",
  reasoning: { effort: "medium" },
  input: [
    {
      role: "developer",
      content: "Return a concise, source-grounded decision brief.",
    },
    {
      role: "user",
      content: "Compare the attached proposals against the approval criteria.",
    },
  ],
});

console.log(response.output_text);
Guarda las claves en secretos gestionados por el entorno, nunca en prompts, archivos fuente, código cliente ni registros. Valida el objeto real en lugar de suponer que output_text es la única salida: también puede contener llamadas a herramientas y elementos estructurados.
Elegir el esfuerzo de razonamiento
GPT-6 Astra no admite none. Empieza la evaluación con low o medium y aumenta solo si la mejora justifica latencia y coste. Las tablas de OpenAI publican las puntuaciones máximas obtenidas entre niveles; el benchmark destacado no garantiza el mismo resultado con tu configuración.
Puedes usar este criterio de asignación:
| Señal de la tarea | Esfuerzo inicial |
|---|---|
| Transformación corta y delimitada | Low |
| Análisis de varias fuentes con criterios claros | Medium |
| Planificación, código o coordinación difíciles | High |
| Problema excepcional de alto valor tras fallar niveles inferiores | Xhigh o max |
Registra el esfuerzo en cada ejecución. De lo contrario, una regresión puede parecer un cambio de modelo cuando solo cambió el ajuste. Limita también la salida: el razonamiento oculto se factura como salida, y un esfuerzo alto puede gastar mucho antes de completar la respuesta visible.
Cambiar el razonamiento durante una conversación
OpenAI documenta entradas configuration_update para variar el esfuerzo conservando el prefijo en caché. Resulta útil si una sesión sencilla encuentra una excepción difícil o si una fase compleja da paso a tareas rutinarias.
La aplicación debe registrar la secuencia de configuraciones, no solo la última. Una ejecución que pasa de low a max tiene un coste y una latencia esperados diferentes a otra que permanece en low.
Llamadas asíncronas a herramientas
Con una función asíncrona o herramienta personalizada, Astra puede continuar trabajo independiente mientras la aplicación hace la llamada. Devuelve el resultado cuando esté listo usando su identificador original.
La ejecución asíncrona introduce problemas habituales de sistemas distribuidos:
- El resultado puede llegar después de cancelar o cambiar la tarea.
- Dos llamadas pueden terminar fuera de orden.
- Puede agotarse el tiempo después de una escritura externa correcta.
- Repetir una llamada no idempotente puede duplicar la acción.
- El modelo puede acabar todo el trabajo independiente mientras queda una llamada necesaria pendiente.
Persiste una máquina de estados con pending, completed, failed, cancelled y expired. Usa claves de idempotencia para escribir, consulta el sistema de referencia antes de reintentar y rechaza resultados tardíos de versiones obsoletas de la tarea.
Instrucciones durante el turno
Mediante WebSocket, una aplicación puede enviar instrucciones adicionales mientras Astra trabaja. Facilita corregir tareas largas sin reiniciarlas, pero exige versionar la intención.
Guarda cada cambio con su fecha y hora y marca qué acciones pendientes invalida. Si cambia el público del informe, la redacción puede seguir. Si cambia la cuenta o el destino de una acción externa, pausa hasta validar y aprobar el nuevo alcance.
Salidas estructuradas y herramientas
Usa Structured Outputs cuando el código posterior necesite un esquema. Este valida la forma, no la verdad. Comprueba identificadores permitidos, calcula totales de manera independiente y verifica las fuentes antes de aceptar el objeto.
Diseña herramientas acotadas:
Preferir: create_draft_invoice(customer_id, line_items)
Evitar:   run_shell(command)

Preferir: search_approved_project_sources(query, project_id)
Evitar:   browse_any_url(url)
La aplicación, no el prompt, debe imponer identidad, alcance del tenant, argumentos permitidos, presupuestos y confirmaciones. Consulta la arquitectura de agentes de IA antes de conectar sistemas de producción.
Uso del ordenador
GPT-6 Astra es el modelo de ordenador más potente según OpenAI, pero las interfaces visuales no son deterministas y pueden cambiar entre observación y acción. Trata clics y teclas como operaciones propuestas:
- Limita la aplicación, la cuenta y el alcance disponibles.
- Captura el estado que sustenta la decisión.
- Muestra los cambios importantes antes de ejecutarlos.
- Exige confirmación para enviar, borrar, publicar, comprar o cambiar permisos.
- Verifica el estado final mediante una lectura independiente.
- Guarda evidencia suficiente para diagnosticar y revertir un fallo.
La guía de agentes de IA de escritorio explica cómo el acceso al ordenador local cambia el riesgo.
Precios de la API de GPT-6
OpenAI publica estas tarifas por millón de tokens de texto:
| Concepto | Tarifa Standard |
|---|---|
| Entrada | 10,00 USD |
| Entrada en caché | 1,00 USD |
| Escritura en caché | 12,50 USD |
| Salida | 50,00 USD |
Por encima de 272.000 tokens de entrada, se duplica la tarifa de entrada y caché y se multiplica por 1,5 la de salida para toda la solicitud. Escribir en caché cuesta 1,25 veces la entrada sin caché. Batch y Flex cuestan el 50 % de Standard; Fast duplica la tarifa aplicable. Las herramientas pueden cobrarse aparte.
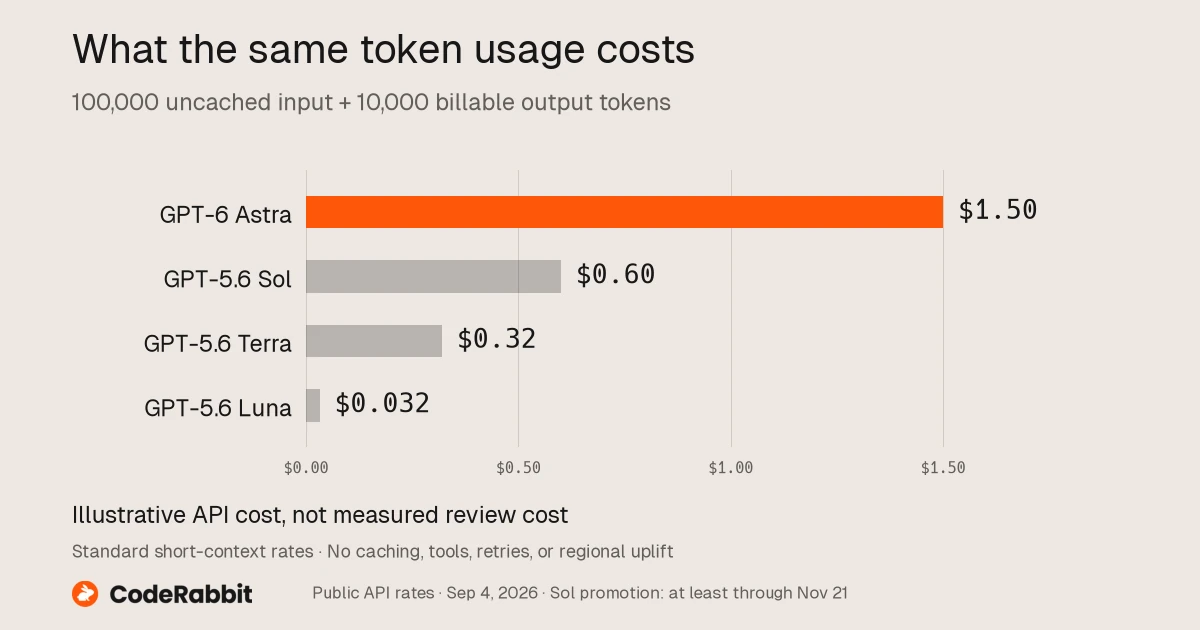
Ejemplo de CodeRabbit con tokens fijos y tarifas del 4 de septiembre de 2026. No es un coste medido por tarea completada.
Ejemplo de coste
Una petición Standard con 80.000 tokens de entrada sin caché y 8.000 de salida cuesta aproximadamente:
entrada: 80.000 / 1.000.000 x 10 USD = 0,80 USD
salida:   8.000 / 1.000.000 x 50 USD = 0,40 USD
subtotal del modelo: 1,20 USD
El ejemplo excluye herramientas, escritura de caché, reintentos y revisión. Al superar el umbral de prompt largo, los multiplicadores cambian el cálculo de toda la petición.
Usar la caché de prompts con criterio
Coloca instrucciones estables, esquemas y fuentes comunes antes del contenido variable, para reutilizar el prefijo. Registra por separado lectura y escritura de tokens en caché. No mantengas material irrelevante solo por aumentar los aciertos: puede distraer al modelo y complicar el control de acceso.
Versiona el prefijo. Si cambia una política, fuente o esquema, el registro debe mostrar exactamente qué versión se usó.
Límites de uso y disponibilidad
La ficha de GPT-6 indica límites por nivel y excluye el gratuito de la API. Pueden aumentar con el uso y el gasto. Prevé respuestas 429, contrapresión de la cola, cancelación y un modelo alternativo deliberado. En tareas críticas o sensibles al esquema, no cambies de modelo silenciosamente sin registrar el cambio y volver a validar la salida.
El anuncio indica que los clientes elegibles pueden usar Zero Data Retention. Elegibilidad, residencia de datos y procesamiento de seguridad son requisitos diferentes; confirma cada uno para tu cuenta y región.
OpenAI también advierte que las protecciones reforzadas pueden detener tareas legítimas. Un relato inicial de Codex documenta trabajo normal de repositorio interrumpido repetidamente al final por política de ciberseguridad. Trátalo como un caso individual a investigar, no como tasa medida: registra bloqueos, tiempo perdido, configuración y si la alternativa terminó de forma segura.
Lista de migración
- Fija de 20 a 50 tareas representativas y resultados esperados.
- Registra modelo, prompts, herramientas, esfuerzo, latencia y coste por tarea aceptada.
- Cambia primero solo el modelo para disponer de una referencia comparable.
- Examina el comportamiento antes de reescribir prompts.
- Prueba contexto largo con evidencia ausente, contradictoria y antigua.
- Prueba denegación de herramientas, tiempos agotados, duplicados y cancelación.
- Prueba inyección de prompts en archivos y páginas.
- Valida Structured Outputs más allá del cumplimiento del esquema.
- Añade presupuesto y condiciones de parada a cada ejecución.
- Asigna un pequeño porcentaje de tareas antes de ampliar.
- Fija una versión del modelo cuando necesites reproducibilidad y exista un snapshot adecuado.
- Conserva una alternativa y una ruta de reversión probadas.
Para decidir qué modelo usar, consulta GPT-6 frente a GPT-5.6.
Plantilla de evaluación para producción
Proceso: [nombre y responsable]
Modelo: gpt-6-astra
Esfuerzo de razonamiento: [low/medium/high/xhigh/max]
Versión del prompt: [ID]
Fuentes: [identificadores, permisos, fecha de recuperación]
Herramientas: [esquemas, alcances, tiempos, idempotencia]
Contrato de salida: [esquema y comprobaciones semánticas]
Validaciones humanas: [acciones que requieren confirmación]
Presupuestos: [tokens, herramientas, coste, tiempo]
Fallos: [reintento, alternativa, parada, escalado]
Aceptación: [umbrales de calidad, seguridad, latencia y coste]
Auditoría: [entradas, llamadas, aprobaciones, salidas, decisión del revisor]
Ottermind puede guardar el briefing, las fuentes, las salidas de pruebas, las decisiones y la entrega en un mismo espacio. Empieza por un proceso delimitado y utiliza la guía de ingeniería de prompts para aclarar el contrato antes de añadir herramientas.
Preguntas frecuentes
¿Cómo se llama GPT-6 en la API?
Usa gpt-6-astra en la API de OpenAI.
¿Chat Completions o Responses API?
La ficha lista ambos, pero la guía GPT-6 usa Responses API y las nuevas funciones dependen de ella. Prefiere Responses para nuevas aplicaciones con herramientas.
¿Admite ajuste fino?
La ficha actual indica que no.
¿Puede procesar imágenes?
Sí, admite imágenes de entrada. No genera imágenes directamente como modalidad, aunque la generación está disponible como herramienta.
¿Cuánto cuesta cada petición?
Depende de entrada, salida, caché, recargos de contexto largo, modo, herramientas y reintentos. A 7 de septiembre de 2026, Standard cuesta 10 USD por millón de tokens de entrada y 50 USD por millón de salida.
¿Puedo enviar un millón de tokens siempre?
La ventana es de 1,05 millones, pero la capacidad no equivale a una recomendación. Más de 272.000 tokens de entrada implican otra tarifa y siguen necesitando fuentes seleccionadas y evaluación.
¿Es seguro el uso autónomo de herramientas?
Ningún modelo debería disponer de herramientas sin restricciones. Aplica mínimo privilegio, valida argumentos, pide confirmación para acciones importantes y audita el comportamiento observable. Empieza con la lista de seguridad para agentes de IA.
