Modellvergleich
GPT-6 vs. GPT-5.6: Astra und Sol im Arbeitsalltag vergleichen
Für besonders schwierige mehrstufige Arbeit ist GPT-6 Astra der stärkere Kandidat; GPT-5.6 Sol bleibt die praktischere Standardwahl, wenn Latenz, Verfügbarkeit und Kosten wichtiger sind als maximale Leistungsfähigkeit. OpenAIs Ergebnisse zeigen Astras größte Fortschritte bei Computernutzung, Automatisierung, Suche in langem Kontext, Wissenschaft und Cybersicherheit. Der Wechsel bringt nicht bei jedem Prompt gleich viel.
Entscheiden Sie nach den Kosten eines akzeptierten Ergebnisses, nicht nach der Modellnummer. Wenn eine Routineanfrage unter GPT-5.6 bereits korrekt, schnell und günstig funktioniert, erhöht GPT-6 möglicherweise nur die Kosten. Scheitert ein Ablauf wiederholt an Werkzeugkoordination, komplexer Schlussfolgerung, langem Kontext oder professionellen Ergebnissen, ist eine kontrollierte Astra-Bewertung sinnvoll.
Quellen: GPT-6-Ankündigung; Modellseite; Entwicklerleitfaden; Sicherheitsübersicht; Astra bei Artificial Analysis; GPT-5.6-Sol-Vergleich; API-Debugging-Test; Coding-Vergleich aus der Produktion. Geprüft am 7. September 2026.
Schnellvergleich
| Entscheidungskriterium | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| Beste Eignung | Schwierige Aufgaben von Anfang bis Ende | Leistungsfähige allgemeine Arbeit zu geringeren Betriebskosten |
| Kontextfenster | 1.050.000 Tokens | Aktuelle Seite der eingesetzten Variante prüfen |
| Maximale Ausgabe | 128.000 Tokens | Aktuelle Seite der eingesetzten Variante prüfen |
| Denkaufwand | Low bis max, kein none | Umfangreiche Steuerung mit produktspezifischen Optionen |
| Neue Ablaufmerkmale | Asynchrone Werkzeuge, Steuerung während des Turns und Anpassung des Denkaufwands im Gespräch | Etablierte Werkzeug- und Responses-API-Abläufe |
| Standard-API-Eingabe | 10 US-Dollar je Million Tokens | Günstiger; aktuelle Preise prüfen |
| Standard-API-Ausgabe | 50 US-Dollar je Million Tokens | Günstiger; aktuelle Preise prüfen |
| Verfügbarkeit | Schrittweise Einführung, kein kostenloser API-Tarif | Breiter in berechtigten OpenAI-Produkten verfügbar |
| Unabhängiger Intelligenzwert | 55 bei max | 51 bei max |
| Unabhängig gemessene Ausgaberate | 64,3 Tokens/Sekunde bei max | Etwa 76 Tokens/Sekunde bei max |
| Unabhängige Kosten je Index-Aufgabe | 2,57 US-Dollar bei max | 1,25 US-Dollar bei max |
| Einsatzstrategie | Zunächst für schwierige, wertvolle Aufgaben reservieren | Als Grundlage für Routine und gemischte Aufgaben behalten |
Die unabhängigen Messungen sind Momentaufnahmen von Artificial Analysis und verändern sich mit Anbietern und Tests. Sie zeigen einen moderaten allgemeinen Intelligenzgewinn, langsamere Ausgabe und etwa doppelte Testkosten, keinen universellen Generationssprung. Für eine Kaufentscheidung gelten die aktuellen Modellseiten.
Unabhängige Tests und die Veröffentlichung
Claire Vos früher Erfahrungsbericht beschreibt Fortschritte bei einer ChatPRD-Funktion, die sie mit Sol und Fable nicht fertigstellen konnte. Das spricht für Astra-Versuche bei blockierten Arbeiten, sagt aber nichts über den typischen Vorteil aus. Verwenden Sie für eigene Vergleiche dieselbe Aufgabe, denselben Repository-Stand und dieselben Abnahmekriterien.
Matt Shumers Einschätzung bevorzugt Astra für tägliche Entwicklungsarbeit und Claude für visuelle Aufgaben. Sie zeigt, warum trotz hoher Tokenpreise ein Standardmodell entstehen kann: Verständliche Kommunikation und weniger Betreuung können wichtiger sein als Generierungstempo. Es bleibt eine persönliche Bewertung und kein kontrollierter Astra-Sol-Test.
Unsere Empfehlung gilt daher für Teams mit festem Budget: Behalten Sie eine funktionierende Grundlage und prüfen Sie Astra bei den Fällen mit dem höchsten Interventionsbedarf. Einzelpersonen mit anderen Aufgaben können sinnvoll anders entscheiden.
OpenAIs größte gemeldete Gewinne betreffen Agenten, Computernutzung und langen Kontext. Artificial Analysis zeigt einen engeren allgemeinen Fortschritt: Astra max erzielt 55 Punkte im Intelligence Index, Sol max 51. Astra erzeugt weniger Ausgabetokens als der Median des Dienstes, ist bei der Ausgabe aber langsamer als Sol und braucht bei max lange bis zum ersten Token.
Ein API-Debugging-Test fand dieselbe Diagnose bei Astra und drei GPT-5.6-Varianten. Astra lieferte die beste Einschränkung und den besten Prüfplan, benötigte aber etwa doppelt so viel Zeit und viermal so viel Geld wie Sol. Das lohnt sich eher, wenn eine fehlende Einschränkung einen teuren Fehler verursacht, nicht wenn lediglich ein Befehl oder eine wahrscheinliche Ursache gesucht wird.
Ein separater produktionsnaher Coding-Test verglich Astra mit GPT-5.6 Terra statt Sol. Beide bestanden die vorhandenen Tests; Terra beschädigte jedoch gekoppelte Seitennavigationszustände, während Astra sie erhielt und einen Test ergänzte. Der Autor wies danach stark gekoppelte, bereichsübergreifende Aufgaben Astra zu und behielt günstigere Modelle für normale und mechanische Änderungen. Das ist besser begründet als ein vollständiger Austausch aller Modelle.
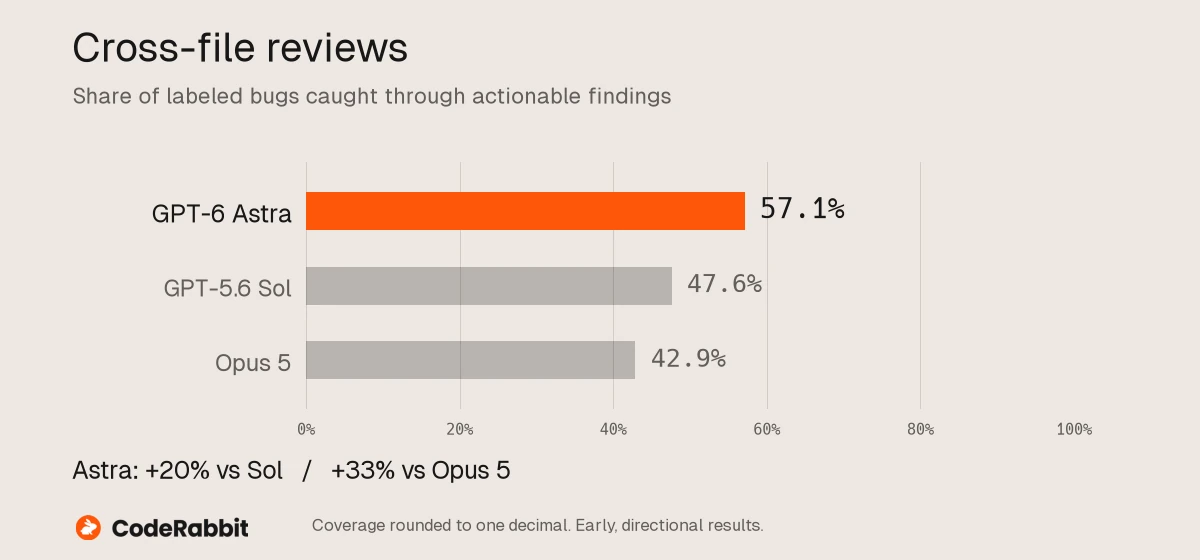
Dateiübergreifende Review-Ergebnisse von CodeRabbit. Frühe Befunde, kein Maß für die gesamte Review-Qualität.
Wo GPT-6 besonders zulegt
OpenAIs Veröffentlichungstests ermöglichen einen nützlichen Vergleich, weil beide Modelle vom selben Herausgeber geprüft wurden. Dennoch sind manche Tests intern, die Werte entsprechen den besten Aufwandsstufen, und Produktivprompts sowie Werkzeuge können die Ergebnisse verändern.
| Bewertung | GPT-6 Astra | GPT-5.6 Sol | Mögliche Bedeutung |
|---|---|---|---|
| OSWorld 2.0 offline | 72,6 % | 65,7 % | Bessere Bedienung von Desktop-Umgebungen |
| AutomationBench | 41,4 % | 18,1 % | Deutlicher Gewinn bei mehrstufiger Automatisierung |
| Terminal-Bench 4.0 | 57,9 % | 37,3 % | Bessere terminalbasierte Entwicklungsarbeit |
| Interne Datenbankmigrationen | 63,9 % | 42,7 % | Potenzial bei langen Änderungen mit Zustandsverwaltung |
| FrontierMath Tier 4 v2 | 97,6 % | 83,0 % | Stärkeres fortgeschrittenes mathematisches Denken |
| MRCR v2, 512K–1M | 96,3 % | 73,8 % | Bessere Suche in sehr langem Kontext |
| ARC-AGI-3 | 99,9 % | 7,8 % | Großer gemeldeter Gewinn bei neuen interaktiven Aufgaben |
Astra führt nicht jeden veröffentlichten Vergleich gegen alle Konkurrenten an. DataCamps Benchmark-Analyse verweist auf den Rückstand gegenüber Claude Fable 5.1 bei Humanity's Last Exam mit Werkzeugen. Die 99,9 % bei ARC-AGI-3 hängen zudem von einer zustandsbehafteten Ausführungsumgebung mit Anbieteradapter ab. Ein zustandsloser API-Aufruf muss diesen Wert nicht reproduzieren. Die Zahlen helfen bei der Auswahl von Tests, nicht als direkte Einsatzentscheidung.
Computernutzung und Agentenabläufe
Das ist der stärkste Grund, GPT-6 zu prüfen. OpenAI hat Astra für Code, Browser, Dokumente, Tabellen, Präsentationen und Fachsoftware entwickelt. Asynchrone Werkzeugaufrufe erlauben unabhängiges Denken während langsamer Werkzeugarbeit. Nutzer können lange Sitzungen während eines Turns korrigieren, ohne neu zu starten.
GPT-5.6 Sol beherrscht bereits Werkzeuge und Agentenabläufe. Behalten Sie Sol bei kurzen Sequenzen, engen Rechten und erfüllten Abnahmekriterien. Prüfen Sie Astra, wenn der Ablauf den Faden verliert, neue Anweisungen falsch verarbeitet, zwischen Programmen scheitert oder zu viele Versuche benötigt.
Die umgebende Architektur bleibt nötig. Authentifizierung, Werkzeugschemata, Rechte, Zustand, Auditprotokolle, Freigaben und Rollback gehören zur Anwendung. Der Leitfaden zur KI-Agenten-Architektur beschreibt diese Verantwortung.
Kontext ist nicht gleich Gedächtnis
Astras Fenster mit 1,05 Millionen Tokens kann viele Quellen aufnehmen, ist aber nur die temporäre Kapazität einer Anfrage. Daraus entsteht nicht automatisch ein korrektes, dauerhaftes Gedächtnis für Kunden, Projekte oder Richtlinien. Dafür braucht es Quellenkennungen, Aktualisierungsregeln, Konfliktlösung, Löschung, Zugriffsrechte und Nutzereinblick.
Verwenden Sie langen Kontext für begrenzte Bestände, die gemeinsam betrachtet werden müssen. Für größere, veränderliche Bestände eignet sich Retrieval. Entscheidungen und freigegebene Ergebnisse, die Sitzungen überdauern sollen, brauchen dauerhaften Projektzustand. Der Leitfaden zum KI-Wissensmanagement erläutert Herkunftsnachweise statt generierter Zusammenfassungen als vermeintliche Wahrheit.
Kosten anhand fertiger Arbeit vergleichen
Die Standard-API von GPT-6 Astra kostet 10 US-Dollar je Million Eingabetokens und 50 US-Dollar je Million Ausgabetokens. Bei Prompts mit mehr als 272.000 Eingabetokens gelten höhere Sätze für die gesamte Anfrage. Cache, Werkzeuge, Fast, Batch und Flex haben eigene Preise.
Bei schwierigen Aufgaben kann Astra günstiger sein, wenn es weniger Tokens verbraucht, Versuche vermeidet oder Prüfaufwand reduziert. Umgekehrt kann selbst eine perfekte Antwort bei massenhafter Klassifizierung unwirtschaftlich sein, wenn diese nicht von Spitzenreasoning profitiert.
Der Debugging-Test veranschaulicht die Größenordnung: etwa 0,194 US-Dollar und 75,5 Sekunden für Astra gegenüber 0,048 US-Dollar und 39,3 Sekunden für Sol. Die Kerndiagnose war gleich; Astra bot präzisere Grenzen und Prüfungen. Ein Prompt liefert keinen Durchschnitt, ergänzt aber Aussagen zur Tokeneffizienz.
Nutzen Sie folgende Rechnung:
Kosten je abgenommener Aufgabe =
  Modelleingabe + Modellausgabe + Cache + Werkzeugaufrufe
  + Fehlversuche + Prüfzeit + Korrekturarbeit

Nutzen des Wechsels =
  vermiedene Fehler + gesparte Arbeit + kürzere Durchlaufzeit
  - zusätzliche Kosten je abgenommener Aufgabe
Messen Sie beide Modelle mit denselben Eingaben. Setzen Sie Prüfzeit nicht mit null an; sie ist häufig der größte versteckte Kostenblock.
Sicherheit und Kontrolle
OpenAI beschreibt Astra als robuster gegen Jailbreaks, Prompt Injection und Grenzüberschreitungen als GPT-5.6 Sol. In einer internen Simulation mit mehr als 54.000 Codex-Aufgaben wurden ungefähr halb so viele schwerwiegende Fehlverhaltensmeldungen erfasst. Gleichzeitig sei das geschriebene Denken weniger gut überwachbar als bei Sol.
Von TechRadar befragte Sicherheitsexperten empfehlen, beobachtbare Aktionen zu überwachen und Agenten mitten in einer Aktion stoppen zu können, statt auf Denktext zu vertrauen. Ein früher Community-Bericht schildert normale Coding-Sitzungen, die nach langer Laufzeit durch Cyberklassifikatoren abgebrochen wurden. Das ist anekdotisch, doch auch OpenAI warnt vor Unterbrechungen legitimer Arbeit. Fehlalarme und verlorene Laufzeit gehören in den Vergleich.
Für die Bewertung bedeutet das:
- Prüfen Sie tatsächliche Aktionen und Ergebnisse, nicht beruhigend klingende Denktexte.
- Geben Sie jedem Werkzeug ein enges Schema und klare Rechte.
- Ergänzen Sie adversariale Quellen und unmögliche Aufgaben.
- Verlangen Sie Bestätigungen für Senden, Löschen, Kaufen, Veröffentlichen und Rechteänderungen.
- Führen Sie ein unabhängiges Protokoll von Eingaben, Aufrufen, Freigaben, Ausgaben und Prüfentscheidungen.
Prüfen Sie die Sicherheitscheckliste für KI-Agenten, bevor Sie einem Modell Schreibrechte geben.
Welches Modell passt?
GPT-6 Astra wählen, wenn
- die Aufgabe normalerweise mehrere Versuche oder menschliche Übergaben benötigt;
- Computernutzung oder Werkzeugkoordination zentral ist;
- die Quellen sehr lang und übersehene Informationen teuer sind;
- ein hochwertiges Dokument, eine Analyse, Präsentation oder Codeänderung entstehen soll;
- eigene Tests einen messbaren Gewinn bei akzeptierten Ergebnissen zeigen.
GPT-5.6 Sol behalten, wenn
- der aktuelle Ablauf Qualitäts- und Zuverlässigkeitsziele erfüllt;
- Geschwindigkeit oder Kosten bei hohem Volumen entscheidend sind;
- die Aufgabe kurz, repetitiv, strukturiert oder leicht prüfbar ist;
- GPT-6-Verfügbarkeit oder Limits die Serviceanforderungen nicht erfüllen;
- das Team noch keinen Bewertungs- und Prüfprozess hat.
Wann beide Modelle sinnvoll sind
Produktionssysteme müssen sich meist nicht binär entscheiden. Beginnen Sie mit der günstigeren Grundlage und eskalieren Sie anhand beobachtbarer Signale: Quellenmenge, Aufgabenrisiko, fehlgeschlagene Validierung, Werkzeugzahl oder gewünschte Qualität. Die Verteilungsregel sollte leicht auditierbar bleiben.
Vorlage für einen direkten Vergleich
Ablauf: [Name]
Aktuelles Modell: GPT-5.6 Sol
Kandidat: GPT-6 Astra
Fälle: [20-50 repräsentative Aufgaben]

Je Kriterium 0 bis 2 Punkte:
- Korrekte Fakten und Berechnungen
- Notwendige Vorgaben eingehalten
- Vollständiges, nutzbares Ergebnis
- Autorisierter Umfang gewahrt
- Quellen und Unsicherheit sichtbar

Separat erfassen:
- Tatsächliche Laufzeit
- Eingabe-/Ausgabe-/Cache-/Werkzeugkosten
- Versuche und Fehler
- Prüfminuten und Änderungen

Nur einführen, wenn:
- Keine kritische Sicherheits- oder Umfangsregression
- Qualitätsgewinn statistisch und praktisch relevant
- Kosten je akzeptierter Aufgabe zum erwarteten Volumen passen
Ein praktischer Einführungsplan
- Fixieren Sie repräsentative Eingaben und Abnahmekriterien.
- Nutzen Sie gleichwertige Werkzeuge und Rechte für beide Modelle.
- Verbergen Sie nach Möglichkeit die Modellidentität vor Prüfern.
- Untersuchen Sie Fehler, nicht nur Mittelwerte.
- Leiten Sie einen kleinen Anteil geeigneter Arbeit an Astra weiter.
- Verfolgen Sie Kosten, Korrekturen, Vorfälle und Nutzereingriffe.
- Erweitern Sie nur die Bereiche, die weiterhin Nutzen zeigen.
Ottermind hält Quelldateien, Vergleichsergebnisse, Prüfentscheidungen und Endprodukte in einem Projekt zusammen. Nutzen Sie einen KI-Agenten-Workspace, um den gesamten Ablauf zu bewerten, statt Screenshots aus getrennten Chats zu sammeln.
Häufige Fragen
Ist GPT-6 Astra immer besser als GPT-5.6 Sol?
Nein. Astra ist in vielen Bewertungen leistungsfähiger; Sol kann schneller, günstiger, verfügbarer und für Routine bereits ausreichend sein.
Lohnt sich der höhere API-Preis?
Bei schwierigen Aufgaben kann er sich durch weniger Versuche, Prüfzeit oder Fehler rechnen. Berücksichtigen Sie Werkzeuge und menschliche Arbeit je akzeptierter Aufgabe.
Ersetzt GPT-6 GPT-5.6?
Nicht automatisch. OpenAI bietet GPT-5.6 weiterhin an. Ein sinnvoller Aufbau verwendet es für Routine und GPT-6 für besonders schwierige Fälle.
Welches Modell eignet sich besser fürs Coding?
OpenAI meldet höhere Astra-Werte bei Terminal-Bench 4.0 und weiteren Coding-Tests, besonders bei internen Datenbankmigrationen. Prüfen Sie beide mit eigenen Repositories, Regeln und CI-Kriterien.
Welches eignet sich für lange Dokumente?
Astra bietet 1,05 Millionen Kontexttokens und laut OpenAI bessere Suche in langem Kontext. Das ersetzt weder Dokumentauswahl, Quellenangaben, Konfliktbehandlung noch menschliche Prüfung.
Können die Prompts bei der Migration gleich bleiben?
Beginnen Sie mit demselben Aufgabenvertrag für eine faire Basis. Passen Sie erst nach einer Fehleranalyse an. Der GPT-6-API-Leitfaden enthält eine Migrationscheckliste.
