选一个撑得住整条视频的触发音
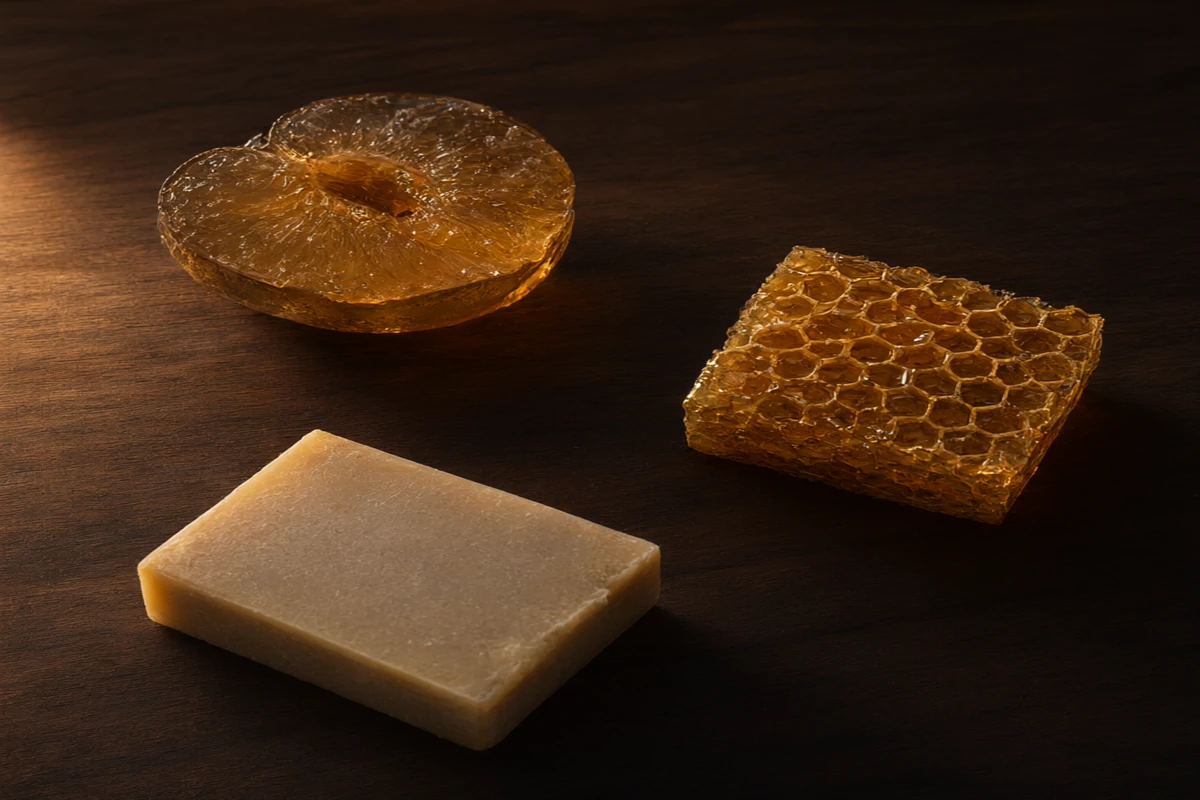
玻璃果子、蜂巢键盘、香皂、床单、倒出的奶昔:每个触发音都是一个物体、一个动作、一个声音,三者对上才成立。玻璃果子要刀刃和脆响,蜂巢要慢压,床要布料和手。一条只放一个触发音。这一条对了,再用 AI Reel 生成器裁成信息流要的竖版。
写清物体、动作和声音:切开玻璃质感的果子、按下蜂巢键盘、切开一块皂。Ottermind 会写好提示词,在模型支持时连同声音一起生成,并为下一条保留布景。


声音才是产品。观众在头一秒半就判断这一刀像不像真的在切,画面再美、脆响却是通用的,也会被划走。把物体、工具、麦克风距离和室内底噪一起写进去,然后一次生成画面和声音。如果画面优先,可以先用 AI 图片生成器把画面定下来。
玻璃果子、蜂巢键盘、香皂、床单、倒出的奶昔:每个触发音都是一个物体、一个动作、一个声音,三者对上才成立。玻璃果子要刀刃和脆响,蜂巢要慢压,床要布料和手。一条只放一个触发音。这一条对了,再用 AI Reel 生成器裁成信息流要的竖版。
AI ASMR 最常见的失败是:刀切得完美,底下没有声音;或者脆响晚了半秒。用能输出原生音频的视频模型生成,在提示词里写清材质和麦克风距离,再用小音量耳机确认。需要在动作上叠一层人声时,AI 口型同步工具会把脸和声音加到同一条片子上。
一个系列需要同一块板、同一把刀、同一盏灯,否则第二条就像另一个频道。把画面参考和管用的提示词留在任务里,下一条就从同一套布景开始。声音对了但长度不对时,用 AI 视频编辑裁好循环。
第 01 步
一个物体、一个动作、一个声音。写清材质(玻璃、蜂巢、皂、布)、接触它的工具、刀落在哪里。含糊的「治愈 ASMR」不会给模型任何可以动的东西。
第 02 步
写清脆响、按压声或倾倒声,写麦克风距离和房间。要求同一次生成里带原生音频,并把音乐拿掉:ASMR 里触发音就是配乐,其他声音都在抢戏。
第 03 步
用小音量耳机判断,手机扬声器会把让片子成立的那一层吃掉。把参考和提示词留下,下一条才是系列,而不是又一次试验。
提示词点名物体、工具和声音,刀口和脆响才会一起落下,而不是各走各的。
支持原生音频的视频模型会把画面和声音一起给出,而不是先给一条无声片、再去音效库里找。
画布会跟着任务走,所以第二条还是那块板、那把刀、那盏灯。
按 9:16、六到十秒来写,正好是信息流里能干净循环的长度。
公开体验提供有限次免费轮次,够试一个触发音、听一次结果。
无声的一条是同一个工作区里的提示词修改。声音对了以后,用 AI 视频编辑收尾。
它把写好的提示词变成一条 ASMR 视频:触发音、画面,以及在支持的模型上一起生成的音频。你写物体和动作,模型出一条,你决定留还是改。它不是 ASMR 素材库,也不播放别人的录音。
物体清楚、声音清楚的:切玻璃果子、按蜂巢键盘、切香皂、翻床单、倒饮料。一条只放一个。八秒里塞两个会互相打架,观众听不出自己在听什么。
用这个页面不需要指定模型:你写清片子,Studio 用当下可用的视频模型生成。有些模型自带原生音频,比如 Kling 3.0,画面和声音会一起出来;如果是无声模型,你拿到画面,再补声音。
六到十秒,一个触发音,循环。更长的作品要每一拍换表面,因为同一个切法几秒后就不再被感知。要做长版本,把选中的这条在 AI 视频编辑里循环,而不是生成一条长片。
公开体验不用注册,可以免费使用有限的轮次,够生成一条并判断声音。我们不承诺无限免费,需要账号的选项仍在账号之后。如果还需要一层人声,AI 口型同步工具可以把声音加到人像上。
可以。把做出这条的参考图和提示词留在任务里,下一次生成就从同一块板、同一把刀、同一盏灯开始。这就是系列和一堆片子的区别。