
三条可以直接复制的 Sora 提示词
这类提示词已发布的范例都是同一个形状:一句话说清发生什么、在哪里、怎么打光、怎么拍。下面三条按这个形状分别写了一个运动镜头、一个单动作和一个双取景段落。
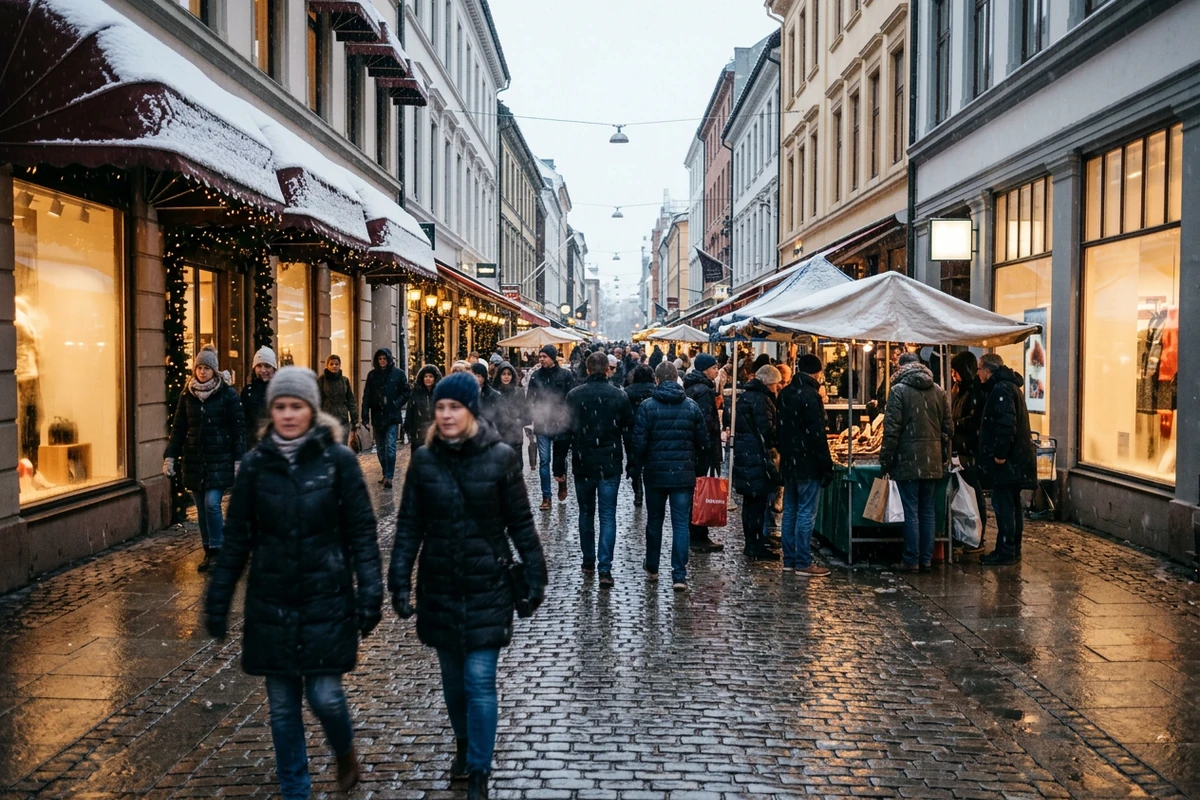
运动镜头
镜头向前推进,穿过一条下着小雪的繁忙商业街。几个穿冬衣的人从摊位旁慢慢走过,呼出的白气可见,雪积在遮阳篷和潮湿的鹅卵石路面上,店铺暖光透过起雾的玻璃亮着。阴天的傍晚光线,店面是唯一的暖色点缀。广角镜头,深焦,自然色彩,照片级写实,画面中不要出现可读文字或水印。
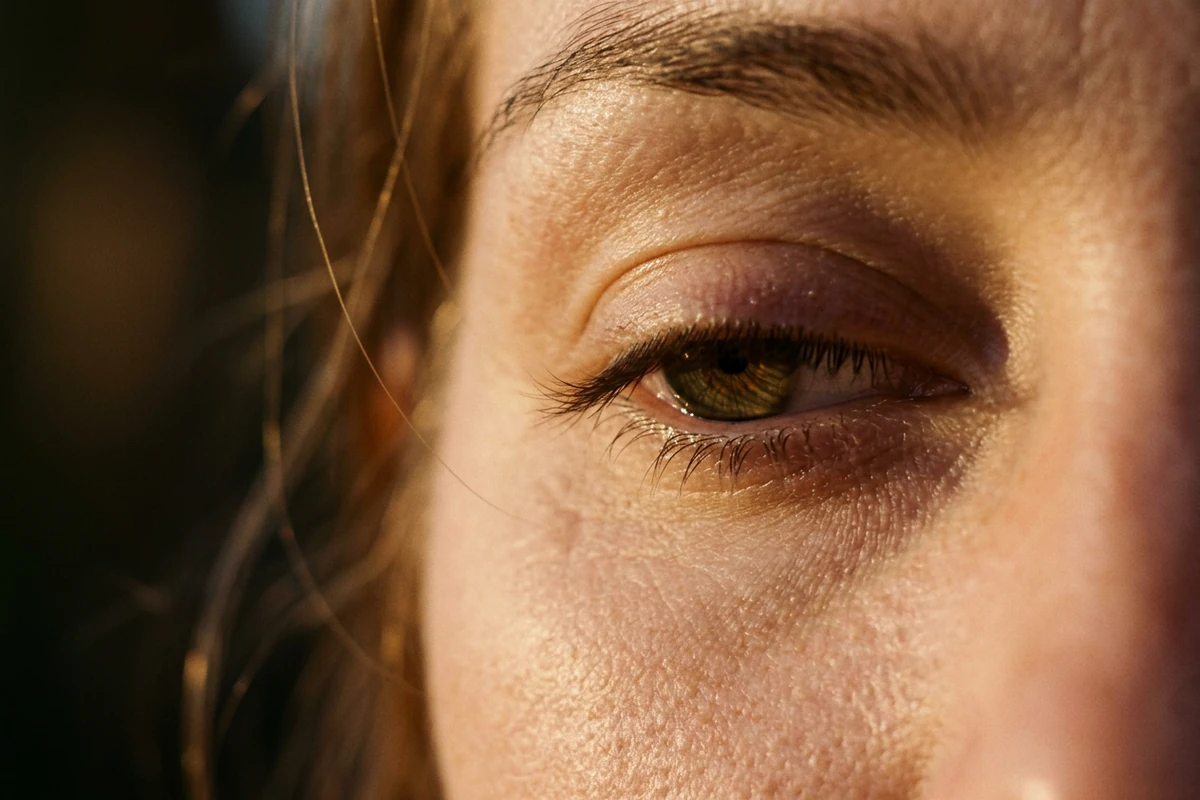
单一动作
一位女性眼睛眨到一半的极近特写,睫毛停在开合之间,侧面照来低而暖的黄昏阳光,虹膜里有一个小反光点,其余部分落进柔和阴影。微距镜头,极浅景深,真实皮肤质感。只做一个动作,就是这次眨眼,画面里没有其他运动。自然色彩,不要出现可读文字或水印。
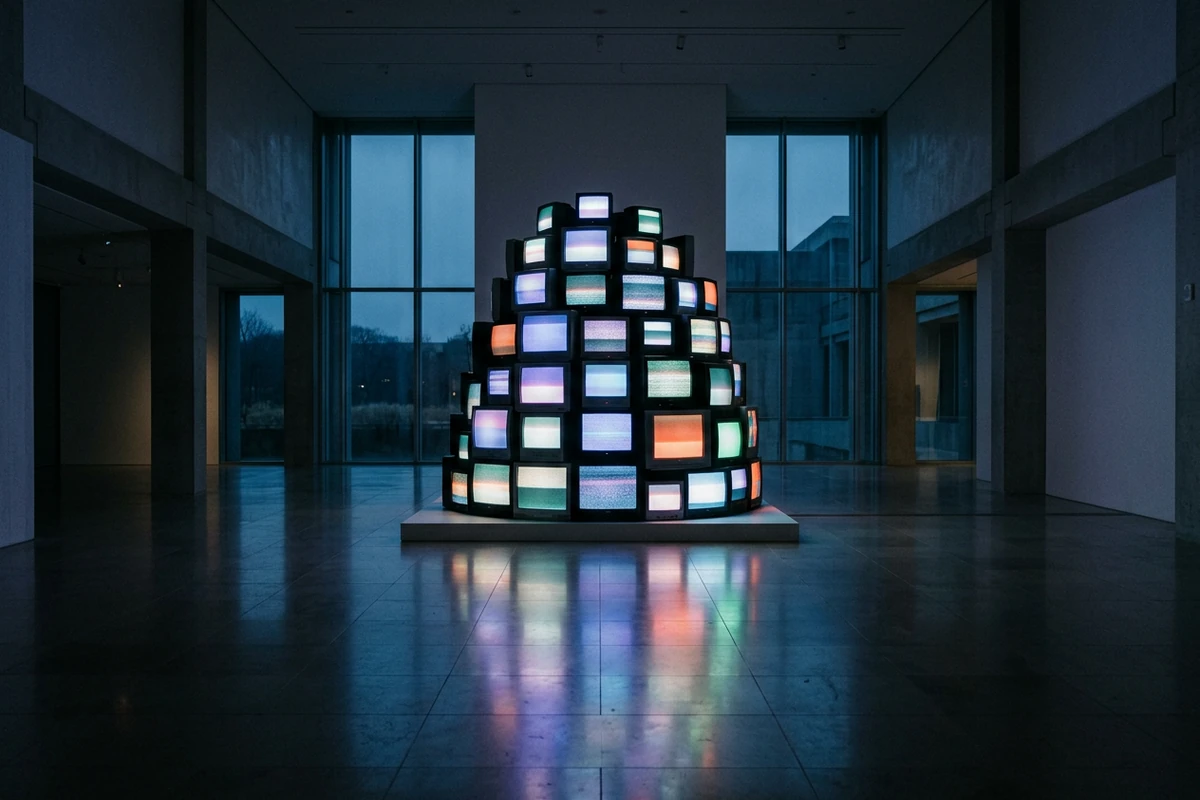
双取景段落
夜晚一座大型美术馆,房间中央的基座上堆着一摞高高的老式电视机,每块屏幕都亮着,但只显示抽象的色彩辉光和轻微雪花。镜头先以全景开场,再向那摞电视推近,两个取景保持同样的冷蓝环境光和同样的观感。抛光地面映出辉光,画面里没有人,屏幕上没有可读内容,也没有水印。
一句话,按主体到镜头的顺序来读
这个模型配用的提示词风格不是参数清单,而是一句描述性的话;出问题的地方,正是那些要求模型自述有困难的内容。
按主体、动作、地点、光线、镜头的顺序写
先主体,再发生什么,再在哪里,再怎么打光,最后怎么拍。已发布的范例都按这个顺序,而不是堆一串逗号分隔的风格词,顺序也让「该改哪一句」变得一目了然。AI 提示词生成器 能把碎片清单重排成这句话。
镜头只留一个平实运动
镜头指令是最常被误读的部分:有描述的运镜轨迹被指出是模型容易理解错的东西,所以一个清楚的运动——比如向前推进或环绕一圈——胜过一串方位。图片转视频 从一张已经定住这个运动的画面开始。
绕开公开报道的短板写
公开综述提到它在物理模拟和因果关系上较吃力,空间与事件细节也偏弱。所以动作只留一件事,把空间写实而不是暗示,也不要串联互相依赖的事件。免费 AI 照片转视频 可以低成本试这样一个镜头。
在 Ottermind 里怎么写一条 Sora 提示词
第 1 步:写成一句话
按顺序点明主体、那一个动作、地点、光线和镜头,然后停手。如果需要第二个动作,那其实是两个镜头。AI 提示词生成器 能撑住这个结构。
第 2 步:先把开场那一帧渲染出来
把镜头先当一张静帧生成,确认光线和镜头之后再花一次视频渲染。图片转视频 会把这张确认过的帧动起来,并保留你认可的观感。
第 3 步:只动一个运镜,然后对比几条
给短片一个运镜,其余措辞在各条之间保持不变,这样一条不理想的结果就能归因到某一句话。AI Reel 生成器 会把几条按顺序留好。
第二次提问在哪里划算
当一个镜头必须描述得足够清楚、让别人或另一个模型也能复现时,一句话的视频提示词才开始回本。
社交平台短片
一个清楚的动作放在一个清楚的空间里,是能扛住竖版短切片的形状,因为提示词里没有留给模型含糊处理的东西。写好那一句话,再让 AI Reel 生成器 把几条排好。
正式渲染前先做分镜
视频渲染是贵的那一步,所以先把镜头当静帧搭出来,确认光线和取景确实是你的意思。AI 视频演示生成器 是完整渲染前的那次快速过一遍。
要交接出去的镜头
当需求交给另一个人或另一个模型时,一条点名了光线和镜头的一句话提示词,对方不用问你想表达什么就能直接跑。免费 AI 照片转视频 会把这张静帧留作共同起点。
Sora 提示词常见问题
一条 Sora 提示词能描述多长的片段?
公开综述称视频大约可达一分钟,但一个清楚的动作放在一个清楚的空间里,比一分钟的事件长链更容易保持连贯。写你能用一句话说清的镜头。图片转视频 会把每一条锚定在你确认过的帧上。
为什么我的镜头指令被忽略了?
因为有描述的运镜轨迹被指出是模型容易读错的东西。把一串方位换成一个平实运动,比如向前推进,其余部分不要动,这样镜头那句话就是唯一的变量。AI 提示词生成器 只重写那一句。
这个模型哪里比较弱?
公开综述提到物理和因果关系较吃力,空间与事件细节也偏弱。把动作收敛成一件事,把空间写清楚,并避开后半段依赖前半段的提示词。免费 AI 照片转视频 可以低成本试出来。
提示词应该写一句还是几句?
一句话是已发布范例的惯例,也和镜头的读法对应:主体、动作、地点、光线、镜头。要写一段取景序列时可以用几句,模型能把它当作多个镜头并保持观感一致。AI 视频生成器 负责这些渲染。
可以免费先试一试吗?
Ottermind 的公开体验无需登录即可使用,并包含有限次数的免费轮次;账户额度和套餐限制仍可能适用。先把镜头当静帧试一次,这样一次轮次就能告诉你行不行,再去 AI 图像生成。
这一页是官方的吗?这些说法从哪来?
不是,本页与模型厂商无关联,也未获其背书,这里不复制任何厂商文档。工艺说明描述的是已发布范例库里共有的提示词形状,限制类说明则转述公开综述已经报道的内容。
你可能也喜欢的提示词主题
把这句话变成一个镜头
写下那一句话,渲染出帧,然后只动一个运镜,并且之后只改那一句,直到镜头读起来和你描述的一样。