
Absolute Cinema 梗图:先出画面,再加字幕
absolute cinema 梗图就是一张电影剧照加两个字。用提示词把自己的主角放进画面,把文字留给自己处理,并在发布前想清楚字幕落在哪里。
三段可以直接复制的 absolute cinema 提示词
每段提示词只负责画面:一个主角、一个果断的动作、一种向边缘暗下去的光,字幕才有干净的位置可落。
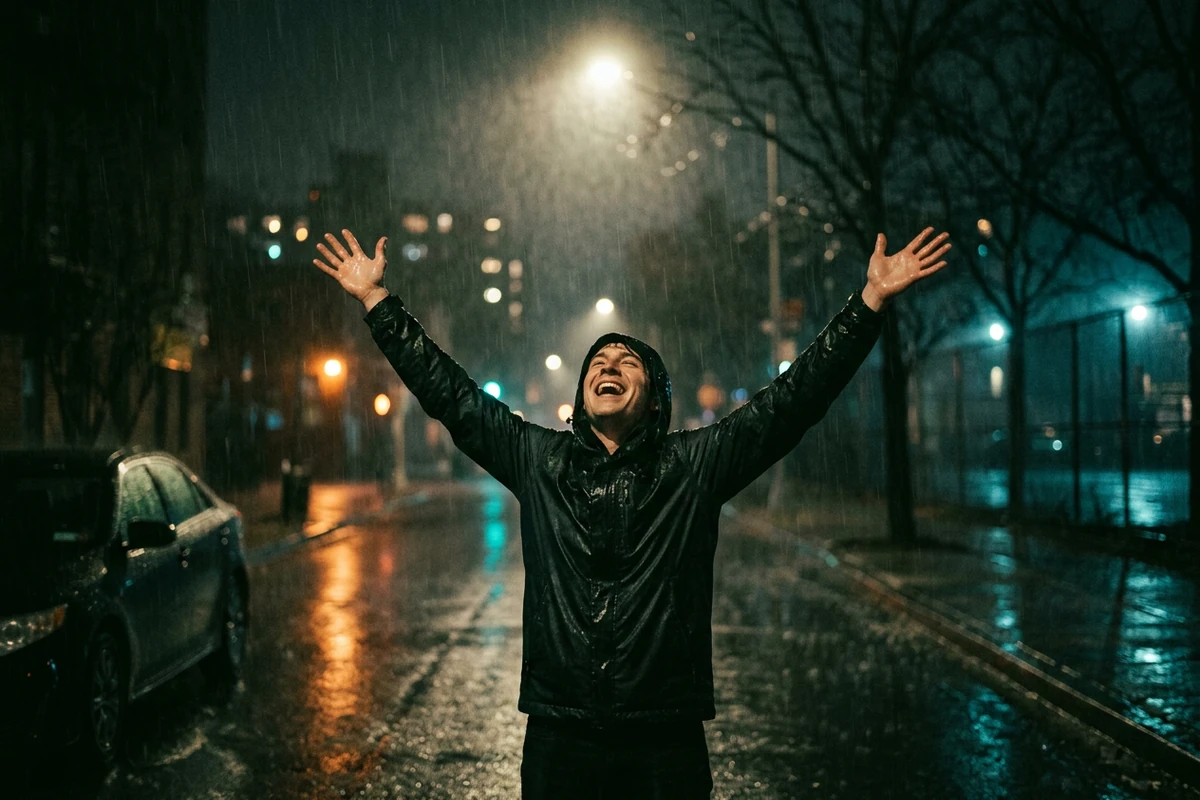
夸张的手势
一张原创电影剧照:一个人独自站在雨夜的街道上,双手高举过头,脸向后仰、眼睛闭着,正被捕捉在动作之中。头顶后方一盏硬调路灯勾出肩膀、双手和头发的轮廓,脸留在明暗之间,再往外全部落进黑雨、湿沥青和柔和的散景。用宽画幅变形镜头低角度拍摄、浅景深、仍保留细节的深黑、冷蓝阴影中仅一点暖光、细腻的胶片颗粒。画面里只有一个人,没有人群、没有文字、没有字母、没有数字、没有标志、没有水印、没有字幕。
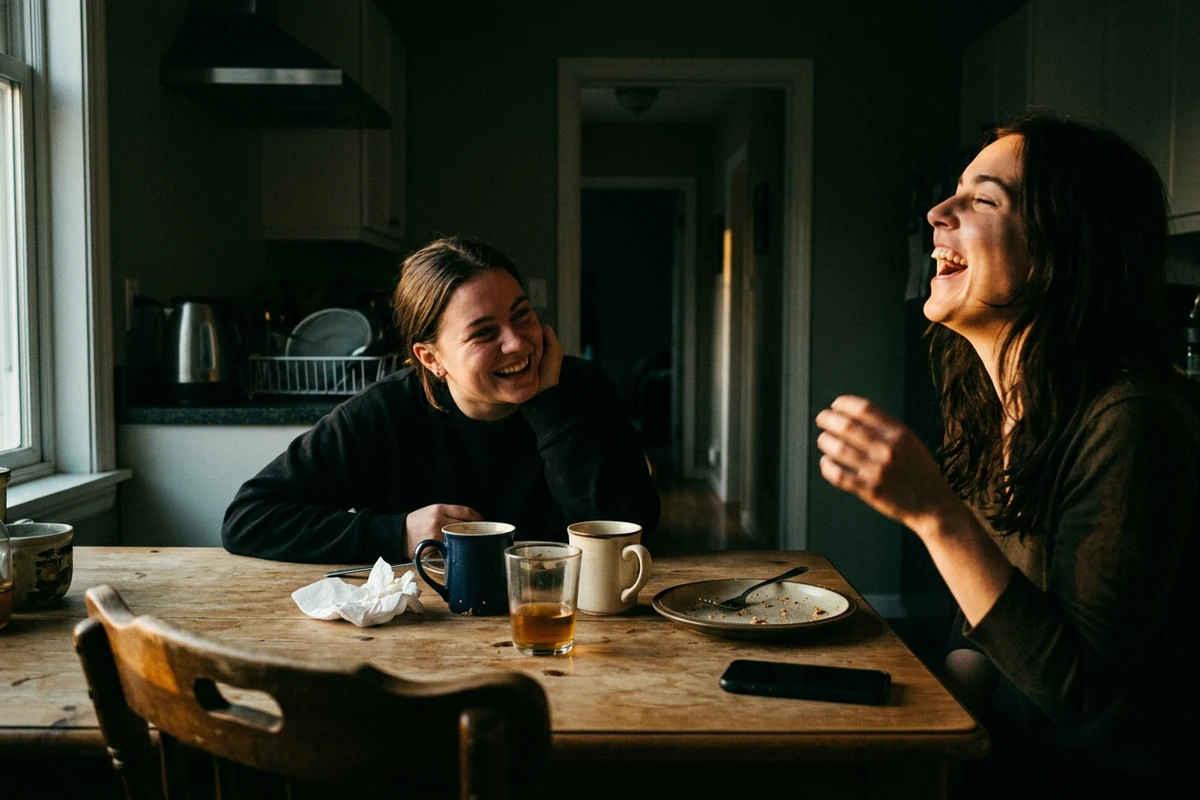
自己的照片改拍
把附上的生活照改成一张电影剧照,画面里的两个人、厨房餐桌、马克杯和构图全部保留。脸、姿势和聊天中笑出来的那一瞬间都留着,只改光线和色调。把室内平淡的光换成左侧来的硬调方向性窗光,让背景沉进深影,加上一点冷暖对比、亮部周围的柔和光晕和细腻的胶片颗粒。保持随手拍的感觉而不是棚拍肖像,所有五官都要看得出来。不要加入文字、字母、数字、标志、水印或字幕。
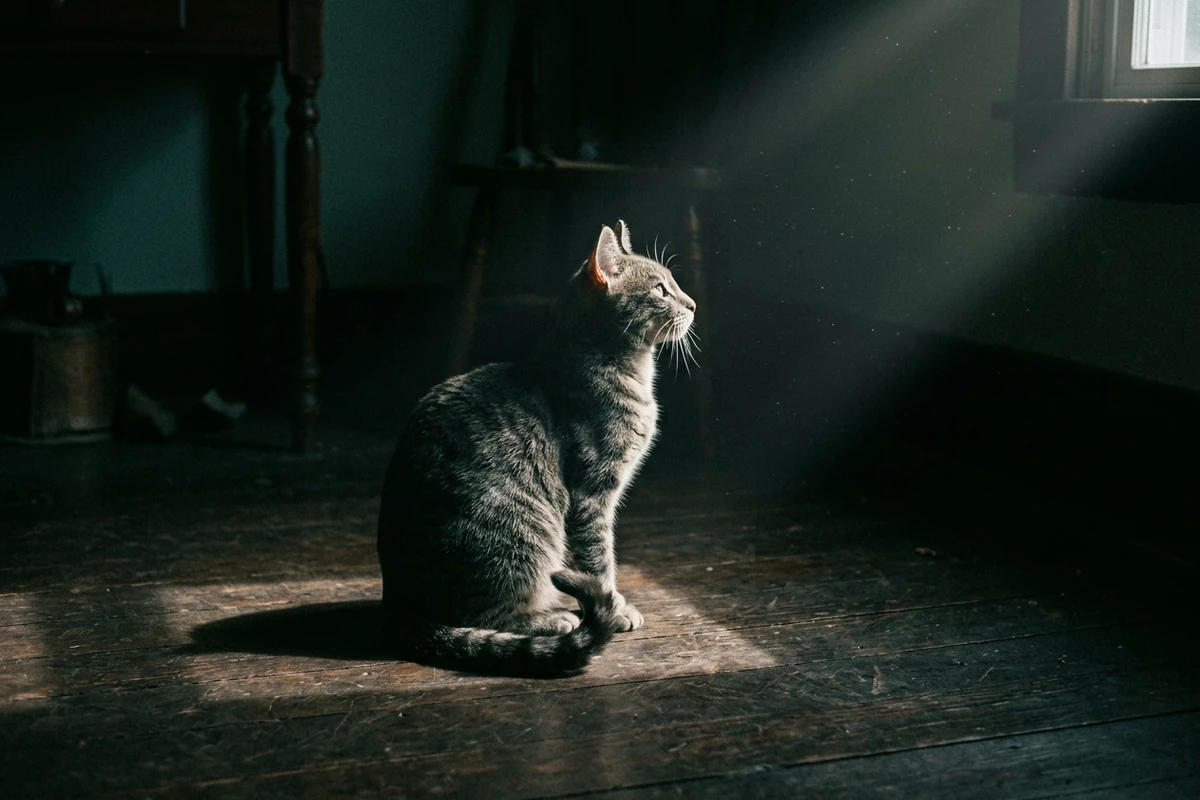
换上自己的主角
一张原创电影剧照:一只灰虎斑猫端正地坐在深色木地板上,处在从右侧射入的唯一一道硬调窗光里,头抬起转向光源,尾巴在身后高高卷起。房间其余部分近乎全黑,阴影里只隐约看得到门框,光束中能看到灰尘。镜头压低到猫的眼睛高度、浅景深、仍保留细节的深黑、琥珀与灰色调、细腻的胶片颗粒。画面里只有这只猫,任何位置都没有文字、字母、数字、标志、水印或字幕。
为什么大多数这个梗图的提示词都不成立
提示词通常抓对了外观,却漏掉了笑点。三个决定,分开「读起来像这个梗图的画面」和「一张暗图上面贴了字」。
让模型负责光,别让它负责文字
图片模型擅长光线,对文字并不可靠,所以字幕应该单独成层。提示词里要求没有文字的画面,两个字自己叠上去。如果确实想让模型写字,把字幕限制在画面上方一到两个大写单词并加上引号,同时预期要重跑——把你送回提示词框的通常是失败的字,而不是光线。
电影的那一半要完全认真地演
这个格式成立,是因为画面诚恳、主角普通。一个人、一个果断的动作、硬调的光、真实的场景,读起来就是电影;在画面里再加第二个笑点、换一套服装或者塞进一群人,落差就会碎成噪音。把已有的照片用 图片特效 改拍,主角原样保留,改变的是色调。
给字幕留一条干净的带状空间
两个字需要有地方落。构图时让画面上方保持暗且少细节——天花板、天空或者房间的暗角——并把明亮的部分集中在中央。方形和 4:5 的构图在信息流里更能撑住字幕;16:9 适合真正的剧照贴文。如果你只想要画面本身,当背景或反应素材用,让它可以复用的正是上方这条干净的带状空间。字幕需要被安排而不是靠猜时,用 AI 海报生成器 以海报的方式把整个画面做出来。
在 Ottermind 做出 absolute cinema 梗图
第 1 步:写画面,不写笑点
描述一张导演真的会拍的照片:谁在里面、手在做什么、唯一的光从哪里来、画面如何在边缘落进阴影。把字幕完全排除在提示词之外,把笑点留给之后加上的字。把描述贴进 图片转 AI 艺术生成器,先生成一张画面。
第 2 步:生成画面并检查动作
只用三件事判断第一张结果:主角是在动作中而不是摆姿势、光是否只从一个方向来、画面上方是否仍然暗而安静。一次只改一行再生成;整段重写会把已经成立的部分一起丢掉。当画面在没有任何文字的情况下读起来像剧照,最难的部分就完成了。
absolute cinema 画面什么时候真的有用
当一张图必须在没有说明段落的情况下回应某个瞬间,或者当整条帖子只靠一张图撑起来时,这个格式才值得做。
回应群聊里的一个瞬间
有人进球、把菜烧糊或者摔了盘子,你现在就要那张反应图。写好画面提示词、生成一次,把已经加好字幕的文件留着,下一次回复就不用从零开始。
用自己的主角取代原图
这个梗图最有名的那一版是一张特定的照片,而上面的人多半不是你。想换成自己的脸、朋友或者猫,就把已有的照片用 图片特效 改拍进同一个构图——这个格式需要的不是原始图片,而是它的打光逻辑。
需要电影感脸孔的帖子或封面
视频封面、歌单封面和短视频开场都要一张在小尺寸也能读懂的画面:一个主角、一道强光、没有别的东西抢注意力。同一段提示词在 16:9 是封面、在 4:5 是信息流帖子,字幕图层可以按平台替换。
absolute cinema 梗图常见问题
absolute cinema 是什么意思?
在影评里,这个说法指的是不靠台词、而用影像、动作和情绪讲故事的电影。到了网上,同一句话有两种用法:一种是真心的,用在你真的被打动的东西上;另一种是反讽的,用在完全没被打动的东西上。反讽就是笑点所在——把高级文化的语言套在普通或者荒诞的对象上,也常以「this is cinema」的形式流传。
absolute cinema 梗图是从哪来的?
那个画面是 Martin Scorsese 的照片,由 Philip Montgomery 为 2020 年 1 月 2 日刊出的《纽约时报》人物专访拍摄,照片里他双手举在头上、正处在动作之中。有人在那张照片上加了两个字,格式就这样传开了。你不需要那张照片:人们认得的是构图和光线,不是照片里的人。
为什么 AI 会把字幕写错?
图片模型是把字幕当成画面的一部分画出来,而不是真的排版,所以即使画面其他部分都对,较长或者少见的字仍然会出错。可靠的做法是先在提示词里生成没有文字的画面,再把字加上去。如果坚持让模型写,就把字幕缩到一到两个短的大写单词、在提示词里加上引号,并预期要重跑到干净为止。
没有文字的 absolute cinema 梗图怎么做?
生成完全没有文字的画面,然后就停在那里。干净的画面可以当反应素材、别人字幕的背景,或者 16:9 的剧照;上方那条暗而少细节的带状空间,正是它能被复用的原因。需要字幕时再用单独图层加上去,让同一张图同时满足两种用途。
absolute cinema 的字幕是什么字体?
这个格式背后没有单一的授权字体。字幕读起来是在暗部之上的粗体无衬线大写字母,Impact 是梗图字幕的常见默认,用来重做已经足够接近;真正让格式被认出来的是字重、全大写和白字压暗部的对比,而不是某个字体文件。对齐的是外观,不是文件。
可以用自己的照片或者自己的猫吗?
可以,而且这是有趣得多的版本。把自己已经拥有的照片改拍成同一种光——一道硬调主光,其余都是深影——并保留主角的五官特征,让结果仍然是那个人或者那只动物。宠物特别合适,因为戏剧性光线下的单一主角不需要解释,而这正是这个格式在玩的东西。
做 absolute cinema 梗图需要模板吗?
不需要。模板固定一张照片、让你在上面打字,所以成品看起来都差不多。写出来的提示词给的是画面本身,主角可以是任何人或者任何东西。当你想要的正好是原始构图时,模板仍然更快;如果想在同一个工作空间里同时处理画面和字幕,可以看看普通图片流程怎么运作:AI 图像生成。
可以把真人或者名人放进画面吗?
不能用生成相似长相的方式。原始梗图用的是一位真人的真实照片,而重现可辨认的公众人物,是和套用这个格式不同、风险也更高的工作。请用自己的主角,或者自己拍的、画面里有这些人的照片,并保留构图——这才会让梗图成为你的,而不是复制品。
其他你可能喜欢的提示词主题
把同一段提示词放进别的模型
把一个普通的瞬间变成剧照
挑一段画面提示词,换上自己的主角,在想字幕之前先把画面生成出来。画面对了,文字就是简单的部分。