AI Fruits:如何做出一个能撑过一条片子的水果角色
AI fruits 是长着面孔、有声音、有行动理由的水果角色。单支短片是生成问题,连续剧集是连贯性问题。先固定一张角色图,再为每支短片只写一个动作。
可选
JPG / PNG / WebP
这是 Ottermind 的输入框。简述和参考图都先留在草稿里,点圆形箭头才交给 Studio 审核。
2026年11月14日 · 约 13 分钟
AI fruits 就是有脸、有声音、还带着一点行动理由的水果角色,短片短到能在手机上刷完。 这个格式在大概十八个月里走过了水果 ASMR、加字幕的梗图、会说话的水果、连续剧式的水果剧情,现在你一搜,出来的全是带模板的生成器,就等着你去改。
今天你就能做出这样一条短片。做不出来的是第六条——让它看着跟第一条是同一个东西:同样的表皮、同样的籽、同一张脸、同一个世界。模板页不会写这部分,而这份指南就是围着它组织的。一条短片是生成问题,一集内容是连贯性问题。
这份指南是怎么准备的: 文中引用的页面在 2026 年 11 月 14 日核对过:Media.io 的 AI Fruit Story 专区页、Designkit 的 AI fruits 科普文(发布于 2026 年 8 月 13 日),以及 Ottermind 的 Image to Video、Photo to Video 和 AI Reel Maker 页面。趋势脉络按这些页面的描述转述,包括它们标注为来自 Know Your Meme 的日期;竞品引用的播放量属于营销说法,这里不作为事实重复。这是一篇流程指南,不是速度或质量评测。本文没有生成任何视频,所以没有哪条片段被当成成品展示。封面和三张配图是为本文用 Image 2.5 系列模型(GPT Image 2.5)生成的,标注为概念图;合成器截图是这一页的真实截屏。
大家实际在做什么
这个趋势走了一年半,沉淀出几种格式。可一旦你打算连发不止一条,它们的行为就完全不同了。讲时间线时被引用最多的那篇趋势文章,把它分成五个互相重叠的阶段:2025 年的水果 ASMR,2025 年 7 月前后开始的有脸水果吃同类,同年 8 月加字幕的水果梗图,2025–26 年贯穿的会说话的水果,以及 2026 年的连续剧式水果剧情。同一篇还写到,2026 年 3 月,一档全部由 AI 水果出演的相亲秀恶搞在 TikTok 上火了——从那一刻起,这个格式不再是一个笑话,而是一档节目。
这段历史有一个很实际的意义:你越往后走,每条短片就越依赖上一条。一颗自己吃自己的草莓,是个十五秒的点子。一个有持续人设的水果,是一份带演员表、带造型、带档案的制作活儿。
| 格式 | 画面里发生什么 | 撑起这条短片的是什么 | 重复一次的成本 |
|---|---|---|---|
| 水果吃自己 | 喂一颗水果吃它同类的一块,它咬下去、有反应 | 那一口、那声脆响、那种不对劲的反差 | 低——换颗水果就是新的一条 |
| 婴儿脸水果 | 圆润的五官、超大的眼睛、一个夸张反应 | 可爱撞上一点隐隐不对 | 低,直到你想要同一张婴儿脸第二次 |
| 会说话的水果 | 角色对着镜头说一句台词或一个笑话 | 节奏,和清晰的嘴部动作 | 中——声音和脸必须对得上 |
| 水果 ASMR | 切、削、挤,靠声音撑住整条 | 表面质感和干净的音效 | 低,但受众窄 |
| 短水果故事 | 一两个角色走到一个包袱或一个决定 | 在片内就解决的冲突 | 中——第二个角色需要单独设计 |
| 连续剧式水果剧情 | 固定演员表、分集、悬而未决的张力 | 造型、人设和世界观的连贯 | 高——大多数尝试都倒在这里 |
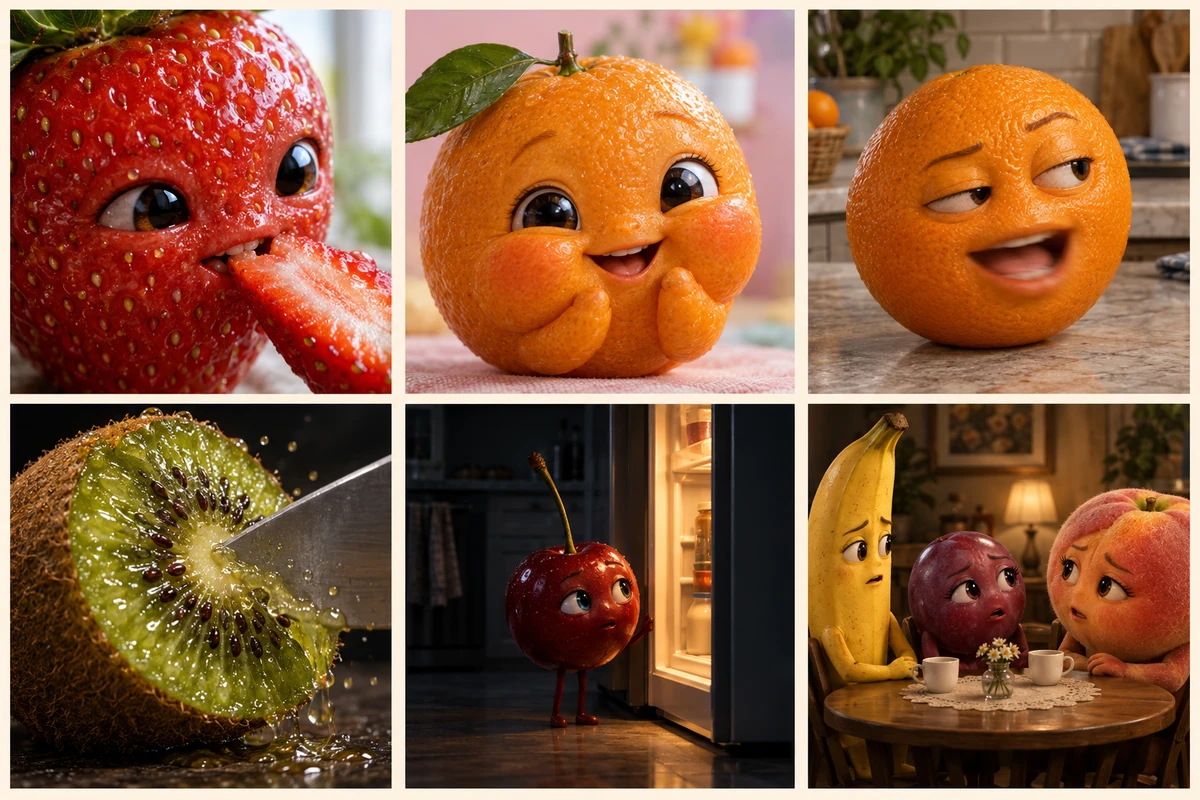
六种格式,一帧看完:咬、婴儿脸、对镜头说话、ASMR 切片、单条故事的一个节拍,以及围桌而坐的固定班底。配图是用 Image 2.5 系列模型为本文生成的概念图;不是截图,不是已发布案例,也不是推荐输出。
右栏值得读两遍。生成器页面会很乐意卖你左栏,因为一个能出一条搞笑短片的模板就是个完整产品。但如果你打算做系列,你买的是最后一行,而最后一行取决于你在两次会话之间留下了什么,而不是你挑了哪个模型。
为什么第六条看着像换了颗水果
每次生成都从你给的那张图或那段话开始。只给一段文字,它每次都重新发明这颗草莓:新的籽密度、新的叶子角度、新的眼睛位置,还有一张悄悄变宽或变小的嘴。单看哪一处差别都不大。叠上五条,演员表已经换人了。
解决办法不是换个更好的模型,而是给模型一个能回去对照的参考,外加一段写清楚哪些部分不许动的指令。Designkit 的指南在建议固定角色用图生视频而不是文生视频时,说得很直白:参考图能提升连贯性,但不保证它一定连贯。这句话就是那条诚实的边界,值得围着它设计,而不是跟它较劲。
三个习惯承担了大部分工作:
- 一张静帧,多条短片。 角色图只生成一次,检查过,然后在整轮制作里把那个文件当视觉参考反复用。
- 一条短片只做一个动作。 一条提示词里写两个动作,就是给了脸两次漂移的机会,因为模型得同时把两件事处理完。
- 一段写死的身份描述。 一小段贴进每条运动提示词的文字,点名哪些东西不能变:红晕、籽的排列、叶冠、眼距、嘴的宽度。
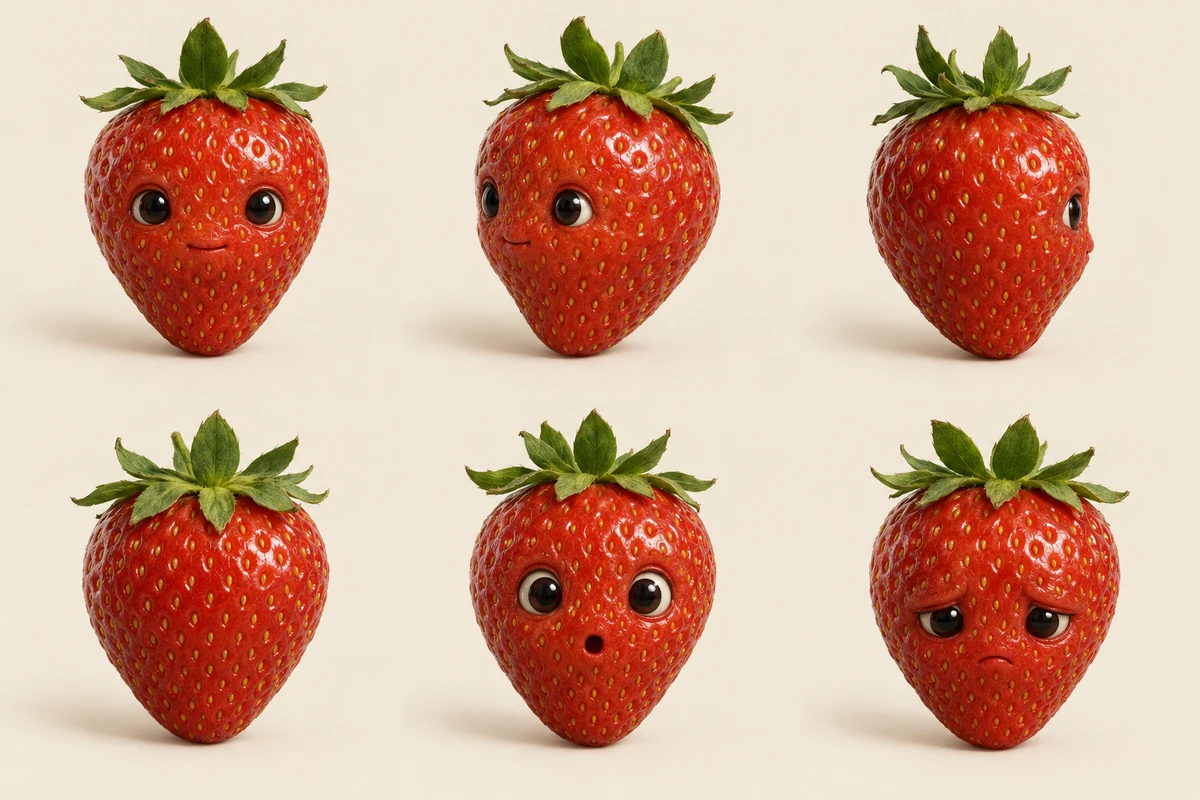
转面图不是美术指导,是一个你要留住的文件。同一颗草莓角色的六个视角,同一个米色底,同一个距离。这里任何一张都能当短片的参考。概念图是为本文生成的,不是 Ottermind 的输出。
九步做完一条
下面的顺序是故意的。提示词写在角色前面,因为你该先搞清楚这个点子好不好笑,再决定要不要投入一个演员表。第二步之后的所有步骤,都是为了保护你在第二步做出来的那个角色。
第 1 步:写一条短片,不是写一季
从一条你真的会发的竖屏短片开始。写清主体、那一个动作、机位、光线和结尾。如果你没法用一句话说清结尾,那它还没有结尾。
这条控制什么: 动作、镜头的运动方式、模型要处理的改变量,以及这条短片能不能自己收住。
生成一条 8 秒竖屏短片。一颗有光泽的红草莓,表皮上嵌着两只小小的深色眼睛,一张小小的闭合的嘴,放在温暖的木质台面上。一只手把一把银色勺子推过来,勺子上有一片草莓。草莓凑过去,咬一小口,咀嚼两次,眼睛因惊讶而睁大。固定机位、平视特写,不推不拉,不切镜。柔和的晨光从左侧照来。保持形状、籽的排列和叶冠不变。画面不出现文字,不出现 logo。这段提示词会填进本页顶部的合成器。填进去不等于发出去:文字和任何附上的参考都停在草稿状态,直到你点那个圆形箭头。如果你已经有角色静帧,发之前先附上;参考图是引导生成,而不是把结果锁成一份精确的复制品。
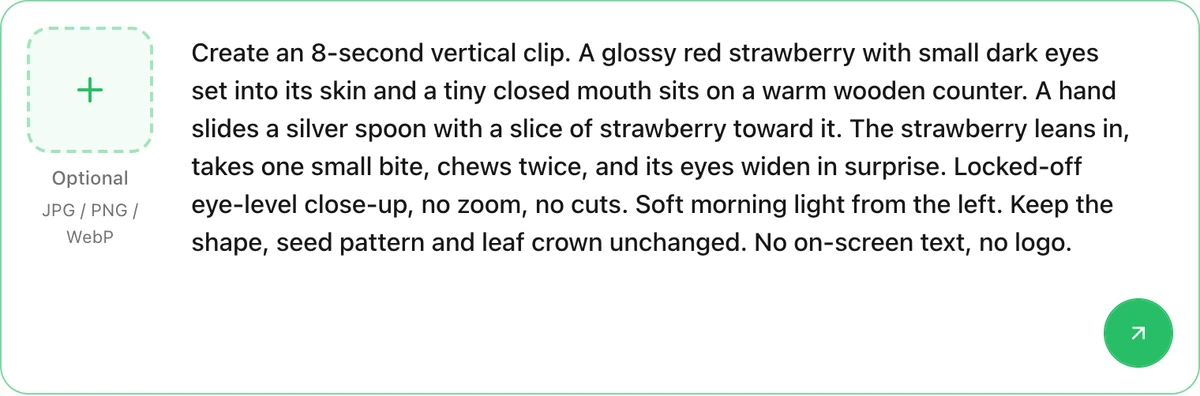
用过这段提示词之后的合成器:参考图位是可选的,文字还停在草稿,点箭头就把请求交给 Studio。这是本页的真实截屏,展示的是请求的准备过程,不是生成出来的片段。
第 2 步:生成角色静帧,然后停手
点子跑通了,再认真设计角色,然后把它冻住。要一张中性姿势、纯色背景、脸完全露出来的图,然后把文件留下。后面每条短片都靠这个素材。
这条控制什么: 表皮质感、脸的构造、光的来向、机位距离——后面每条短片都会继承这些。
一张草莓角色的写实静帧,单一主体,居中,暖米色纸面背景。脸是长进表皮里的:两只小小的深色眼睛微微陷进表面,一张小小的闭合的嘴,没有描边,没有卡通式着色,没有贴纸边。整个果身可见均匀的籽的排列,自然的油亮感和几滴水珠,一顶绿色的叶冠立着。柔和的窗光从左侧照来,右侧有淡淡的影子,50mm 镜头平视拍摄,浅景深。角色大约占画面高度的六成。不要文字,不要道具,不要手,不要第二件物体。第 3 步:把角色写成一段身份描述
文字比反复生成便宜。打开静帧,列出陌生人一眼就会注意到的五个细节,写成一段,之后每条运动提示词都接在后面。清单只留那些一旦变了、观众就会察觉的东西。
这条控制什么: 那些固定细节,以及当运动指令和它们冲突时,模型遵循的优先级。
角色必须与参考图完全一致:同样的果形,宽肩、尖头;同样的籽,成整齐的行列排列;同样的绿色叶冠,立着,共五片叶;同样的两只小深色眼睛,微微陷进表皮,间距一个眼宽;同样的窄小闭合的嘴。不要加牙齿、眉毛、头发或衣服。不要改变表皮的油亮感和光的来向。如果动作在不改变脸的前提下做不完,就保住脸,简化动作。最后那句才是有用的那句。它给了模型一条出路——保住你的角色,而不是靠把主体重新设计一遍来完成任务。
第 4 步:一条短片一个动作,分三拍
一条看得懂的短片有预备、动作和反应。三拍塞得进一条竖屏短片,五拍塞不进。把每一拍写成单独的句子,弱的那一拍就好删。
这条控制什么: 节奏、模型要同时处理的事情数量,以及这条短片看起来是一个瞬间还是一份摘要。
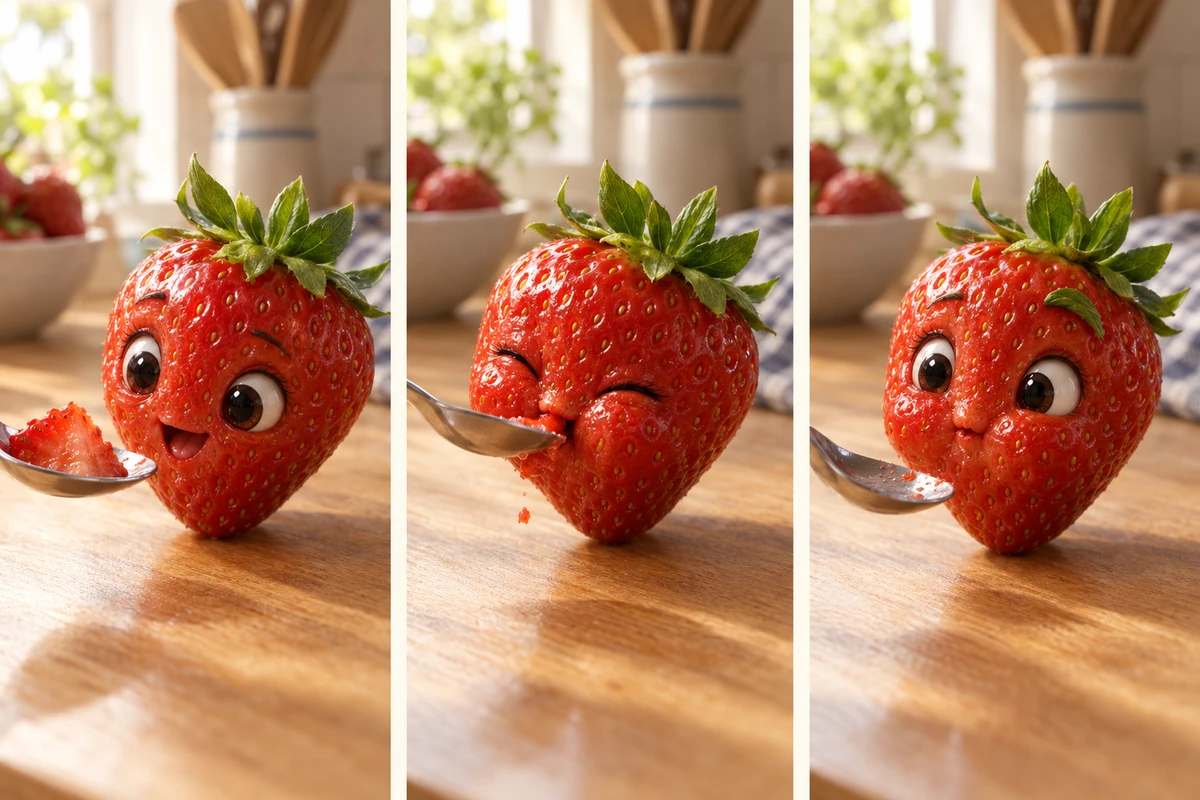
第一拍、第二拍、第三拍——同一个角色,同一个台面,同一支镜头。写成三句,这是一条提示词;写成一句,这是三条互相抢的指令。概念图是为本文生成的。
第 1 拍,预备:草莓朝勺子倾过去,眼睛睁大,嘴微微张开。第 2 拍,动作:它咬一小口,眼睛紧紧闭上,掉下一粒碎屑。第 3 拍,反应:它咀嚼两次,把眼睛睁得很大,一片叶子像被惊到一样翘起。连续镜头,三拍之间不切,每拍约两秒。保持果形、籽的排列和叶冠不变。台面边缘在画面里的位置全程不动。第 5 步:给短片一个能落剪的结尾
大多数生成出来的短片会慢慢散掉,因为提示词里从没说过最后一帧该是什么。把最后那个画面写出来。它也是你拿去做封面的那一帧;而在系列里,它是下一条接上的起点。
这条控制什么: 最后一帧、剪辑点,以及交到下一集的接口。
草莓嚼完,咽下,直视镜头,眨一次眼。在这个眼神上停一秒,然后短片结束。到最后一秒,勺子已经出画。保持与参考图相同的表皮、籽的排列、眼睛和叶冠,机位和光线与第一拍保持一致。第 6 步:水果要说话,先写台词,再写嘴
会说话的水果有一种特定的坏法:嘴动得像木偶,因为压根没有台词和节奏可跟。先把那句话写出来,再描述嘴怎么走完它。台词要短到在你有的时间里念得完。
这条控制什么: 台词长度、嘴的行为,以及这段表演听起来是说话还是一段动作。
草莓看向镜头偏左一点,说一句短台词:「你带了一块我来野餐。」嘴部动作:开始时闭着,说到「带了」时张开一次,逗号处闭上,说到「野餐」时再张开,然后收成一个小小的闭唇微笑。结尾加一片抬起的叶子当标点。画面里不烧字幕。脸、眼睛和表皮质感与参考图完全一致。十来个字,两次嘴部动作,结尾一次表情变化。这就是一条你能审的镜头。同样的八秒里塞一整段台词,就是一条你注定得重做的镜头。
第 7 步:用同一张静帧做第二集
第二条短片是分水岭:系列要么从这里立住,要么悄悄重开。复用参考图,开场那一帧承接上一条的结尾,只改一个变量:一个新道具、一个新角色、一个新房间。同时改两样,观众会读成另一档节目。
这条控制什么: 角色和世界的连贯,以及你要求观众接受的陌生度有多少。
沿用同一颗草莓角色,做第二条 8 秒短片。开场是空勺子搁在同一个木质台面上,草莓的位置与上一条最后一个画面相同。一个小小的蓝莓角色从右侧慢慢滚进画面,停在它旁边。草莓只转眼球、不转身体,低头看它,然后把目光收回来平视镜头,一脸平淡。机位和光线不变。草莓的脸、籽的排列和叶冠与参考图完全一致。蓝莓是圆的,深蓝色带一层白霜,两只小眼睛,没有嘴。第 8 步:文案和 AI 声明,一次写完
文案是格式的一部分,不是事后补的:笑话在那里收口,也是在那里告诉观众他们看的是什么。在文本助手或 Studio 里做这件事,声明写成一句大白话,别写成一整段术语。
这条控制什么: 跟着短片一起发出去的文字、你在邀请的回复,以及在任何人都没开口之前合成媒体标注是否已经到位。
为一条竖屏短片写三个文案选项:一颗草莓角色咬了一口草莓,露出惊讶的表情。每个选项不超过 90 个字符,前两个不带话题标签,第三个必须以一个能引来回复的问句结尾。然后写一句大白话,不超过 100 个字符,说明这条短片是 AI 生成的,不用术语,也不道歉。第 9 步:对着静帧审,别对着记忆审
把新短片和角色静帧摆在一起,按这个顺序看四件事:脸、表皮、光、结尾。然后再看你打算当封面的那一帧——往往是片子里最丑的一帧。如果脸漂了,就用同一张参考图重新生成,而不是改提示词改到「看着差不多」为止。
常见翻车,和真正管用的修法
| 症状 | 通常是什么造成的 | 修法 |
|---|---|---|
| 脸在两条短片之间变形 | 从文字重新生成,没附静帧 | 附上同一张静帧,重复那段身份描述 |
| 水果像贴在照片上的贴纸 | 用了 "cute cartoon" 或 "kawaii" 这类词,或者把脸描述成覆盖层 | 要求脸长进表皮里、写实质感、无描边、无贴纸边 |
| 八秒里什么都没发生 | 一条提示词塞三个动作,每个都只做了一半 | 砍到一个动作,分三拍,重新生成 |
| 短片没有结尾 | 提示词从没点名最后一帧 | 写出最后那个画面,并停一秒 |
| 手融化,或者勺子弯了 | 快速运动、手、反光道具三样凑一起 | 去掉手,让道具不动,或者缩短动作 |
| 声音和嘴对不上 | 台词从没写,模型自己编了动作 | 先写台词,再描述嘴的开头、中间和结尾 |
| 每条都像同一个爆款视频 | 你是从模板起步,不是从角色起步 | 换一个结构性变量:物种、尺度,或者它所在的世界 |
| 声音像后期硬贴上去的 | 短片是静音生成的,音乐是后面加的 | 声音和动作一起规划:咬、嚼、咽,然后在台词前留白 |
| 平台限流或给内容打标 | 合成媒体声明缺失,或者被埋了 | 把声明放在文案前几行,并遵守平台当前规则 |
其中两条比别的更值钱。贴纸问题是个措辞问题,一行提示词就能修。没有结尾是个规划问题,在打开工具之前就该修好。
在整条流程里,Ottermind 放在哪个位置
第 2 步到第 7 步放在 Ottermind 里跑是合理的,因为这个流程把参考和文字指令放在一起,而不是每改一次就让你从一个空提示词重来。
- 做静帧:AI 图像生成 产出你后面要反复用的角色图。生成两三个候选,挑一个,留住。
- 让静帧动起来:Image to Video 接收一张参考图,加上对运动、镜头行为、节奏和目标帧的描述,然后让你逐条看、逐条重渲。要做系列就走这条路,因为静帧才是那个不动的锚点。
- 改成从照片起步: 如果你自己拍了真实的水果,Photo to Video 从那张照片开始,而不是从生成的角色开始。动效提示词一样,素材来源不同。
- 把一集拼起来:AI Reel Maker 是通往多场景社媒序列的出口——三条短片一旦能接住彼此,就变成了这样一条序列。
这条路不保证任何事。参考图能提升连贯性,但锁不死它——有些条该重新生成就重新生成。片长、分辨率,以及任何积分消耗,都取决于你的账号,和你生成当下在 Studio 里选的模型,不取决于这篇文章。权利要你自己核:用手拍的、或者你有授权的照片,别围着别人的节目造角色,目的地要求标注合成媒体就标。以上都不构成法律意见,也都不构成对流量承诺。
接下来做什么
在格式表里挑一行,对应你本周真能做完的那条短片,然后做出它最小、最诚实的版本。
- 想做系列: 先做静帧,然后守住一条短片一个动作。看Image to Video 提示词,把运动词汇写具体。
- 想练短视频的制作纪律: 不出镜短视频指南 从另一头讲同一个问题——怎么在没有出镜主播的情况下做出可重复的短视频。
- 想要两条短片之间的转场: morphing 是把一样东西变成另一样东西的格式,而一集的断点常常正需要这个。
- 想要在小屏上还认得出的角色风格: chibi 风格 是在脸必须在小图上读得清时,对写实风的有用对冲。
- 想要逐帧控制: tweening 讲的是两张图之间发生了什么,而那正是水果角色开始不像自己的时刻。
AI 水果短片是一份带脸的草稿。脸是你的那部分,也是值得守住的那部分。
AI fruits 常见问题
我需要一个专门做水果的生成器吗?
不需要。专门的 AI fruit 生成器省事,因为它内置的模板就是已经跑通的格式,用它是有正当理由的。但如果你想要自己的角色、想要跨短片的统一观感,或者想要一个不像模板变体的系列,通用的图像加视频流程是更好的选择。
文生视频还是图生视频?
一次性的短片、角色每次都可以不一样,就用文生视频。只要有一张脸、一种质感或一件配饰需要跨短片延续,就用图生视频。参考图会缩小结果的范围,但不锁死结果。
一条 AI 水果短片该多长?
短到一个动作就能填满。这个格式通常被说成十到三十秒,而真正的限制不是平台上限,是观众在短片该结束之前能跟住几拍。
我必须说明视频是 AI 生成的吗?
规则因平台、市场和题材而异,所以去看目的地当前的规则,别依赖一份摘要。实操上,文案里一句大白话不花什么成本,却省掉了观众不信任这条内容的一个明摆着的理由。
这些短片能卖或者变现吗?
这取决于工具的条款、你用的素材,和你发布的平台。在拿一个角色去做生意之前,先读模型和平台的商用条款,也不要以为生成了一张图,你就拥有了别人拥有的可识别角色的权利。
