提示词指南
形变:从 A 到 B,怎么让这次转换站得住
形变,是一个主体在同一个连续画面里变成另一个主体。从一帧开始,描述这次变化走的路径,再检查那几帧——它们决定观众读到的是转化,还是失误。
可选
JPG / PNG / WebP
这是 Ottermind 的输入框。先附上起始帧,再发送需求——填文字和发送是两个动作,在你到 Studio 里继续之前,什么都不会生成。
2026年11月12日 · 阅读约 12 分钟
形变,是一个主体在同一个连续镜头里变成另一个主体。 马克杯的把手折成一只翅膀,釉面变成折好的纸,影子留在原地,镜头一次都没眨。它不是两张图之间的淡入淡出:画面始终是同一个画面,变的是画面里的东西。
这条唯一的条件,就决定了什么时候该用它。当变化本身就是信息,形变才配得上这些帧——一种材料变成另一种材料、产品变成它的包装、一张脸老去、一段演示里「之前」不靠剪切直接变成「之后」。反过来,两个状态本来无关、读者需要并排比较,或者两张图是在不同光线下拍的,那你要的是硬切、分屏或叠化:因为形变会替你补出中间那一段,而它坏就坏在补出来的那段上。
这篇指南是怎么准备的: 官方页面均读取于 2026年11月12日:Dreamina 的变形动画资源页(发布于 2026年10月24日),其中写明了首帧加尾帧的工作流、时长设置和五个示例类别;以及 Ottermind 自己的 Image to Video 和 Image Effects 页面,它们的步骤是选一张参考图、描述运动、查看结果再重新生成。这里的帧数是按帧率算出来的,不是实测的渲染耗时。每一张图都有交代:那条序列是两张剪影之间的计算插值,时间轴和锚点图是按正文里的数字等比例画的示意图,封面是用同一批样帧排的版,输入框那张是本页的真实截图,需求已经填在里面。本文没有在 Ottermind 里提交任何生成,所以这里没有保证的产出,也没有一张图是产品渲染的结果。
什么算形变,什么只是看着像
两个操作同时发生,而它们就是你手上仅有的两个抓手。几何变形挪动几何:起始帧里的各个部分,走到它们在结束帧里的位置。融合改表面:颜色、质感、光泽和边缘的软硬在这里换手。几何那一步做对、融合做短,读起来就是一个物体在转化。融合做错——太长、太早——你得到的是两个物体叠在一起,那是一次穿着形变外衣的叠化。
好用的测试是暂停。把片段停在中间。数得出一件物体,是形变。数得出两件,哪怕只是隐约两件,就是交叉叠化,提示词写多长都盖不住。
| 人们常说的形变 | 它实际做的事 | 为什么不是形变 | 该用什么 |
|---|---|---|---|
| 硬切或划像 | 在一帧之内把 A 换成 B,或者把一条边界推过去 | 没有任何东西在移动,几何从没动过 | 两个状态无关时,用硬切 |
| 交叉叠化 | A 淡出的同时 B 淡入 | 两个物体同时出现在画面上 | 变化是换场时,用叠化 |
| 风格迁移或滤镜 | 保留几何,只改表面 | 只做了形变的一半:有融合,没有几何 | 形状该留着时,用图像特效 |
| 变速或旋转 | 同一个物体动得更快 | 身份从没变过 | 写在视频提示词里的镜头或运动方向 |
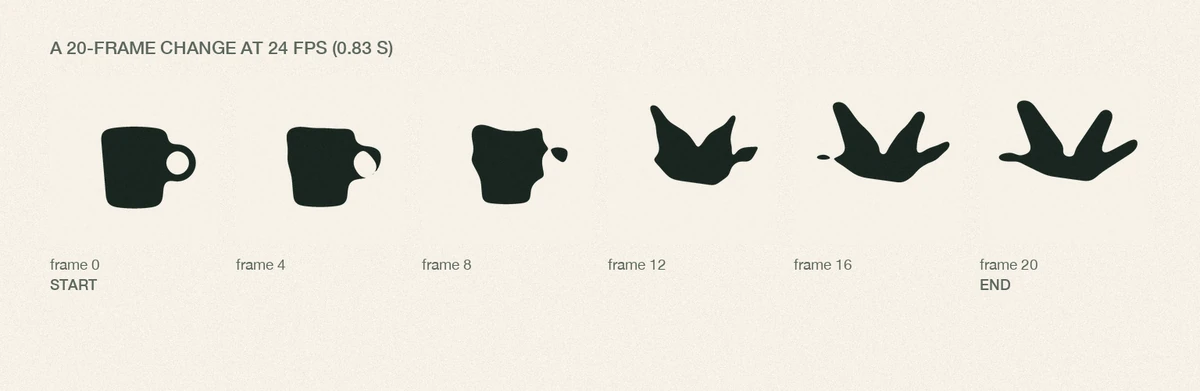
24 fps 下 20 帧的变化,每四帧取一个样。这条序列是本文用两张剪影计算插值得到的,它展示了形变必须完成的两个操作——几何先移位,表面再跟上。第 8 帧值得细看:把手已经和杯身分开,观众能数出两件物体。下面的数字,防的正是这个。
决定它读不读得出来的五个数字
大多数弱形变不是渲染的问题,而是一个被甩给模型的节奏与对应关系问题。五个数字就能覆盖它,而且每一个都能靠暂停来查。
| 数字 | 它固定住什么 | 目标值 | 怎么查 |
|---|---|---|---|
| 变化的长度 | 几何那一步拿到多少时间 | 24 fps 下 12–17 帧(0.5–0.7 秒);只有变化本身就是整个镜头时,才用 24–36 帧(1–1.5 秒) | 数第一个和最后一个变化帧之间的帧数 |
| 两端的停留 | 眼睛到底有没有看清 A 和 B | 24 fps 下两端各至少 6 帧停留(0.25 秒) | 停在第 1 帧和最后一帧;两帧都必须静止、完整 |
| 锚点对 | 有多少特征在承诺「这是同一件东西」 | 4–6 组锚点,在写提示词之前就选好 | 念出来:杯口中心、把手根部、影子边缘、布上的褶 |
| 锚点偏移 | 一个固定特征允许漂多远 | 不超过画面宽度的 8%;缩放 10% 以内 | 把 A 和 B 调成同一尺寸并排放,量那道缝 |
| 路径变化 | 这次转换有没有一个方向 | 一条路径;最多一次折返 | 数变化里的方向反转 |
算术是大家最容易跳过的那部分。帧不是秒:18 帧在 24 fps 下是 0.75 秒,在 30 fps 下是 0.6 秒,同一个片段在一种帧率下显得慢,在另一种下就显得赶。先定帧数,再定帧率,然后把时间写进提示词,用这个镜头自己的单位。
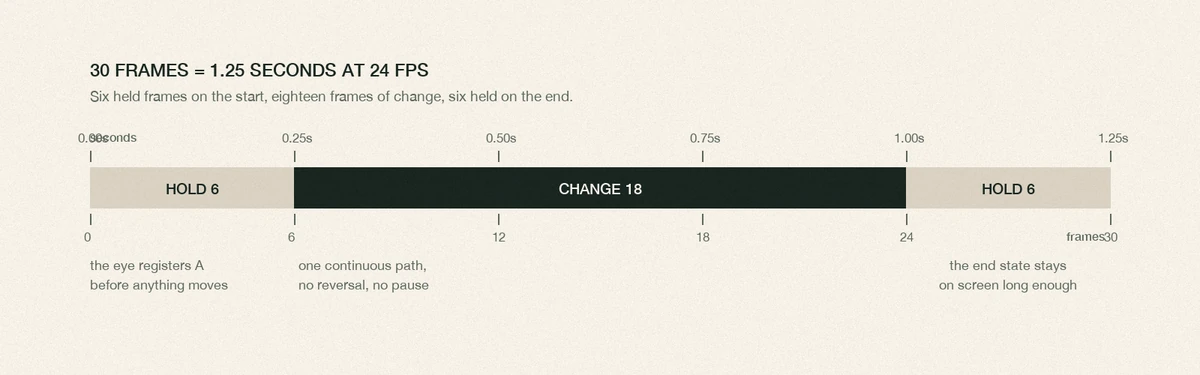
24 fps 下的一个 30 帧镜头,也就是 1.25 秒:开头停留六帧,中间十八帧变化,结尾停留六帧。按上表的数字等比例画出;这是示意图,不是渲染结果。
还有两个更小的数字,值得为你自己的镜头另设,因为它们让评审有据可依。把主体高度占画面的百分比写下来,再把它底边距画面底部的百分比写下来。如果 A 和 B 在这两项上差了几个点以上,哪怕几何本身干净,形变也会看起来像被抬起或被平移。
五段提示词,每段只动一个变量
下面每段提示词只改一件事,所以结果不好时,你能指到该改的那一行。它们共用一个例子——亚麻布上的一只粗陶马克杯,变成一只折纸鹤——因为它有一个明显的对应关系(把手对翅膀),也有一个明显的失败模式(陶瓷的光泽活到了纸上)。Ottermind 的输入框收一张参考图和一段文字指令,所以时间是作为「停留多少帧」写在提示词里的,而不是放在公开页面上的时长控件里。
| 提示词 | 它控制的变量 | 之后该看什么 |
|---|---|---|
| 1. 终点 | 结束状态必须和起始状态共享什么 | 首帧和末帧调成同一尺寸并排看 |
| 2. 锚点 | 哪些点不许动 | 你点名的那四五个特征,逐帧看 |
| 3. 路径 | 各个部分变化的先后顺序 | 中间三分之一,暂停着看 |
| 4. 时间 | 变化落在片段的哪一段 | 两端的帧数 |
| 5. 拒绝项 | 告诉模型要避开的失败清单 | 画面里多出来的任何东西 |
提示词 1——终点。 控制结束状态和起始状态的匹配:尺寸、位置、光的方向,以及主体允许占满画面的多少。 几何那一步大致对了、结果却漂出了那块布的时候,用它。
从附上的这一帧开始,把这只粗陶马克杯变成一只折纸鹤,并保持住最后一帧。主体的尺寸不变、在画面里的位置不变,亚麻布、桌沿和窗光都不变,镜头完全不动。纸鹤要留在马克杯原来那块布上,高度一样,朝向一样。画面里其他东西不动,也不多出任何东西。不要文字,不要标志,不要多余物体。这个按钮会把第一段需求填进页面顶部的输入框。它只负责填:什么都没发出去,在你到 Studio 里继续之前,也不会生成任何东西。做形变时这层空隙值得留着,因为起始帧得先附上、措辞得先改对,一次渲染才值得花。
提示词 2——锚点。 控制对应关系:那少数几个必须待在原地的特征,正是它们让观众相信这只纸鹤就是那只马克杯,而不是第二件物体。
整个变化过程中固定住五个点:杯口中心、把手和杯身相接的那一点、影子的前缘、杯后那道布褶,以及桌面的上沿。纸鹤的脖子从杯口中心升起,折出来的翅膀从把手长出来,尾巴始终在影子前缘以内。镜头不动,光的方向不变,布和桌面连几个像素都不许漂。提示词 3——路径。 控制中间三分之一:哪一部分先动、哪一部分后动,以及物体在变化过程中允不允许缩小、旋转或抬起。
让物体朝一个方向连续变化:先是把手向下折叠、收窄成一只翅膀;接着杯口合拢,杯壁压出折痕变成平的纸面;最后釉面转为哑光,成为折好的纸。变化过程中不许物体缩小、漂浮、旋转或弹跳。每一刻,物体底部都要贴着布。提示词 4——时间。 控制停留,按帧来,这样变化会落在你规划的位置,而不是从第一帧就开始。
前六帧让第一帧完全静止。接下来十八帧,让物体匀速地持续变化,中间不歇一口气,也不加速。最后六帧,让成形的纸鹤完全静止,不许漂,不许闪。整段镜头里机位锁死。提示词 5——拒绝项。 控制失败清单:那些明确不许发生的事,写成禁令,而不是愿望。
保持画面干净:不许推镜、摇镜、变焦或抖动;背景、布、桌面和光都不许变;不许出现多余物体;纸鹤上不许留下马克杯的残影;布不许扭曲;不许添加任何文字或符号。如果这次变化做不完,就把物体停在一个可信的半折状态,不要让它同时出现两件物体。第六段提示词其实不算形变提示词:它先让光对齐,修补的是两个片段之间的接缝。它属于 Image Effects 页面而不是视频页面,因为它改的是一张静帧。
把我上传的这张照片的色相、对比度和光的方向,对齐到参考画面的布光:同样是左侧偏暖的窗光,同样的影子方向和柔和度,同样中性的亚麻色,不要偏色。主体和构图完全保持原样,只换光。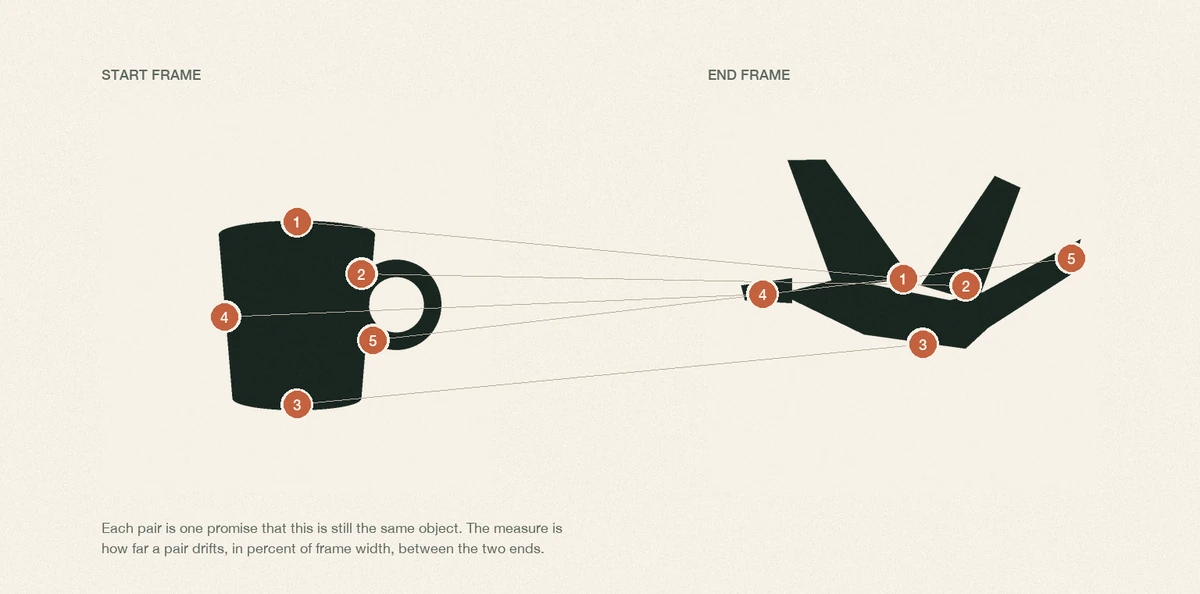
两端的五个锚点,以及它们之间的配对线。这是一张对应关系示意图,不是渲染出来的形变:它要说明的是哪些特征可以动、哪些是承诺。写提示词之前先把配对定下来,之后再用「占画面宽度的百分比」去量两端的偏移。
AI 形变会断在哪里
下面这些失败是生成视频特有的,不是动画的通病,而且大多数停在一帧上就看得见。按这个顺序查,因为一个扛过了其他所有修法的残影,通常是节奏问题,不是贴图问题。
| 你看到的 | 通常正在发生什么 | 怎么修 |
|---|---|---|
| 中间一路隐约有重影 | 融合在几何还没结束时就开始了 | 缩短变化,并把表面变化放到提示词的最后 |
| 硬边物体边缘发软、像化了 | 模型在平均贴图,而不是移动几何 | 在提示词里点明硬边和材质;把变化控制在 0.7 秒以内 |
| 主体没动,墙或布却在起伏 | 模型把整幅画面都当成可以形变的 | 要求背景、布和桌面保持不变,镜头锁死 |
| 多出一片翻片、一个尖角或一条肢体 | 模型凭空造了一只像样的翅膀,而不是把把手折过去 | 把对应关系写明确:哪个部位变成哪个部位,按顺序 |
| 文字变成看着像字的胡话 | 文字没有可供变形的稳定几何 | 别让字形进入形变;事后再在编辑器里加真字 |
| 主体朝镜头漂过来 | 推镜或变焦被读成了变化的一部分 | 写「机位锁死」「不推、不摇、不变焦」;比较首尾两帧里主体的高度 |
| 两段接缝处有明显跳帧 | 中间的静帧和第二段的头一帧对不上 | 先把两段一起调色,再在共用的那一帧上切,或者用一段短叠化藏住接缝 |
| 快速运动处细节糊成一片 | 变化太多,像素太少 | 放慢变化、缩短变化,或者渲染得更大再裁 |
有一条失败值得单独拎出来,因为它最贵:落错终点的形变,看起来像一段坏素材;落错终点却运动完美的形变,看起来像一个坏主意。 在把一次渲染花在中间那段转化之前,先把两端当成静帧批掉。
形变、补间,和夹在中间的叠化
这三个词经常被互相借用,但它们的区别是实用的,不是学术的:它告诉你该去够哪个控件。
补间填的是同一个主体两个姿势之间的帧。姿势由绑定或者一对关键帧定义,工作是插值——主体还是它自己,问题在于节奏和缓动。形变改的则是主体本身,从一张静帧到另一张静帧,工作是建立对应关系——A 的哪一部分变成 B 的哪一部分,表面在哪里换手。形变没有绑定可以信,这正是为什么锚点清单比缓动曲线更重要。如果你的片段里只有一个主体,问题只是它怎么动,你要的是补间工作流;如果主体本身换了身份,你要的是这一页。
交叉叠化是两者都便宜的版本:A 淡出,B 出现,没有任何几何在移动。两个镜头本来无关时,它是诚实的;两个镜头本该是同一个物体时,它是不诚实的,因为观众会把叠化读成换场。本页开头那个暂停测试,就是全部的界线所在。
风格迁移保留几何、改表面,正好是形变的一半。Ottermind 的 Image Effects 是放这一半的地方:它把一套视觉方向应用到你拥有授权的照片上,并保护主体和构图。在形变流程里,它是你让两端先在光上达成一致用的工具,不是让任何东西动起来的工具。
还有一个相邻的变量是机位。如果起始帧是斜的、结束帧是正的,模型常常去转整个世界而不是转主体,读起来就是一次荷兰角被纠正,而不是一次形变。如果你有意在某一端用了倾斜的画面,先读荷兰角,两端保持同样的倾斜;不然就得接受倾斜本身会变成形变的一部分。
在 Ottermind 里怎么做
先说边界。 Ottermind 的 Image to Video 页面从一张上传的图和一段用文字描述的运动开始,它自己写的步骤是:选参考、描述运动、看结果、重新生成。它不是有文档记载的「首帧加尾帧」工具,所以真正的双图形变,是你在它周围搭出来的,而不是从一个输入框里拿到的。下面所有内容都守着这条线。
路径 A——主体在一个镜头里变。 这是这个工具为它而造的情况,也是上面五段提示词描述的情况。
- 准备一张起始帧:主体要足够独立,剪影读得出来,光已经是你想在结尾看到的那种光。
- 先贴终点那段提示词,再贴锚点,再贴路径。时间那段提示词留给第二条,而不是第一条,这样你可以先看清模型拿这个形状怎么办,再去约束它的时钟。
- 生成,然后暂停三次:第一帧、中间帧、最后一帧。在中间帧上决定留不留,不要在播放时决定。
- 重新生成时一次只改一段提示词——路径或拒绝项,不要两个一起——把几条并排放着,直到有一条在暂停时站得住。
路径 B——两张不同的静帧,A 和 B。 这需要一个中间状态,因为模型必须被告知物体到一半时是什么样。先做出或者找到那张中间静帧,再把两半分开做。
- 让 B 共享 A 的取景:同样的机位高度、同样的焦段感、主体尺寸在 10% 以内、同样的光的方向。
- 在动任何东西之前,先用 Image Effects 把 B 调到 A 的色上,这样接缝就成了一件你已经解决过的打光问题。
- 做出中间静帧——以 A 为基础、用文字描述路径生成一个半折的物体——并把它当作整段序列的合页。
- 先 A 到中间,再中间到 B,做成两条。两半对得上就在共用的那一帧上切;对不上就重叠两到四帧。
- 按原尺寸看一遍接缝,再缩到缩略图看一遍——接缝在缩略图上会藏起来,跳帧不会。
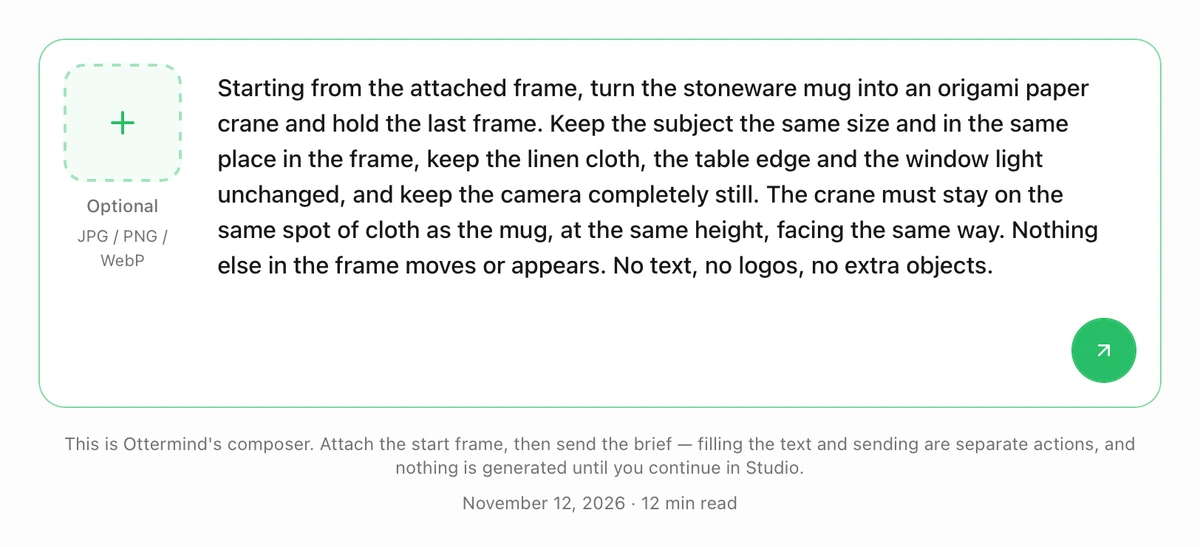
填好第一段需求之后,本页的输入框。附件控件是起始帧放的地方,发送控件只是把这段需求交给 Studio;这张截图展示的是一次准备好的请求,不是生成出来的形变。
留在工具之外的部分。 帧精确的端点控制、有保证的时长、固定的输出分辨率,以及清晰可读的文字,都不是这套流程承诺的事。它们在你的剪辑里:掐掉多余的停留、排上真正的字、把两半剪到你想要的那一帧。模型返回的任何东西,都是一条等你看的素材,不是做完的转场。
关于形变,几个值得回答的问题
形变和补间是一回事吗?
不是。补间在一个主体的两个姿势之间插值,所以主体的身份是固定的,工作是节奏。形变改的是主体本身,所以工作是判断 A 的哪一部分变成 B 的哪一部分。一个形变事后可以被补间,但锚点的决定在更前面。
一个形变该多长?
长到眼睛能跟着一条路径走完,短到任何一刻都不会同时看见两件物体。实际数字:变化发生在一个镜头里时,24 fps 下 12–17 帧;变化就是整个镜头时,24–36 帧。两端各停留至少六帧,让起止两个状态被看见。
为什么我的 AI 形变会糊成一团?
通常是因为该由几何干的活,被融合干了。模型找不到对应关系时,它就把两张贴图平均掉,结果读起来就是一次柔和的交叉淡入。缩短变化、点名对应的部位、让表面变化发生在最后。
能把两个不同人的照片做形变吗?
可以,这是最经典的用法,也是最严的:脸需要的锚点对比物体更多——眼睛、鼻根、嘴角、下颌、发际线——偏移的容差也更小,因为看脸的人都是专家。两张角度差很多的照片,会逼模型去虚构一个四分之三侧面,而身份就是在那里漂掉的。
能对文字或标志做形变吗?
不可靠。字形没有可供变形的稳定几何,生成的形变倾向于编出看着合理、其实不存在的字。让字形和标志完全留在形变之外,之后在编辑器里放进真正的素材,而且拿原始文件去量标志的比例,不要拿模型那一版去量。
形变是一门藏在大型视觉效果里的小手艺,而且是可以数的。把两端钉住、点名四五个锚点、选一条路径、把两端的帧数数清楚——然后在 Ottermind 里从一帧开始,剩下的交给模型真正擅长的那部分。
