Faceless Reels:不出镜短视频的完整制作流程
不出镜 Reel 是没有主持人在镜头前的竖屏短视频。先选格式,写三段式脚本,搭好画面,再在剪辑器里收尾配音和字幕。
可选
JPG / PNG / WebP
这是 Ottermind 的输入框。需求和参考图在你发送之前都只留在草稿里;点圆形箭头,请求才会交给 Studio 审阅。
2026年11月9日 · 约 12 分钟
不出镜 Reel(faceless reel),就是画面上不出现主持人的竖屏短视频。 规矩只有这一条。手、产品、录屏、旁白、动态字幕、生成出来的场景,都能用。
定义松,所以“不出镜 Reel”其实不是个好用的工具搜索词——它说的是形态,不是做法。真正要定的是:这条片子靠什么撑起来。是你拍得到的实拍,是能录屏的演示,还是必须生成的画面。先回答这一句,工具清单立刻短一半。
这篇给的是制作顺序,不是又一份灵感清单。四类可复用的格式、三段式脚本、几条值得试的画面路线,以及生成之外仍得自己做的那遍剪辑。想现在就试生成这条路,页面上方的输入框收一段需求,也可以附一张参考图。
本文的资料说明: 官方页面均读取于 2026年11月9日:Dreamina 的 faceless reels 页,以及 Ottermind 的 AI Reel Maker、AI Product Video Ads、AI Lip Sync 三个工具页。这是一篇基于上述页面写的工作流指南,不是速度或质量测评。本文没有生成任何 Reel。封面是 Ottermind 的设计,输入框那张图是本页的真实截图,没有任何 AI 图片被当作产品输出展示。各应用不一的格式规则,以各自当前的上传界面为准。
什么是不出镜 Reel,什么不是
不出镜,省掉的只是“必须有人站到镜头前”这一道工序。它没省掉“观众为什么要看下去”。画面里仍然要有主体,声音里仍然要有观点,第一秒仍然得换来第二秒。
三条约束定义了这种格式:
- 镜头前没有人。 手、产品、屏幕、文字、生成的画面,都算数。
- 竖屏构图。 要按手机来设计,不是把横屏素材裁一刀。
- 短视频节奏。 一个点子,开头要快,结尾要清楚。
大家选它,多是出于实际考虑:不想露脸、想要一套能重复的流程、不用布光、热点还在的时候就能发。这些是制作上的好处,不等于平台会给你流量,本文也不谈播放量。
还有两组概念值得分开。用生成主持人出镜的 Reel,不算不出镜——哪怕没人真的站在镜头前。全程没人说话的 Reel 也未必就是不出镜,那是音频上的选择,跟谁出镜无关。两件事分开决定。
先定格式,再挑工具
四类格式能覆盖大多数不出镜账号。挑一类你今天就能拿出东西来的,再判断生成要不要插手。
| 格式 | 需要什么 | 靠什么撑住片子 | 主要风险 |
|---|---|---|---|
| 产品空镜配旁白 | 一件产品、一个台面、还过得去的窗光 | 质感、比例,加上一段讲解 | 画面好看,却没有观点 |
| 只拍手的演示 | 手、工具、材料、干净的台面 | 动作本身和结果 | 每条之间构图对不上 |
| 屏幕或界面走查 | 一段录屏,和一个让人看下去的理由 | 屏幕上发生的变化 | 露出隐私数据,或界面看不清 |
| 生成的场景序列 | 一份写好的需求,最好再加一张参考图 | 主体、风格、运动是否连贯 | 产品走形、手变形、冒出莫名其妙的文字 |
真东西拍得到,前三种通常更省事:控制力更强,返工更少。生成的画面最有价值的时候是三种——主体难拍,你需要一个自己进不去的视觉世界,或者想先试几个方向再决定要不要实拍。
四种拍法,大致摊在桌上:左上角是手机架着对准一只杯子,右上角是一双手在给杯子裹布,下方是摊开的分镜本和空白场景卡,用来排镜头。本文的 AI 生成概念插图,不是任何产品的截图,也不是样例产出。
还有第五种,文字驱动的动态画面,夹在中间:一句话或一条知识点,压在会动的背景上。一个人做最省力,也最容易做成一张静止的图。句子本身就是钩子的时候才用它,别把它当成每条片的默认解。
工具页面不是制作方案
Dreamina 的 faceless reels 页面(读取于 2026年11月9日)是这个品类的典型样本:三个按主题分的概念提示词、一套三步出图的流程、支持上传参考图,最后交接到它自己的视频生成器。你需要一些视觉方向来挑的时候,这些确实有用。
可它不是一条成片的方案。脚本、人声、字幕时间轴、音乐授权、最终剪辑,页面一样没提——而决定观众留不留的,恰好是这几样。它的提示词模板甚至写死了 16:9 的宽画幅,这倒是个提醒:套用任何提示词之前,先想清楚你要的输出比例。把生成器页面当成视觉选项的来源,格式和脚本的事,回到上面两节。
先写三段式脚本
不出镜 Reel 翻车,多数翻在脚本,不在镜头。先写口播稿,再去收画面。一句话说不清这条片要给人什么,说明它其实是两条片。
三段就够:
- 钩子。 第一句直接给结果、问题,或者一个意外。寒暄和铺垫全省。
- 证据。 让东西真的动起来。两到四个镜头通常够用:物件、动作、结果。
- 落点。 收在一句结论,或者一个下一步动作上。别在同一口气里塞关注、收藏、评论、点链接。
拿一家陶艺工作室举例,按只拍手的格式写:
钩子: 买手工马克杯之前,我会先看三处。
证据: 杯口抵着直尺的特写。杯底在桌面上晃。一只手捏住把手,把杯子提起来。
落点: 杯口不平,就放回架子上。
这段脚本一次干三件事:告诉你需要哪些镜头,给了口播一个自然的长度,也把撑不住的说法逼出来。“三处”就真是三处;含糊的“几个要点”,什么也没承诺。
出声读一遍,哪句绊嘴就删。再看画面已经说清的句子,也删。不出镜 Reel 不是配了图的播客——声音和画面各扛同一个意思的一半。
搭画面:三条路线
路线一:用手上已有的素材
从两到四秒的片段开始。能竖拍就竖拍,主体别贴着画面底边——那儿是应用控件的位置——每个动作前后多录一点,剪辑时才有余量。
卡住你的通常是权利,不是设备。素材自己拍;画面里有能认出来的人、私人场所、别人的品牌产品,先拿许可。许可和项目存在一起,别等以后再去回忆。
路线二:生成一段场景序列
视觉世界本身就是难点的时候,生成很合适。写清主体、场景、动作、运镜、光线、节奏,再补两条生成器最容易漏的约束:不露脸,不出现屏幕文字。
Ottermind 的 AI Reel Maker 把一段文字需求加一张可选参考图,变成竖屏短视频。文档里的流程是先定信息、受众、投放位置、时长和视觉情绪,再在对话里看片、改片。某个产品、某种配色或某个场景必须活过生成这一步时,参考图就派上用场。
生成出来的镜头,每次都用同一张清单过一遍:首帧、镜头之间的主体连贯、手和手指、产品形状与标签、背景扭曲,以及模型自己编出来的文字。产品这一关不过,光再美也弃掉。一张漂亮但错的图,比一张普通但对的图贵得多。
运镜要写得更长的那种需求,图生视频提示词教程讲得更细。原则不变:一个镜头一个动作,胜过五条互相打架的指令。
路线三:一张产品图,做成纯产品片
卖实物产品的话,从照片开始,别从空白提示词开始。Ottermind 的 AI Product Video Ads 收一张产品图,再收一张可选的人物图。不传人物图,出来就是不出镜的纯产品片;传了,片子就变成主持人主导。
工具页描述的是一条 15 秒的 UGC 风格广告:钩子、快速演示、行动号召,按竖屏信息流来做。这个结构即便台词全部重写也管用——它逼你交出开头、中段和一句请求。
原图决定了上限。用一张干净、颜色准确、产品占满画面的图。照片虚、光不对、三件产品挤在一起,先把这些解决掉;生成器补不回本来就不存在的细节。
配音、字幕,和那遍剪辑
工具导向的教程最常跳过这一段。可不出镜 Reel 好不好看,恰恰在这里定。
配音。 自己录,对重音和节奏的控制最足。找个安静的屋子,手机拿近,一句一句录——错一句只废一行,不用整条重来。用文字转语音工具的话,先确认授权范围覆盖你要发布的地方,再听一遍人名和数字念得对不对。
配音这一遍,更像一张书桌而不是一块仪表盘:耳机、用来录音的手机,还有一本笔记,每段一行。本文的 AI 生成概念插图,不是产品界面,也不是 Ottermind 的截图。
Ottermind 文档里的语音生成,属于它基于人像的口播视频流程。那不是独立的“不出镜旁白”功能,别拿它来规划纯配音。自己录,或者另找一个你验过的配音工具。
字幕。 在剪辑器里加,然后手动改一遍。产品名、数字、术语,是自动字幕最容易留下的错。每屏一到两行,放在应用控件区之上,拿手机伸直手臂看一眼对比度。字幕如果跟口播一字不差,考虑删短一点——剩下的观众听得见。
音乐和时间轴。 用能为投放平台拿到授权的音乐,人声要稳稳压住伴奏,按动作切,别对着固定的秒数切。导出按投放平台当前的规格来,别照着旧教程里的数字填。
| 环节 | 在哪里做 | 为什么归那里 |
|---|---|---|
| 脚本和镜头表 | 笔记、文档,或 Ottermind 对话 | 想法在变贵之前,得先能改 |
| 画面 | 自己的素材,或 Ottermind 生成 | 按你真正拍得到的东西选路线 |
| 配音 | 录音机,或有授权的文字转语音工具 | 语气和发音,得亲耳听 |
| 字幕、音乐、剪辑 | 视频剪辑器 | 逐帧对时间和混音,是剪辑器的活 |
| 发布 | 投放平台的应用 | 上传规则、标注、排期都在那边 |
这张表是条诚实的界线。Ottermind 从一段需求生成视频方案,并支持在对话里改,但它替代不了逐帧对字幕、音乐授权,也替代不了平台的上传流程。手上的活主要是剪一条已有录像的话,单独给它排时间,别指望生成器顺手做完。
30 分钟做完一条
目标是一条能发的片,不是一套内容体系时,用这个。
- 定一类格式,把承诺写成一句话。 这句话需要逗号加“而且”,就拆成两条。
- 写三段,出声读。 绊嘴的全删。
- 列五到七个镜头,每个标上“实拍 / 录屏 / 生成”。 有个镜头你根本拿不到,就是在这儿发现的。
- 拍,或者生成。 只留通过产品和连贯检查的那几条。
- 录音、拼片、加上改过的字幕。
- 手机静音看一遍,修前两秒,然后导出发布。
一条片可以发了,标准是这些:首帧没声音也看得懂,主体在每个镜头里长得一样,没有不该出现的文字,字幕把产品名拼对了,声音不爆,每一段素材和每一首曲子的权利状态你都说得清。这些检查很枯燥。能发的片和一堆实验文件,就差在这儿。
在输入框里试这段不出镜需求
下面这段是给陶艺工作室写的,按只拍手的格式。产品、台面、光线换成你自己的,约束别动:竖屏、不露脸、不加屏幕文字、一个镜头一个动作。
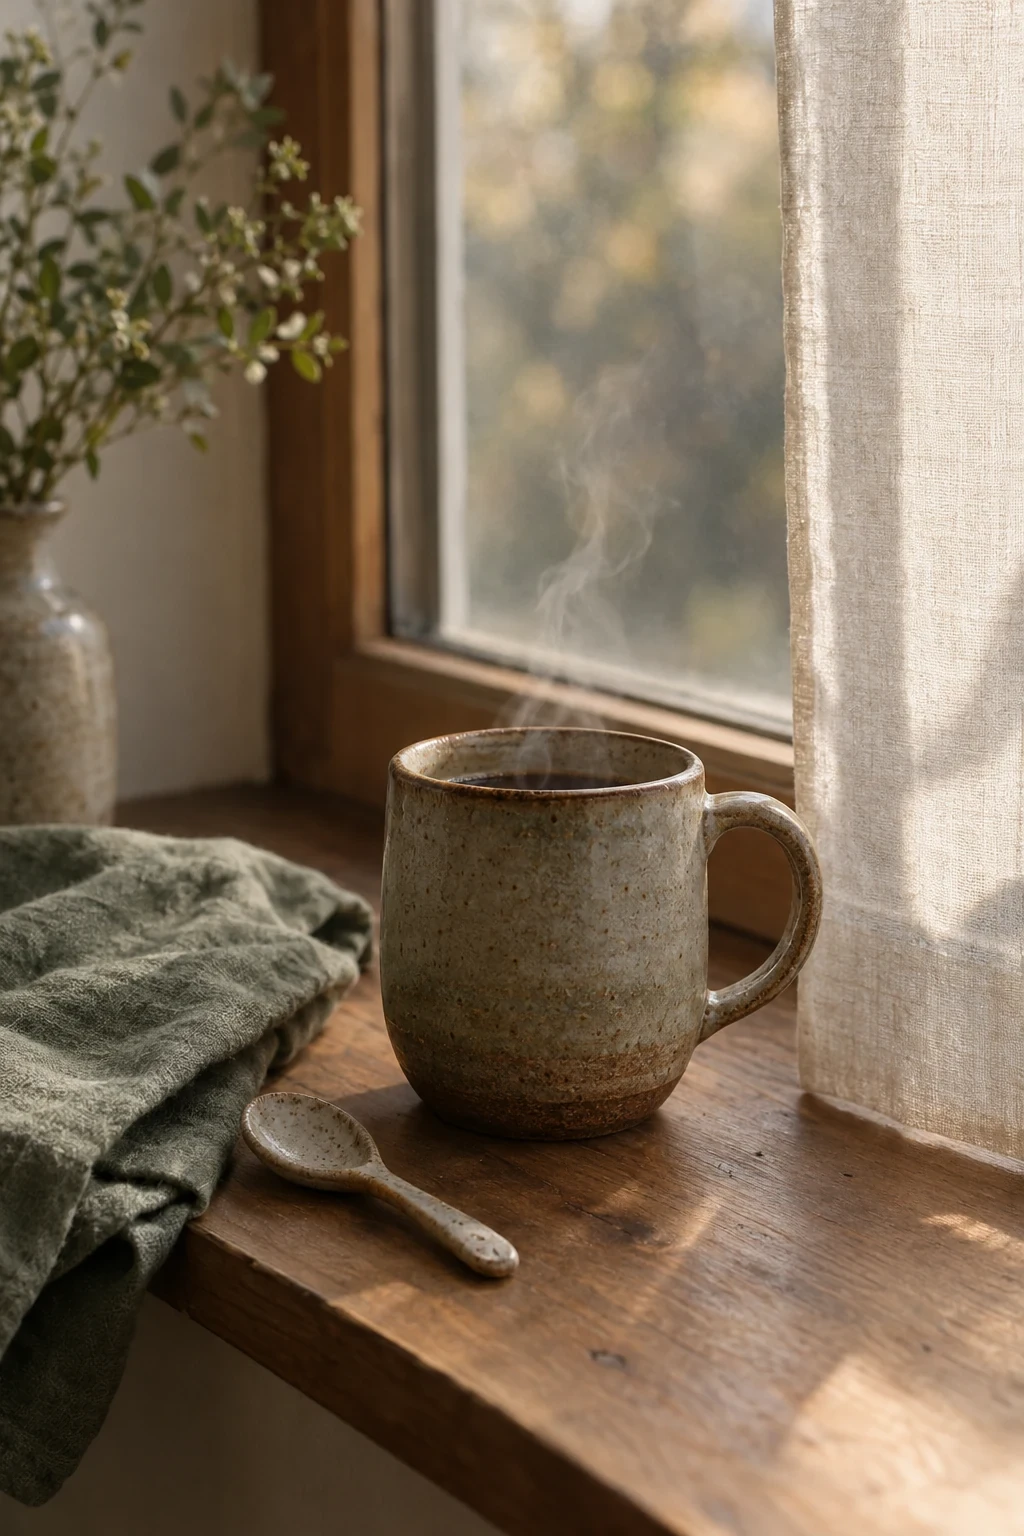
需求里描述的那个开场:杯子、窗台、热气,没有人脸。这是为本文做的 AI 生成概念帧,不是 Ottermind 的输出。如果它跟你的产品对得上,可以拿它当视觉参考传上去。
为一家小型陶艺工作室做一条 15 秒的竖屏不出镜 Reel。开场是窗台上炻器马克杯升起热气的特写,切到两只手把杯子托起来,再慢慢环绕亚麻布上的杯子转一圈。画面里不出现人脸,不加屏幕文字,不放 logo。清早的暖光,低饱和的大地色,节奏放慢。按钮会把内容填进本页顶部的输入框。填入不等于发送:文字和附上的参考图都留在草稿里,直到你点那个圆形箭头。空的输入框、没有附件,是发不出去的,所以占位文字不会变成一次误发的请求。
杯子的形状、釉色或者标签必须保持一致,就附一张产品图。参考图引导生成,但不会把结果锁成一份精确的复制品。没登录的话,参考图跟着草稿存在这台设备上,发送时一起带进 Studio;在这个页面上选中它,不会往任何账号上传东西。
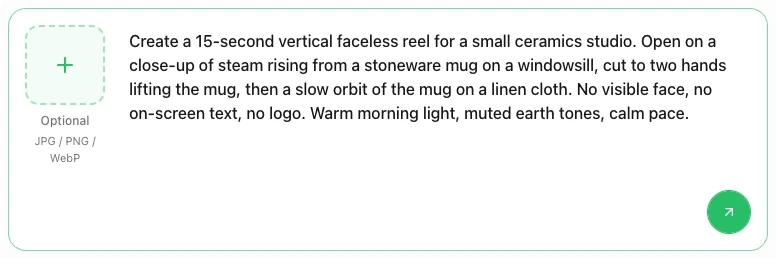
用完之后的本页输入框。参考图那块是可选的,箭头把请求交给 Studio 审阅。截图展示的是请求的准备过程,不是生成结果。
请求到了 Studio,生成前先看当前的套餐资格、模型选择和标出来的积分消耗——这些跟着账号走,不归本文管。第一条不满意,就只提一处具体改动:环绕再慢一点、热气少一点、背景再淡一点,或者换一个台面放同一只杯子。其余部分不动,两次对比才有意义。
什么时候该破例出镜
有些话确实需要一张脸:直接的请求、需要眼神的讲解,或者一段产品镜头扛不住的表演式回应。这是换格式的正当理由,不是把界线搞糊的理由。
Ottermind 的 AI Lip Sync Tool 从一张人像和一份写好的脚本出发,生成音色和一个口播视频方案,表演得你自己看。文档明确提醒,别假定它能逐帧对上。人像要拿授权,别让人以为某个真人说过他没说过的话,该标注合成内容的地方就标注,发布前把表演看一遍。
走这条路,结果就是主持人主导的片子。在自己的排期里也这么标,别当不出镜去推。这个区分,观众在意,你发布时遵守的平台规则也在意。
不出镜 Reel 常见问题
不出镜 Reel 一定要有旁白吗?
不一定,但静音得有静音的理由。文字主导的片子、让人看得舒服的过程镜头、靠音乐推的剪辑,都可以没有解说。价值在讲解里,就录;只靠字幕,观众是在读,不是在看你拍的东西。
能完全用 AI 做一条不出镜 Reel 吗?
画面序列可以生成,配音也能另找一个工具生成。没法自动化的是判断:产品对不对、连不连贯、权利清不清楚、要不要标注、前两秒值不值得看。每一条生成出来的片子,都得留出审的时间。
不出镜 Reel 该多长?
以投放平台当前的上传页面为准。剪得紧一点,整体更好撑住,用生成镜头时尤其如此;但本文不给一个可能早就变了的平台上限。
画面是生成的,需要说明吗?
规则按平台、市场、题材各不相同。查投放地当前的政策,要求标注的就标注。别把生成的场景当成真实事件或真实客户的纪实素材。
Ottermind 能顺带把剪辑和字幕也做了吗?
文档里的 Reel 流程是基于提示词的生成,加对话式修改。逐帧的剪辑点、字幕样式与时间、音乐授权、上传本身,属于剪辑器和投放平台。把这些排进日程,别假定生成那一步已经覆盖了。
要花多少钱?
本文不报价格,也不报生成额度。套餐资格和实际扣费,会在 Studio 里针对你真正提交的那次请求显示。
接下来做什么
从手上的材料出发,别从你最先刷到的工具出发。
- 有素材,也有清楚的想法: 写三段、录音、剪。生成可有可无。
- 只有一张产品图: 打开 AI Product Video Ads,不传人物图,做一条纯产品片。
- 有需求,没素材: 用 AI Reel Maker,主体一致性要紧就附参考图,出来按镜头清单审。
- 先要运镜语言: 读图生视频提示词教程,回来时做到一个镜头一个动作。
格式是活的,制作顺序不是:先定靠什么撑住片子,写出那句承诺,只拍能证明它的镜头,最后在真正能收尾的地方把声音和字幕做完。
