Guia técnico
GPT-6 na programação: bugs entre arquivos, pequenos ajustes e testes reais
A vantagem mais interessante do GPT-6 Astra na programação é conectar informações espalhadas pelo código. Os primeiros testes sugerem um benefício maior em revisões difíceis entre arquivos do que em alterações simples. Isso o torna um candidato para investigar consequências de mudanças, enquanto a implementação rotineira ainda merece uma comparação de custo e velocidade.
Duas avaliações externas úteis fazem perguntas diferentes: CodeRabbit mede se os achados da revisão detectam bugs previamente identificados, enquanto Real Python verifica o comportamento em cinco prompts fixos. Juntas, oferecem um ponto de partida mais prático do que um único ranking de programação.
Fontes: avaliação da CodeRabbit; testes da Real Python; comparação de programação da OpusBooster. Consultadas em 7 de setembro de 2026. Resultados e experiências são atribuídos aos respectivos autores ao longo do texto.
O que a CodeRabbit mediu
Na avaliação de 4 de setembro, a CodeRabbit reportou a seguinte cobertura de bugs por achados que permitem agir:
| Conjunto de revisão | Astra | Sol | Diferença |
|---|---|---|---|
| Geral | 61,3% | 59,0% | 2,3 pontos percentuais |
| Subconjunto mais difícil, entre arquivos | 57,1% | 47,6% | 9,5 pontos percentuais |
O ganho relativo de aproximadamente 20% no subconjunto difícil não representa 20 pontos percentuais. Também não significa que toda equipe entregará 20% menos bugs. A métrica mede bugs identificados naquela avaliação, e as duas linhas representam distribuições diferentes de dificuldade.
O resultado justifica testar Astra em mudanças com consequências distribuídas entre arquivos. Não prova que todo comentário de revisão esteja correto, que todos os bugs importantes sejam encontrados ou que pequenos patches precisem do modelo mais caro.
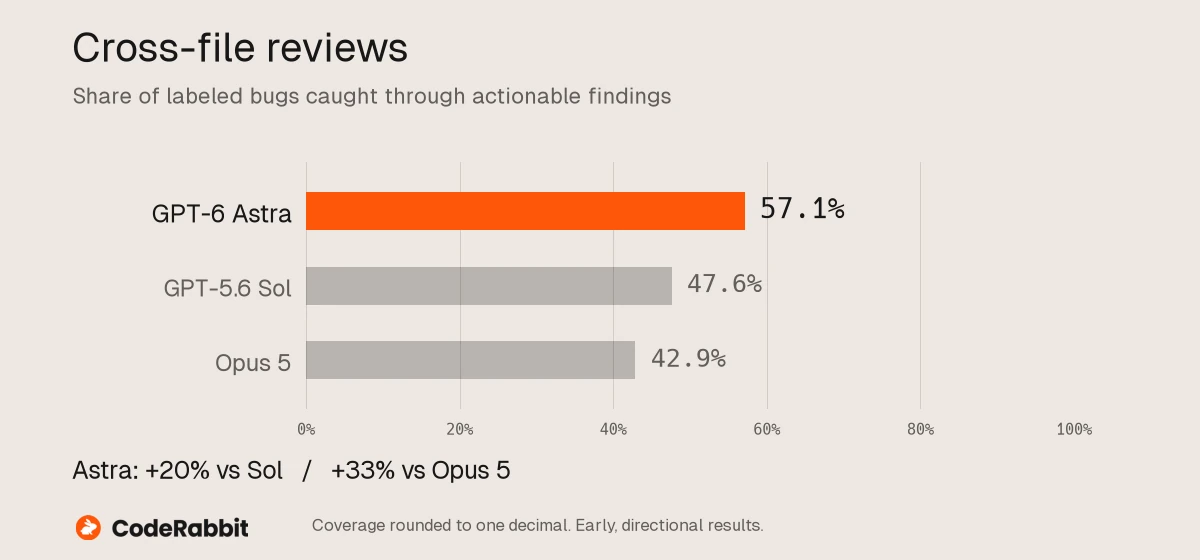
Resultados de revisão entre arquivos publicados pela CodeRabbit. São dados iniciais, não uma medida da qualidade geral de revisão.
O que a Real Python testou
O teste de cinco prompts da Real Python usou Astra pelo OpenRouter com raciocínio padrão, uma tentativa por prompt e nenhum prompt de sistema. O site publicou as saídas para inspeção.
O modelo reconheceu que uma função inventada da biblioteca padrão não existia. Ao acrescentar uma opção simples, alterou 11 linhas, contra o mínimo de sete. As cinco tarefas custaram US$ 0,31 naquela execução. É um formato de teste útil: verificar APIs inventadas, tamanho do patch e execução, em vez de aceitar código apenas porque parece plausível.
Cinco prompts não permitem prever o desempenho no seu repositório inteiro. Podem, porém, revelar pequenos comportamentos que um benchmark amplo deixa passar.
Por que testes aprovados podem não validar a funcionalidade
Uma comparação entre Astra e Terra baseada em produção constatou que ambas as implementações passaram na suíte existente, mas uma ainda tratava incorretamente estados relacionados de paginação. Astra preservou a relação e acrescentou uma verificação correspondente.
A lição geral é revisar o contrato de comportamento alterado pela tarefa. Os testes existentes talvez nunca exercitem a interação que torna a nova funcionalidade útil. Pergunte se cobrem a jornada do usuário, não apenas a função recém-escrita.
Leia o patch por trás da pontuação
A Real Python publica tanto o diff da pequena alteração quanto sua contagem de linhas. As linhas extras incluem formatação da definição do argumento; portanto, ultrapassar o mínimo não demonstra, por si só, complexidade prejudicial. A pergunta útil é se o patch muda algum comportamento fora do pedido. A etapa posterior de trabalho real ainda estava incompleta na consulta, então os cinco prompts devem ser avaliados por seus próprios resultados. Veja o teste e o patch.
Essa distinção importa na avaliação de qualquer agente de programação. Um patch maior pode melhorar a clareza, enquanto um curto pode esconder uma quebra de compatibilidade. Examine o que o código acrescentado faz, quais comportamentos existentes altera e se os novos testes falhariam sem a correção.
Use benchmarks para selecionar candidatos e depois inspecione as entregas para saber se o trabalho se encaixa no repositório. Uma demonstração de produto, uma avaliação de cobertura de bugs e um teste de prompts fixos respondem a perguntas diferentes.
Exemplo completo: revisar uma mudança de paginação compartilhada
Considere uma página ilustrativa com duas listas paginadas de forma independente. O usuário leva a primeira lista à página três e depois avança a segunda. A primeira deve permanecer na página três. Cada paginador pode funcionar sozinho e, ainda assim, a interação entre ambos falhar.
O revisor deve acompanhar a construção da URL, a leitura dos parâmetros, o estado dos componentes e a navegação do navegador. Se o novo link contiver apenas o parâmetro da segunda lista, poderá apagar a seleção da primeira. Um teste unitário de qualquer paginador isolado talvez não detecte isso.
URL inicial: /results?customersPage=3&invoicesPage=1
Ação: avançar as faturas para a página 2
Esperado: /results?customersPage=3&invoicesPage=2
Verificar também: recarregamento, voltar no navegador e página inválida
É esse tipo de relação que o caso da OpusBooster incentiva a investigar. Ele também lembra a importância de escrever um exemplo de aceitação antes da implementação. O exemplo dá ao agente e ao revisor um alvo concreto sem impedir o uso de funções auxiliares já existentes no repositório.
Separe cobertura de achados de qualidade da revisão
Um revisor que encontra mais bugs conhecidos ainda pode gerar falsos positivos que distraem. Sua avaliação local deve registrar quais achados o mantenedor aceita, quais rejeita e quanto tempo gasta verificando ambos. Uma preocupação vaga, sem condição de disparo, pode consumir mais atenção do que poupa.
| Resultado da revisão | O que registrar | Por que importa |
|---|---|---|
| Defeito confirmado | Reprodução e comportamento afetado | Mostra um achado útil |
| Achado incorreto | Por que o código é válido | Mede o ruído da revisão |
| Questão pendente | Evidência ou ambiente ausente | Evita transformar incerteza em afirmação de bug |
| Defeito não encontrado | Bug histórico ou reprodução posterior | Expõe lacunas de cobertura |
Quando possível, peça que o mantenedor avalie sem ver o nome do modelo. Mantenha a dificuldade visível: uma pequena configuração e uma migração entre serviços não devem virar uma única média sem explicação.
Forneça contexto suficiente para revisar consequências
Comece pelo pedido de mudança e pelo diff; depois disponibilize os chamadores e testes afetados. Inclua requisitos de compatibilidade fáceis de esquecer, como um cliente antigo de API, um formato de dados persistido ou um comando público cuja saída é interpretada por scripts.
Evite despejar material irrelevante no prompt. Peça ao modelo que siga os caminhos afetados e explique o que precisou ler. Isso torna a revisão mais verificável e ajuda a perceber se uma dependência importante nem sequer foi considerada.
Ao mudar um tipo compartilhado, exija verificações de produtores e consumidores. Em uma migração de banco, inclua premissas de atualização e rollback. Em interfaces, descreva as transições de estado esperadas pelo usuário. O guia de arquitetura de agentes de IA aborda a relação entre contexto, ferramentas e modelo.
Ajuste os testes ao tamanho da mudança
As orientações de prompts do GPT-6 da OpenAI observam que tarefas de programação podem disparar mais testes do que uma pequena alteração exige. Antes de executar, defina a verificação relevante: o teste focado, o comportamento que ele comprova e a condição que justificaria uma suíte maior.
Corrigir uma grafia e alterar autenticação compartilhada exigem validações diferentes. Em um patch pequeno, repetir a suíte inteira pode acrescentar pouca evidência. Em uma mudança de comportamento compartilhado, um teste unitário pode ser insuficiente. Peça ao modelo que explique o alcance das verificações em termos do comportamento afetado.
Comece pelos testes que cobrem o comportamento alterado.
Amplie as verificações se a mudança afetar um contrato compartilhado
ou se o resultado focado revelar uma regressão mais ampla.
Informe qual comportamento cada verificação comprova.
Se algum teste não puder executar, forneça o comando e o impedimento.
Não deixe um agente fazer a suíte passar enfraquecendo asserções sem relação com o pedido. Revise testes excluídos e expectativas alteradas como parte do patch. O status aprovado só é útil quando os testes continuam expressando o contrato pretendido.
Compare o custo de uma mudança aprovada
Registre uso do modelo, tempo de ferramentas, tentativas e revisão do mantenedor por caso. Depois compare o custo até chegar a um patch aprovado. Uma primeira tentativa barata pode sair cara após duas rodadas de reparo; um modelo caro também pode desperdiçar tempo redesenhando o que não precisava.
Faça um pequeno experimento de encaminhamento: envie revisões difíceis entre arquivos ao GPT-6 e mantenha patches rotineiros no modelo atual. Amplie apenas se houver mais achados aceitos ou menos retrabalho. Não extrapole uma vitória em revisão para implementação, documentação ou design visual sem testar essas tarefas separadamente.
Quatro casos para sua avaliação de programação
| Caso | Tarefa | Verificação de aceitação |
|---|---|---|
| Pequena edição | Acrescentar uma opção a um comando existente | Sem a opção, a saída anterior permanece igual |
| Mudança entre arquivos | Alterar um campo de dados compartilhado | Todos os produtores e consumidores seguem o novo contrato |
| Depuração | Investigar uma falha reproduzível | A correção resolve a reprodução e preserva comportamentos próximos |
| Revisão | Examinar uma mudança histórica com bug | Achados identificam defeitos reais sem ruído especulativo |
Use um snapshot inicial limpo para cada candidato. Mantenha instruções, ferramentas permitidas e orçamento iguais. Registre patch real, mudanças de testes, correções do revisor e tempo até a aceitação. Para comparar modelos, veja GPT-6 vs GPT-5.6.
Modelo de prompt para revisão de código
Revise esta mudança conforme o comportamento pretendido: [objetivo].
Siga os chamadores, consumidores de dados e caminhos de erro afetados.
Para cada achado, forneça:
- A condição concreta que dispara o bug
- O comportamento afetado e referências aos arquivos que o comprovam
- Uma reprodução ou um teste que revele o problema
Priorize defeitos acionáveis. Explicite incertezas.
Não edite arquivos durante esta revisão.
Modelo de prompt para implementação
Implemente [comportamento] usando os padrões existentes do repositório.
Leia o código e os testes relevantes antes de escolher uma abordagem.
Preserve [invariantes e requisitos de compatibilidade].
Verifique [jornada específica do usuário] além dos testes focados.
Entregue a mudança, resultados de verificação e limitações restantes.
Torne as invariantes concretas: manter a seleção do outro filtro, preservar a saída do comando ou não mudar a estrutura pública da resposta. Restrições específicas são mais testáveis que um pedido de "código com qualidade de produção".
Quando a atualização compensa
Experimente Astra quando a tarefa exigir raciocínio cuidadoso entre módulos ou quando o tempo do revisor dominar o custo. Mantenha uma referência mais barata para alterações repetitivas e fáceis de verificar. Não use quantidade de linhas ou comentários gerados como medida de produtividade: mudanças desnecessárias podem aumentar a revisão.
Em projetos que combinam pesquisa, requisitos e planejamento de implementação, organize briefing e materiais de apoio no Ottermind. Mantenha a verificação do código no repositório e conecte os resultados à decisão mais ampla do projeto.
Perguntas frequentes
GPT-6 é melhor em revisão de código?
A avaliação inicial da CodeRabbit encontrou maior cobertura por achados acionáveis, com vantagem maior no subconjunto difícil entre arquivos. Teste esse comportamento no seu código.
Uma pontuação maior permite dispensar revisão?
Não. A cobertura continua incompleta, e até um achado útil precisa ser validado antes de mudar o código.
Astra é sempre a melhor opção para um patch pequeno?
As evidências publicadas não estabelecem isso. Compare correção, mudanças desnecessárias, velocidade e custo.
O que medir além de testes aprovados?
Confira contrato da funcionalidade, risco de regressão, cobertura removida, correções do revisor e tempo até o patch aprovado.
Por onde começar?
Use os casos acima e consulte o guia da API do GPT-6 para os detalhes de integração.
