모델 소식
GPT-6 리뷰: 출시일, 독립 테스트와 도입 판단
GPT-6가 출시됐지만 모든 작업에 곧바로 더 나은 선택은 아닙니다. OpenAI는 2026년 9월 3일 GPT-6 Astra를 출시했습니다. 첫 주의 독립 테스트는 어렵고 서로 연결된 작업에서 실제 개선을 보여 주지만, 높은 지연 시간과 가격, 일상적인 프롬프트에서의 불균일한 이점도 드러냅니다. API 모델 ID는 gpt-6-astra입니다.
이 글의 판단은 Astra가 일상 대화나 대량 생성의 기본 모델보다는 길고 밀접하게 연결된 과정의 고난도 작업에 적합하다는 것입니다. 대규모 시스템을 이해하고 여러 도구를 사용하며 제약을 지켜야 하고, 잘못된 결과의 비용이 큰 경우에 가장 설득력이 있습니다. 범위가 명확한 작업에는 GPT-5.6급 모델이 여전히 경제적입니다.
출처: 출시 발표; 모델 문서; 개발자 안내; 안전성 개요; 이용 조건; Artificial Analysis; 실제 제품 작업 기반 코딩 비교; API 실측; Axios 보도; 보안 전문가 의견. 2026년 9월 7일 확인.
핵심 답변
| 질문 | 2026년 9월 7일 기준 답변 |
|---|---|
| GPT-6가 출시됐나요? | 네. OpenAI가 2026년 9월 3일 GPT-6 Astra를 출시했습니다. |
| API 모델 ID는 무엇인가요? | gpt-6-astra |
| ChatGPT에서 쓸 수 있나요? | 해당 Pro, Business, Enterprise 요금제에 GPT-6 Pro가 순차 제공됩니다. 제품과 워크스페이스 설정에 따라 다릅니다. |
| Codex와 ChatGPT Work는요? | 순차 제공 중입니다. OpenAI에 따르면 Plus에는 Work와 Codex 접근이 포함되지만 Chat은 조건이 다릅니다. |
| API 요금은 얼마인가요? | Standard 입력 100만 토큰당 10달러, 출력 100만 토큰당 50달러이며 캐시 읽기와 쓰기는 별도입니다. |
| 컨텍스트 크기는요? | 1,050,000토큰, 최대 출력 128,000토큰입니다. |
| 모든 작업을 지금 옮겨야 하나요? | 아닙니다. 실제 작업으로 평가해 추가 비용과 운영 위험을 상쇄하는 경우만 옮기세요. |
독립 테스트가 보여 주는 것
초기 외부 증거는 출시 홍보보다 신중합니다. 역량 향상은 뒷받침하지만 모든 작업에서 승리하거나 항상 가장 경제적이라는 뜻은 아닙니다.
| 외부 테스트 | 결과 | 실무적 해석 |
|---|---|---|
| Artificial Analysis Intelligence Index | 현재 집계에서 Astra max 55점, 202개 모델 중 3위 | 최상위권이지만 독보적 1위는 아님 |
| Artificial Analysis 속도 | 초당 출력 64.3토큰, 202개 중 93위 | 비교군 중앙값보다 낮고 같은 자료의 GPT-5.6 Sol max보다 느림 |
| Artificial Analysis 지수 과제 비용 | Astra max 2.57달러, Sol max 1.25달러 | 4점 향상에 과제당 약 두 배 비용 |
| ComputingForGeeks 디버깅 시험 | Astra, Sol, Terra, Luna가 같은 세 가지 원인을 찾음 | 차이는 진단 자체보다 한계 설명과 검증 절차 |
| 실제 개발 기반 비교 | 두 모델 모두 기존 테스트를 통과했지만 Astra만 연결된 페이지 상태를 보존하고 테스트 추가 | 통과한 테스트도 기능 계약 오류를 놓칠 수 있음. 이 과제에서는 Astra가 구성 요소 관계를 더 잘 이해 |
Artificial Analysis는 max 설정에서 첫 토큰까지 약 355초도 측정했습니다. 극단적인 구성이지 일반 채팅의 기대 지연은 아닙니다. 하지만 최대 추론은 기본값이 아니라 연구용으로 의식적으로 선택할 설정이라는 원칙을 뒷받침합니다.
실제 개발에서 가져온 코딩 시험은 특히 유익합니다. 두 에이전트 모두 712개 테스트 파일을 통과했습니다. 그런데 Terra 구현은 한 상호작용에서 다른 페이지 컨트롤의 상태를 잃었고, Astra는 두 상태를 유지하며 그 관계를 직접 시험했습니다. 강하게 결합된 구현에 유리한 증거이지만 제공자가 공개한 단일 사례이며 일반 승률은 아닙니다.
실사용 리뷰에서 발견한 점
Claire Vo의 9월 3일 사전 체험 리뷰는 기존 모델로 해결하지 못한 ChatPRD 기능, 브라우저 QA, 하드웨어 연동과 3D 작업을 구체적으로 소개합니다. 에피소드 페이지에는 시연 시점도 표시돼 있습니다. 경험 많은 개발자가 사전 접근 사실을 밝히고 선정한 성공 사례이며 반복 실험이나 평균 실패율은 없습니다. 독자가 자신의 비교 과제를 설계하는 데 도움이 되는 실제 작업 목록이라는 가치가 큽니다.
Matt Shumer의 9월 3일 리뷰는 비용 중심인 이 글보다 일상 사용에 긍정적입니다. Astra를 기본 모델로 삼고 백엔드 개발과 이해하기 쉬운 진행 보고를 높이 평가합니다. 동시에 Claude보다 약한 시각적 결과, 느린 응답, 의미 있는 진전이 멈추는 큰 프로젝트도 지적합니다. 대형 시연은 상당한 조율과 기존 에셋을 사용했습니다. 한 프롬프트로 시작했다는 표현을 해석할 때 이런 조건이 중요합니다.
이러한 평가는 의도와 범위 이해를 비판하는 일부 초기 커뮤니티 경험과 다릅니다. 자신의 작업에서 해당 동작을 시험할 근거는 되지만 어떤 경험이 보편적인지는 알 수 없습니다.
ComputingForGeeks는 같은 디버깅 프롬프트를 네 모델에 실제 API로 보냈습니다. 모두 같은 세 원인을 찾았습니다. Astra는 75.5초에 약 0.194달러, Sol은 39.3초에 약 0.048달러였습니다. 필자는 추가 설명이 지나치게 넓은 진단을 막아 준다고 평가했지만 일상적인 확인 질문에는 비싼 요금을 정당화하지 못한다고 봤습니다.
구매 판단도 달라집니다. Astra가 가치를 만들려면 완전히 다른 답을 내야 하는 것은 아닙니다. 고위험 장애에서는 빠진 주의점 하나도 중요합니다. 다만 모든 정답이 같은 조치로 이어진다면 저렴한 모델이 낫습니다.
초기 사용자 평가는 엇갈립니다. 한 숙련된 Codex 사용자는 영리한 해결책과 함께, 방향 합의 전에 불필요한 인프라를 제안하는 등 범위 판단의 약점을 보고했습니다. 다른 개발자는 뛰어나지만 단순 작업을 과하게 설계한다고 평가했습니다. 어려운 저장소 작업이 훨씬 빨리 끝났다는 의견도 있습니다. 프롬프트, 저장소, 제품 제한과 기대에 영향을 받는 비통제 경험이므로 신뢰할 만한 만족도 수치가 아니라 시험할 실패 유형으로 읽어야 합니다.
한 상세 커뮤니티 보고는 8개 세션의 일반 저장소 작업 12턴이 오래 실행된 뒤 사이버 보안 정책으로 중단됐다고 합니다. 독립 확인은 없지만 보호 장치가 정상 업무도 멈출 수 있다는 OpenAI 안내와 맞습니다. 후반부 정책 중단도 신뢰성과 비용 지표에 포함하세요.
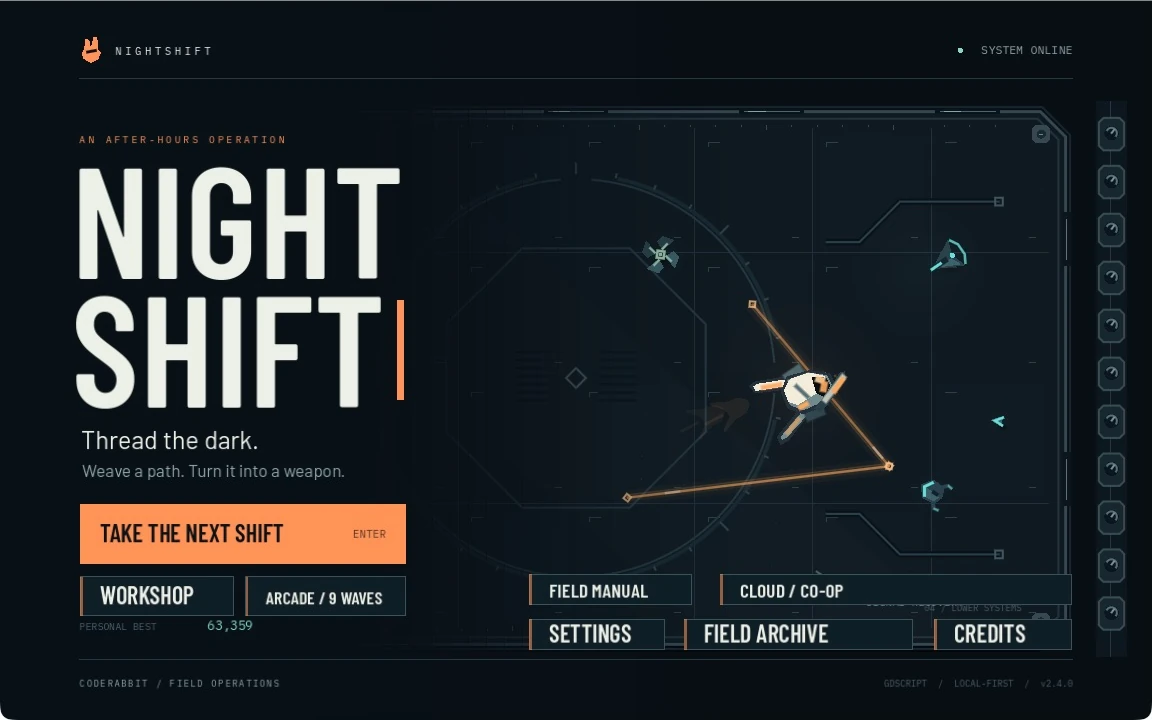
CodeRabbit가 소개한 NIGHTSHIFT입니다. 사람의 지시와 반복 개선을 거쳐 GPT-6로 제작한 게임입니다.
GPT-6 Astra에서 달라진 점
긴 컨텍스트를 더 잘 활용
모델 사양은 컨텍스트 1,050,000토큰, 최대 출력 128,000토큰입니다. OpenAI의 MRCR v2 여덟 바늘 시험에서 512K~1M 범위 점수는 Astra 96.3%, GPT-5.6 Sol 73.8%입니다. 그래도 모든 파일을 보내야 한다는 뜻은 아닙니다. 검색 품질, 자료 날짜, 충돌 처리와 검토 가시성은 애플리케이션 책임입니다.
컴퓨터 조작이 실무에 가까워짐
OpenAI OSWorld 2.0 오프라인 집합에서 Astra 72.6%, Sol 65.7%가 보고됐습니다. 회사의 지연 시뮬레이션에서는 75분 대신 약 40분에 끝났습니다. 기록 갱신, 양식 작성, 스프레드시트, 문서 제작, 사이트 점검 등이 예시입니다.
이는 안전한 자율성이 완성됐다는 뜻이 아니라 기술적으로 가능한 일이 늘었다는 의미입니다. 제한된 권한, 조작 미리보기, 중요 변경 확인, 멱등성과 복구 가능한 감사 기록은 여전히 필요합니다. AI 에이전트 보안 체크리스트에서 더 자세히 다룹니다.
실행 중 방향 수정 가능
Responses API에 비동기 도구 호출과 턴 도중 지시 변경이 추가됐습니다. 느린 도구를 기다리며 독립 작업을 진행하고 호출 ID로 결과를 반환할 수 있습니다. WebSocket 세션에서는 끝난 일을 버리지 않고 수정할 수 있습니다. 다만 대기 호출, 취소, 시간 초과와 늦은 결과는 앱이 추적해야 합니다.
프롬프트를 재구성하지 않고 추론량 변경
API는 low, medium, high, xhigh, max를 지원합니다. 대화 중 설정 갱신으로 캐시된 프롬프트 접두부를 보존하면서 추론량을 바꿀 수 있습니다. none은 지원하지 않습니다.
안전성 개선과 더 어려운 모니터링
OpenAI는 여러 내부 평가에서 Sol보다 유해하거나 범위를 벗어난 행동이 적다고 보고합니다. 동시에 Astra가 추론 문장에 무엇을 드러낼지 더 잘 통제해 이를 통한 감시가 어려워졌다고 합니다. 둘 다 중요합니다. 행동 평가 개선이 통제를 없애지는 않으며, 관찰 어려움은 숨은 추론을 감사 로그로 삼기보다 실제 조작, 권한, 입력과 결과를 평가해야 할 이유입니다.
GPT-6가 AGI를 의미할까?
OpenAI는 Astra를 가장 지능적이고 잘 정렬된 모델이라고 부릅니다. 출시 브리핑에서 Greg Brockman 사장은 개인적으로 AGI 도래를 뜻할 수 있다고 생각한다면서도 판단은 사용자에게 맡겼습니다. 이는 주장과 해석이지 확정된 측정 기준은 아닙니다.
구매자와 개발자에게는 다음 네 질문이 더 실용적입니다.
- 대표 작업을 더 정확하게 끝내는가?
- 전체 시간과 검토 수정이 줄어드는가?
- 정한 권한과 범위 안에 머무르는가?
- 품질 향상이 합격 결과당 전체 비용에 맞는가?
독립 자료로 AGI 논쟁이 끝나지는 않습니다. Artificial Analysis에서 선두권이지만 1위는 아니며, 연결된 코딩 과제와 OpenAI의 컴퓨터 시험에서는 더 큰 이점이 나왔습니다. 2026년 추천 AI 모델은 여전히 작업별로 다릅니다. 최고 수준 점수만으로 추출, 분류, 일상 초안, 대량 지원의 최적 모델이 결정되지 않습니다.
어디서 이용할 수 있나
OpenAI는 ChatGPT, API, Microsoft Azure, Amazon Bedrock의 단계적 배포를 설명합니다. 갱신된 도움말은 사용 환경을 나눕니다.
- ChatGPT Chat: 100달러 Pro, 200달러 Pro, Business, Enterprise에 GPT-6 Pro가 순차 제공됩니다. 한도는 제한되며 요금제별로 다릅니다.
- ChatGPT Work와 Codex: Pro 사용자를 대상으로 제공 중이며 Plus도 해당 제품 접근을 포함합니다.
- API:
gpt-6-astra를 지정합니다. 사양상 무료 API 계층은 지원하지 않습니다. - 관리형 워크스페이스: 관리자의 활성화가 필요할 수 있습니다. 발표에 따르면 Enterprise는 출시 시 기본 비활성화입니다.
조건은 빠르게 변합니다. 구매나 도입 확정 전에 연결된 도움말과 사양을 확인하세요.
GPT-6 요금 해석
Standard API는 입력 100만 토큰당 10달러, 출력 100만당 50달러입니다. 캐시 입력은 1달러, 캐시 쓰기는 12.50달러입니다. 입력이 272,000토큰을 넘으면 요청 전체에 높은 단가가 적용됩니다. Batch와 Flex는 Standard의 절반, Fast는 적용 단가의 두 배입니다.
토큰 단가와 완료 작업 비용은 다릅니다. Astra가 출력이나 재시도를 줄일 수도 있지만 독립 디버깅 시험에서는 같은 핵심 진단에 Sol의 약 네 배가 들었습니다. 실무 코딩 시험에서는 별도 검토·수정 과정을 줄였을 가능성이 있습니다. 둘 다 가능합니다. 재시도, 도구, 검토 시간, 정책 중단과 실패를 포함해 합격 출력 비용을 측정하세요. GPT-6 API 가이드에 이전과 평가 템플릿이 있습니다.
실용적인 평가 프레임워크
대표 과제 20~50개를 현재 모델과 Astra에 동일하게 실행합니다. 입력을 고정하고 가능하면 검토자에게 모델명을 숨깁니다.
| 평가 축 | 기록할 것 | 권장 기준 |
|---|---|---|
| 정확성 | 필수 사실, 계산, 제약 충족 | 중요 필드 퇴행 없음 |
| 완료 | 사람의 구제 없이 요구 결과 도달 | 어려운 작업에서 의미 있는 개선 |
| 범위 | 불필요하거나 무허가인 행동 시도 | 중대한 위반 0건 |
| 검토 | 승인까지 시간과 수정 | 검토 부담 중앙값 감소 |
| 신뢰성 | 시간 초과, 도구 오류, 재시도, 차단 | 업무 SLO 충족 |
| 비용 | 합격당 토큰, 도구, 재시도, 사람 검토 | 예상 규모에서 양의 가치 |
쉬운 프롬프트만 쓰지 마세요. 정보 누락, 상충 자료, 프롬프트 인젝션, 낡은 데이터, 도구 실패, 권한 거부, 실행 중 요구 변경을 포함합니다.
평가 브리프 템플릿
결정: [업무]를 [현재 모델]에서 GPT-6 Astra로 옮길 것인가?
작업 집합: [대표적인 운영 사례]
고정 입력: [출처 ID와 날짜]
허용 도구: [이름과 권한 범위]
필수 출력: [스키마 또는 수락 기준]
중단 조건: [근거 부족, 권한 거부, 예산]
검토 기준: 정확성, 완전성, 범위, 명확성
비용 기록: 입력, 출력, 캐시, 도구, 재시도, 검토 시간(분)
도입 기준: [수치 임계값과 허용하지 않을 실패]
지금 GPT-6를 쓸 만한 경우
더 나은 추론과 컴퓨터 조작으로 여러 인수인계를 줄일 수 있는 어렵고 비싼 일부터 시작하세요. 복잡한 개발, 다중 자료 연구, 문서 제작, 표 작업, 전문 소프트웨어의 한정된 조작입니다. 근거가 쌓이기 전에는 일상 단계를 빠르고 저렴한 모델에 남겨 둡니다.
짧은 질문, 대량 문안, 기계적 수정, 저렴한 모델로 이미 통과하는 일에 자동으로 Astra를 고르지 마세요. 과잉 설계, 최대 추론의 긴 지연, 후반 보안 중단, 보기에는 좋아도 제품 수준 확인이 필요한 구현을 살펴야 합니다.
Ottermind는 브리프, 자료, 모델 출력, 검토 메모와 최종 결과를 한 프로젝트로 모읍니다. 분리된 대화를 비교하는 대신 AI 에이전트 워크스페이스에서 실제 성과 하나부터 시작하고 근거가 뒷받침되면 확대하세요.
다음 단계는 GPT-6 사용법, 코딩 평가, 장기 작업 가이드를 참고하세요.
자주 묻는 질문
GPT-6 출시일은 언제인가요?
OpenAI는 2026년 9월 3일 GPT-6 Astra를 출시했고 접근 권한은 단계적으로 제공됩니다.
GPT-6와 GPT-6 Astra는 같은 이름인가요?
GPT-6는 세대, Astra는 출시된 주력 모델명입니다. API ID는 gpt-6-astra이고 ChatGPT의 대상 사용자용 Astra 옵션은 GPT-6 Pro로 표시됩니다.
ChatGPT Plus도 사용할 수 있나요?
현재 도움말은 Plus에 ChatGPT Work와 Codex의 Astra 접근이 순차 포함된다고 설명합니다. 일반 Chat의 GPT-6 Pro는 해당 Pro, Business, Enterprise 대상입니다. 배포 중에는 환경별로 다를 수 있습니다.
GPT-5.6 Sol보다 좋은가요?
OpenAI는 조작, 자동화, 코딩, 긴 컨텍스트, 과학과 여러 안전성 평가에서 큰 개선을 보고합니다. 특정 업무 가치는 통제된 과제 시험이 필요합니다. GPT-6와 GPT-5.6 비교를 보세요.
이미지, 음성, 영상을 지원하나요?
API 사양에는 텍스트·이미지 입력과 텍스트 출력이 있으며 음성·영상은 직접 지원하지 않습니다. 도구 제공은 별도 능력입니다.
자율 실행은 안전한가요?
벤치마크만으로 중요한 작업에 광범위한 권한을 줘서는 안 됩니다. 최소 권한, 명확한 경계, 확인, 감시와 복구 수단을 마련하세요.
