
Sora プロンプト
一続きの一文として書かれたSoraのプロンプトをコピーし、カメラはシンプルな動き1つに絞り、アニメーションの前にフレームを生成します。
そのままコピーできるSoraプロンプト3つ
このスタイルの公開例はどれも同じ形です。何が起きるか、どこで、どう照らされ、どう撮られるかを一続きの一文で示します。この3つは、動くショット、単一の動作、2つの画角のシーケンスにその形を当てはめたものです。
動くショット
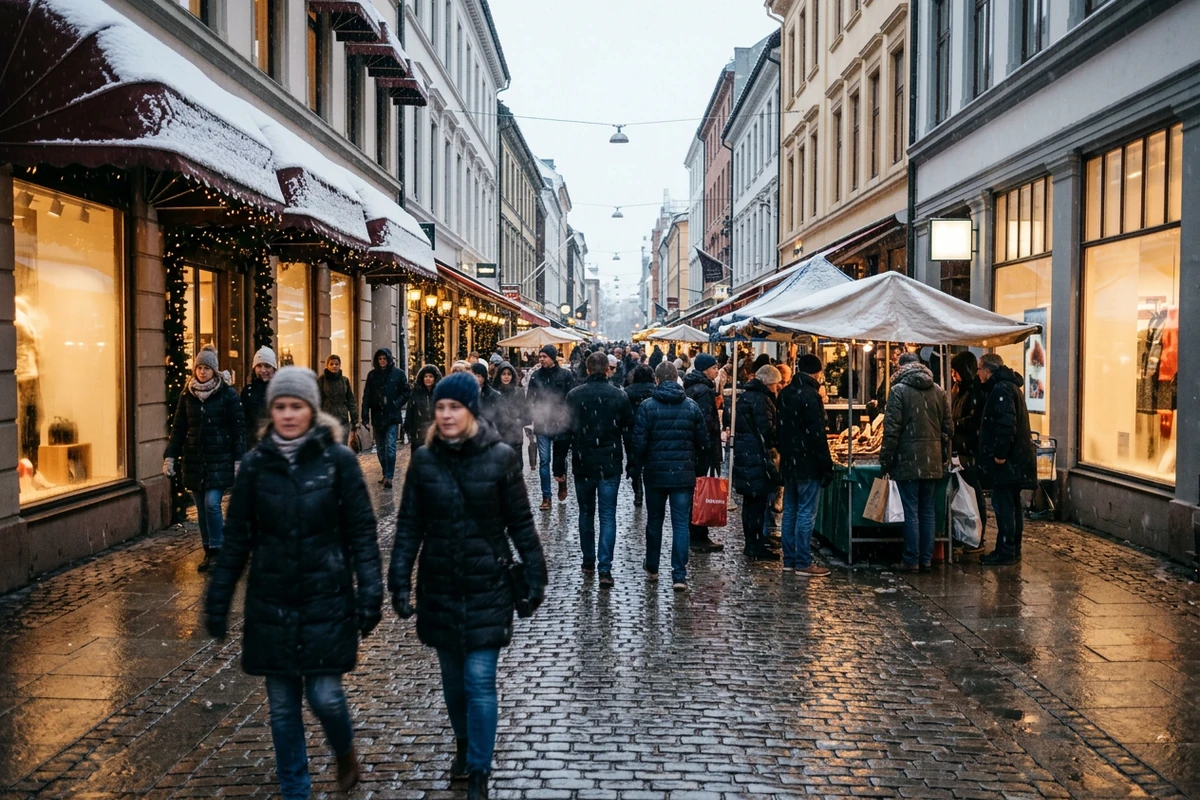
カメラが、小雪の舞う賑やかな商店街を前へ進んでいきます。冬のコートを着た何人かが屋台の横をゆっくり歩き、息が白く見え、雪が日よけと濡れた石畳に積もり、曇ったガラスの向こうに店の暖かい明かりがともっています。曇った午後の遅い光で、暖色のアクセントは店先だけ。広角レンズ、深いピント、自然な色、写真のような写実性。読める文字とウォーターマークは入れないでください。
単一の動作
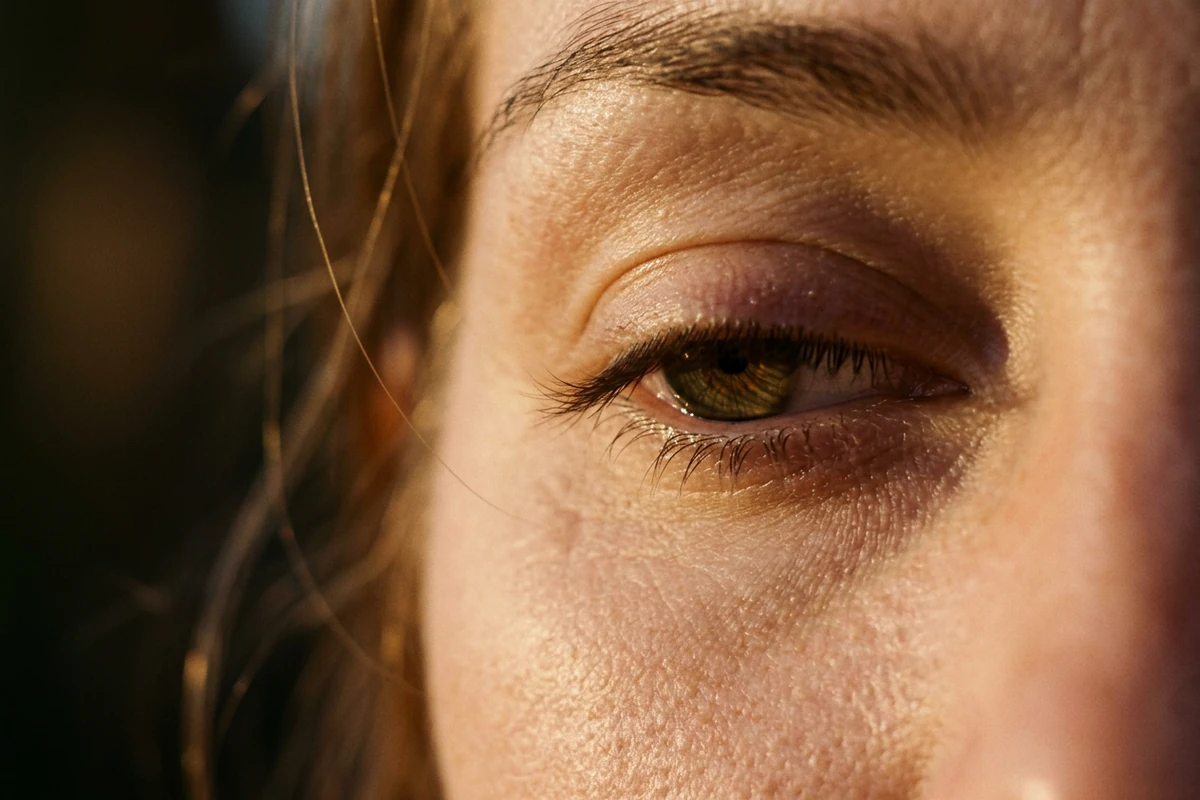
まばたきの途中にある女性の目を極端な寄りで捉えます。まつげは開くと閉じの間にあり、横から差す低く暖かい夕日が虹彩に小さな光点を作り、他はすべて柔らかな影に落ちます。マクロレンズ、非常に浅い被写界深度、実物の肌の質感。動作はまばたき1つだけで、画面に他の動きはありません。自然な色。読める文字とウォーターマークは入れないでください。
2つの画角のシーケンス
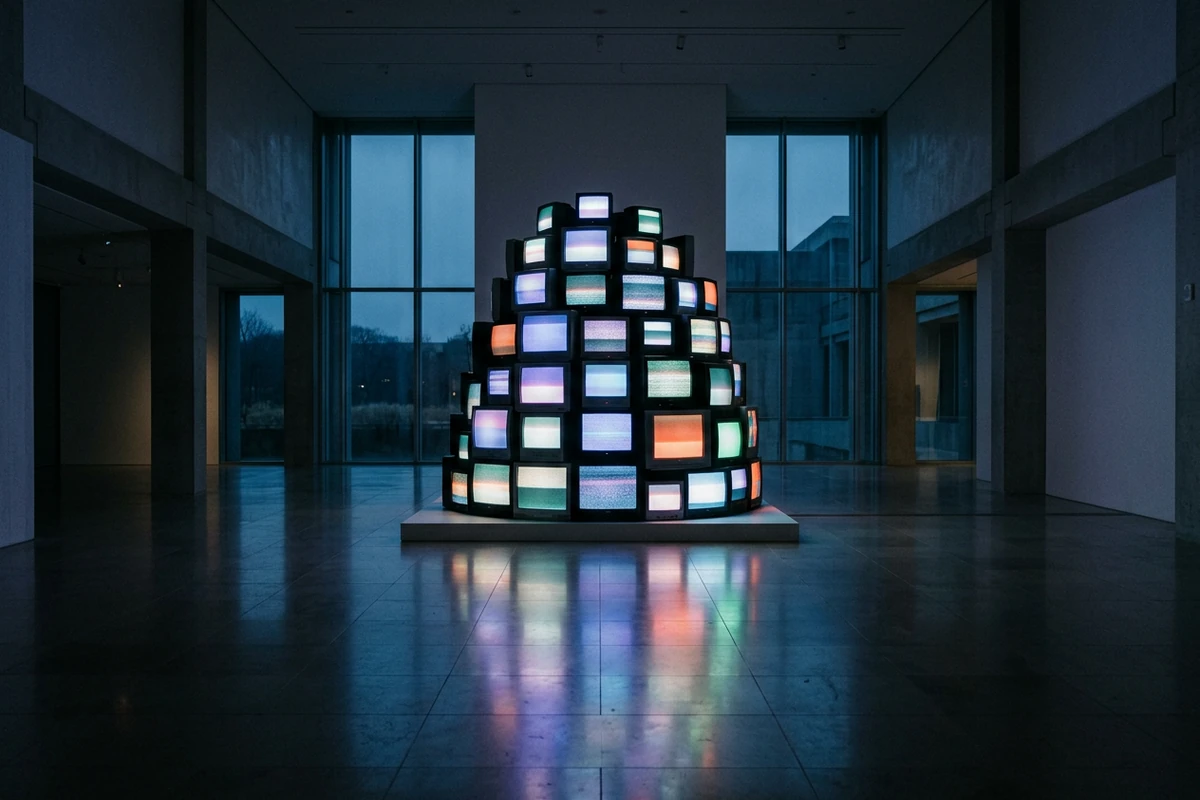
夜の大きな美術館のギャラリー。部屋の中央の台座に古いテレビが高く積まれ、どの画面もついていますが、抽象的な色の光と淡いノイズだけが映っています。ショットはギャラリー全体を広く開き、それからその積み山へ近づき、両方の画角で同じ冷たい青い環境光と同じ見た目を保ちます。磨かれた床が光を映し、人はおらず、どの画面にも読める内容はなく、ウォーターマークもありません。
一文を、順番どおりに読む
このモデルで使われるプロンプトの型は、パラメータの一覧ではありません。説明的な一文として読まれ、失敗するのは、モデルが苦手だと公表している内容を求めた部分です。
被写体、次に何が起きるか、どこで、光、そしてレンズ
被写体、次に何が起きるか、次にどこで、次にどう照らされ、最後にどう撮られるか。公開例はスタイル語をカンマで積むのではなくこの順序をたどり、順序があることでどの部分を変えればよいかが明らかになります。AIプロンプトジェネレーター は断片の一覧をこの一文に組み直します。
カメラはシンプルな動き1つに絞る
カメラの指示は最も誤読される部分です。記述されたカメラの軌道はモデルが取り違えるものだと報告されているため、前へ進む、一度回り込むといった明確な動き1つのほうが、方向の連続より有効です。画像から動画AI はその動きをすでに固定したフレームから始めます。
公表されている苦手分野を避けて書く
公開のレビューは、物理シミュレーションと因果関係が苦手で、空間と出来事の細部も弱いと報告しています。ですから動作は1つに絞り、空間はほのめかさず明示し、互いに依存する出来事をつながないでください。無料AI写真動画化 はそんなショットを安く試せます。
OttermindでSoraプロンプトを書く方法
ステップ1:一文として書く
被写体、その1つの動作、場所、光、レンズをこの順に書き、そこで止めます。2つ目の動作が要るなら、それは実際には2つのショットです。AIプロンプトジェネレーター がこの構造を保ちます。
ステップ2:まず冒頭のフレームを生成する
ショットを静止画として生成し、動画のレンダリングを使う前に光とレンズを確認します。画像から動画AI は承認したそのフレームを動かし、認めた見た目を保ちます。
ステップ3:動きを1つ入れてテイクを比べる
クリップにカメラの動きを1つだけ与え、テイク間で残りの文言を同一に保ちます。そうすれば良くない結果を1つの語句に帰属できます。AIリール作成ツール がテイクを順に保持します。
2回目の指示が効く場面
同じショットを他の人や別のモデルが再現できるほど明確に説明しなければならないとき、一文の動画プロンプトが効いてきます。
短いSNSクリップ
明確な動作を明確な空間に1つ置く形は、短い縦のカットに耐えます。プロンプトに、モデルが曖昧に解釈できる要素が残らないからです。その一文を書き、テイクの順序は AIリール作成ツール に任せます。
レンダリング前の絵コンテ
動画のレンダリングは高くつく工程なので、まずショットを静止画として組み、光と画角が意図を言えているか確認します。AI動画デモ作成 は本番レンダリング前の速い確認です。
引き継ぐショット
ブリーフが他の人や別のモデルへ渡るとき、光とレンズを名指しした一文のプロンプトなら、意図を聞き返されずにそのまま実行できます。無料AI写真動画化 は静止画を共通の出発点として残します。
Soraプロンプトのよくある質問
Soraのプロンプトはどれくらいの長さの動画を書けますか?
公開のレビューは1分程度までの動画に触れていますが、明確な動作を明確な空間に1つ置くほうが、1分の出来事の連鎖より整合を保ちやすいです。一文で説明できるショットを書いてください。画像から動画AI はそれぞれを承認したフレームに固定します。
カメラの指示が無視されるのはなぜですか?
記述されたカメラの軌道は、モデルが読み違えるものだと報告されているからです。方向の連続を、前へ進むといったシンプルな動き1つに置き換え、他はそのままにします。そうすればカメラの語句だけが変数になります。AIプロンプトジェネレーター はその語句だけを書き直します。
このモデルが苦手なことは何ですか?
公開のレビューは、物理と因果関係が苦手で、空間と出来事の細部も弱いと報告しています。動作を1つに絞り、空間を明示し、後半が前半に依存するプロンプトを避けてください。無料AI写真動画化 なら安く試せます。
プロンプトは一文と複数文のどちらにすべきですか?
公開例での慣例は一続きの一文で、ショットの読まれ方に対応します。被写体、動作、場所、光、レンズです。画角のシーケンスには複数文が向き、モデルはそれを複数のショットとして一貫した見た目で保持できます。AI動画生成 がそのレンダリングを実行します。
無料で試せますか?
Ottermindの公開版はサインインなしで使え、無料の試行回数が限られた範囲で含まれます。アカウントのクレジットやプランの上限は別途適用される場合があります。まず静止画として試すと、1回で通るか分かります。AI画像生成 で展開してください。
このページは公式ですか。これらの記述の根拠は?
いいえ、このページはモデルの提供元と提携しておらず、承認も受けていません。提供元の資料もここには転載していません。制作の記述は公開された作例集に共通するプロンプトの形を述べたもので、限界についての記述は公開のレビューがすでに報じている内容の要約です。
その一文をショットに変える
一文を書き、フレームを生成し、カメラの動きを1つだけ入れて、書いたとおりに読めるまでその語句だけを変え続けます。