モデル比較
GPT-6とGPT-5.6を比較:実務でAstraとSolをどう選ぶか
最も難しい複数段階の仕事にはGPT-6 Astraが有力です。一方、最高性能より待ち時間、利用しやすさ、費用を重視するならGPT-5.6 Solが実用的な標準になります。 OpenAIの結果では、Astraの改善が大きいのは操作、自動化、長いコンテキストの検索、科学、サイバーセキュリティです。どのプロンプトも同じ恩恵を受けるわけではありません。
型番ではなく、合格した仕事の費用で判断してください。日常の依頼がGPT-5.6ですでに正確・高速・安価なら、GPT-6は費用を増やすだけかもしれません。ツール調整、複雑な推論、長い資料、専門的成果物で何度も失敗するなら、Astraを統制した条件で試す価値があります。
出典: GPT-6公開発表; モデル仕様; 開発者ガイド; 安全性の概要; Artificial AnalysisのAstra評価; GPT-5.6 Sol比較; APIデバッグ実測; 実務由来のコーディング比較。2026年9月7日確認。
比較の要点
| 判断項目 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| 得意な用途 | 難しい一連の仕事 | 低い運用費で幅広い仕事 |
| コンテキスト | 1,050,000トークン | 利用するバージョンの最新仕様を確認 |
| 最大出力 | 128,000トークン | 利用するバージョンの最新仕様を確認 |
| 推論量 | Lowからmax、noneなし | 製品別の設定を含む幅広い制御 |
| 新しい機能 | 非同期ツール、ターン途中の指示、会話中の推論変更 | 既存のツールとResponses APIの仕組み |
| Standard API入力 | 100万トークン当たり10米ドル | より安価。最新料金を確認 |
| Standard API出力 | 100万トークン当たり50米ドル | より安価。最新料金を確認 |
| 利用条件 | 段階的提供、無料API層なし | 対象のOpenAI製品でより広く利用可能 |
| 独立知能評価 | maxで55 | maxで51 |
| 独立実測の出力速度 | maxで毎秒64.3トークン | maxで約76トークン |
| 独立指標の課題費用 | maxで2.57米ドル | maxで1.25米ドル |
| 運用上の方針 | 高価値の難しい仕事から導入 | 日常・混合タスクの基準として維持 |
独立測定はArtificial Analysisの時点データで、提供者やテストの更新で変わります。一般的知能の差は控えめで、出力は遅く、課題費用は約2倍です。すべての用途で世代が変わるほどの差を示すわけではありません。購入計算には最新仕様を使ってください。
独立試験と公開時の説明
Claire Voの先行利用記録は、SolやFableで苦戦したChatPRD機能が前進したと述べています。行き詰まった仕事で試す理由にはなりますが、選ばれた成功だけではSolに対する平均的な差は分かりません。同じ依頼、リポジトリ状態、受け入れ基準を残して比較しましょう。
Matt Shumerのレビューは日常開発にAstra、視覚的な仕事にClaudeを選んでいます。会話しやすさと監督の減少が生成速度より重要なら、高いモデルを標準にする理由になるという例です。ただし、個人的評価であって統制された比較ではありません。
本記事の推奨は、予算を管理するチーム向けです。機能する現行構成を保ち、人の介入が多い仕事から試します。異なる業務の個人が別の判断をするのも合理的です。
OpenAIの大きな改善は、エージェント、操作、長いコンテキストの評価に集中しています。Artificial Analysisの一般評価ではAstra maxが55、Sol maxが51です。Astraの出力総量は同サービスの中央値より少ないものの、Solより出力が遅く、maxでの最初のトークン待ちも長くなっています。
APIのデバッグ試験ではAstraと3種類のGPT-5.6が同じ原因を診断しました。Astraは留保と確認計画が優れていましたが、時間は約2倍、費用は約4倍でした。注意点を落とすと高額なミスになる仕事には意味があり、単にコマンドや原因候補を知りたい場合には向きません。
別の実務由来試験はSolではなくGPT-5.6 Terraとの比較です。両実装とも既存テストを通過しましたが、Terraは関連ページング状態を壊し、Astraは保存して検証を追加しました。作者は密接につながる複数領域の仕事をAstraへ、通常・機械的変更を安価なモデルへ振り分ける方針に変えました。全モデルを置き換えるより根拠のある運用です。
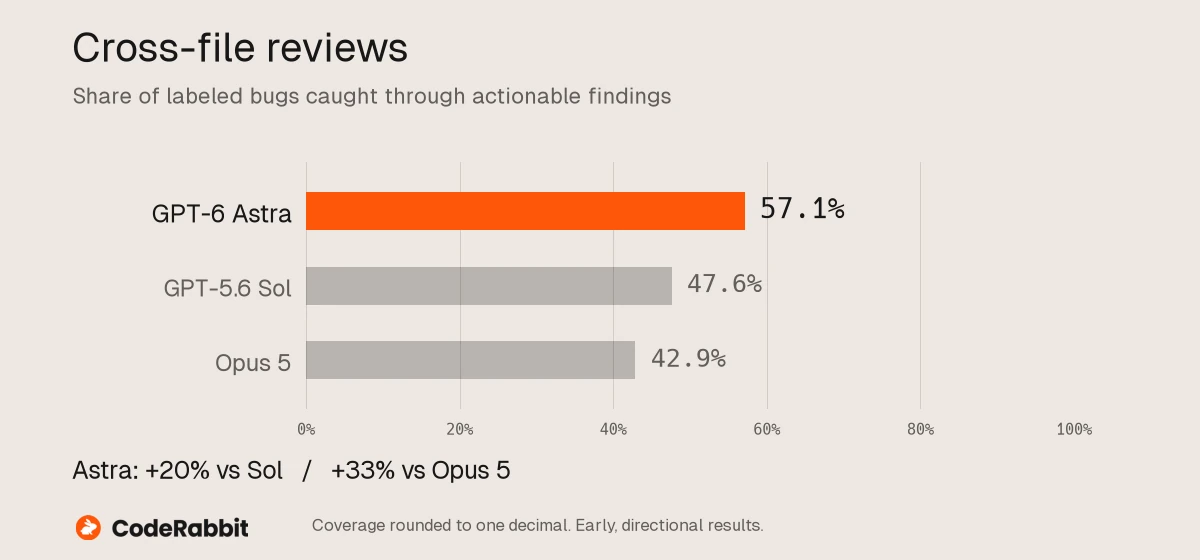
CodeRabbitが公開したファイル横断レビューの結果です。初期評価であり、レビュー品質全体の指標ではありません。
改善が特に大きい領域
OpenAIの公開時評価は同じ組織が両モデルを試しているため、条件をそろえた比較として有用です。ただし内部試験もあり、各推論設定の最高点が使われ、本番の指示やツールによって結果は変わります。
| 評価 | GPT-6 Astra | GPT-5.6 Sol | 示唆されること |
|---|---|---|---|
| OSWorld 2.0オフライン | 72.6% | 65.7% | デスクトップ環境の操作向上 |
| AutomationBench | 41.4% | 18.1% | 多段階自動化の大きな改善 |
| Terminal-Bench 4.0 | 57.9% | 37.3% | ターミナルでの開発能力向上 |
| 内部DB移行タスク | 63.9% | 42.7% | 状態を扱う長いコード変更への期待 |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 高度な数学推論の強化 |
| MRCR v2、512K〜1M | 96.3% | 73.8% | 非常に長い資料からの取得改善 |
| ARC-AGI-3 | 99.9% | 7.8% | 新しい対話的課題での大きな改善報告 |
全指標ですべての競合を上回るわけではありません。DataCampの解説は、ツール付きHumanity's Last ExamでClaude Fable 5.1に届かないこと、ARC-AGI-3の99.9%は状態保持と提供者アダプターを使う実行基盤に依存することを指摘します。ステートレスなAPI呼び出しで同じ点を期待すべきではありません。導入を即決する材料ではなく、試す領域を選ぶ材料にしましょう。
コンピューター操作とエージェント業務
これがGPT-6を評価する最大の理由です。コード、ブラウザー、文書、表計算、プレゼン、専門ソフトをまたぐ作業向けに作られています。非同期呼び出しで遅いツールを待つ間も独立推論を続け、ターン途中の修正で長いセッションを再起動せず方向転換できます。
Solもすでにツールとエージェント業務を扱えます。短い手順、限定的権限、十分な品質なら維持しましょう。進行を忘れる、新指示を誤解する、複数ソフト間で苦戦する、再試行が多いならAstraを試します。
モデルが強くても周辺設計は残ります。認証、ツールのスキーマ、認可、状態、監査、承認、ロールバックはアプリの責任です。AIエージェントのアーキテクチャでこの境界を説明しています。
コンテキストと記憶は別物
Astraの105万トークン枠には多くの資料が入りますが、リクエスト時の一時的容量です。顧客、プロジェクト、規則について持続的で正しい記憶が自動的に作られるわけではありません。長期記憶には資料ID、更新規則、矛盾解消、削除、アクセス制御、利用者への可視化が必要です。
まとめて検討すべき限定資料には長いコンテキスト、大規模で変動する資料には検索、実行を越えて保持する決定や承認済み成果には永続的なプロジェクト状態を使います。AIナレッジ管理ガイドは、生成要約を正本とみなさず、出所を保存する方法を説明します。
トークンだけでなく仕事の完了費用を比べる
Standard APIは入力100万トークン10米ドル、出力100万50米ドルです。272,000入力トークンを超えると全リクエストに高い料金が適用されます。キャッシュ、ツール、Fast、Batch、Flexはそれぞれ別の料金です。
Astraがトークン、再試行、確認時間を減らすなら、難しい仕事は総額で安くなる可能性があります。一方、大量分類に最高水準の推論が不要なら、完璧な答えでも非経済的です。
デバッグ実測は、Astraが約0.194米ドル・75.5秒、Solが約0.048米ドル・39.3秒という具体的な差を示します。中心診断は同じで、Astraの価値はより正確な留保と検証計画でした。1つのプロンプトでは平均を確定できませんが、効率の主張を補足します。
次のように計算します。
合格タスクの費用 =
  モデル入力 + モデル出力 + キャッシュ + ツール呼び出し
  + 失敗した試行 + レビュー時間 + 修正作業

移行の価値 =
  防げたミス + 削減工数 + 短縮した期間
  - 合格タスク当たりの追加費用
両モデルを同じ入力で測ります。レビュー時間をゼロと見積もらないでください。最大の隠れた費用になることがあります。
安全性と制御
OpenAIは、AstraがSolより脱獄、プロンプトインジェクション、範囲外行動に強いと説明しています。54,000件以上のCodexタスクの内部シミュレーションでは、重大な不整合行動の指摘が約半分でした。一方、書面推論の監視しやすさはSolより低下したと報告しています。
TechRadarが取材した専門家は、推論文に頼るより実際の動作を監視し、途中で止められるようにすべきと述べています。初期コミュニティ報告にも、通常のコード作業が長時間後にサイバー判定で中断された例があります。個別体験ですが、OpenAI自身も正当な作業の中断を警告しています。誤検知による停止と失った時間も測定対象です。
評価には次を含めます。
- 推論が安心できるかではなく、実際の操作と成果を試す。
- 各ツールに限定スキーマと明確な権限を設定する。
- 攻撃的な資料と実現不能な課題を追加する。
- 送信、削除、購入、公開、権限変更に確認を求める。
- 入力、呼び出し、承認、出力、確認者の決定を独立記録する。
どちらにも書き込みを許可する前に、AIエージェント安全チェックを確認してください。
どのモデルを選ぶべきか
Astraが向く場合
- 通常は複数回のやり直しや人への引き継ぎが必要な複雑さがある。
- 操作や複数ツールの調整が成果の中心になる。
- 資料が非常に長く、取得漏れが高くつく。
- 高価値の文書、分析、プレゼン、コード変更を作る。
- 自社の評価で合格成果が測定可能に増える。
Solを維持する場合
- 現行業務が品質と信頼性の目標を満たしている。
- 応答速度や大量処理費用が最優先である。
- 短く反復的、構造的、または検証しやすいタスクである。
- GPT-6の提供条件やレート制限が要件に合わない。
- チームに評価とレビューの仕組みがまだない。
両者に振り分ける場合
多くの本番システムでは二者択一にする必要はありません。安い基準モデルから始め、資料量、リスク、検証失敗、ツール数、希望品質といった観測できる条件で上位モデルに回します。割り当て規則は監査できる簡潔さを保ちます。
比較評価用テンプレート
業務:[名称]
現行モデル:GPT-5.6 Sol
候補:GPT-6 Astra
ケース:[20-50件の代表タスク]

各項目を0-2点で評価:
- 事実と計算の正確性
- 必須制約の充足
- 完全で使える成果
- 許可範囲の遵守
- 資料と不確実性の明示

別途記録:
- 実所要時間
- 入力/出力/キャッシュ/ツール費
- 再試行と失敗
- レビュー分数と修正

導入条件:
- 重大な安全・範囲の退行がない
- 品質差が統計的にも実務的にも意味を持つ
- 合格成果の費用が想定量に見合う
実用的な導入手順
- 代表入力と受け入れ基準を固定する。
- 同等のツールと権限で両モデルを実行する。
- 可能ならレビュー者からモデル名を隠す。
- 平均だけでなく失敗を調べる。
- 対象業務の少量をAstraに割り当てる。
- 費用、修正、事故、利用者の介入を追う。
- 継続して価値がある領域だけ拡大する。
Ottermindでは元資料、比較出力、レビュー判断、最終成果を1つのプロジェクトに保存できます。AIエージェントのワークスペースで業務全体を評価し、別々の会話のスクリーンショットを集めるだけで終わらせないようにしましょう。
よくある質問
Astraは常にSolよりよいですか?
いいえ。多くの評価で能力は上ですが、Solのほうが速く、安く、使いやすく、日常業務には十分な場合があります。
APIの高い料金に見合いますか?
難しい作業でやり直し、レビュー、失敗を減らせるなら見合います。ツールと人の作業も含めて合格成果当たりで計算します。
GPT-6はGPT-5.6を置き換えますか?
自動的には置き換えません。OpenAIはGPT-5.6も提供しています。日常をGPT-5.6、最難関をGPT-6へ回す構成が考えられます。
コードにはどちらがよいですか?
OpenAIはTerminal-Bench 4.0などでAstraの高得点、特にDB移行の大きな改善を報告しています。自分のリポジトリ、指示、CI条件で両方試してください。
長い文書にはどちらが向きますか?
Astraは105万トークン枠と、OpenAI報告の優れた長文検索を備えます。文書選択、引用、矛盾処理、人の確認は別途必要です。
移行時に同じプロンプトを使えますか?
公平な基準のため同じ依頼から始め、失敗を確認してから調整します。GPT-6 APIガイドに移行チェックリストがあります。
