Guide d’achat
Meilleurs outils d'observabilité de l'IA : choisir pour les agents et workflows LLM
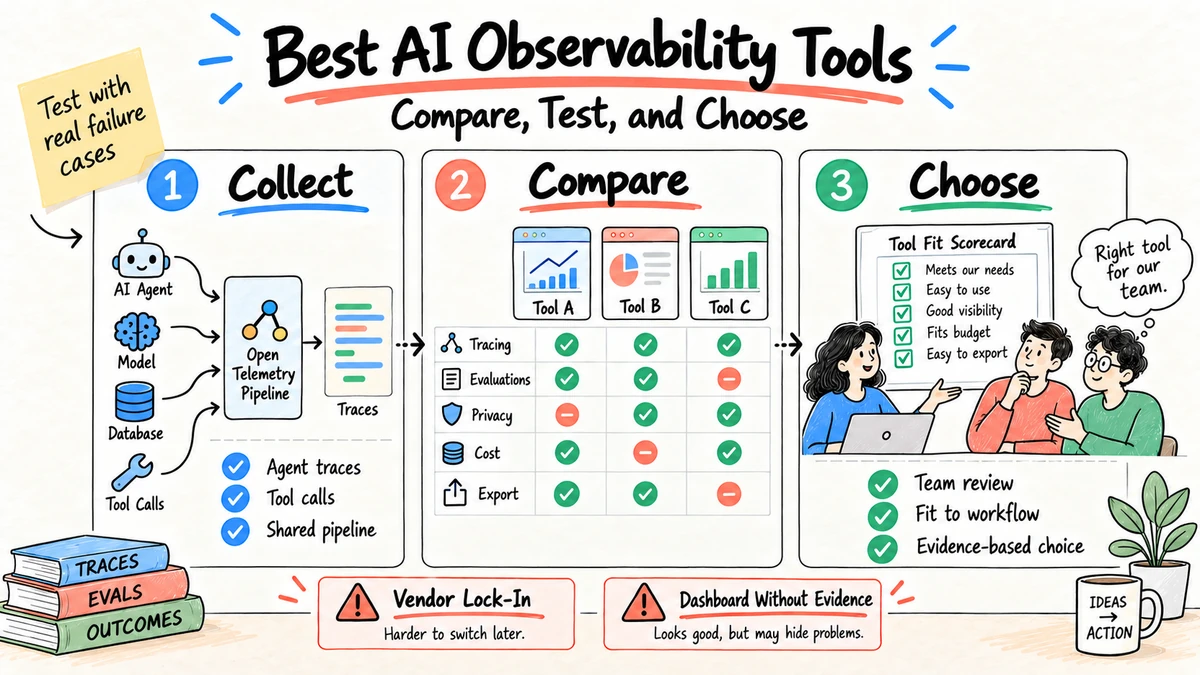
Le meilleur outil d'observabilité de l'IA est celui qui relie un échec de production à la version exacte de l'exécution, du prompt ou du modèle, du résultat de récupération, de l'appel à l'outil, de l'évaluation et du résultat de l'utilisateur. Choisissez parmi les exigences, pas la liste de fonctionnalités la plus longue. La plupart des équipes ont plus besoin de traces interopérables, d'évaluations spécifiques aux tâches, de contrôles de confidentialité et d'un chemin d'exportation qu'elles n'ont besoin d'un autre tableau de bord générique.
Recherche et transparence: Ce guide utilise la documentation publique d'OpenTelemetry, LangSmith, Arize Phoenix, Braintrust et Datadog, consultée le 4 septembre 2026. Ottermind n'est pas classé comme fournisseur d'observabilité. Les fonctions et forfaits évoluent; vérifiez-les avec un essai représentatif.
Liste restreinte par besoin d'exploitation
| Le besoin | Outils d'évaluation | Pourquoi ils sont inscrits sur la liste de choix ? |
|---|---|---|
| Télémétrie ouverte et inspection locale | OpenTelemetry plus Arize Phoenix | Instrumentation ouverte et voie d'inspection des traces et des évaluations |
| Développement de LangChain ou de LangGraph | LangSmith | Un flux de travail de suivi, d'ensemble de données et d'évaluation rigoureux pour cet écosystème |
| Iteration du produit d'évaluation | Braintrust | Des expériences, des scores, des ensembles de données et des journaux de production en une seule boucle |
| Surveillance des entreprises existantes | Datadog LLM Observability | Les signaux d'agents aux côtés de l'infrastructure et des incidents d'application |
| Pipeline de données neutres entre les fournisseurs | Collecteur OpenTelemetry plus backend sélectionné | Conventions d'événements portables et contrôle du routage |
Il s'agit d'une liste par ajustement, pas d'un classement universel. Ajoutez les exigences en matière de sécurité, de résidence des données, de conservation, de déploiement et de prix avant de sélectionner un produit.
Sept capacités à tester
1. Traces de bout en bout
La trace doit relier les appels de modèle, la récupération, l'utilisation des outils, les sous-agents, les répétitions et les étapes d'approbation. Vérifiez si le travail asynchrone et les transferts de main restent dans la même exécution.
2. Des expériences en version
Vous devez comparer les modifications de prompt, de modèle, d'outil et de récupération sur le même ensemble de données. Un graphique sans métadonnées de version ne peut expliquer une régression.
3. Évaluation en ligne et hors ligne
Recherchez des contrôles déterministes, des évaluations basées sur des modèles, des évaluations humaines et des résultats commerciaux personnalisés. Confirmez que vous pouvez inspecter les défaillances individuelles derrière un score global.
4. Attribution du coût et de la latence
Le produit doit attribuer des tokens, des coûts et du temps aux étapes et aux outils, et pas seulement à la demande finale. Dans le cas contraire, une boucle de nouvelle tentative peut se cacher à l'intérieur d'une moyenne acceptable.
5. Contrôles de confidentialité
Testez l’expurgation avant exportation, accès par rôle, suivi sans contenu, contrôles de conservation et journaux d'audit. Demandez si les prompts et les sorties sont utilisées pour la formation des fournisseurs.
6. Export ouvert
Confirmer que vous pouvez envoyer ou exporter la télémétrie en utilisant un format documenté. La compatibilité avec OpenTelemetry réduit le coût de la modification des backends et de la connexion des traces d'agents avec la surveillance des applications.
7. Flux de travail opérationnel
Le point final utile est une correction: alerte, inspection, étiquetage, ajout d'un cas de défaillance à un ensemble de données, test d'un changement et vérification du résultat de production. Assurez-vous que l'outil supporte cette boucle sans archéologie de feuille de calcul.
Comprendre les catégories de produits
Normes ouvertes d'instrumentation
OpenTelemetry n'est pas un produit fini d'observabilité en soi. Il fournit des API, des SDK, des collecteurs et des conventions sémantiques qui aident les applications à décrire et à parcourir la télémétrie de manière cohérente. Il fait partie de la liste restreinte lorsque la portabilité, l'infrastructure de surveillance existante ou le contrôle de l'enroulement des données sont des questions.
Testez la maturité de la langue exacte, du fournisseur de modèles et de l'instrumentation du cadre d'agent que vous utilisez. La compatibilité sur une page du fournisseur ne prouve pas que les appels d'outils, le streaming, la récupération, les transferts et les erreurs apparaissent avec les champs dont votre équipe a besoin.
Plateformes de développement d'agents
Des plateformes telles que LangSmith connectent des traces avec le développement rapide ou du flux de travail, des ensembles de données, des expériences, des évaluateurs et des annotations. Ils peuvent raccourcir la distance d'une exécution de production ratée à un test de régression, surtout lorsque l'équipe utilise déjà des cadres connexes.
L'évaluation devrait toujours inclure une application neutre en matière de cadres. Confirmer ce qui fonctionne grâce à l'intégration native, ce qui nécessite une instrumentation manuelle et comment les données peuvent être exportées.
Plateformes d'évaluation en premier
Des produits tels que Braintrust mettent l'accent sur les ensembles de données, les scoreurs, les expériences, les journaux et les comparaisons. Ils conviennent aux équipes qui traitent l'évaluation comme le contrat de mise en production plutôt qu'un tableau de bord occasionnel.
Testez des traces complexes en plusieurs étapes, des annotations humaines, des échantillonnages de production et le chemin d'une correction de l'relecteur à un cas d'essai permanent. Demandez comment les versions de l'évaluateur et les changements du modèle du juge affectent les comparaisons historiques.
Inspection et expérimentation à open source
Des projets tels que Arize Phoenix peuvent appuyer l'inspection et l'évaluation des traces locales ou autogérées. L'open source offre aux équipes des options de déploiement et de personnalisation, mais elles possèdent des mises à niveau, du stockage, de l'authentification, de la sauvegarde, de la disponibilité et de la réponse aux incidents à moins qu'un service géré ne les couvre.
Exécutez la même vérification de sécurité que pour un service commercial. L'auto-hébergement change la responsabilité; il ne l'élimine pas.
Surveillance des applications des entreprises
Des plates-formes telles que Datadog connectent des signaux d'IA avec des traces d'application, des infrastructures, des journaux, la propriété des services et des flux de travail sur appel. Cela peut être décisif lorsqu'une défaillance d'agent traverse les appels de modèle, les API, les bases de données, les files d'attente et les dépendances réseau.
Vérifiez la profondeur des flux de travail d'évaluation et de collecte de données spécifiques à l'agent. Une forte corrélation entre les infrastructures ne fournit pas automatiquement la boucle de qualité éditoriale ou de domaine dont a besoin une équipe de produits.
Ajoutez l'outil à l'équipe
| Situation de l'équipe | Commencez par | Valider avant de s'engager |
|---|---|---|
| Une petite équipe, un prototype d'agent | Outils de traçage natifs ou ouverts légers | Vitesse de débogage et coût d'installation minimal |
| Expédition hebdomadaire de l'équipe de produits | Traçage des expériences et ensembles de données plus versions | Flux de travail de régression et étiquetage de l'relecteur |
| Plusieurs cadres et fournisseurs | Instrumentation compatible avec OpenTelemetry | champs cohérents et portabilité de l'backend |
| Charges de travail réglementées ou sensibles | Service autogéré ou fortement contrôlé | Rédaction, résidence, accès, conservation, vérification |
| Programme d'observabilité des entreprises existant | Extension actuelle de l'APM plus spécifique à l'agent | Profondeur de l'évaluation de la qualité et corrélation des traces |
| Groupe de recherche ou d'évaluation | La première plateforme d'évaluation | Reproducibilité, scoreurs personnalisés, gouvernance des ensembles de données |
Évitez de considérer la taille de l'organisation comme le seul signal. Un petit flux de travail légal peut nécessiter des contrôles de capture plus stricts qu'une démonstration publique à volume élevé, tandis qu'un grand prototype interne peut nécessiter peu d'infrastructures de production.
Cinq scénarios de sélection
Scénario 1: Un agent de support donne une réponse politique incorrecte
Prioritisez les fils à plusieurs tours, les traces de récupération, les métadonnées de la version du document, l'évaluation des citations, l'annotation et un chemin rapide d'une correction utilisateur à une régression. Les mesures d'infrastructure seules ne montreront pas pourquoi la politique dépassée a gagné.
Scénario 2: Un agent de codage consomme un temps et des tokens imprévisibles
Prioritisez les spans d'outils et de modèles nichés, nouvelles tentatives la visibilité et la visibilité en boucle, l'attribution des tokens et des coûts, les événements de la sandbox et la comparaison des itinéraires entre les versions. Testez une exécution qui se termine après avoir changé des fichiers, pas seulement une suggestion de code réussie.
Scénario 3: Un flux de travail de document réglementé
Prioritiser le suivi sans contenu, la expurgation avant exportation, le stockage autonome ou régional, l'accès basé sur les rôles, les journaux d'audit, la conservation et les validations déterministiques. Un outil à moindre coût ne convient pas si les relecteurs ne peuvent pas prouver quelle source et quelle version régissaient le résultat.
Scénario 4: Une équipe de produits compare des prompts et des modèles chaque semaine
Prioritisez les ensembles de données, les expériences, la versionisation des évaluateurs, l'examen des sorties côte à côte, les résumés statistiques et les commentaires sur la production. L'équipe a plus besoin de reproductibilité et de comparaison de changement qu'une interface mature en appel.
Scénario 5: De nombreuses équipes utilisent des cadres d'agents différents
Prioritisez la compatibilité OpenTelemetry, un schéma d'événement commun, le contrôle du collecteur, le suivi neutre du cadre et l'exportation. Testez la cohérence sémantique entre deux cadres; le simple fait d'accepter l'OTLP ne garantit pas de champs d'action comparables.
Utiliser une matrice de décision pondérée
Fixez des poids avant les essais. L'exemple suivant convient à un agent de travail de la connaissance de la production; il l'adapte au risque réel.
| Critère | Poids | Candidat A | Candidat B | Candidat C |
|---|---|---|---|---|
| Exhaustivité des traces | 20 | |||
| Flux de travail d'évaluation | 15 | |||
| Confidentialité et l'accès | 20 | |||
| Débogage et révision de l'utilisabilité | 15 | |||
| Intégration et portabilité | 10 | |||
| Opérations de production | 10 | |||
| Coût total | 10 |
Points chacun de 0 à 5 à l'aide de preuves provenant de la POC. Ajoutez une liste séparée pour les exigences non négociables telles que la région, la suppression, le SSO ou la suppression du contenu. Un score pondéré élevé ne doit pas surpasser une exigence juridique ou de sécurité ratée.
Exiger une note et faire un test derrière chaque score. Sinon, la matrice transforme les impressions de démonstration en décimales.
Utilisabilité du relecteur de test
L'observabilité sert plus que les ingénieurs. Demandez à un gestionnaire de produit, spécialiste du domaine, relecteur de sécurité et opérateur de support d'enquêter sur les mêmes exécutions étiquetées sans coaching.
Observez s' ils peuvent:
- trouver la exécution à partir d'un rapport d'utilisateur ou d'un identifiant d'artefact;
- comprendre la séquence sans lire le JSON brut;
- ouvrir le résultat exact de la source et de l'outil récupérés;
- distinguer les données de production des commentaires des évaluateurs;
- étiqueter le défaut et attribuer un responsable;
- comparer la version défaillante avec une correction candidate;
- l'exportation de preuves d'un incident ou d'un audit;
- éviter de voir du contenu en dehors de leur autorisation.
Enregistrer le temps d'achèvement et les erreurs. Une plateforme qui est puissante pour son équipe de mise en œuvre mais inutilisable pour les relecteurs qui jugent la qualité laissera la boucle d'amélioration incomplète.
Évaluer l'alerte et la réponse aux incidents
Créer trois incidents de test: une panne d'outil, une augmentation soudaine des coûts et une régression de la qualité de sortie. Confirmer comment les groupes de plateforme affectés exécutent, suppriment les doublons, modifient les liens, routent les notifications et conservent les preuves.
Les alertes de qualité ont besoin d'un volume et d'une calibration suffisants pour éviter le bruit. Un seul faible score du juge modèle peut créer un élément d'examen; une baisse soutenue de l'achèvement accepté peut justifier un incident. Les événements de sécurité et de confidentialité peuvent nécessiter une réponse immédiate à partir d'un cas confirmé.
Vérifiez si les alertes peuvent utiliser des résultats commerciaux tels que des livraisons rejetées ou des cas d'appui non résolus, et pas seulement la télémétrie technique. L'échec de production le plus important peut renvoyer HTTP 200.
Planifier l'architecture de l'instrumentation
Application d'agent
-> instrumentation et rédaction en cours
-> OpenTelemetry ou SDK du fournisseur
-> collecteur contrôlé ou passerelle
-> politique de routage et d'échantillonnage
-> l'backend de l'observabilité
-> évaluation et annotation
-> système d'incident, de problème et de déploiement
Mettre le filtrage secret et la classification obligatoire aussi près de l'application que possible. Utilisez un collecteur ou une passerelle pour appliquer de manière cohérente les contrôles de routage, d'échantillonnage, d'enrichissement et de destination. Garder le flux de travail et métadonnées de version connectées aux dossiers de déploiement afin d'enquêter sur un changement.
Le comportement de l'échec du document. Si le backend observable n'est pas disponible, décidez si la télémétrie tamponne, diminue ou bloque le flux de travail. La plupart des agents axés sur les utilisateurs ne devraient pas échouer uniquement parce que le suivi facultatif est limité, mais les flux de travail à haut risque peuvent nécessiter un dossier d'audit durable avant que des actions conséquentes ne soient menées.
Évitez les pièges de référence
Les comparaisons de fournisseurs comptent souvent des intégrations ou présentent une latence synthétique. Ces signaux ne permettent pas de savoir si votre équipe peut résoudre ses échecs. Utilisez la même version de l'agent, les cas d'essai, l'échantillonnage, le mode de capture de contenu, la rétention et les définitions de l'évaluateur pour chaque candidat.
Ne comparez pas un outil open source hébergé localement avec un service géré tout en excluant l'infrastructure et la main-d'œuvre internes. Ne comparez pas le prix de la liste lorsque les candidats comptent les spans, les tokens, le stockage, les évaluations et les licences utilisateur différemment. Normaliser au coût par résultat de flux de travail accepté selon les mêmes hypothèses de volume.
Gardez les résultats de test et les notes de notation originaux. Si un candidat s'améliore au cours de l'essai, enregistrez la version et réécrivez le test fixe au lieu de modifier l'ancien score à partir de la mémoire.
Écrire les exigences des défaillances
Transformer les histoires de débogage en béton en tests d'acceptation:
Échec: L'agent a cité une politique dépassée après une conversation de trois tours.
Les preuves requises:
- Remplissez le fil de conversation et exécutez les identifiants
- Recherche de récupération et versions de documents retournés
- Les versions de l'instruction, du modèle et du flux de travail
- L'outil et la séquence de retrait
- Résultat de l'évaluation des citations
- Correction et résultat par l'utilisateur final

Test d'acceptation:
Un relecteur peut trouver la récupération obsolète, ajouter la exécution à un ensemble de données,
comparer une correction proposée et confirmer la version de production corrigée.
Créez au moins cinq histoires: une réponse erronée, une boucle coûteuse, une dépendance lente, une défaillance des autorisations et une trace sensible à la vie privée. Une démonstration de fournisseur devrait reproduire ces histoires avec votre forme de données plutôt que de présenter un tableau de bord préparé.
Une carte de résultats de deux semaines pour prouver le concept
Testez deux flux de travail réels et notez chaque critère de 0 à 2.
| Critère | 0 | 1 | 2 - |
|---|---|---|---|
| Exhaustivité des traces | Des étapes importantes manquantes | La plupart des étapes visibles | La exécution complète est reconstructible |
| Adéquation de l'évaluation | Scores génériques fixes | Une logique personnalisée | Évaluation propre à la tâche et versionnée |
| Temps de débogage | Aucune amélioration | Amélioration partielle | Cause racine trouvée rapidement |
| Confidentialité | Contenu toujours stocké | Contrôles manuels | Minimisation axée sur les politiques |
| La portabilité | Export fermé | Export partiel | Export ouvert et documenté |
| Lien avec le résultat | Aucun résultat pour l'utilisateur | Étiquettes manuelles | Le résultat s'ajoute à chaque exécution |
Flux de travail:
Échec à reproduire:
Champs de trace requis:
champs sensibles à supprimer:
Ensemble d'évaluation hors ligne:
Résultat de la production:
Limite d'alerte:
Relecteur:
Décision de sortie: adoption / prolongation du test / rejet
Une POC planifié au jour le jour
1 à 2 jours: congeler le test
Choisissez deux flux de travail, dix succès connus, dix défaillances et un cas sensible. Documentez le temps de débogage actuel, le coût, la latence et le taux d'acceptation. Finalisez la grille de notation avant que les fournisseurs ne configurent le produit.
Jours 3 et 4 : Instrumenter
Connectez le flux de travail de mise en scène. Enregistrez les champs qui apparaissent automatiquement, les modifications de code requises, les spans manquants et le temps de configuration. Vérifiez le streaming, nouvelles tentatives, les tâches de fond et les erreurs d'outil plutôt que de vous arrêter après un chat réussi.
Les 5 à 6 jours: évaluer
Importez ou créez un ensemble de données, ajouter des évaluateurs déterministes et qualitatifs et comparer deux versions contrôlées du flux de travail. Demandez à un relecteur métier d’étiqueter les échecs sans compter sur le score par défaut du fournisseur.
Jour 7 à 8: opérations d'essai
Créez une alerte, l'enquêter, attribuer une correction, ajouter la exécution à la régression, et vérifier une version fixe. Exportez les traces et évaluations. Testez les changements de rôle et suppression de l'accès d'un utilisateur.
Jour 9 à 10: Test de gouvernance et de coûts
Testez l'expurgation, la conservation, la suppression, les journaux d'audit et la capture sans contenu. Estimez les coûts mensuels d'ingestion, stockage, évaluation, licences, support et exploitation. Consignez les hypothèses et fourchettes de volume.
Finissez par une décision écrite. Un POC convaincant peut encore échouer parce que l'exportation est incomplète, que les relecteurs ne peuvent pas l'utiliser ou que le coût d'évaluation prévu est trop élevé.
Estimation du coût total de la propriété
Inclure plus que le prix d'abonnement:
| Poste de coût | Les questions |
|---|---|
| L'ingestion | Les spans, les tokens, les événements ou les octets sont-ils facturés? Qu'est-ce qui est échantillonné ? |
| Conservation | Comment les traces actives, archivées et supprimées affectent-elles le coût ? |
| Évaluation | Est-ce que les appels au modèle de juge sont inclus ou passés ? |
| Les licences utilisateur | Quels ingénieurs, relecteurs, auditeurs et téléspectateurs ont besoin d'accès? |
| Hébergement | Pour les outils autogérés, qui possède le calcul, le stockage, la sauvegarde et les mises à niveau? |
| Ingénierie | Combien d'instruments personnalisés et d'entretien sont nécessaires? |
| Migration | Les traces historiques, les ensembles de données, les étiquettes et les évaluateurs peuvent-ils être exportés? |
| Réponse aux incidents | Est-ce que la couverture du support correspond au risque de production et aux fuseaux horaires? |
Modèle trois volumes: courant, utilisation prévue de douze mois, et un pic. L'échantillonnage et la rétention doivent être explicites dans chaque modèle. L'ingestion peu coûteuse peut devenir coûteuse lorsque les commentaires complets, les résultats et les évaluations des juges se multiplient à chaque exécution.
Révision de la sécurité et de la vie privée
Demandez au fournisseur de démontrer, pas seulement de décrire:
- expurgation avant que les données ne quittent votre application;
- le suivi uniquement de métadonnées par classification des flux de travail;
- le chiffrement en transit et en repos;
- choix régionaux de transformation et de stockage;
- l'isolement des locataires et l'accès fondé sur les rôles;
- les journaux d'audit destinés à la visualisation et à l'exportation;
- la conservation configurable et la suppression vérifiée;
- traitement des informations, des sorties et de la télémétrie pour la formation des modèles;
- les sous-traitants et l'accès à l'assistance;
- détection des secrets dans les arguments des outils et les messages d'erreur.
Créer une trace d'essai contenant des identifiants synthétiques et des données personnelles, puis confirmer le blocage ou la rédaction attendus à chaque destination. N'utilisez jamais de vrais secrets pour ce test.
Construire, acheter ou combiner
Achetez une plateforme gérée lorsque la vitesse, la collaboration, l'évaluation hébergée et le support comptent davantage qu'un contrôle maximal de l'infrastructure.
Autogérez une pile open source lorsque le contrôle des données, la personnalisation ou l'intégration interne justifient une responsabilité opérationnelle continue.
Étendez l'APM existant lorsque les incidents interservices et les pratiques d'astreinte dominent, à condition de pouvoir ajouter l'évaluation de la qualité des agents.
Combinez une instrumentation ouverte avec le backend choisi lorsque la portabilité est requise. C'est souvent un compromis pratique, à condition que le schéma commun conserve les détails nécessaires au backend.
Évitez de construire une interface entière simplement pour éviter une licence. L'instrumentation personnalisée et un petit rapport interne de qualité peuvent être raisonnables; recréer la recherche de traces, l'évaluation, l'annotation, le contrôle de l'accès et la conservation est un engagement du produit.
Liste de contrôle des migrations et des sorties
[ ] Les données de trace s’exportent dans un format documenté et exploitable.
[ ] Les ensembles de données conservent les entrées, les sorties attendues, les métadonnées et les partitions.
[ ] Les étiquettes humaines et l'identité des relecteurs peuvent être conservées conformément aux règles.
[ ] Les définitions et versions de l'évaluateur peuvent être recréées ailleurs.
[ ] Les références à la version de prompt et au flux de travail restent significatives.
[ ] Les alertes, les tableaux de bord et les requêtes enregistrées sont inventoriés.
[ ] La suppression du SDK ne brise pas le flux de travail de production.
[ ] La suppression de l'ancien service peut être vérifiée.
Faites une exportation pendant l'essai. Le langage contractuel ne remplace pas le fait de voir si les données obtenues peuvent reconstruire une enquête utile.
Adoption après achat
Commencez par une nomenclature commune, des attributs obligatoires, des modes de capture et des champs de résultat. Publiez un exemple d'instrumentation et examinez-le comme un contrat d'API. Si chaque équipe invente son propre agent_name, ses statuts et ses résultats utilisateur, l'outil central ne peut pas produire de vues comparables.
Nommez des responsables pour l'instrumentation, la plateforme, l'évaluation, la revue métier, la confidentialité et les incidents. Organisez chaque mois une revue des échecs qui sélectionne quelques modifications et vérifie leur effet en production. Accumuler des traces sans cadence opérationnelle crée du stockage, pas de la fiabilité.
Auditez les des tableaux de bord et des alertes après chaque changement majeur de flux de travail. Retirez les mesures qui ne mènent plus à une décision et testez si de nouveaux outils ou transferts apparaissent dans les traces avant le déploiement.
Questions pour une RFP ou un appel au fournisseur
- Quels cadres d'agents, fournisseurs de modèles et langues sont pris en charge au niveau des étapes?
- Comment sont représentés les fils à plusieurs tours, les sous-agents, le travail asynchrone et les transferts?
- Quelles conventions OpenTelemetry et quelles voies d'exportation sont aujourd'hui prises en charge?
- Pouvons-nous faire des évaluations déterministes personnalisées, basées sur des modèles et humaines ?
- Comment les ensembles de données, les évaluateurs, les requêtes et les versions du flux de travail sont-ils reliés?
- Où l’expurgation a-t-elle lieu, et peut-on désactiver la capture de contenu par la politique?
- Quelles sont les durées de conservation par défaut et maximales?
- Comment sont vérifiés l'accès, la accès du support et les exportations?
- Qu'arrive-t-il à nos données lors de la formation des modèles et de l'amélioration des services?
- Comment les spans, le stockage, les évaluations et les licences utilisateur influencent-ils le prix ?
- Qu'est-ce qui peut être exporté si nous partons, et dans quel format?
- Quelles limitations actuelles affecteraient nos échecs de POC ?
Erreurs de sélection courantes
- Acheter des tableaux de bord attrayants avant de définir une question de débogage.
- Traiter le sentiment générique ou la pertinence comme preuve du succès de la tâche.
- Capturer le contenu complet par défaut et concevoir la vie privée plus tard.
- Comparer des outils avec des prompts de démonstration au lieu de défaillances en plusieurs étapes.
- Verrouiller l’instrumentation à un backend sans tester l'exportation.
- Mesurer le succès des demandes tout en ignorant si les utilisateurs acceptent le travail.
Une autre erreur courante consiste à sélectionner à partir d'un tableau de comparaison sans confirmer la date de publication. Les produits d'observabilité des agents évoluent rapidement. Traitez ce guide comme un cadre de exigences, puis vérifiez toutes les capacités dans la documentation actuelle et dans l'environnement d'essai.
Le guide de l'observabilité des agents d'IA définit le modèle d'événement et de revue. L'explication des workflows agentiques aide à déterminer quelles étapes et décisions humaines appartiennent à une trace.
FAQ
L'observabilité du LLM et l'observabilité des agents de l'IA sont-elles les mêmes?
Ces notions se recouvrent, mais l'observabilité de l'agent couvre plus que les appels de modèle. Elle doit inclure la planification, la récupération, les outils, l'état, les transferts, les nouvelles tentatives, les autorisations, les approbations et les résultats finaux.
Un outil open source est-il toujours moins cher ?
Non. Le coût de la licence n'est qu'un seul élément. Incluez l'hébergement, le stockage, la maintenance, le contrôle des accès, l'intégration en appel et le temps d'ingénierie nécessaire pour maintenir l'instrumentation à jour.
La surveillance standard des applications peut-elle gérer les agents ?
Elle peut couvrir la santé des infrastructures et des services. Elle nécessite généralement de traces et d'évaluations spécifiques à l'agent pour expliquer les échecs comportementaux et la qualité des tâches.
Combien d'outils devrions-nous essayer ?
Deux ou trois suffisent lorsque la carte de score et les défaillances représentatives sont fixées à l'avance. Une grande tournée produit des captures d'écran, pas une décision.
Faut-il à la fois des traces et des évaluations ?
Oui pour la plupart des agents de production. Le suivi explique la séquence; l'évaluation juge si le résultat et le comportement répondent au contrat de tâche. L'un ou l'autre laisse une lacune importante.
Les données d'observabilité devraient-elles rester dans la même région que les données de production?
Cela dépend de la politique, des contrats et de la classification des données applicables. Traiter la télémétrie comme des données de production potentiellement sensibles et vérifier les exigences en matière de traitement, de stockage, d'accès à l'assistance et de transfert.
Que devrions-nous exporter pendant un essai ?
Exporter des traces représentatives, des ensembles de données, des étiquettes humaines, des résultats d'évaluation et des définitions de configuration. Confirmez qu'un autre ingénieur peut les comprendre et les réutiliser sans l'interface originale.
Quel outil d'observabilité d'IA est le mieux adapté à une startup ?
Il n'y a pas de solution automatiquement gagnante pour une startup. Commencez par l'option la plus légère qui reconstruit le vrai flux de travail et prend en charge une boucle d'échec à l'essai. Évitez une plateforme d'entreprise dont l'exploitation dépasse la complexité de l'agent, mais préservez une voie d'exportation.
On peut changer d'observabilité plus tard ?
Une instrumentation ouverte aide, mais les tableaux de bord, les définitions de l'évaluateur, les annotations, les ensembles de données, les alertes et les champs responsables peuvent toujours créer un dépendance fournisseur. Testez l’exportation et la recréation lors de la démonstration du concept.
L'évaluation doit-elle être effectuée sur chaque trace de production?
Pas nécessairement. Utilisez des contrôles déterministes de manière générale lorsqu'ils sont peu coûteux, basés sur des modèles échantillonnés et évalués par l'homme en fonction du risque et du volume, et examinez toujours les incidents confirmés ayant un impact élevé dans le cadre de la politique.
Commencez l'évaluation avec un workflow réel dans Ottermind, puis conservez son pack de sources, le livrable accepté et les corrections des relecteurs comme cas de test partagé.
