Guía técnica
GPT-6 para programar: errores entre archivos, cambios pequeños y pruebas
La ventaja de programación más interesante de GPT-6 Astra es relacionar información repartida por una base de código. Las primeras pruebas sugieren más beneficio en revisiones difíciles entre archivos que en ediciones simples. Por eso merece evaluarse al investigar consecuencias de un cambio, mientras que la implementación rutinaria aún requiere comparar velocidad y coste.
Dos evaluaciones externas plantean preguntas diferentes: CodeRabbit mide si los hallazgos detectan errores etiquetados; Real Python comprueba el comportamiento con cinco prompts fijos. Juntas ofrecen un punto de partida más práctico que un único ranking.
Fuentes: evaluación de CodeRabbit; pruebas de Real Python; comparativa de OpusBooster. Consultadas el 7 de septiembre de 2026. Los resultados y experiencias se atribuyen a sus autores en el texto.
Qué midió CodeRabbit
En su evaluación del 4 de septiembre, CodeRabbit publica esta cobertura de errores mediante hallazgos que permiten actuar:
| Conjunto | Astra | Sol | Diferencia |
|---|---|---|---|
| General | 61,3 % | 59,0 % | 2,3 puntos porcentuales |
| Subconjunto difícil entre archivos | 57,1 % | 47,6 % | 9,5 puntos porcentuales |
La mejora relativa aproximada del 20 % en el subconjunto difícil no significa 20 puntos porcentuales, ni que cada equipo publique un 20 % menos de errores. Mide defectos identificados en esa evaluación y las dos filas tienen distintas distribuciones de dificultad.
El resultado respalda probar Astra en cambios con efectos repartidos entre archivos. No demuestra que todos sus comentarios sean correctos, que encuentre todos los errores importantes ni que un parche pequeño necesite el modelo más caro.
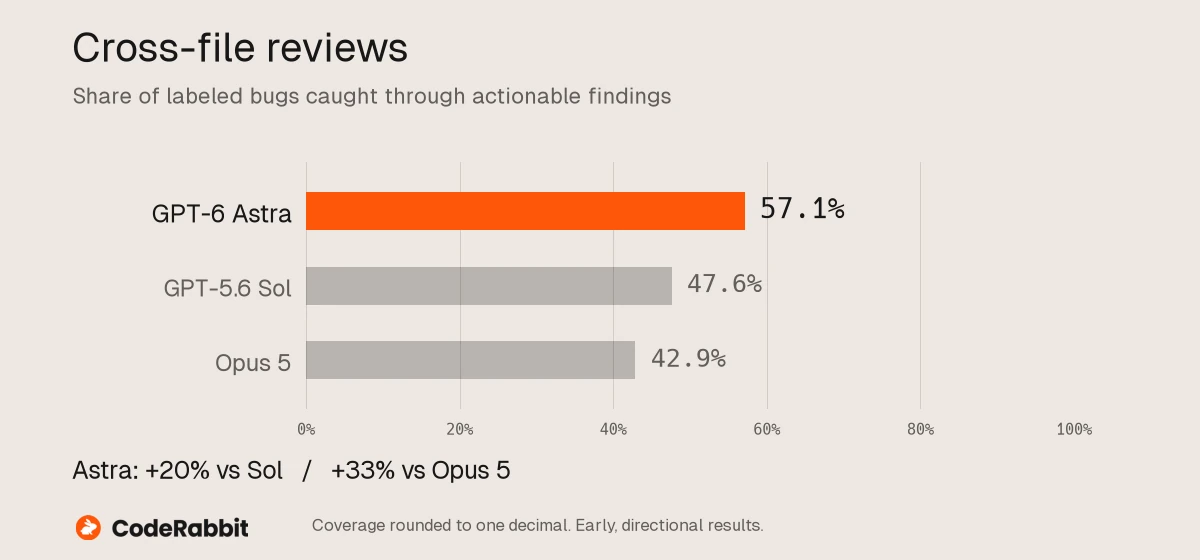
Resultados entre archivos publicados por CodeRabbit. Son hallazgos iniciales, no una medida de la calidad global de revisión.
Qué probó Real Python
La prueba de cinco prompts de Real Python usó Astra mediante OpenRouter con razonamiento predeterminado, un intento por prompt y sin instrucciones de sistema. Publicó salidas que el lector puede inspeccionar.
El modelo reconoció que una función inventada de la biblioteca estándar no existía. Al añadir una opción simple, modificó 11 líneas frente a un mínimo de siete. Los cinco ejercicios costaron 0,31 USD. Es una forma útil de evaluar API inventadas, tamaño del cambio y ejecución, en lugar de aceptar código solo por parecer razonable.
Cinco prompts no predicen el rendimiento en todo un repositorio. Sí pueden revelar conductas pequeñas que las evaluaciones amplias pasan por alto.
Por qué pasar los tests puede no validar la función
Una comparativa Astra-Terra basada en producción encontró dos implementaciones que superaban la batería existente, aunque una gestionaba mal estados de paginación relacionados. Astra conservó la relación y añadió una comprobación.
La lección general es revisar el contrato que modifica la tarea. Puede que los tests nunca ejerciten la interacción que hace útil la nueva función. Pregunta si cubren el recorrido del usuario, no solo la función añadida.
Lee el parche detrás de la puntuación
Real Python publica el diff de la pequeña edición y su tamaño. Las líneas adicionales incluyen formato de la definición del argumento, de modo que superar el mínimo no demuestra complejidad perjudicial. Lo relevante es si el parche altera comportamientos fuera de la petición. Su seguimiento de trabajo real aún estaba pendiente al consultarlo; los cinco prompts deben valorarse por sus propios resultados. Consulta la prueba y el parche.
Esta distinción vale para cualquier agente. Un parche largo puede ser más claro y uno corto ocultar una incompatibilidad. Revisa qué hace el código añadido, qué comportamiento cambia y si los nuevos tests fallarían sin la corrección.
Usa benchmarks para elegir candidatos y luego examina las entregas para decidir si encajan en el repositorio. Una demo, la cobertura de errores y una prueba de prompts fijos responden a preguntas distintas.
Ejemplo completo: revisar una paginación compartida
Imagina una página con dos listas paginadas de forma independiente. El usuario pasa la primera a la página tres y luego avanza la segunda. La primera debe mantenerse en la tercera. Cada paginador puede funcionar por separado mientras falla su combinación.
El revisor debe seguir el constructor de URL, los parámetros, el estado de componentes y la navegación. Si el enlace nuevo contiene solo el parámetro de la segunda lista, puede borrar la selección de la primera. Un test aislado de cualquiera de ellas podría no detectarlo.
URL inicial: /results?customersPage=3&invoicesPage=1
Acción: avanzar las facturas a la página 2
Esperado: /results?customersPage=3&invoicesPage=2
Comprobar también: recarga, retroceso del navegador y página inválida
Es el tipo de relación que el caso de OpusBooster invita a investigar. También recuerda la utilidad de escribir un ejemplo de aceptación antes de implementar. Da un objetivo concreto al agente y al revisor, sin impedir que reutilicen las funciones auxiliares del repositorio.
Distingue cobertura y calidad de revisión
Un revisor que detecta más errores conocidos puede producir falsos positivos molestos. La evaluación local debe registrar hallazgos aceptados, rechazados y el tiempo de comprobar ambos. Una preocupación vaga sin condición de activación puede consumir más atención de la que ahorra.
| Resultado | Qué registrar | Por qué importa |
|---|---|---|
| Defecto confirmado | Reproducción y comportamiento afectado | Muestra un hallazgo útil |
| Hallazgo incorrecto | Por qué el código es válido | Mide el ruido |
| Duda pendiente | Evidencia o entorno ausente | Evita presentar incertidumbre como error |
| Defecto omitido | Error histórico o reproducción posterior | Expone huecos de cobertura |
Cuando sea posible, pide al mantenedor que valore sin conocer el modelo. Mantén visible la dificultad: una configuración pequeña y una migración multiservicio no deben mezclarse en una media sin explicar.
Da contexto suficiente para revisar consecuencias
Empieza con la petición y el diff, y facilita los llamadores y tests afectados. Incluye compatibilidades fáciles de olvidar, como un cliente API antiguo, un formato persistente o un comando público cuya salida interpretan scripts.
Evita volcar material irrelevante en el prompt. Pide al modelo que siga las rutas afectadas y explique qué necesitó leer. Así la revisión es comprobable y puedes detectar dependencias importantes que nunca consideró.
Al cambiar un tipo compartido, comprueba productores y consumidores. En una base de datos, incluye las hipótesis de actualización y reversión. Para una interfaz, indica las transiciones esperadas. La arquitectura de agentes de IA explica cómo se combinan contexto, herramientas y modelo.
Ajusta las pruebas al cambio
La guía de prompting de GPT-6 de OpenAI señala que las tareas de código pueden generar más pruebas de las necesarias para un cambio pequeño. Define antes el test específico, el comportamiento que acredita y cuándo procede ampliar la batería.
Una errata y una modificación de autenticación compartida requieren validaciones distintas. Repetir la batería completa en un parche pequeño puede añadir poca evidencia; una única prueba unitaria puede ser insuficiente para un comportamiento compartido. Pide que explique el alcance de las comprobaciones en función del comportamiento afectado.
Empieza con las pruebas que cubren el comportamiento modificado.
Amplía si afecta a un contrato compartido
o si el resultado inicial revela una regresión más amplia.
Explica qué comportamiento verifica cada comprobación.
Si una prueba no se puede ejecutar, proporciona el comando y el impedimento.
No permitas que el agente consiga tests verdes debilitando aserciones ajenas al pedido. Inspecciona pruebas eliminadas y expectativas modificadas como parte de la revisión. Un resultado aprobado solo sirve si los tests siguen expresando el contrato correcto.
Compara el coste de un cambio aceptado
Registra consumo, tiempo de herramientas, reintentos y revisión humana por caso. Compara el coste hasta un parche aceptado. Una primera respuesta barata puede salir cara tras dos reparaciones; un modelo caro también puede perder tiempo en un rediseño innecesario.
Prueba un reparto pequeño: GPT-6 para revisiones difíciles entre archivos y el modelo actual para cambios habituales. Amplía si aumentan los hallazgos aceptados o disminuye el retrabajo. No extrapoles el éxito de revisión a implementación, documentación o diseño visual sin evaluarlos aparte.
Cuatro casos para tu propia evaluación
| Caso | Tarea | Criterio de aceptación |
|---|---|---|
| Edición pequeña | Añadir una opción a un comando | Sin la opción, se conserva la salida anterior |
| Cambio entre archivos | Modificar un campo compartido | Todos sus productores y consumidores siguen el contrato nuevo |
| Depuración | Investigar un fallo reproducible | La corrección resuelve el caso y conserva comportamientos próximos |
| Revisión | Examinar un cambio histórico con error | Los hallazgos identifican defectos reales sin especulación |
Parte de un snapshot limpio para cada candidato. Mantén instrucciones, herramientas y presupuesto iguales. Guarda parche, cambios de tests, correcciones y tiempo hasta aceptación. Para comparar modelos, consulta GPT-6 frente a GPT-5.6.
Plantilla de prompt para revisar código
Revisa este cambio según su comportamiento previsto: [objetivo].
Sigue llamadores, consumidores de datos y rutas de error afectadas.
Para cada hallazgo, proporciona:
- La condición concreta que provoca el defecto
- El comportamiento afectado y referencias de archivos que lo acreditan
- Una reproducción o prueba que lo revele
Prioriza defectos accionables. Señala la incertidumbre.
No edites archivos durante la revisión.
Plantilla de implementación
Implementa [comportamiento] con los patrones existentes del repositorio.
Lee código y pruebas relevantes antes de elegir un enfoque.
Conserva [invariantes y requisitos de compatibilidad].
Verifica [recorrido concreto] además de los tests específicos.
Devuelve el cambio, los resultados y las limitaciones restantes.
Concreta las invariantes: mantener el otro filtro, preservar la salida de un comando o no cambiar el esquema público. Son condiciones más comprobables que «escribe código listo para producción».
Cuándo compensa actualizar
Prueba Astra si hace falta razonar con cuidado entre módulos o si la revisión domina el coste. Mantén una referencia económica para cambios repetitivos y fáciles. No midas productividad por líneas o comentarios: las modificaciones innecesarias aumentan la revisión.
Para proyectos que mezclan investigación, requisitos y planificación, organiza el briefing y el material en Ottermind. Conserva la verificación de código en el repositorio y relaciona los resultados con la decisión general del proyecto.
Preguntas frecuentes
¿GPT-6 revisa mejor el código?
CodeRabbit encontró más cobertura mediante hallazgos útiles, con mayor ventaja en el subconjunto difícil entre archivos. Compruébalo en tu propio código.
¿Una puntuación superior permite omitir revisión?
No. La cobertura sigue siendo incompleta y los hallazgos necesitan validación antes de modificar nada.
¿Siempre conviene Astra para un parche pequeño?
Las pruebas publicadas no lo demuestran. Compara corrección, cambios innecesarios, velocidad y coste.
¿Qué mido además de los tests aprobados?
Contrato funcional, riesgo de regresión, cobertura retirada, correcciones del revisor y tiempo hasta un parche aceptado.
¿Por dónde empiezo?
Usa los casos anteriores y consulta la guía de la API de GPT-6 para integrarlo.
