
Sora-Prompt
Kopiere einen Sora-Prompt als einen fließenden Satz, halte die Kamera bei einer einzigen einfachen Bewegung und rendere das Bild, bevor du animierst.
Drei Sora-Prompts zum Kopieren
Jedes veröffentlichte Beispiel dieses Stils hat dieselbe Form: ein fließender Satz, der sagt, was passiert, wo, wie beleuchtet und wie gefilmt wird. Diese drei folgen ihr für eine bewegte Einstellung, eine einzelne Handlung und eine Sequenz aus zwei Bildern.
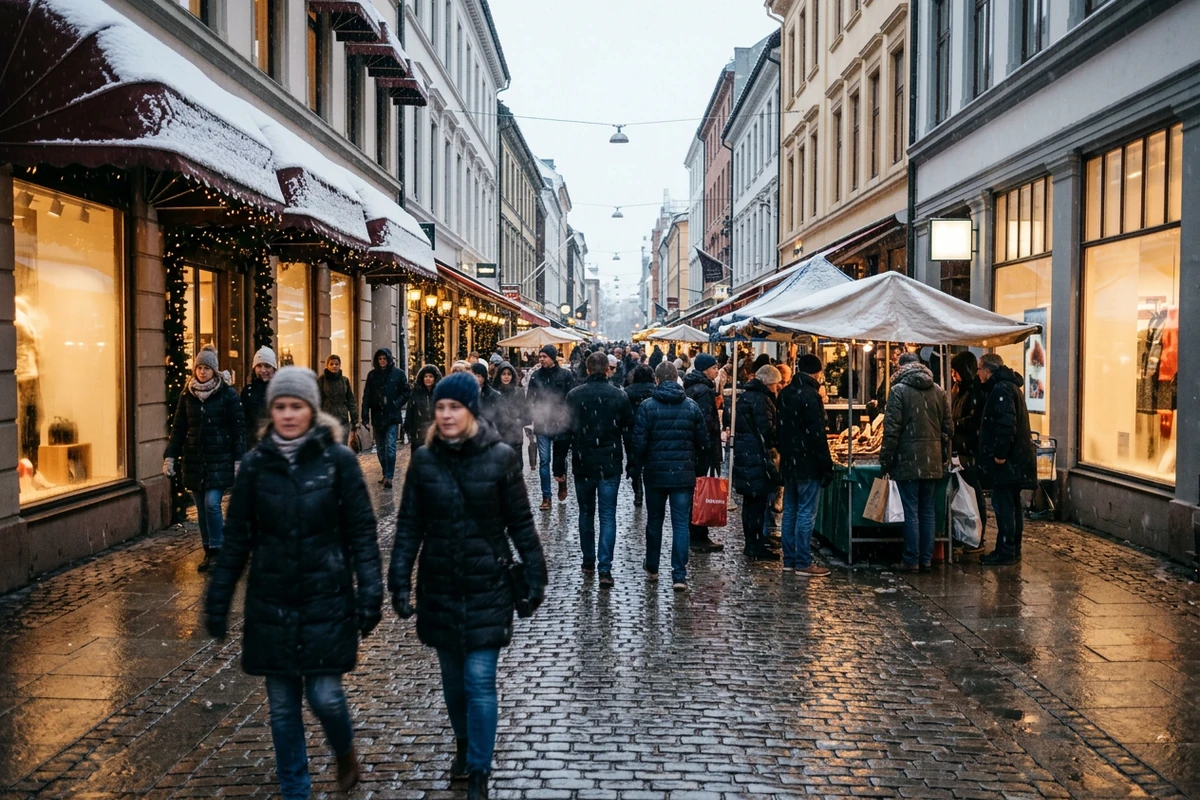
Die bewegte Einstellung
Die Kamera fährt vorwärts durch eine belebte Einkaufsstraße bei leichtem Schneefall. Mehrere Menschen in Wintermänteln gehen langsam an Marktständen vorbei, ihr Atem ist sichtbar, Schnee legt sich auf Markisen und nasse Pflastersteine, warmes Ladenlicht leuchtet hinter beschlagenen Scheiben. Bewölktes Licht am späten Nachmittag, die Schaufenster sind der einzige warme Akzent. Weitwinkel, große Schärfentiefe, natürliche Farbe, fotografischer Realismus, kein lesbarer Text und kein Wasserzeichen.
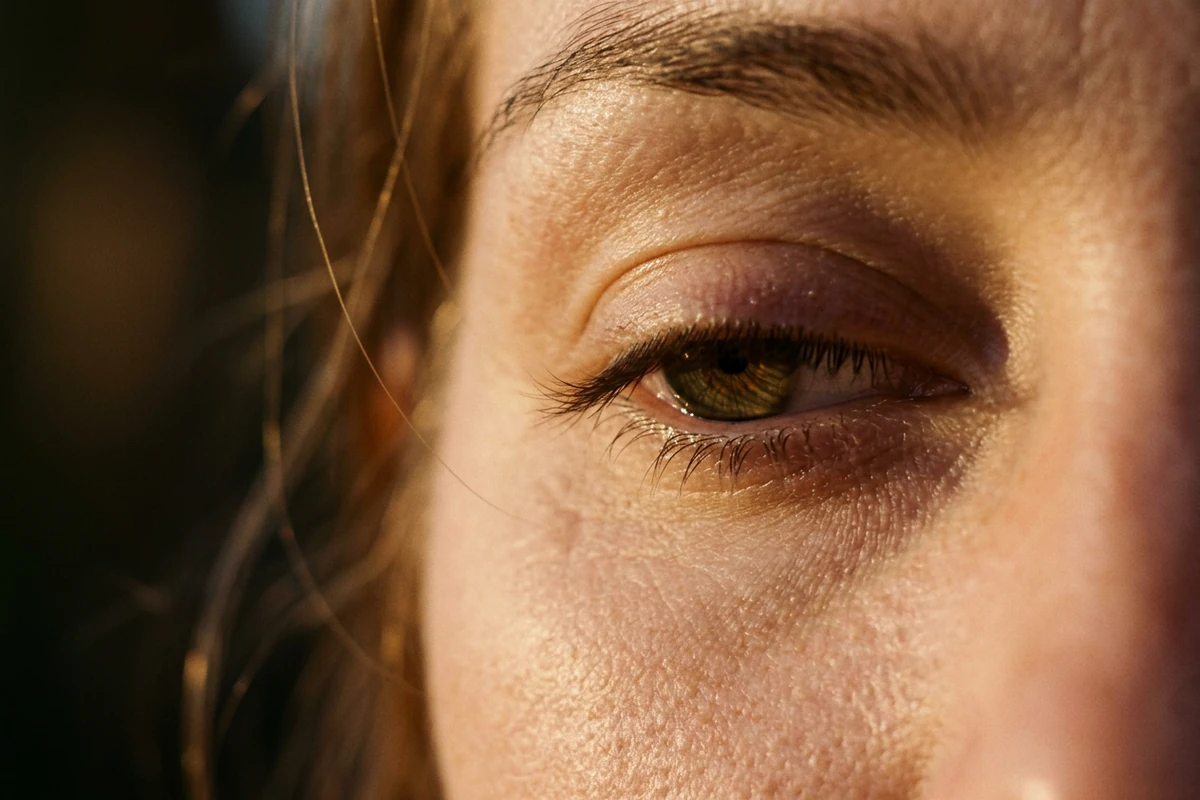
Die einzelne Handlung
Extreme Nahaufnahme des Auges einer Frau mitten im Blinzeln, die Wimpern zwischen offen und geschlossen, tief stehende warme Abendsonne von der Seite mit einem kleinen Glanzpunkt in der Iris und allem anderen in weichem Schatten. Makroobjektiv, sehr geringe Schärfentiefe, echte Hauttextur. Nur eine Handlung, das Blinzeln, ohne jede weitere Bewegung im Bild. Natürliche Farbe, kein lesbarer Text und kein Wasserzeichen.
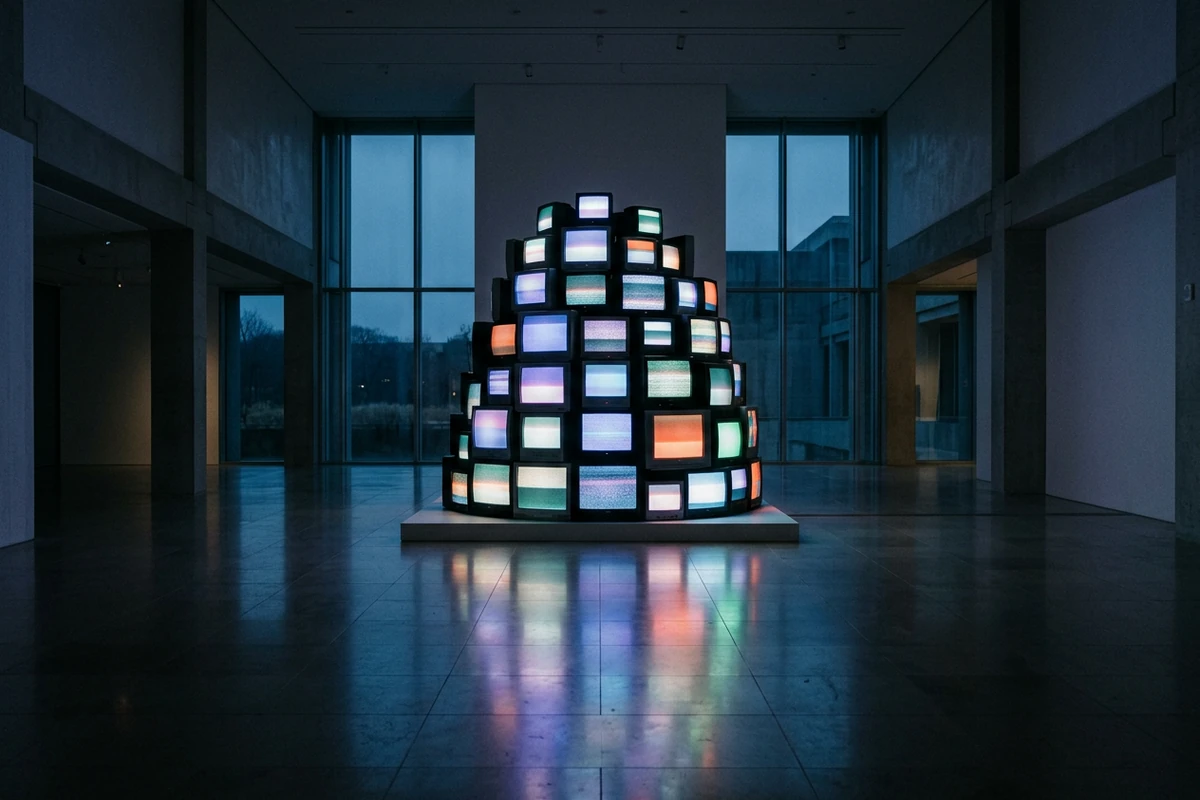
Die Sequenz aus zwei Bildern
Eine große Museumsgalerie bei Nacht mit einem hohen Stapel alter Fernseher auf einem Sockel in der Raummitte, alle Bildschirme an, aber nur abstraktes farbiges Leuchten und leichtes Rauschen zeigend. Die Einstellung öffnet weit auf die ganze Galerie und fährt dann näher an den Stapel heran, wobei dasselbe kühle blaue Umgebungslicht und derselbe Look über beide Bilder hinweg bleibt. Polierter Boden, der das Leuchten spiegelt, keine Menschen, kein lesbarer Inhalt auf den Bildschirmen und kein Wasserzeichen.
Ein Satz, in Reihenfolge gelesen
Der Prompt-Stil, mit dem dieses Modell genutzt wird, ist keine Parameterliste. Er liest sich als ein beschreibender Satz, und die Teile, die scheitern, sind die, die etwas verlangen, womit das Modell laut Berichten Schwierigkeiten hat.
Motiv, dann Handlung, dann Ort, Licht und Objektiv
Erst das Motiv, dann was passiert, dann wo, dann wie beleuchtet und schließlich wie gefilmt. Veröffentlichte Beispiele folgen dieser Reihenfolge statt Stil-Tokens mit Kommas zu stapeln, und die Reihenfolge macht offensichtlich, welchen Teil man ändert. KI-Prompt-Generator formt eine Fragmentliste zu diesem Satz um.
Halte die Kamera bei einer einzigen einfachen Bewegung
Kameraanweisungen werden am häufigsten falsch gelesen: eine beschriebene Kamerafahrt gilt als etwas, das das Modell missverstehen kann, also schlägt eine klare Bewegung wie vorwärtsfahren oder einmal umkreisen eine Folge von Richtungen. Bild zu Video startet aus einem Bild, das diese Bewegung schon festlegt.
Schreib um die berichteten Schwächen herum
Öffentliche Auswertungen berichten von Schwierigkeiten mit Physiksimulation und mit Ursache und Wirkung sowie von schwächerem Raum- und Ereignisdetail. Halte die Handlung deshalb bei einer Sache, benenne den Raum, statt ihn anzudeuten, und verkette keine voneinander abhängigen Ereignisse. Foto-zu-Video-KI kostenlos testet eine solche Einstellung günstig.
Wie du einen Sora-Prompt in Ottermind schreibst
Schritt 1: schreib ihn als einen Satz
Benenne Motiv, die eine Handlung, den Ort, das Licht und das Objektiv in dieser Reihenfolge und hör dann auf. Braucht es eine zweite Handlung, sind es eigentlich zwei Einstellungen. KI-Prompt-Generator hält diese Struktur.
Schritt 2: rendere zuerst das Anfangsbild
Generiere die Einstellung als Standbild und prüf Licht und Objektiv, bevor du ein Video-Rendering ausgibst. Bild zu Video animiert dieses freigegebene Bild und behält den Look, den du abgesegnet hast.
Schritt 3: eine Bewegung animieren und Takes vergleichen
Gib dem Clip eine einzige Kamerabewegung und halt den restlichen Text zwischen den Takes identisch, damit ein schlechtes Ergebnis einer Formulierung zuzuordnen ist. KI-Reel-Generator hält die Takes in Reihenfolge.
Wo die zweite Anfrage sich lohnt
Ein Video-Prompt aus einem Satz zahlt sich aus, sobald eine Einstellung klar genug beschrieben sein muss, dass jemand anderes oder ein anderes Modell sie reproduzieren kann.
Kurze Clips für soziale Netze
Eine klare Handlung in einem klaren Raum ist die Form, die einen kurzen vertikalen Schnitt übersteht, weil nichts im Prompt bleibt, was das Modell mehrdeutig auflösen könnte. Schreib den einen Satz und lass KI-Reel-Generator die Takes ordnen.
Storyboard vor dem Rendern
Das Video-Rendering ist der teure Schritt, also blockiere die Einstellung zuerst als Standbild und prüf, ob Licht und Bildausschnitt das sagen, was du gemeint hast. KI-Videodemo ist der schnelle Durchlauf vor dem vollen Rendering.
Eine Einstellung zum Weitergeben
Wenn ein Briefing an eine andere Person oder ein anderes Modell geht, ist ein Ein-Satz-Prompt mit benanntem Licht und Objektiv etwas, das ohne Rückfrage läuft. Foto-zu-Video-KI kostenlos behält das Standbild als gemeinsamen Startpunkt.
Häufige Fragen zu Sora-Prompts
Wie lang kann ein Clip sein, den ein Sora-Prompt beschreibt?
Öffentliche Auswertungen berichten von Video bis etwa einer Minute, aber eine klare Handlung in einem klaren Raum bleibt leichter zusammenhängend als eine einminütige Ereigniskette. Schreib die Einstellung, die du in einem Satz beschreiben kannst. Bild zu Video verankert jede an einem freigegebenen Bild.
Warum wird meine Kameraanweisung ignoriert?
Weil eine beschriebene Kamerafahrt als etwas gilt, das das Modell falsch liest. Ersetze eine Folge von Richtungen durch eine einfache Bewegung wie vorwärtsfahren und lass den Rest unangetastet, damit die Kameraphrase die einzige Variable ist. KI-Prompt-Generator schreibt nur diese Phrase um.
Was kann dieses Modell schlecht?
Öffentliche Auswertungen berichten von Schwierigkeiten mit Physik und mit Ursache und Wirkung sowie schwächerem Raum- und Ereignisdetail. Halte die Handlung bei einer Sache, benenne den Raum klar und vermeide Prompts, deren zweite Hälfte von der ersten abhängt. Foto-zu-Video-KI kostenlos testet das günstig.
Soll der Prompt ein Satz sein oder mehrere?
Ein fließender Satz ist die Konvention in veröffentlichten Beispielen und entspricht der Art, wie die Einstellung gelesen wird: Motiv, Handlung, Ort, Licht, Objektiv. Mehrere Sätze funktionieren für eine Folge von Bildern, die das Modell als mehrere Einstellungen konsistent halten kann. KI-Videogenerator führt diese Renderings aus.
Kann man das kostenlos ausprobieren?
Die öffentliche Ottermind-Erfahrung lässt sich ohne Anmeldung nutzen und enthält eine begrenzte Zahl kostenloser Runden; Kontingente und Planlimits können trotzdem gelten. Teste die Einstellung zuerst als Standbild, damit eine Runde zeigt, ob sie funktioniert, in KI-Bildgenerierung.
Ist diese Seite offiziell, und woher stammen die Aussagen?
Nein, diese Seite ist weder mit dem Anbieter des Modells verbunden noch von ihm bestätigt, und es wird hier keine Anbieterdokumentation wiedergegeben. Die Handwerkshinweise beschreiben die Prompt-Form veröffentlichter Beispielsammlungen, und die Grenzhinweise geben wieder, was öffentliche Auswertungen bereits berichten.
Weitere Prompt-Themen, die dir gefallen könnten
Denselben Prompt auf einem anderen Videomodell ausführen
Mach aus dem Satz eine Einstellung
Schreib den einen Satz, rendere das Bild, animiere dann eine einzige Kamerabewegung und ändere weiter nur diese Phrase, bis die Einstellung sich so liest, wie du sie beschrieben hast.