Technischer Leitfaden
GPT-6-API-Leitfaden: Preise, Kontext, Werkzeuge und Migration
Verwenden Sie gpt-6-astra in OpenAIs Responses API, um mit GPT-6 zu entwickeln. Das Modell unterstützt Text- und Bildeingaben, Textausgaben, Funktionsaufrufe, Structured Outputs, Streaming und von OpenAI gehostete Werkzeuge. Das Kontextfenster umfasst 1.050.000 Tokens, die maximale Ausgabe 128.000 Tokens. Standard kostet 10 US-Dollar je Million Eingabetokens und 50 US-Dollar je Million Ausgabetokens.
Eine Produktionsmigration sollte nicht nur den Modellnamen austauschen. GPT-6 ergänzt asynchrone Werkzeugaufrufe, Steuerung während eines Turns und Änderungen des Denkaufwands im Gespräch. Das betrifft Sitzungszustand, offene Aufrufe, Abbrüche, Beobachtbarkeit und Kosten. Beginnen Sie mit einem festen Testsatz und einem kleinen Anteil umgeleiteter Aufgaben.
Quellen: Modellseite; Modellleitfaden; Responses-API-Migration; Ankündigung; Sicherheitsübersicht; Artificial Analysis; API-Tests zu Kosten und Denkaufwand; Coding-Test aus der Produktion. Geprüft am 7. September 2026.
Kurzreferenz
| Einstellung | Aktueller Wert |
|---|---|
| Modellkennung | gpt-6-astra |
| Empfohlene API | Responses API |
| Kontextfenster | 1.050.000 Tokens |
| Maximale Ausgabe | 128.000 Tokens |
| Wissensstand | 30. April 2026 |
| Denkaufwand | low, medium, high, xhigh, max |
| Text | Ein- und Ausgabe |
| Bilder | Nur Eingabe |
| Audio und Video als Modalitäten | Nicht direkt unterstützt |
| Funktionsaufrufe | Unterstützt |
| Structured Outputs | Unterstützt |
| Fine-Tuning | Nicht unterstützt |
| Kostenloser API-Tarif | Nicht unterstützt |
Erkenntnisse aus externen API-Tests
Die wichtigste frühe Erkenntnis: Konfiguration ist genauso wichtig wie der Modellname.
Artificial Analysis prüfte Astra max über OpenAIs eigene API. Im aktuellen Stand erreicht es 55 Punkte im Intelligence Index, 64,3 Ausgabetokens pro Sekunde und Kosten von 2,57 US-Dollar je Index-Aufgabe. Bei maximalem Aufwand vergehen rund 355 Sekunden bis zum ersten Token. Max ist bewusst kostspielig, doch die Messungen erklären, warum eine Integration Aufwand, Latenz und Kosten sichtbar machen muss, statt alles hinter gpt-6-astra zu verbergen.
ComputingForGeeks bestätigte die angekündigten Tokenpreise mit einem echten Aufruf und ließ dann dasselbe Debugging-Problem mit verschiedenen Modellen und Stufen lösen. Astra verbrauchte 3.525 Denktokens, benötigte 75,5 Sekunden und kostete etwa 0,194 US-Dollar. Sol brauchte 39,3 Sekunden für ungefähr 0,048 US-Dollar. Die Diagnose war gleich; Astra lieferte eine zusätzliche Einschränkung und gründlichere Bestätigungsschritte.
Der Tester meldete außerdem, dass der Wechsel von low zu max bei derselben Astra-Frage die Kosten nahezu verzehnfachte und die Latenz ungefähr verachtfachte. Low hatte die drei Ursachen bereits erkannt. Mehr Aufwand führte zu einem ausführlicheren Plan und schließlich zum gesetzten Ausgabelimit von 6.000 Tokens. Ein Einzeltest rechtfertigt keine allgemeine Quote, stützt aber einen vorsichtigen Standard: mit medium beginnen, nur mit Messgrundlage erhöhen und die Ausgabe begrenzen.
Der produktionsnahe Coding-Test zeigt die andere Seite. Astra vermied einen komponentenübergreifenden Zustandsfehler, den ein günstigeres Modell trotz grüner Tests auslieferte. Ein einzelner API-Aufruf kann teurer sein, während die gesamte abgenommene Aufgabe nach Prüfung und Reparatur günstiger wird. Ihre Bewertung braucht beide Zahlen.
Die Modellseite nennt zudem Websuche, Dateisuche, Bilderzeugung, Code Interpreter, gehostete Shell, Patch-Anwendung, Skills, Computernutzung, MCP und Werkzeugsuche als unterstützte Responses-API-Werkzeuge. Unterstützung bedeutet nicht automatisch Aktivierung, Autorisierung oder Eignung für Ihre Anwendung.
Was eine Demo nicht über die API beweist
Matt Shumers Bericht beschreibt große Experimente mit koordinierten Sitzungen und hohem Tokenverbrauch; lange Läufe konnten stagnieren. Eine Integration sollte deshalb Fortschritt zur Abnahme ebenso wie Laufzeit messen. Ein weiterhin ausgebender Prozess verbessert möglicherweise das Ergebnis nicht mehr.
Claire Vos Episodennotizen betonen Browser-QA zusätzlich zur Implementierung. Für API-Anwendungen lautet die entsprechende Frage, ob die Laufzeitumgebung das fertige Ergebnis prüfen kann. Codeaufgaben brauchen Verhaltensprüfungen, Dokumentaufgaben Quellenkontrollen. Reiner Modelltext reproduziert keine werkzeugreiche Demonstration.
Diese Erfahrungen helfen beim Testentwurf. Sie bestätigen weder API-Parameter noch Abrechnung oder eine allgemeine Abschlussquote.
Minimaler Responses-API-Aufruf
Nutzen Sie die vom aktuellen Quickstart empfohlene Version des offiziellen OpenAI-SDKs. Ein minimaler JavaScript-Aufruf sieht so aus:
import OpenAI from "openai";

const client = new OpenAI();

const response = await client.responses.create({
  model: "gpt-6-astra",
  reasoning: { effort: "medium" },
  input: [
    {
      role: "developer",
      content: "Return a concise, source-grounded decision brief.",
    },
    {
      role: "user",
      content: "Compare the attached proposals against the approval criteria.",
    },
  ],
});

console.log(response.output_text);
Bewahren Sie API-Schlüssel in verwalteten Umgebungsgeheimnissen auf, nicht in Prompts, Quellcode, Clientcode oder Logs. Prüfen Sie das echte Antwortobjekt. output_text ist nicht zwingend die einzige Ausgabe; Werkzeugaufrufe und strukturierte Elemente können ebenfalls enthalten sein.
Denkaufwand bewusst wählen
GPT-6 Astra unterstützt none nicht. Beginnen Sie bei der Bewertung mit low oder medium und erhöhen Sie nur, wenn die Qualitätsverbesserung Latenz und Kosten rechtfertigt. OpenAIs Tabellen nennen die besten Werte über die Aufwandsstufen hinweg. Ein hervorgehobener Benchmark garantiert daher nicht dasselbe Resultat mit Ihrer Einstellung.
Eine mögliche Verteilung:
| Aufgabensignal | Anfangsstufe |
|---|---|
| Kurze, begrenzte Transformation | Low |
| Analyse mehrerer Quellen mit klaren Kriterien | Medium |
| Schwierige Planung, Programmierung oder Werkzeugkoordination | High |
| Seltener, wertvoller Fall nach erfolglosen niedrigeren Stufen | Xhigh oder max |
Protokollieren Sie die Stufe bei jeder Ausführung. Sonst kann eine spätere Regression wie ein Modellwechsel aussehen, obwohl nur die Konfiguration anders ist. Begrenzen Sie auch die Ausgabe: Verborgenes Denken wird als Ausgabe berechnet, und hoher Aufwand kann bereits vor Abschluss der sichtbaren Antwort erhebliche Kosten verursachen.
Denkaufwand im Gespräch ändern
OpenAI dokumentiert configuration_update-Eingabeelemente, die den Aufwand ändern und den Cache-Präfix erhalten. Das ist hilfreich, wenn eine einfache Sitzung auf einen schwierigen Sonderfall trifft oder eine komplexe Phase in Routinearbeit übergeht.
Die Anwendung sollte den zeitlichen Verlauf der Konfiguration erfassen, nicht nur den Endwert. Ein Lauf von low zu max hat andere erwartete Kosten und Latenzen als einer, der bei low bleibt.
Asynchrone Werkzeugaufrufe
Mit einer asynchronen Funktion oder einem eigenen Werkzeug kann Astra unabhängig vom Ergebnis weiterarbeiten, während die Anwendung den Aufruf ausführt. Geben Sie das fertige Ergebnis mit der ursprünglichen Aufruf-ID zurück.
Dabei entstehen typische Probleme verteilter Systeme:
- Ergebnisse kommen nach Abbruch oder Änderung der Aufgabe an.
- Zwei Aufrufe enden in anderer Reihenfolge.
- Ein Timeout tritt nach einer erfolgreichen externen Schreibaktion auf.
- Die Wiederholung eines nicht idempotenten Aufrufs dupliziert die Aktion.
- Das Modell beendet alle unabhängigen Arbeiten, während ein nötiger Aufruf noch offen ist.
Speichern Sie eine Zustandsmaschine mit pending, completed, failed, cancelled und expired. Verwenden Sie Idempotenzschlüssel bei Schreibzugriffen, prüfen Sie das maßgebliche System vor einem erneuten Versuch und verwerfen Sie verspätete Ergebnisse veralteter Aufgabenversionen.
Steuerung während eines Turns
Über WebSocket kann die Anwendung zusätzliche Nutzeranweisungen senden, während Astra arbeitet. Lange Aufgaben lassen sich dadurch ohne Neustart korrigieren. Die Absicht muss dabei versioniert werden.
Speichern Sie jede Richtungsänderung mit Zeitstempel und markieren Sie dadurch ungültige offene Aktionen. Ändert sich die Zielgruppe eines Berichts, kann das Schreiben weitergehen. Ändern sich Konto oder Ziel einer externen Aktion, pausieren Sie bis zur Prüfung und Freigabe des neuen Umfangs.
Strukturierte Ausgaben und Werkzeuge
Structured Outputs eignet sich, wenn nachfolgender Code ein Schema benötigt. Das Schema prüft die Form, nicht die Wahrheit. Gleichen Sie Kennungen mit erlaubten Werten ab, berechnen Sie Summen unabhängig und prüfen Sie Quellen vor Annahme des Objekts.
Entwerfen Sie eng begrenzte Werkzeuge:
Bevorzugen: create_draft_invoice(customer_id, line_items)
Vermeiden:  run_shell(command)

Bevorzugen: search_approved_project_sources(query, project_id)
Vermeiden:  browse_any_url(url)
Identität, Mandantengrenzen, erlaubte Argumente, Budgets und Bestätigung muss die Anwendung durchsetzen, nicht nur der Prompt. Lesen Sie die KI-Agenten-Architektur, bevor Produktionssysteme angebunden werden.
Computernutzung
GPT-6 Astra ist laut OpenAI sein stärkstes Computernutzungsmodell. Visuelle Oberflächen sind jedoch nicht deterministisch und können sich zwischen Beobachtung und Aktion verändern. Behandeln Sie Klicks und Tastendrücke als vorgeschlagene Operationen:
- Begrenzen Sie Anwendung, Konto und Aufgabenbereich.
- Erfassen Sie den Zustand, auf dem die Entscheidung basiert.
- Zeigen Sie folgenreiche Änderungen vor der Ausführung.
- Fordern Sie Bestätigung für Senden, Löschen, Veröffentlichen, Kaufen oder Rechteänderungen.
- Prüfen Sie den Ergebniszustand durch einen unabhängigen Lesezugriff.
- Bewahren Sie genug Nachweise für Diagnose und Rücknahme eines Fehlers auf.
Der Leitfaden zu Desktop-KI-Agenten erläutert, wie lokaler Computerzugang das Risikomodell verändert.
GPT-6-API-Preise
OpenAI nennt folgende Astra-Preise je Million Texttokens:
| Kostenart | Standardtarif |
|---|---|
| Eingabe | 10,00 US-Dollar |
| Gecachte Eingabe | 1,00 US-Dollar |
| Cache-Schreibzugriff | 12,50 US-Dollar |
| Ausgabe | 50,00 US-Dollar |
Über 272.000 Eingabetokens gelten für die gesamte Anfrage doppelte Eingabe- und Cachesätze sowie das 1,5-Fache der Ausgaberate. Cache-Schreiben kostet das 1,25-Fache ungespeicherter Eingaben. Batch und Flex liegen bei 50 % von Standard, Fast beim Doppelten des geltenden Preises. Werkzeugaufrufe können weitere Gebühren verursachen.
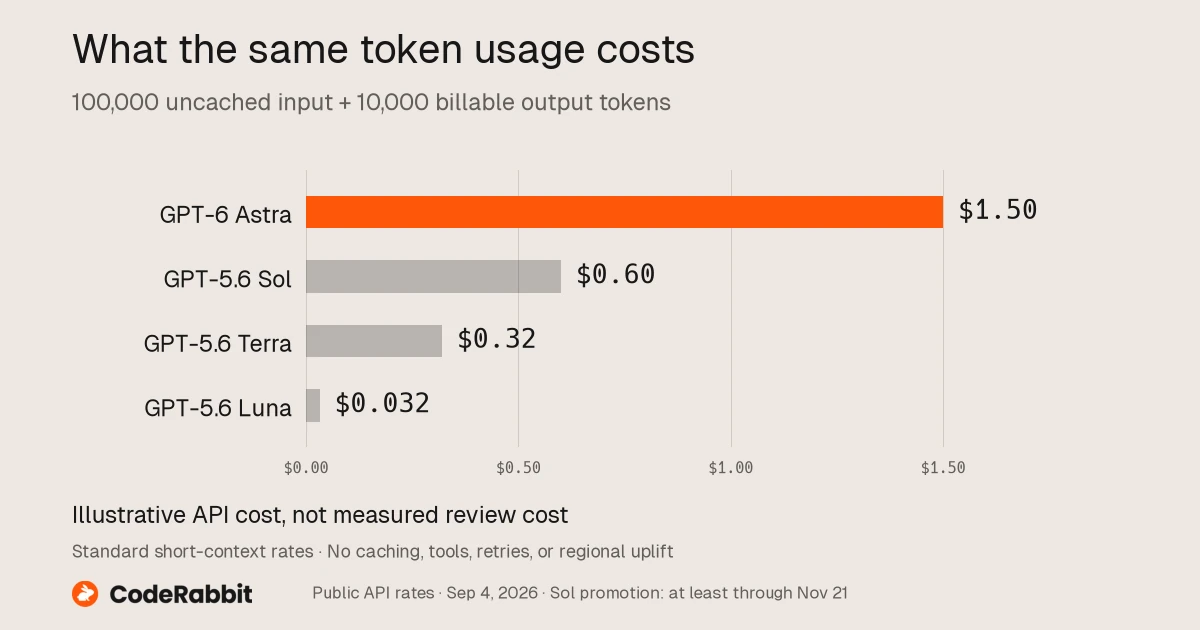
Kostenbeispiel von CodeRabbit mit festen Tokenmengen und Preisen vom 4. September 2026. Keine gemessenen Kosten je abgeschlossener Aufgabe.
Kostenbeispiel
Eine Standardanfrage mit 80.000 nicht gecachten Eingabetokens und 8.000 Ausgabetokens kostet ungefähr:
Eingabe: 80.000 / 1.000.000 x 10 USD = 0,80 USD
Ausgabe:  8.000 / 1.000.000 x 50 USD = 0,40 USD
Modell-Zwischensumme: 1,20 USD
Werkzeuge, Cache-Schreiben, Wiederholungen und Prüfung sind nicht enthalten. Oberhalb der Langpromptgrenze verändern die Multiplikatoren die gesamte Rechnung.
Prompt-Caching gezielt nutzen
Stellen Sie stabile Regeln, Schemata und gemeinsame Quellen vor häufig wechselnde Nutzerinhalte, damit Anfragen einen Präfix wiederverwenden. Erfassen Sie Cache-Lese- und Schreibmengen getrennt. Behalten Sie keine irrelevanten Informationen nur für eine höhere Trefferrate: Sie können ablenken und Zugriffsregeln erschweren.
Versionieren Sie den Präfix. Ändern sich Richtlinie, Quelle oder Schema, muss die Ausführung nachvollziehbar zeigen, welche Version verwendet wurde.
Ratenlimits und Zugang
Die GPT-6-Modellseite führt Grenzen nach Nutzungsstufe auf und schließt den kostenlosen API-Tarif aus. Limits können mit Nutzung und Ausgaben steigen. Planen Sie 429-Antworten, Rückstaukontrolle, Abbrüche und ein bewusst gewähltes Ersatzmodell ein. Wechseln Sie bei sicherheitskritischen oder schemasensiblen Aufgaben niemals unbemerkt das Modell, ohne den Wechsel zu erfassen und die Ausgabe erneut zu prüfen.
Laut Ankündigung unterstützt Astra Zero Data Retention für berechtigte API-Kunden. Berechtigung, Datenresidenz und Sicherheitsverarbeitung sind getrennte Anforderungen und müssen für Konto und Region einzeln geprüft werden.
OpenAI warnt außerdem, dass erweiterte Schutzmaßnahmen legitime Arbeit stoppen können. Ein früher Codex-Erfahrungsbericht dokumentiert gewöhnliche Repository-Aufgaben, die spät durch eine Cyberrichtlinie endeten. Behandeln Sie das als mögliches Fehlerszenario, nicht als gemessene Häufigkeit. Erfassen Sie Abbruch, verlorene Zeit, Konfiguration und ob der Ersatzweg sicher abschließen konnte.
Migrationscheckliste
- Fixieren Sie 20 bis 50 repräsentative Aufgaben und erwartete Ergebnisse.
- Erfassen Sie aktuelles Modell, Prompts, Werkzeuge, Aufwand, Latenz und Kosten je Abnahme.
- Ändern Sie zunächst nur das Modell für eine faire Vergleichsbasis.
- Prüfen Sie das neue Verhalten vor einer Prompt-Neufassung.
- Testen Sie langen Kontext mit fehlenden, widersprüchlichen und veralteten Belegen.
- Prüfen Sie Werkzeugverweigerung, Timeouts, doppelte Ergebnisse und Abbrüche.
- Testen Sie Prompt Injection in Dateien und Webinhalten.
- Validieren Sie Structured Outputs über reine Schemakonformität hinaus.
- Setzen Sie Budget und Stoppbedingungen für jeden Lauf.
- Leiten Sie vor einer Ausweitung nur einen kleinen Anteil geeigneter Arbeit um.
- Fixieren Sie bei wichtigem Reproduktionsbedarf einen verfügbaren passenden Modell-Snapshot.
- Halten Sie einen getesteten Ersatz- und Rollbackweg bereit.
Für die Modellentscheidung lesen Sie GPT-6 vs. GPT-5.6.
Vorlage für die Produktionsbewertung
Ablauf: [Name und Verantwortlicher]
Modell: gpt-6-astra
Denkaufwand: [low/medium/high/xhigh/max]
Prompt-Version: [ID]
Quellen: [IDs, Rechte, Abrufdatum]
Werkzeuge: [Schemata, Bereiche, Timeouts, Idempotenz]
Ausgabevertrag: [Schema und semantische Prüfungen]
Menschliche Freigaben: [bestätigungspflichtige Aktionen]
Budgets: [Tokens, Werkzeuge, Kosten, Zeit]
Fehlerbehandlung: [Wiederholung, Ersatz, Stopp, Eskalation]
Abnahme: [Qualitäts-, Sicherheits-, Latenz- und Kostengrenzen]
Audit: [Eingaben, Aufrufe, Freigaben, Ausgaben, Prüfentscheidung]
Ottermind kann Bewertungsauftrag, Quellen, Testergebnisse, Prüfentscheidungen und Endprodukt in einem verbundenen Workspace halten. Beginnen Sie mit einem begrenzten Ablauf und klären Sie den Aufgabenvertrag mit dem Prompt-Engineering-Leitfaden, bevor Sie Werkzeuge hinzufügen.
Häufige Fragen
Wie heißt das Modell in der GPT-6-API?
Verwenden Sie gpt-6-astra in der OpenAI-API.
Chat Completions oder Responses API?
Die Modellseite führt beide Endpunkte auf, doch OpenAIs GPT-6-Leitfaden nutzt Responses API, von der die neueren Ablaufmerkmale abhängen. Für neue werkzeugbasierte Anwendungen ist Responses vorzuziehen.
Unterstützt GPT-6 Fine-Tuning?
Die aktuelle Modellseite nennt keine Unterstützung für Fine-Tuning.
Kann GPT-6 Bilder verarbeiten?
Ja, Bildeingaben sind aufgeführt. Direkte Bildausgabe ist keine Modellmodalität, Bilderzeugung steht jedoch als Werkzeug zur Verfügung.
Wie viel kostet eine Anfrage?
Das hängt von Ein- und Ausgabe, Cache, Langpromptaufschlägen, Modus, Werkzeugen und Wiederholungen ab. Am 7. September 2026 liegen die Standard-Basissätze bei 10 US-Dollar je Million Eingabetokens und 50 US-Dollar je Million Ausgabetokens.
Kann jede Anfrage eine Million Tokens enthalten?
Die Kontextkapazität beträgt 1,05 Millionen Tokens, ist aber keine Empfehlung zur vollständigen Nutzung. Ab 272.000 Eingabetokens gelten andere Preise. Quellenwahl und Tests bleiben auch bei langen Prompts notwendig.
Ist autonomer Werkzeugeinsatz sicher?
Kein Modell sollte uneingeschränkte Werkzeuge erhalten. Erzwingen Sie minimale Rechte, Argumentprüfung, Bestätigung folgenreicher Aktionen und Auditierung beobachtbaren Verhaltens. Die Sicherheitscheckliste für KI-Agenten ist ein Ausgangspunkt.
