مقارنة النماذج
GPT-6 أم GPT-5.6؟ مقارنة Astra وSol للعمل الفعلي
GPT-6 Astra مرشح أقوى للأعمال الأصعب متعددة المراحل، بينما يبقى GPT-5.6 Sol خيارًا افتراضيًا عمليًا عندما تكون السرعة والإتاحة والتكلفة أهم من أقصى قدرة. تظهر نتائج OpenAI أكبر مكاسب Astra في تشغيل الحاسوب والأتمتة واسترجاع السياق الطويل والعلم والأمن السيبراني. ليست كل الطلبات متساوية في الاستفادة.
اختر وفق تكلفة المهمة المقبولة لا رقم النموذج. إذا كان GPT-5.6 ينجز الطلب المعتاد بدقة وسرعة وسعر منخفض، فقد يضيف الانتقال تكلفة فقط. أما الإخفاق المتكرر في تنسيق الأدوات أو التفكير المعقد أو المصادر الطويلة أو المخرجات المهنية فيستحق تجربة Astra بشروط مضبوطة.
المصادر: إعلان GPT-6; مواصفات النموذج; دليل المطور; ملخص الأمان; Astra لدى Artificial Analysis; مقارنة GPT-5.6 Sol; اختبار تصحيح الأخطاء عبر API; مقارنة برمجية مستمدة من الإنتاج. روجعت في 7 سبتمبر 2026.
مقارنة سريعة
| المعيار | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| الأنسب | أعمال صعبة من البداية للنهاية | أعمال عامة قوية بتكلفة تشغيل أقل |
| نافذة السياق | 1,050,000 رمز | راجع مواصفات النسخة المستخدمة حاليًا |
| أقصى إخراج | 128,000 رمز | راجع مواصفات النسخة المستخدمة حاليًا |
| جهد الاستدلال | من low إلى max، دون none | خيارات واسعة تتغير باختلاف المنتج |
| الإمكانات الجديدة | أدوات غير متزامنة وتوجيه أثناء الجولة وتغيير الاستدلال في المحادثة | مسارات مستقرة للأدوات وResponses API |
| إدخال API Standard | 10 دولارات لكل مليون رمز | أقل؛ تحقق من السعر الحالي |
| إخراج API Standard | 50 دولارًا لكل مليون رمز | أقل؛ تحقق من السعر الحالي |
| الوصول | طرح تدريجي دون مستوى API مجاني | انتشار أوسع في منتجات OpenAI المؤهلة |
| نتيجة الذكاء المستقلة | 55 عند max | 51 عند max |
| سرعة الإخراج المستقلة | 64.3 رمزًا في الثانية عند max | نحو 76 رمزًا في الثانية عند max |
| تكلفة مهمة المؤشر المستقلة | 2.57 دولار عند max | 1.25 دولار عند max |
| أسلوب التشغيل | تخصيصه أولًا للعمل الصعب عالي القيمة | إبقاؤه مرجعًا للأعمال المعتادة والمختلطة |
هذه قياسات لحظية من Artificial Analysis تتغير مع تحديث الخدمات والاختبارات. تظهر زيادة محدودة في الذكاء العام وإخراجًا أبطأ ونحو ضعف تكلفة المهمة، لا قفزة شاملة في كل المجالات. استخدم صفحات النماذج الحالية عند حساب الشراء.
الاختبارات المستقلة مقابل خطاب الإطلاق
يصف تقرير Claire Vo المبكر تقدمًا في ميزة ChatPRD تعثرت مع Sol وFable. يدعم اختبار Astra في العمل المتوقف، لكن النجاحات المختارة لا تقيس التحسن المعتاد. حافظ على المهمة وحالة المستودع ومعايير القبول عند إعادة المقارنة.
تفضل مراجعة Matt Shumer Astra للهندسة اليومية وClaude للعمل البصري. توضح كيف يمكن أن يصبح نموذج باهظ خيارًا أساسيًا إذا كانت سهولة التواصل وقلة الإشراف أهم من سرعة التوليد. لكنها تظل رأيًا شخصيًا، لا مقارنة محكومة بين Astra وSol.
لذلك تستهدف توصيتنا فرقًا تدير ميزانية: أبقِ النموذج العامل أساسًا، ثم جرّب Astra في الحالات التي تتطلب أكبر تدخل. وقد يختار الأفراد ذوو الأعمال المختلفة خيارات أخرى معقولة.
تركز مكاسب OpenAI الأكبر على الوكلاء واستخدام الحاسوب والسياق الطويل. أما النتيجة العامة لدى Artificial Analysis فهي أضيق: 55 لـAstra max مقابل 51 لـSol max. أنتج Astra رموزًا أقل من وسيط المجموعة، لكن إخراجه أبطأ من Sol وانتظار أول رمز عند max طويل.
في اختبار API واحد، شخّص Astra وثلاث نسخ GPT-5.6 المشكلة نفسها. قدم Astra أفضل تحفظ وخطة تأكيد، لكنه استغرق نحو ضعف الوقت وكلف قرابة أربعة أمثال Sol. يفيد ذلك إذا كان حذف التحفظ قد يسبب خطأ مكلفًا، لا إذا كان المطلوب مجرد أمر أو سبب مرجح.
قارنت تجربة إنتاج منفصلة Astra مع GPT-5.6 Terra لا Sol. نجح الاثنان في الاختبارات الموجودة، لكن Terra أفسد حالات ترقيم صفحات مترابطة بينما حافظ عليها Astra وأضاف اختبارًا. غيّر الكاتب توزيع العمل، فخصّص المهام المترابطة متعددة المجالات لـAstra وأبقى التعديلات المعتادة والآلية للنماذج الأرخص. هذا أكثر استنادًا للأدلة من استبدال الجميع.
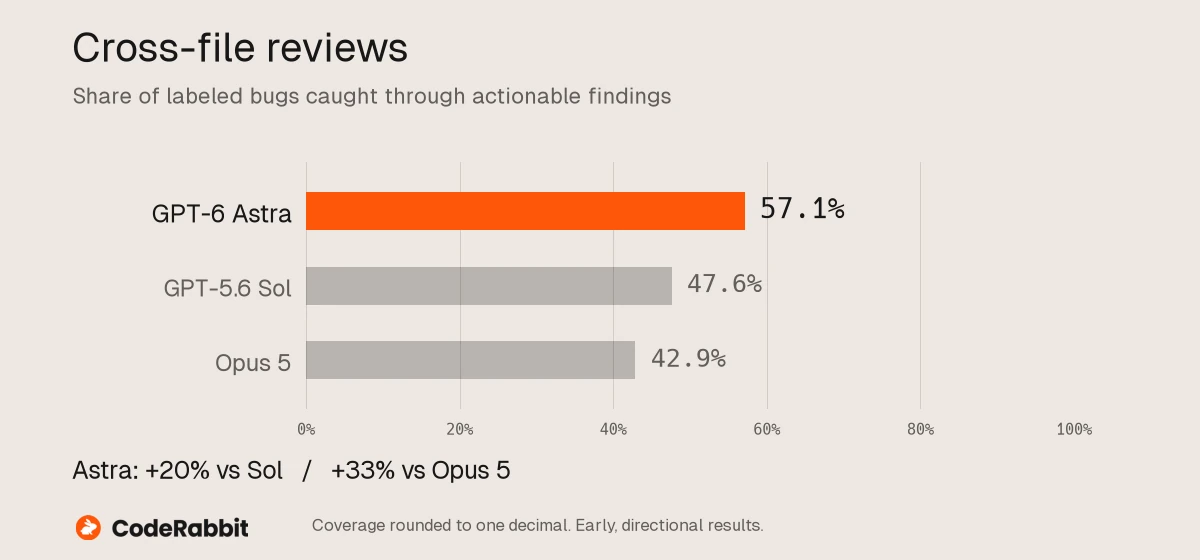
نتائج المراجعة بين الملفات التي نشرتها CodeRabbit. هي نتائج أولية ولا تقيس جودة المراجعة الإجمالية.
أين تظهر أوضح مكاسب GPT-6؟
تساعد اختبارات الإطلاق في المقارنة لأن الجهة نفسها اختبرت النموذجين. لكنها تتضمن تقييمات داخلية وتعرض أفضل النتائج بين مستويات الجهد؛ وقد تختلف بيئة الإنتاج في تعليمات النظام والأدوات.
| التقييم | GPT-6 Astra | GPT-5.6 Sol | الدلالة المحتملة |
|---|---|---|---|
| OSWorld 2.0 غير المتصل | 72.6% | 65.7% | استخدام أفضل لبيئات سطح المكتب |
| AutomationBench | 41.4% | 18.1% | تحسن كبير في الأتمتة متعددة الخطوات |
| Terminal-Bench 4.0 | 57.9% | 37.3% | هندسة أفضل عبر الطرفية |
| مهام ترحيل قواعد بيانات داخلية | 63.9% | 42.7% | إمكانات في تعديلات طويلة تتطلب حفظ الحالة |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | استدلال رياضي متقدم أقوى |
| MRCR v2، نطاق 512K–1M | 96.3% | 73.8% | استرجاع أفضل في السياقات شديدة الطول |
| ARC-AGI-3 | 99.9% | 7.8% | تحسن معلن كبير في المهام التفاعلية الجديدة |
لا يتصدر Astra جميع المقارنات أمام كل المنافسين. تشير قراءة DataCamp إلى تأخره عن Claude Fable 5.1 في Humanity's Last Exam مع الأدوات، وإلى أن نتيجة 99.9% في ARC-AGI-3 تعتمد على بيئة ذات حالة ومحوّل خاص بالمزود. لا تتوقع تكرارها بطلب API عديم الحالة. استخدم النتائج لاختيار الاختبارات، لا لاتخاذ قرار النشر مباشرة.
استخدام الحاسوب ومسارات الوكلاء
هذا أقوى مبرر لتجربة GPT-6. صُمم للعمل بين الشفرة والمتصفح والمستندات والجداول والعروض والبرامج المتخصصة. تسمح الأدوات غير المتزامنة باستدلال مستقل أثناء تشغيل أداة بطيئة، ويتيح التوجيه أثناء الجولة تصحيح جلسة طويلة دون إعادة تشغيلها.
يدعم Sol الأدوات والوكلاء بالفعل. احتفظ به إذا كان التسلسل قصيرًا والصلاحيات محدودة والنتيجة مقبولة. جرّب Astra إذا ضاع سياق التقدم أو أسيء فهم التعليمات المتغيرة أو تعثر التنقل بين البرامج أو كثرت المحاولات.
النموذج الأقوى لا يلغي البنية المحيطة. التحقق من الهوية ومخططات الأدوات والصلاحيات والحالة والتدقيق والموافقة والتراجع تخص التطبيق. يوضح دليل بنية وكلاء الذكاء الاصطناعي هذا الحد.
السياق ليس ذاكرة دائمة
يمكن لنافذة Astra البالغة 1.05 مليون رمز استيعاب مصادر كثيرة، لكنها سعة مؤقتة للطلب. لا تصبح تلقائيًا ذاكرة صحيحة ومستديمة عن العميل أو المشروع أو السياسة. تتطلب الذاكرة الطويلة تعريف المصادر وقواعد تحديث وحل تعارض وحذفًا وضبط وصول ووضوحًا للمستخدم.
استخدم السياق الطويل لمجموعة محدودة تحتاج قراءة مشتركة، والاسترجاع لمجموعة أكبر ومتغيرة، وحالة مشروع دائمة للقرارات والمخرجات المعتمدة بين التشغيلات. يشرح دليل إدارة المعرفة بالذكاء الاصطناعي حفظ المنشأ بدل اعتبار الملخصات المولدة مرجع الحقيقة.
قارن تكلفة العمل المنجز
تكلف API Standard 10 دولارات لكل مليون إدخال و50 دولارًا لكل مليون إخراج. فوق 272,000 رمز إدخال ترتفع تعرفة الطلب كله. وللذاكرة المؤقتة والأدوات وFast وBatch وFlex أسعار خاصة.
قد يكون Astra أوفر في مهمة صعبة إذا خفّض الرموز أو المحاولات أو المراجعة البشرية. لكن حتى الإجابة المثالية قد لا تكون اقتصادية في تصنيف جماعي لا يستفيد من أقصى الاستدلال.
يوضح اختبار التصحيح المقايضة: نحو 0.194 دولار و75.5 ثانية لـAstra، مقابل 0.048 دولار و39.3 ثانية لـSol. التشخيص الأساسي واحد، والميزة في حدود أدق وخطة تحقق. لا يحدد طلب واحد متوسطًا عامًا، لكنه يوازن دعاوى كفاءة الرموز.
استخدم الحساب التالي:
تكلفة المهمة المقبولة =
  إدخال النموذج + إخراجه + التخزين المؤقت + استدعاءات الأدوات
  + المحاولات الفاشلة + وقت المراجعة + أعمال التصحيح

قيمة الانتقال =
  أخطاء جرى تجنبها + عمل جرى توفيره + اختصار زمن الإنجاز
  - التكلفة الإضافية لكل مهمة مقبولة
قس النموذجين على المدخلات نفسها. لا تفترض أن المراجعة مجانية؛ فهي غالبًا أكبر تكلفة خفية.
الأمان والتحكم
تقول OpenAI إن Astra أكثر مقاومة لكسر القيود وحقن التعليمات وتجاوز النطاق من Sol. وفي محاكاة داخلية لأكثر من 54,000 مهمة Codex، انخفضت إشارات سوء التوافق الأخطر إلى نحو النصف. لكنها أبلغت أيضًا عن تراجع قابلية مراقبة الاستدلال المكتوب مقارنة بـSol.
يوصي خبراء تحدثوا إلى TechRadar بمراقبة الأفعال المرئية والقدرة على إيقاف الوكيل أثناءها بدل الاعتماد على التفكير المكتوب. ويصف تقرير مبكر من المجتمع إيقاف جلسات برمجة عادية بعد وقت طويل بواسطة مصنفات الأمان. هو وصف فردي، لكن OpenAI نفسها تقر باحتمال قطع العمل المشروع. ضمّن الإنذارات الخاطئة والوقت الضائع في المقارنة.
ينبغي أن يتضمن التقييم ما يلي:
- اختبر الأفعال والنتائج، لا مدى الاطمئنان إلى نص التفكير.
- امنح كل أداة مخططًا محدودًا وصلاحيات واضحة.
- أضف مصادر عدائية ومهام مستحيلة.
- اطلب تأكيدًا للإرسال والحذف والشراء والنشر وتغيير الوصول.
- احتفظ بسجل مستقل للمدخلات والاستدعاءات والموافقات والمخرجات وقرار المراجع.
راجع قائمة أمان الوكلاء قبل منح أي نموذج صلاحية كتابة.
أي نموذج تختار؟
اختر GPT-6 Astra عندما
- تتطلب المهمة عادة محاولات متعددة أو تدخلًا بشريًا.
- يكون تشغيل الحاسوب أو تنسيق الأدوات جوهريًا.
- تكون المصادر طويلة جدًا وإغفال المعلومات مكلفًا.
- يكون التسليم وثيقة أو تحليلًا أو عرضًا أو تغييرًا برمجيًا عالي القيمة.
- تظهر اختباراتك تحسنًا قابلًا للقياس في النتائج المقبولة.
احتفظ بـGPT-5.6 Sol عندما
- يحقق المسار الحالي أهداف الجودة والاعتمادية.
- تهيمن السرعة أو اقتصاديات الحجم الكبير على القرار.
- تكون المهمة قصيرة أو متكررة أو منظمة أو سهلة التحقق.
- لا تلائم إتاحة GPT-6 وحدوده متطلبات الخدمة.
- لم يؤسس الفريق آلية تقييم ومراجعة بعد.
متى توزع العمل بينهما؟
لا تحتاج معظم الأنظمة إلى انتقال ثنائي. ابدأ بالنموذج الأرخص ثم صعّد بناء على مؤشرات قابلة للرصد: حجم المصادر أو المخاطر أو فشل التحقق أو عدد الأدوات أو مستوى الجودة المطلوب. أبقِ القاعدة بسيطة بما يكفي لتدقيقها.
قالب مقارنة مباشرة
العملية: [الاسم]
النموذج الحالي: GPT-5.6 Sol
المرشح: GPT-6 Astra
الحالات: [20-50 مهمة ممثلة]

امنح كل بند درجة من 0 إلى 2:
- صحة الحقائق والحسابات
- الالتزام بالقيود المطلوبة
- مخرج كامل وقابل للاستخدام
- احترام النطاق المصرح
- وضوح المصادر والشكوك

سجّل منفصلًا:
- الوقت الفعلي
- تكلفة الإدخال/الإخراج/التخزين المؤقت/الأدوات
- المحاولات والإخفاقات
- دقائق المراجعة والتعديلات

لا تنشر إلا إذا:
- لم يظهر تراجع حرج في الأمان أو النطاق
- كان تحسن الجودة مهمًا عمليًا وإحصائيًا
- ناسبت تكلفة المهمة المقبولة الحجم المتوقع
خطة نشر عملية
- ثبّت مدخلات الإنتاج الممثلة ومعايير القبول.
- شغّل النموذجين بأدوات وصلاحيات متكافئة.
- أخفِ هوية النموذج عن المراجع إن أمكن.
- افحص الإخفاقات لا المتوسطات وحدها.
- وجّه حصة صغيرة من الأعمال المناسبة إلى Astra.
- راقب التكلفة والتصحيحات والحوادث وتدخلات المستخدم.
- وسّع فقط المجالات التي تواصل تقديم قيمة.
يمكن لـOttermind جمع المصادر والمقارنات وقرارات المراجعة والمخرجات النهائية في مشروع واحد. قيّم المسار الكامل داخل مساحة عمل لوكلاء الذكاء الاصطناعي بدل جمع لقطات محادثات متفرقة.
الأسئلة الشائعة
هل Astra أفضل دائمًا من Sol؟
لا. هو أقوى في تقييمات كثيرة، لكن Sol قد يكون أسرع وأرخص وأسهل وصولًا وكافيًا للعمل المعتاد.
هل يستحق سعر API الأعلى؟
قد يستحقه في العمل الصعب إذا قلّت المحاولات أو المراجعة أو الأخطاء. احسب الأدوات والعمل البشري ضمن تكلفة المهمة المقبولة.
هل يستبدل GPT-6 نموذج GPT-5.6؟
ليس تلقائيًا. تواصل OpenAI توفير GPT-5.6. يمكن تخصيص العمل اليومي له وترك الأصعب لـGPT-6.
أيهما أفضل للبرمجة؟
تنشر OpenAI نتائج أعلى لـAstra في Terminal-Bench 4.0 واختبارات أخرى، خصوصًا ترحيل قواعد البيانات الداخلي. اختبرهما على مستودعاتك وتعليماتك وضوابط CI.
أيهما أفضل للمستندات الطويلة؟
Astra يوفر سياقًا من 1.05 مليون رمز واسترجاعًا أفضل وفق OpenAI. هذا لا يلغي اختيار الوثائق والاستشهادات وحل التضارب والمراجعة البشرية.
هل أستطيع الاحتفاظ بالتعليمات عند الانتقال؟
ابدأ بعقد المهمة نفسه لمرجع عادل، ثم عدّل بعد فحص الإخفاقات. يتضمن دليل API لـGPT-6 قائمة انتقال.
