提示詞指南
ChatGPT 漫畫肖像:會誇張什麼、會在哪裡崩,以及六段站得住的提示詞
ChatGPT 收到一句話就能把照片畫成漫畫。你沒辦法在那句話裡指定「誇張到什麼程度」,所以把誇張寫成數字,送出前先檢查像不像。
選填
JPG / PNG / WebP
這是 Ottermind 的輸入框。填入描述和送出是兩個動作,不繼續進入 Studio 就不會生成任何圖片。
2026年11月14日 · 11 分鐘閱讀
可以。ChatGPT 能把一張照片畫成漫畫肖像,而且只要一句話。 OpenAI 的說明中心寫明,圖像生成與編輯在所有方案裡都屬於 ChatGPT 的功能,你可以上傳一張現成的圖片並描述想改的地方,生成可能需要幾分鐘(ChatGPT 裡的圖像功能,2026年11月14日核對)。這件事沒有隱藏門檻,也不是搜尋結果暗示的那種付費專屬功能。
麻煩的地方在控制。一張漫畫肖像其實是兩個決定:讓人一眼認得出,同時把「像他」的地方誇張出來。提示詞介面給這兩件事的,只有一個文字框。你只說「來一張漫畫肖像」,檔位就由模型替你挑,通常是那種客氣的卡通,誰也不得罪,偶爾是一張頭大到已經不像本人的圖。2026年2月那波職場漫畫肖像裡拿到好結果的人,並沒有用什麼祕密提示詞,他們只是檢查了那張臉。
這份指南是怎麼準備的: 官方頁面均於 2026年11月14日核對:OpenAI 的ChatGPT 裡的圖像功能與用量上限兩篇文章,以及 Wikipedia 的漫畫肖像(Caricature)條目(版本 1385434321)。文中的圖都是我們自己渲染的:一張虛構人物的照片,為本文生成,不是真人,2026年11月14日以 OpenAI 的 gpt-image-2.5-flare 模型透過 API 照下面引用的提示詞,畫了四個誇張檔位和五個失敗變體。我們用的是 API 而不是 ChatGPT 應用程式,這樣每一張都對著同一張參考照片;提示詞是照 ChatGPT 寫的,附上照片之後用法一樣。這次測試裡有一段提示詞被安全系統拒絕,我們在發生的地方照實寫了。圖上的說明文字、標註與裁切屬於編輯處理。那張輸入框的圖是本頁的實拍截圖。下面沒有任何一句是在斷言模型內部怎麼運作,也沒有任何生成圖被當成付費客戶的作品來呈現。
漫畫肖像是什麼,濾鏡不是什麼
漫畫肖像是一種肖像:既讓人認得出是誰,又把那些讓他跟別人不一樣的特徵誇張出來。Wikipedia 的定義說,它是一張以「簡化或誇張的方式」呈現對象特徵的圖像,並指出這個詞來自義大利文 caricare,意思是「裝載」,所以一張漫畫肖像是一張「裝得太滿的肖像」(漫畫肖像,2026年11月14日核對)。同一條目還提到,漫畫肖像可以捧人,也可以傷人。後面這一句,多數提示詞教學都跳過了。
這個定義給了你一個標準,用來檢查每一張回來的圖。風格濾鏡(卡通、動漫、水彩)改的是畫法,比例原封不動。漫畫肖像改的是比例,畫法是你另外單獨決定的事。這兩件事天天被混在一起,包括那些打著「漫畫肖像生成器」名號、實際上只給一個卡通濾鏡加一根滑桿的工具。
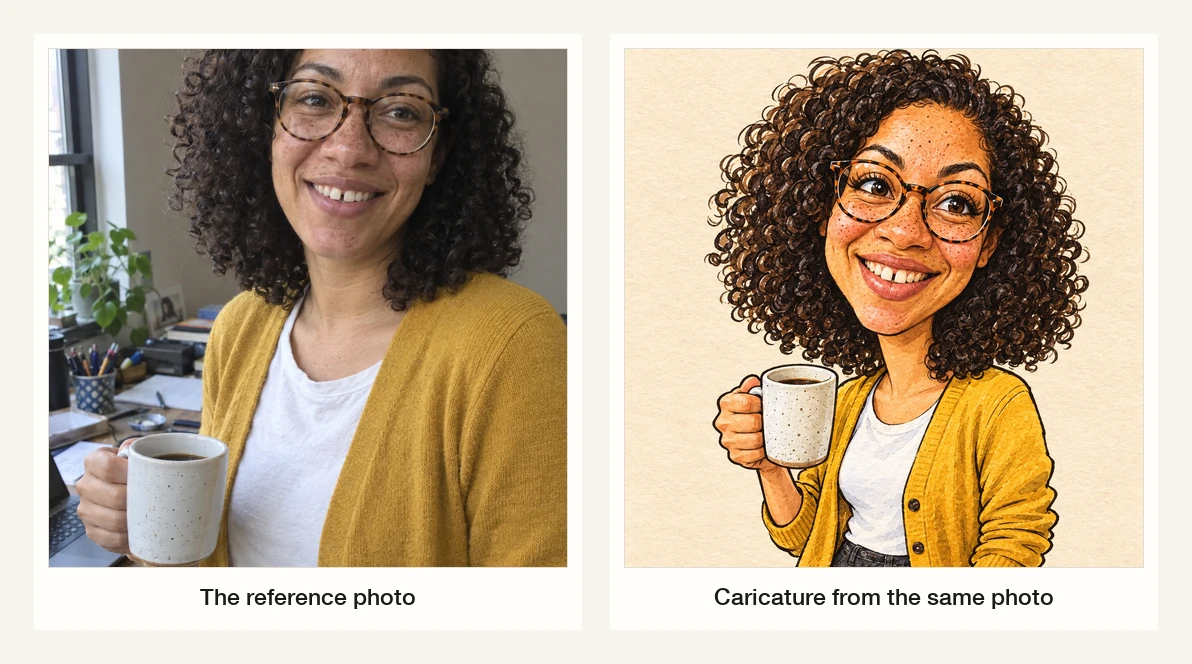
左:參考照片,一張為真實客戶照片做的生成替身。右:同一張臉在經典檔位的樣子。沒有任何地方被改成卡通;頭、眼睛和笑容被放大,其餘都留了下來,包括眼鏡、雀斑、牙縫和那件針織外套。為本文以 gpt-image-2.5-flare 渲染,2026年11月14日。標註由我們加上。
ChatGPT 拿到照片之後到底做了什麼
OpenAI 文件裡有三個細節,決定了這段需求該怎麼寫。
它改的是你給它的東西。 生成第一張圖之後,你可以選取畫面的一部分再描述要改什麼,也可以不選,直接在對話裡描述這處修改。OpenAI 另外提醒,選取範圍的標示不一定精準,編輯可能超出你選取的地方,所以一句「把笑容拉寬」也可能把眼鏡挪了位置。每次改完,把整張臉重看一遍,不要只看你瞄準的那一塊。
畫面比例由你決定。 現在的應用程式裡有比例選擇器,所以一個方形大頭貼和一張 16:9 的卡片來自同一次生成,而不是事後再裁。
你的限額是帳號層級的,不是模型層級的。 OpenAI 沒有公布一個適用於所有人的數字;方案額度顯示在帳號裡,而且從 2026年12月起,公司表示 Plus、Pro 和 Business 的額度將改成與 Codex 共用的 token 計量(用量上限,2026年11月14日核對)。一批按八到十次試畫來規劃,不要按五十次;開始之前先看一眼用量指示。
介面沒有給你的,是一根控制誇張程度的旋鈕。這只能靠句子寫出來,而句子裡有數字,比有形容詞管用。
誇張階梯:挑一個倍數,不要挑形容詞
「再好笑一點」不是一個模型能校準的指令。「頭部是真實比例的 1.5 倍,眼睛放大,笑容加寬,脖子收細」就是。我們把同一張照片按四個檔位各渲染了一次,看每一檔到底換來什麼。
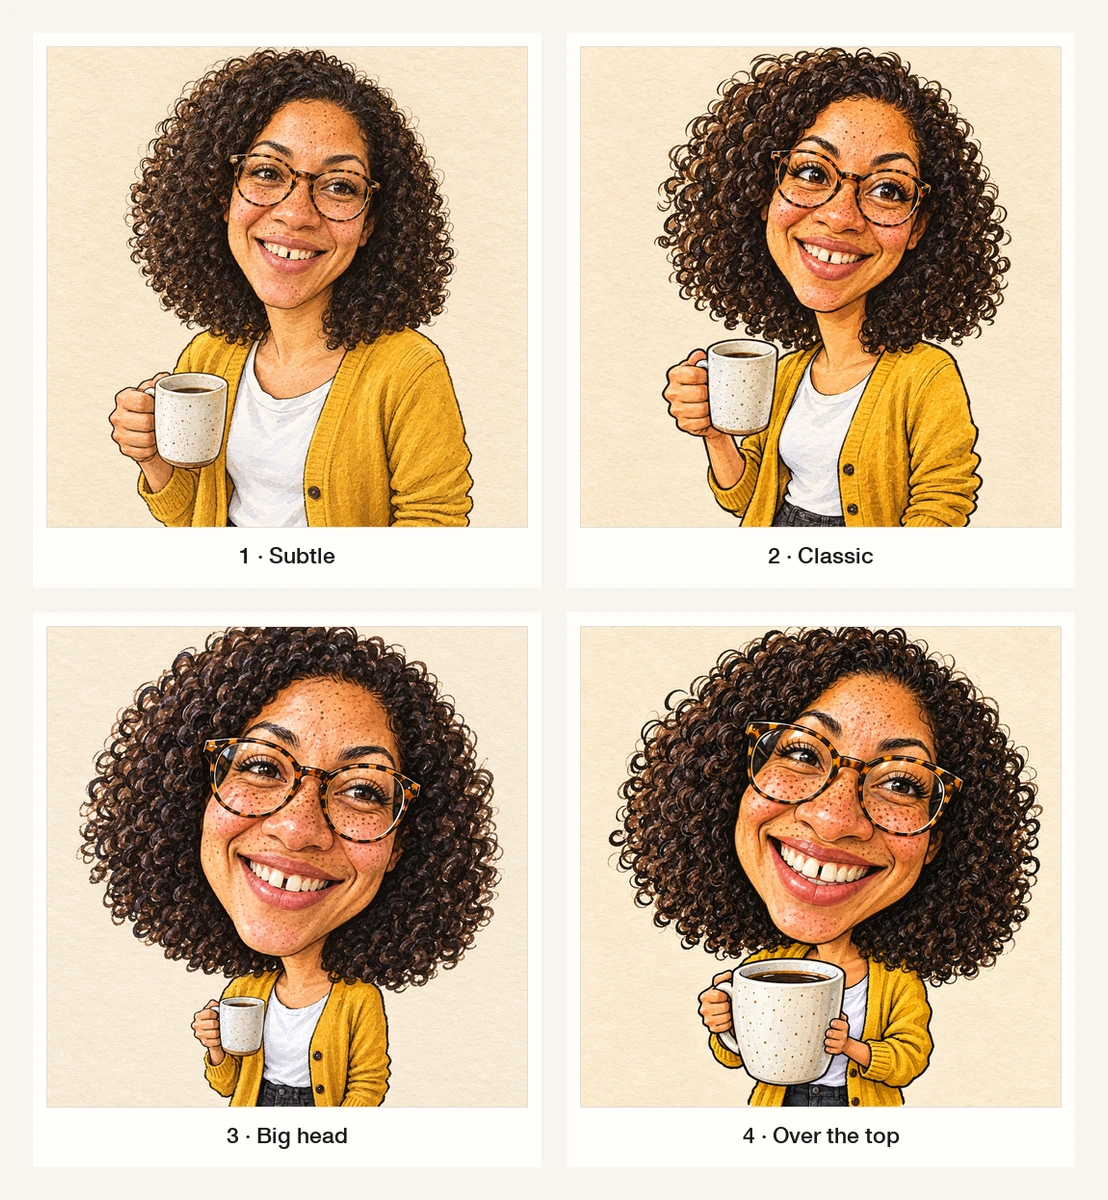
同一張參考照片出來的四張,每次只改一個數字。對象是生成的替身,不是真人。為本文以 gpt-image-2.5-flare 渲染,2026年11月14日;檔位的名字是我們取的。
| 檔位 | 改了什麼 | 適合用在哪 | 會在哪裡失敗 |
|---|---|---|---|
| 1 · 輕微 | 頭部約 1.2×,其餘幾乎照原比例 | 大頭貼、職場貼文、送給個性保守的人 | 讀起來像一張插畫肖像;沒有人會叫它漫畫肖像 |
| 2 · 經典 | 頭部約 1.5×,眼睛和笑容放大,脖子和肩膀縮小 | 卡片、請帖、社群貼文的預設選擇 | 依然客氣;不是大家期待的那種爆紅「大頭」 |
| 3 · 大頭 | 頭部約 2.5×,配一個緊實的身體 | 那股潮流的樣子;派對邀請、團隊頁面 | 道具開始縮小或消失;手的選擇變少 |
| 4 · 過火 | 頭部約 3×,手很小,笑到最大 | 縮圖、海報、朋友之間的玩笑 | 體面和相似度一起掉;用在工作上通常是錯的選擇 |
這道階梯上有兩點值得記住。第一,你要的倍數是一個方向,不是一次測量:第 3 檔和第 4 檔回來的差距比數字看起來要小。第二,也更有用的一點,相似度在四個檔位上都活了下來,因為參考照片夠強,而提示詞把字都花在描述那張臉上。當我們拿掉照片、只說「畫一張我的漫畫肖像」時,模型整個編了另一個人。做事的是照片,不是形容詞。
六段提示詞,每段只改一個變數
每個框只改一件事。其餘保持不變,否則你不會知道是哪一條指令起了作用。
1. 經典遊樂場檔位
對照組。它點名了媒材、檔位、比例,以及最關鍵的:哪些特徵不准動。
只以我上傳的這張照片為唯一參考。把照片裡的人畫成遊樂場風格的漫畫肖像,畫在有紋理的米白紙上:溫暖的黑色墨水線稿,平塗的水彩,看得見紙的紋理。經典檔位:頭部約為真實比例的 1.5 倍,眼睛放大,笑容加寬,脖子更細,肩膀更窄。頭髮的形狀與質感、眼鏡框、眉毛、鼻子、牙齒和衣服都嚴格照照片保留。腰部以上,四分之三側面,純紙張背景。不要文字,不要邊框,不要簽名。這一段改的是:畫法和誇張檔位兩件事。如果結果太平,先把頭的倍數提到 2.5,其他都別動。
2. 適合職場的版本
用在 LinkedIn 大頭貼,或是同事的離職賀卡上,玩笑得撐得住被他的主管看到。這段需求把比例留在幾乎老實的位置,把效果交給畫法。
用我上傳的這張照片。畫一張插畫肖像,只做最輕微的漫畫化誇張:保留真實比例,只把眼睛放大大約 10%,笑容稍微加寬,讓它看起來是一張手繪肖像,而不是一個玩笑。鬆一點的墨線,雙色水彩,暖色紙張。頭肩構圖,正方形裁切,平靜的中性背景,不要文字。這一段改的是:臉被推得多遠。其他,媒材、裁切、背景,都和第 1 段一樣。
3. 禮物版本,加上名字
一塊牌子會把一張畫變成一件實體物品。短文字現在可靠到可以試,但每一個字都得事後讀過一遍。
用我上傳的這張照片。畫一張生日禮物用的大頭漫畫肖像:頭部約為真實比例的 2.5 倍,配一個緊實的身體,兩隻手捧著一只大馬克杯,站姿,腳要露出來,墨水加水彩,暖色紙張。在人物下方加一條手繪緞帶橫幅,用大寫字母寫上名字“DANA”,再用很小的手寫字寫上“THANK YOU 2026”。兩處都嚴格照原樣拼寫,不要再加任何其他文字。這一段改的是:構圖和文字。它也是最可能需要第二輪的一段,所以在原尺寸下檢查拼寫。
4. 兩個人畫在同一張裡
多人圖壞的方式很具體:第二張臉會變成一張通用的臉。把兩個人的錨點都點名,並要求兩張臉用同一個檔位。
用我上傳的這張雙人合照。把兩個人畫進同一張漫畫肖像,並肩站著。兩張臉用同一個經典檔位誇張,各自用他自己最有辨識度的特徵,也就是讓人一眼認出他的那個地方,不要虛構任何東西:每個人的髮型、眼鏡、鬍子和衣服都對照照片。兩個人保持一樣的比例,真實的身高差要保留。墨水加水彩,暖色紙張,素色背景,不要文字。這一段改的是:模型怎麼處理一個以上的對象。如果有一張臉飄掉了,就拆開來做:各自畫一張,之後再合。
5. 全身,在辦公室
2 月那波裡,多數人是請人畫自己在辦公座位上的樣子。全身畫面給了模型更多可以編的空間,所以把場景釘死。
用我上傳的這張照片。畫一張全身漫畫肖像:這個人站在一張堆著東西的辦公桌旁邊,經典的頭部誇張比例,頭約為真實比例的 2 倍,一隻手搭在馬克杯上,桌上放著一台筆記型電腦和一本筆記本。衣服、髮型和眼鏡照照片保留。暖色調的辦公室,身後有一扇窗和一盆植物,鬆一點的墨線加水彩,不要任何文字,筆記型電腦和馬克杯上不要 logo。這一段改的是:場景。道具和背景正是編造細節出現的地方,「不要 logo、不要文字」這句擋掉了大部分。
6. 修補這一輪
最常見的下一步不是重畫,而是小修一處。把「什麼保持不變」講出來。
這張畫其他地方完全不變,只改一件事:讓頭相對於身體縮小大約 15%。眼睛、笑容、頭髮、眼鏡和衣服都不要動,紙張紋理、線條粗細和顏色保持一致,背景不要重畫。不要加任何文字。這一段改的是:一個比例。這段適合在 ChatGPT 的編輯器裡用,在那裡你還可以選取頭部,只對這一塊提要求。
上面的按鈕會把第 1 段提示詞填進本頁的輸入框。填入和送出是兩件事:在你進到 Studio 繼續之前,什麼都不會生成。
四十秒的相似度檢查
在把這張畫發給任何人之前,先跑一遍。它花的時間比重新生成一張少。
1. 剪影。 瞇起眼睛,或者退到兩公尺外看。髮型、頭的輪廓、肩膀、眼鏡:那個黑色形狀讀起來是這個人嗎?剪影要是通用的,再多細節也救不回來。
2. 錨點計數。 把能認出這個人的特徵列出來:髮際線、眼鏡、鬍子、雀斑、牙縫、耳環、一道疤、某個特定的下顎。數一數有幾個活到了畫裡。三個以上通常就夠了;只剩一個,那是一個穿著對的衣服的陌生人。
3. 最大的應該是那個對的特徵。 看看這張畫最用力推的是哪個部位。如果那正好是你描述這個人時第一個會說的特徵,這張漫畫肖像就成立。如果鼻子長大了,而人人都會注意的眼睛還是普通大小,那模型誇張的是一個模板,不是一個人。
4. 交給本人。 唯一算數的檢驗是當事人自己的反應,而這一步同時也是取得同意的步驟。發出去之前先問;誇張了某人在意的特徵的一張畫,和一張捧他的畫,是兩場不同的對話。
通常壞在哪裡
我們自己做出來的和市面上流傳的壞結果,幾乎都能歸到四種失敗。其中三種在下面這條圖裡。
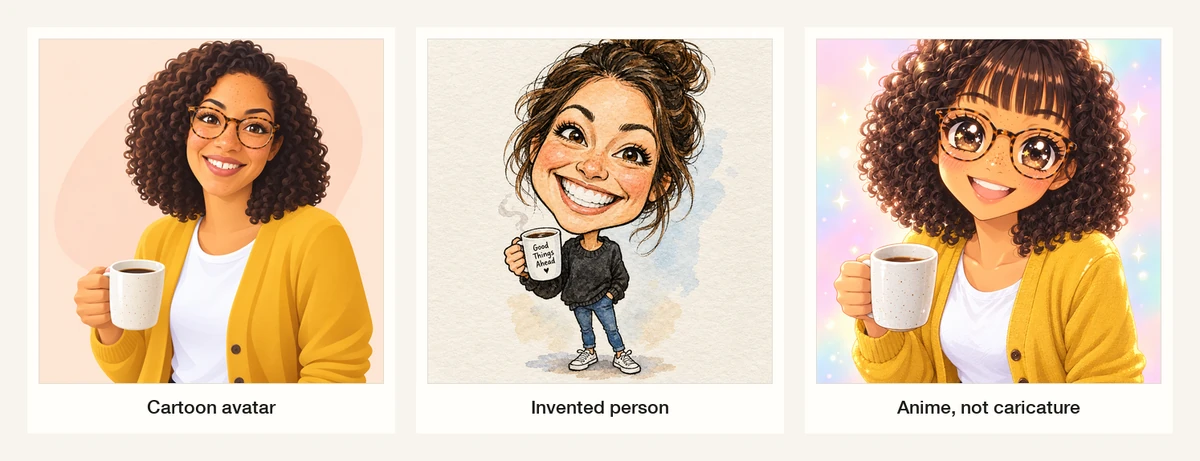
左:一張沒有任何誇張的風格化大頭貼。中:沒有附照片時「畫一張我的漫畫肖像」回來的東西,一個陌生人,還外加一句沒人要求的馬克杯標語。右:風格外洩,需求要的是漫畫肖像,回來的卻是動漫角色。為本文以 gpt-image-2.5-flare 渲染,2026年11月14日。
| 你看到的 | 為什麼會這樣 | 該改什麼 |
|---|---|---|
| 一張滑順的卡通大頭貼 | 提示詞描述了風格,從沒描述比例 | 加上頭部倍數,並點名兩個要放大的特徵 |
| 換了一個人 | 沒附照片,或附的是合照、其中主體很小 | 附一張清晰的單人照片,並描述那張臉 |
| 提示詞蓋過了照片 | 描述裡寫的是另一個人,髮型不同、沒有眼鏡,模型於是照著文字走 | 讓描述和照片一致;描述,不要替換 |
| 動漫、Q 版或 3D 渲染 | 風格詞互相競爭,比較強的那個贏了 | 只點名一種媒材,並加上「不要動漫,不要賽璐璐著色,不要 3D 渲染」 |
| 請求被直接拒絕 | 安全系統在生成之前就攔下了提示詞;我們要求畫一張刻薄、嘲諷的漫畫肖像時撞上了這個 | 要求對一個特徵做善意的誇張,而不是惡意的;並且尊重這次拒絕 |
拒絕這件事值得單獨講,因為這是一般人不會對畫圖工具預期的界線。當我們要求畫一張嘲諷對方牙齒和鼻子的漫畫肖像時,請求在輸入階段就回傳了 moderation_blocked:沒有圖,沒有扣費,只有一個錯誤。這是政策判斷,不是 bug;它帶來的實際後果是,這股潮流裡「損朋友」的那一版,比捧人的那一版更難做出來。
文字、名字和日期
現代圖像模型渲染短文字,比一年前好得多。我們的禮物測試在第一次嘗試可讀文字時就一遍做出了「DANA」牌子;而上面那個沒有照片的失敗,卻給馬克杯加上了一句沒人要的「Good Things Ahead」。兩件事指向同一個方向:文字是做得到的,不是保證的,而且不讀過一遍就永遠不能信。
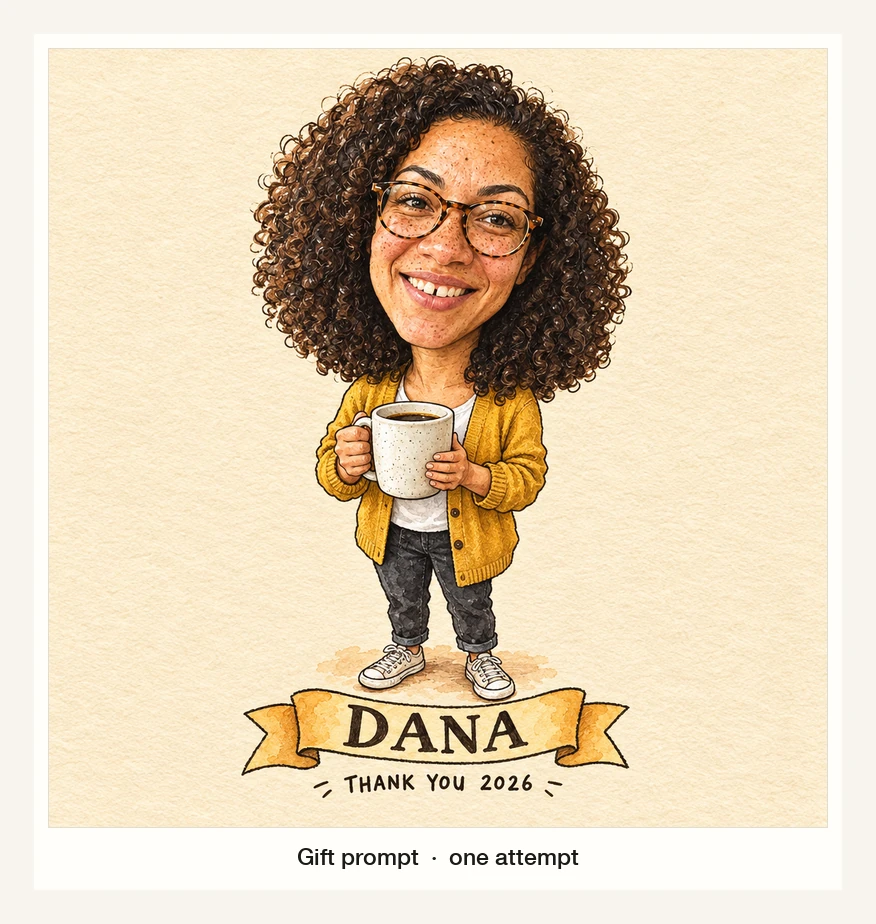
禮物版提示詞,一次生成。緞帶上的字沒錯,全身和馬克杯都沒有走樣,一行都不用重做;而在沒有照片時,同一個模型自己給杯子加了一行沒人要求的標語。為本文以 gpt-image-2.5-flare 生成,2026 年 11 月 14 日。
管用的規則:文字只留一個名字,最多再加一行短句;把準確的拼寫放進引號;寫上「不要加其他任何文字」;然後放大到 100% 逐個字母檢查。凡是要印出來的東西,卡片、馬克杯、海報,都假設還要再一輪,並把它編進預算。
同意、同事,以及一張畫並不代表授權
這股潮流之所以討喜,是因為畫的是同事、老師和朋友。麻煩也從這裡開始。
- 先問本人。 漫畫肖像挑一個特徵放大。你覺得是親暱,對方可能讀成在對他的鼻子、牙齒或體重發表意見。放上團隊頁面或公開帳號之前,先拿到一個「可以」。
- 注意職場細節。 同事在辦公座位上的漫畫肖像,可能帶上螢幕、白板、客戶名字或識別證。上面的提示詞要求不要 logo、不要文字;背景還是要自己看一遍。
- 一張畫不等於一份授權。 用一張沒經本人同意的照片,或是一個可辨識的角色、品牌,是權利問題,生成一次並不能解決。你在 ChatGPT 裡生成的東西怎麼用,歸 OpenAI 的條款管;Studio 這套流程歸 Ottermind 的條款管。兩者都不會轉讓肖像權,也不會替你把一張不屬於你的照片清乾淨。
- 把原始檔和結果放在一起。 如果這張圖要印出來或賣出去,把照片、提示詞和日期存在一起,以便證明這張畫是根據什麼做的,也方便日後重新生成。
這些是審查層面的問題,不是法律意見。商業委託或公開發表之前,和照片的權利人確認使用範圍。
在 Ottermind 裡怎麼做
本頁最上方的輸入框就是真實的請求介面:一個需求欄位,一個可選的附件欄位放照片,一個送出動作,送出後進入 Studio。這裡同樣沒有誇張滑桿,所以那個數字必須寫進句子裡。
本頁的輸入框。附件欄位放肖像,需求欄位放六段提示詞裡的任何一段,綠色按鈕只負責填入;送出是另一個動作,會進到 Studio 裡繼續。實拍截圖,2026年11月14日。
兩個入口涵蓋常見的起點,一個涵蓋還沒有照片的情況:
- AI Art Generator from Image 是照片先行的路線:上傳肖像,描述畫風和必須保持可辨識的細節,再比較幾個方向。第 1 到第 5 段提示詞都適合它,那些都以照片為參考。
- Unrestricted AI Image Generator 適合更長的需求,比如帶道具、光線和衣著描述的全身辦公場景。它自己的頁面把這套做法講成是讓詳細的創作需求保持具體,而不是壓成一張通用圖片。
- AI Image Generator 是還沒有照片時的通用入口:先從一段文字需求開始,有了肖像再加進去。
這些都不保證某個固定的輸出尺寸、固定的生成時間、固定的成本,也不保證相似度撐得過每一次編輯。它縮短的是「我知道我要哪個檔位」和「我看得到我有沒有拿到」之間的距離,而上面那套檢查,才是把這個循環變成一張能用的畫的關鍵。
延伸閱讀
- ChatGPT 圖像提示詞:如果你這是第一次指揮圖像模型,這裡講視覺需求的通用結構。
- 在 ChatGPT 裡編輯圖片:第 6 段那輪修補背後的選取工具流程。
- Q 版風格:如果上面那個動漫風格的失敗其實正是你想要的樣子。風格和漫畫肖像的差別,那篇指南講的也是同一件事。
- GPT Image 2.5 Flare vs Sunburst:當你是在為一個批次挑模型,而不是畫一張。
- 海報點子:如果這張畫要印成卡片或掛上牆。
常見問題
ChatGPT 能用照片做漫畫肖像嗎?
可以。附上一張照片,描述你要的畫;OpenAI 的說明中心寫明了各方案都有的圖像生成與編輯功能,包括上傳現成圖片並描述修改。出來的是漫畫肖像還是卡通,取決於你的需求,而不是某個隱藏模式。
需要付費方案嗎?
OpenAI 說 ChatGPT Images 在所有方案裡都能用;不一樣的是你的方案允許幾張、額度多久重新計算。去看你帳號裡的用量指示,別信某篇文章裡的數字。
為什麼我拿到的那張像卡通,而不是漫畫肖像?
因為提示詞描述了風格,從沒描述比例。一張漫畫肖像至少需要一個明確的誇張,頭部倍數、加寬的笑容、放大的眼睛都行,外加一份「必須保留」的特徵清單。只有風格詞,出來的就會是一個濾鏡。
沒有照片可以做嗎?
可以,但模型會自己編一個人。用來做示範或吉祥物沒問題,用來當禮物沒用:那張畫不會像任何一個具體的人。
用 ChatGPT 做一張漫畫肖像,就是一段提示詞加一道檢查。生成之前先定檔位,送卡片用 1.5×,開玩笑用 2.5×,把不准變的特徵寫進同一句話裡,然後在發給他本人之前,先看一眼剪影。
