提示詞指南
ChatGPT 可以做影片嗎:它做到哪裡,哪裡得交給算圖工具
對話負責寫鏡頭,算圖要交給另一件工具。把下面這段動態描述貼進去,再附上它描述的那張靜態影格,就是本頁要講的那次交接——對話裡並不需要影片模型。
選填
JPG / PNG / WebP
這是 Ottermind 自己的輸入框。填入描述和送出是兩個動作,不繼續進入 Studio 就不會產生任何影片。
2026年11月14日 · 11 分鐘閱讀
光靠它不行;接上別的東西,可以。 ChatGPT 能寫腳本、寫分鏡、寫動態需求,也能做出一個鏡頭起步的那張靜圖。它做不到的,是截至 2026 年 11 月 14 日、單靠自己算出一支能播放的影片檔:對話裡沒有自家的影片模型,因為 OpenAI 的 Sora 網頁版與 App 已在 2026 年 4 月 26 日停止服務,Sora API 接著在 2026 年 9 月 24 日下線。
ChatGPT 的圖像功能也在逐步開放循環 GIF。若你的帳號已支援,可以直接在對話中讓靜態圖片動起來。若要輸出 MP4 等影片檔,仍需使用影片生成工具。 (OpenAI Help Center)
就這一件事,把整個題目換掉了。真正有用的問題不是「ChatGPT 能不能做影片」,而是「影片的哪一段由 ChatGPT 做完,其餘的誰來算」。人會卡住,通常是因為在一個文字框裡要一支成品,或者把一句話的想法丟進生成器,指望那些沒做的決定自己補上。這兩種失敗都出在交接,不在模型。
這份指南是怎麼準備的: OpenAI 說明中心的「What to know about the Sora discontinuation」(2026 年 11 月 6 日更新)與「Plugins in ChatGPT」(2026 年 10 月下旬更新)兩頁,於 2026 年 11 月 14 日核對,用來確認日期,以及外掛如何安裝、如何付費。Pika 於 2026 年 10 月 16 日發布的外掛公告,與 Runway 在 OpenAI 網站上的外掛頁,同日核對。本文由 Ottermind 發布,並提供下面流程中使用的算圖工具。封面、桌面場景與三格連續畫面,是以 GPT Image 2.5 Flare 為本文生成的;它們是示意圖與範例來源,不是任何算圖工具的輸出,也不是 ChatGPT 的截圖。本頁上方的輸入框是真的,可以直接用。
為什麼你查到的答案大多已經過期
把這個問題丟進搜尋,你還是會點到一堆在講「對話直接生成影片」的頁面,或把「ChatGPT 影片生成器」當成一個產品列出來的頁面。很多是在 Sora 還在的時候寫的,或是某個自訂 GPT 代打的時候寫的。那些日期值得記一下,因為它們決定哪些說明今天還跑得動:
| 日期 | 結束了什麼 | 對你意味著什麼 |
|---|---|---|
| 2026 年 4 月 26 日 | Sora 網頁版與 App | 獨立服務已經沒了;既有內容可在 sora.chatgpt.com/sunset 匯出 |
| 2026 年 9 月 24 日 | Sora API | 也不能再透過 API 產生新的 Sora 算圖 |
| 2026 年 10 月 | 外掛目錄持續增加 | 現在在 ChatGPT 裡做影片,等於呼叫某家廠商的算圖服務 |
OpenAI 的停用說明頁也提到,已購買的 ChatGPT 或 Sora 點數仍可用於 Codex。截至 2026 年 11 月 14 日,OpenAI 的說明頁上沒有任何一頁描述 ChatGPT 有自家的影片模型,所以看到哪個頁面說有,就當它在講一件你該先在自己帳號裡驗證的事。
「做一支影片」其實是四件不同的事
這個說法至少涵蓋四種任務,輸入、成本、出錯的方式都不一樣。先挑定你要的是哪一種,再開始寫,因為只有其中一種是從一張照片開始的。
| 你想要的影片 | ChatGPT 自己能做到什麼 | 誰負責把檔案算出來 | 要注意什麼 |
|---|---|---|---|
| 從一個想法或一張靜圖來的短片——一個鏡頭 | 寫需求、寫連戲注意事項、分配時間 | 文字生影片或圖生影片的算圖工具,可能在外掛裡,也可能在對話外 | 難的是動態,而描述動態的詞不是平常講話會用的詞 |
| 會說話的主持人或虛擬人像 | 寫腳本與表現指示 | 虛擬人像工具,通常是另外付費的廠商帳號 | 那張臉是廠商授權的,方案決定你有幾分鐘 |
| 從筆記、PDF 或文件做旁白解說 | 把素材整理成投影片、旁白與圖表規劃 | 外掛或解說影片服務 | 你拿到的是打字排出來的投影片,不是實拍畫面;畫面上不會有人 |
| 剪一支你已經拍好的素材 | 寫剪輯清單與字幕 | 剪輯工具,通常是吃對話指令的那種 | 素材得先存在,對話才幫得上忙 |
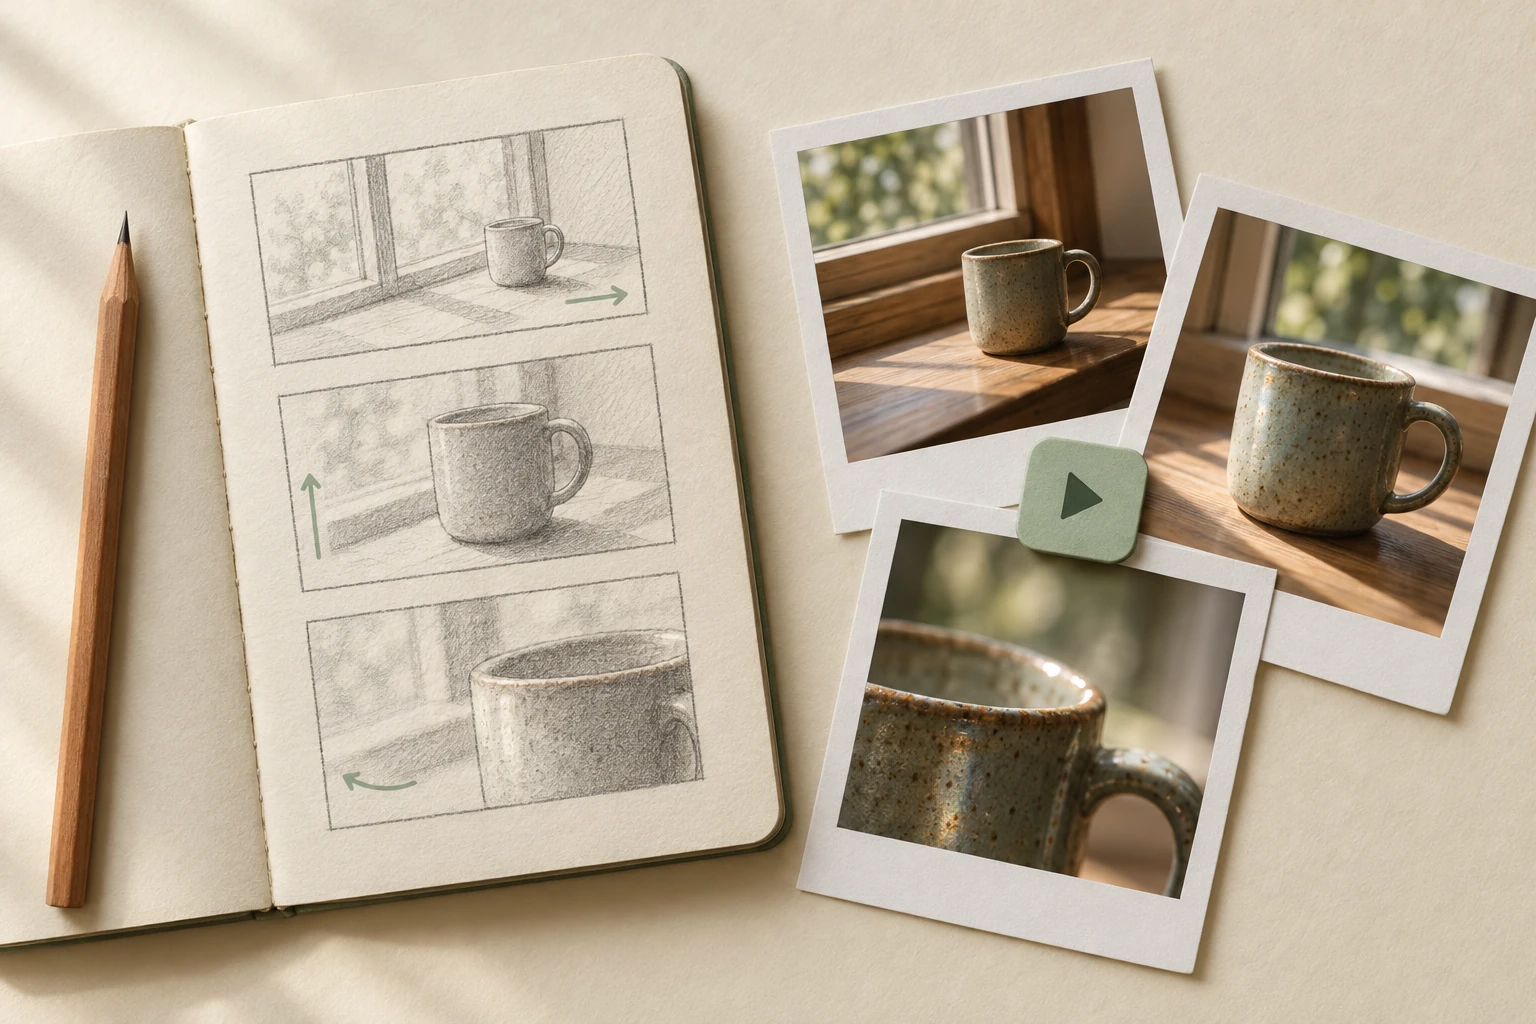
一張照片裡有三件事:左邊是文字,右邊是影格。筆記本是可以由對話填滿的那一半——景別、動態、什麼不能變。相片紙是得由別的東西生產的那一半。本文的 AI 生成示意圖,不是截圖,也不是任何算圖結果。
多數問這個問題的人指的是第一列:一個短鏡頭,素材常常是一張產品照或一張人像。這一列也剛好是交接最容易做對的一列,因為圖生影片的算圖工具收的,正是對話做得好的那兩樣東西——一張靜圖,和一段寫下來的需求。
對話在這裡真正擅長的事
寫需求不是安慰獎。多數壞掉的影片是在這一步就決定的,而一個看得到你素材的對話模型,有四件事做得不錯:
- 指名什麼不能變。「把手留在右邊、釉面不變、咖啡液面高度不變」這種句子,你自己寫的時候常常會漏掉,而它正是讓產品不走樣的那一句。
- 把一個想法拆成節拍。 六秒鏡頭配一個動作、一次運鏡,撐得住;配三個動作就撐不住。你沒開口要短版之前,對話兩種都寫得出來。
- 算時間。 二十秒的旁白,用英文自然的語速唸,大約是 45 到 55 個字。改稿的時候,它可以幫你把這段算術記著。
- 讓需求帶得走。 同一段文字,下週換哪個算圖工具都得能用。對話可以把它壓短,而不用丟掉主體鎖定。
它也能做那張靜圖。ChatGPT 的圖像生成是自家能力——看Images 2.5 改了什麼——所以手上沒照片的人,可以在同一個對話裡生出一張參考影格,再把那一格交給算圖工具。這條鏈真的有用,也是這篇指南要搭的東西。
對話做不到的是看你的算圖結果。它不會盯著那一次算出來的畫面,告訴你哪一格壞了;你得自己描述故障。下面每一段提示詞都是照這個現實寫的:你回報,它改寫。
提示詞不等於鏡頭需求
「幫我做一支我產品的影片」會失敗,原因很無聊:它把八個決定留給算圖工具,而算圖工具會全部默默做完。鏡頭需求把這八個決定按固定順序定下來,而順序比措辭重要。
| 欄位 | 它決定什麼 | 跳過會怎樣 |
|---|---|---|
| 來源 | 這一格是你給的靜圖,還是從文字生出來的場景 | 算圖工具會自己發明一個不是你的產品 |
| 主體鎖定 | 一定要活下來的兩三個細節——標籤、把手在哪一側、咖啡液面高度 | 圖生影片最常見的失敗:主體悄悄變了 |
| 動作 | 畫框裡唯一的那一個移動 | 幾個小動作互相打架,影片看起來不穩 |
| 攝影機 | 推、拉、橫移、環繞、固定,以及幅度 | 鏡頭動得太快看不清,或者完全不動 |
| 光線 | 方向、質感,以及會不會變 | 情緒每次都不一樣,幾次算下來接不上 |
| 時間 | 長度,以及開頭和結尾各發生什麼 | 最後一格不能用,影片就剪不了 |
| 影格 | 畫面比例,以及什麼必須留在安全框內 | 把手或字幕在輸出平台被裁掉 |
下面有八段需求。每一段只控制一個性質,所以兩次算圖之間差在哪裡,可以追溯回某一句話。八段都用同一個主體——木窗台上一個斑點炻器馬克杯——因為只有主體固定,兩次嘗試才比得出來。
1. 動態需求:一個來源,一個動作
把這張照片——木窗台上的斑點炻器馬克杯——做成四秒的動態鏡頭。杯子保持照片裡的樣子:同樣的輪廓、同樣的釉面斑點、把手在右側、杯裡的咖啡液面高度不變。加一層熱氣,從杯口慢慢升起,略微向左飄。四秒內鏡頭向前推大約百分之十——不橫移、不環繞、不拉遠。窗光保持柔和偏冷;不偏色、不換背景、不添加物件、不出現手、不出現文字、不出現標識。這一段同時控制動作與主體鎖定。判斷方法:把第一格和最後一格停住來看,兩邊應該是同一個杯子,只有距離變了。
2. 只動攝影機:畫框裡的東西都不動
同一張圖、同一個時刻:會動的只有攝影機。先從整個窗台拍起,杯子略偏中央右側,接著往左、稍微往下漂四秒,像有人往前傾身去看那個杯子,最後杯子落在畫面左三分之一。杯子不動,熱氣維持原本的節奏,窗台上的樹枝陰影形狀不變。不要變焦、不要移焦、不要出現文字。這一段只控制攝影機的行為。如果第一段需求算出來的畫面飄掉了,改跑第二段,就能判斷問題出在攝影機還是主體。
3. 三個節拍,一個主體
為一支六秒影片寫三拍分鏡,主體是木窗台上一個斑點炻器馬克杯,時間是早上九點。第 1 拍,0 到 2 秒:遠景,杯子靜止,熱氣剛開始,窗光冷而平。第 2 拍,2 到 4 秒:同樣的取景,熱氣升起,晨光從左邊進來,把釉面照暖。第 3 拍,4 到 6 秒:同一個杯子的近景,熱氣捲曲,一道柔和的樹枝陰影掃過窗台。每一拍都要給我景別、什麼在動、什麼必須完全一致,再加一句我能直接貼進圖生影片工具的動態指示。杯子的形狀、釉面、把手在哪一側、咖啡液面高度,三拍都必須一致。這一段控制跨鏡頭的連戲。測法是看第 3 拍裡的把手是不是還在同一側——如果算圖工具把它改了,要修的是需求,不是算出來的畫面。
4. 對得上長度的分鏡表
把這個想法變成一支十五秒直式產品影片的分鏡表,輸出一張五欄的 markdown 表格:鏡號、秒數、景別、發生什麼、鎖住什麼。主體是木窗台上同一個斑點炻器馬克杯,光線從冷調晨光走到暖陽,直式畫面必須隨時看得到把手和咖啡液面。五個鏡頭,秒數加起來剛好十五秒,沒有一個鏡頭短於兩秒。表格之後,列出算圖工具最可能弄壞的三個細節,以及我該加進每個鏡頭、用來保住它們的那句話。這一段同時控制時間預算,順手生出防護欄。加起來剛好 15 秒的分鏡表,就是「能跟著音樂剪」和「一堆用不掉的影格」之間的差別。
5. 對得上剪輯的旁白
為杯子的影片寫一段十五秒的旁白,口播不超過 38 個字,這樣才塞得進自然的語速。把它拆到上面表格的五個鏡頭裡,每一句都給我開始的秒數和字數。語氣:平靜、具體,不要形容品質的形容詞,不要驚嘆號。然後把同一份稿子寫成畫面上的字幕卡,每張不超過六個字,並告訴我,如果算出來的影片短了一秒,該先刪哪一句。這一段控制節奏,也給你退路。刪除順序要明講;沒講的話,你在時間壓力下剪接時會刪錯那一句。
6. 失敗版本的修正需求
上一次算出來的畫面有這些問題:杯子的把手跑到左側,熱氣變成一條實心白線,推鏡推過頭,四秒時杯緣被裁掉。我原本的需求寫的是「杯子保持照片裡的樣子」、「熱氣慢慢升起」、「向前推大約百分之十」。照這三個故障重寫需求,每個故障用自己的一句話回應,不要加入任何新指示。修正按這個順序排:主體鎖定、熱氣行為、攝影機距離。然後告訴我,如果下一次只能修其中一個,該先改哪一句。這一段控制改稿衛生:一個故障配一句話,不夾帶新想法。前三句還在修的時候又塞進第四個指示,就是影片越改越糟、看起來卻越來越詳細的原因。
7. 可以帶走的段落
拿已核准的杯子需求,改寫成單一段落,讓另一個影片生成工具在沒有原始對話的情況下也讀得懂。它必須照這個順序講:來源圖是什麼、什麼不能變、唯一的那個動作、攝影機怎麼動、光線、長度、畫面比例,以及什麼不能出現。不要寫工具名稱,不超過 110 個字。然後再輸出一版 60 個字,仍然要保住主體鎖定和動作。這一段控制的是交接本身,也是本頁最有用的一段提示詞。只存在某個對話裡的需求,沒辦法重複使用、比較,也搬不到更適合這個鏡頭的算圖工具上。
8. 從一個核准鏡頭延伸出的比例版本
從已核准的寬螢幕杯子需求,做出兩個版本:給社群貼文的 9:16 直式版,和給動態牆的 1:1 方形版。每一個版本只重述有變的地方——取景、杯子擺在哪、上方留多少空間、攝影機推多遠。光線、熱氣和主體鎖定都和寬螢幕版一致。不要改長度。這一段控制輸出的形狀。只重述差異,才不會讓同一個鏡頭的三個版本變成三個不相干的鏡頭。
按鈕會把第一段需求填進頁面上方的輸入框。它只負責填入;送出是另一個動作,在你進到 Studio 繼續之前,什麼都不會生成。
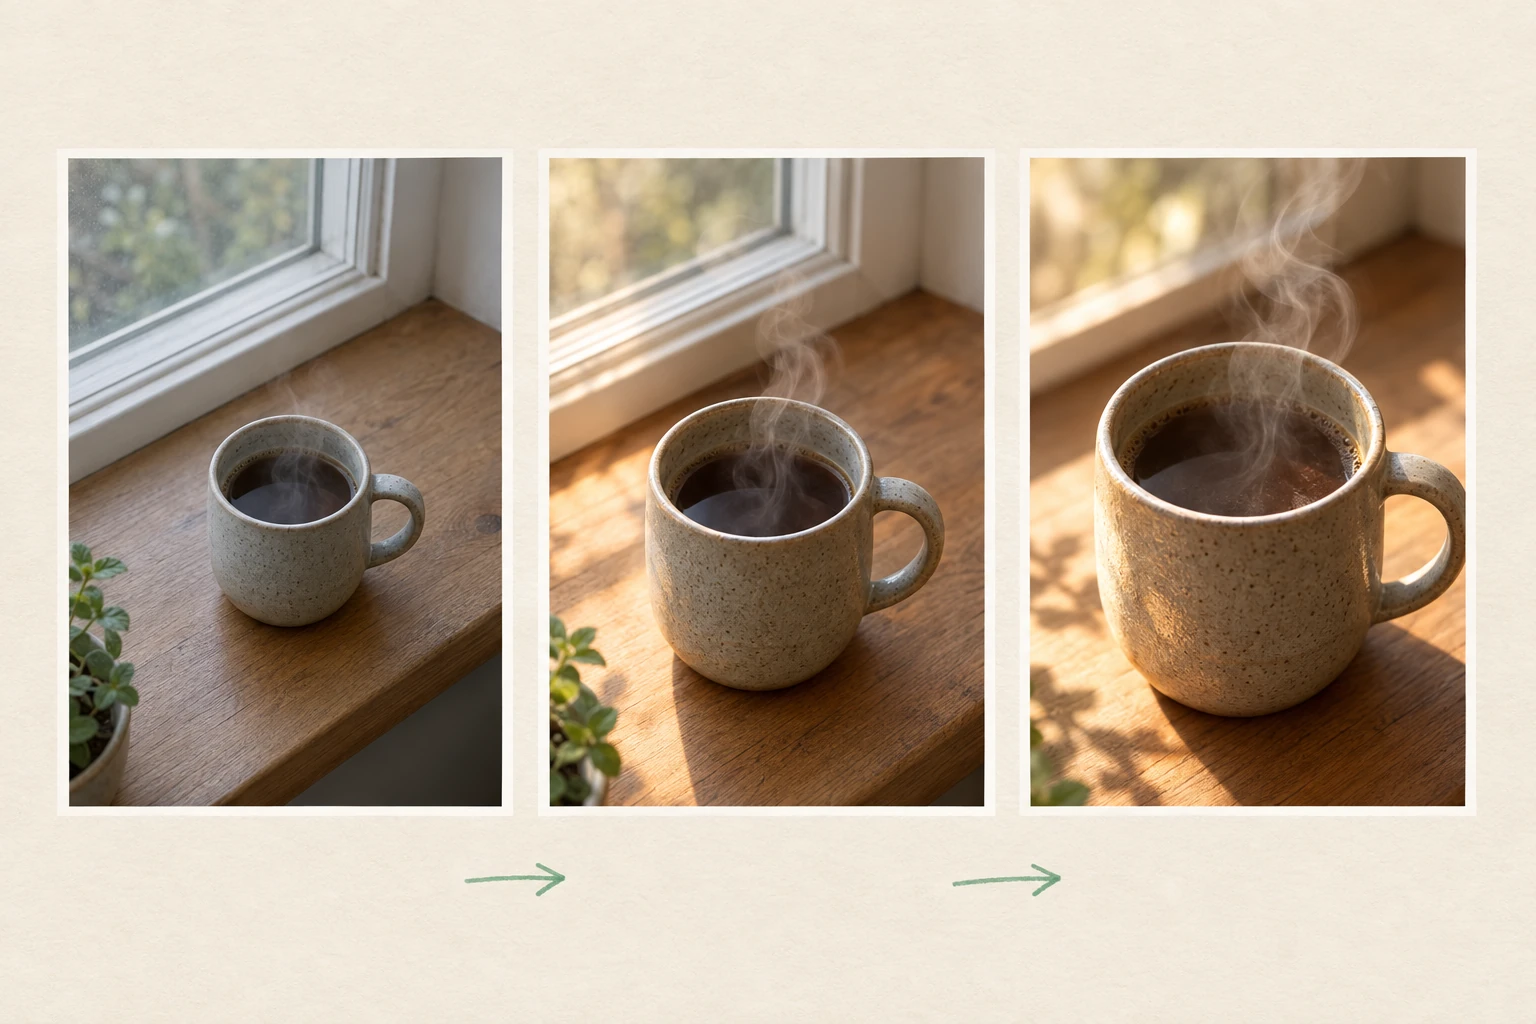
一個撐得住的鏡頭:先冷調遠景,太陽進來之後轉暖,再靠近,杯子還是同一個。三格畫面、一個主體、一個運鏡方向。本文的 AI 生成示意圖;這幾格示範的是需求該保住什麼,不是任何特定算圖工具回傳的結果。
哪裡會出錯
九種失敗,涵蓋了多數人怪到模型頭上的壞影片。其中七種是需求寫錯,這是好消息:需求一分鐘就能改。
| 你看到的 | 為什麼會這樣 | 怎麼修 |
|---|---|---|
| 產品悄悄變了——把手在哪一側、標籤、比例 | 主體鎖定只是暗示,沒有寫出來 | 指名兩三個細節,並且在每一次算圖的需求裡重複 |
| 熱氣、煙或頭髮變成一條實心白線 | 需求描述的是結果,不是行為 | 描述運動曲線:慢慢升起、往左捲、靠近上端變薄 |
| 攝影機推過頭,把主體裁掉 | 「向前推」沒有距離,也沒有結束位置 | 給百分比和結束位置:大約百分之十,杯子在左三分之一 |
| 好幾樣東西同時在動,沒有一樣看得清 | 一句話裡要了兩個動作 | 一個鏡頭一個動作,其餘的留到下一個鏡頭 |
| 影片看起來沒問題,最後一格卻不能用 | 沒有人寫結尾發生什麼 | 寫明結束影格,並停住半秒 |
| 畫面裡冒出文字——價格、字、浮水印 | 需求留了空白,而對話其他地方出現過文字 | 加上「不要文字、不要標誌、不要浮水印」,畫面文字留到剪輯時再做 |
| 直式輸出把臉或把手裁掉 | 畫面比例是算完之後才決定的 | 先決定影格再寫需求,並讓主體留在畫面中間 |
| 期待一般影片生成器做出會說話的主持人 | 這件事屬於表格裡另外三列 | 走虛擬人像或解說影片那條路,並把帳號成本算進去 |
| 對話只描述步驟,不給你檔案 | 對話裡沒有接上任何算圖工具 | 裝一個外掛,或把需求帶去圖生影片工具——見下一節 |
第九列才是讓人以為自己做錯事的那一列。其實沒有:一段純文字的對話,在裝上或打開什麼之前,本來就沒有算圖能力。OpenAI 的外掛說明提到,安裝或使用個別外掛取決於你的方案、工作區、角色與地區,所以你讀到的外掛,在你的帳號裡可能根本不能用。
不管走哪條路,都別期待這些
- 沒有固定的生成時間。 外掛和算圖工具都不保證幾秒內算完一支影片。
- 沒有固定的輸出規格。 長度、解析度、有沒有聲音,取決於你用的工具;外掛的話,取決於廠商自己的服務。
- 沒有可以聽別人講的點數算法。 外掛是透過廠商的帳號與點數算圖——例如 Pika 自己的公告就把外掛生成綁在 Pika 點數上——所以成本屬於那家廠商當下的價目,不屬於 ChatGPT。
- 沒有權利上的捷徑。 生成出來的影片,不代表你取得了產品、肖像、標誌或音樂的授權。發佈前要另外確認。
- 不能代替你親眼看一遍。 還是得有人把影片播一次,檢查產品、邊緣、最後一格和聲音。
從需求到算好的影片
需求有了之後,挑算圖工具就只是挑工具,而 Ottermind 的兩條路涵蓋常見情況:
- Image to Video — 你上傳一張參考圖,描述動態、攝影機感覺、氛圍與格式。那個頁面自己的說法是,每一次算出來的結果你都要看過再修,這正是上面那段修正需求的用途。手上已經有靜圖時用它:產品照、人像、核准過的主視覺。
- Photo to Video AI Free — 同一件事、以照片為主的版本,目前頁面上寫的試用是註冊送 60 點、每天 20 點,下載無浮水印。要照著這些數字規劃之前,先讀那一頁的條款;額度會變。
送出之前有兩件事值得知道。第一,這個網站不保證固定的生成時間、固定的解析度或固定的點數成本,看到有文章這樣保證,就當它在講另一個產品。第二,你帶過去的需求應該是第 7 段提示詞那個版本——可以帶走的段落——不是整段對話紀錄。算圖工具讀的是那段文字,不是你的推理過程。
如果靜圖還不存在,先做一張:ChatGPT 的圖像生成可以生出那一格,而ChatGPT 圖像提示詞範例講的光線與參考圖取捨,決定了那一格能不能當來源用。如果你寧願從手上已經信得過的靜圖開始,圖生影片提示詞教學把運鏡語言講得更深,無臉 Reels講的是等你攢到五支彼此配得上的影片之後,該拿它們做什麼。
值得回答的幾個問題
ChatGPT 還有 Sora 嗎?
沒有。OpenAI 的說明中心寫明,Sora 網頁版與 App 於 2026 年 4 月 26 日停止服務,Sora API 於 2026 年 9 月 24 日。既有內容可從 sora.chatgpt.com/sunset 匯出,已購買的 ChatGPT 或 Sora 點數仍可用於 Codex。
ChatGPT 可以從照片做影片嗎?
沒辦法自己算出來。它可以讀照片、寫動態需求、把主體細節記住,然後由算圖工具把照片和那份需求變成影片。在這個網站上,這一步是 Image to Video。
可以免費做嗎?
一部分可以,但不在同一個地方。對話這一半——腳本、分鏡表、需求——算在你原本就有的 ChatGPT 方案裡。免費額度在算圖這一半,而且各有各的條款:外掛的免費額度屬於廠商,算圖工具的試用屬於那個工具。要拿這些數字規劃之前,先讀當下的頁面。
一定要裝外掛嗎?
不用。外掛路線把一切留在同一個對話裡,素材本來就在那裡時很方便。當你有參考圖、想比較同一個鏡頭的幾次算圖,把需求帶去專門的圖生影片工具通常更合適——而且方案或地區不支援外掛時,這條路照樣走得通。
老實的總結:對話負責寫,別的東西負責算圖。需求裡寫進主體鎖定和結束影格,讓它帶得走,然後每一次算圖都拿同樣那兩三個細節去對。這一串動作,就是「看起來像你的產品」和「只是有點像」之間的差別。
