提示詞指南
動態分鏡:讓分鏡的時間聽得見
動態分鏡(animatic)是配上聲音、按最終長度排好時間的分鏡。下方輸入框裡就是本頁開頭那條「鎖死鏡頭」提示詞——已經填好,你可以讀、改,或直接送出。
可選
JPG / PNG / WebP
這是 Ottermind 的輸入框,不是剪輯時間軸。提示詞已經填好;送出是另一個動作,之後會進入 Studio 繼續。
2026年11月16日 · 約 11 分鐘
動態分鏡(animatic)就是你的分鏡,按完成品實際會跑的長度播一遍,底下墊著聲音。 分鏡畫面本身不動,或只動到剛好足以暗示運鏡和動作的程度;真正撐起整段的是剪輯點、停頓和聲音。Wikipedia 的定義至今還是業界在用的那個:一連串靜態影像,通常取自分鏡,與粗略的對白或粗略的音軌同步播放。它不需要好看。它需要的是長度剛好,而且落在聲音落下的地方。
這一關最常見的錯是順序,不是品味。很多人先把分鏡畫面動起來——一格一段影片,每段都打扮得漂漂亮亮——然後才把影片丟進時間軸,發現整段長了二十秒,或者發現花一小時做的鏡頭無事可做,因為它原本要對的那句台詞被刪了。另一種錯更隱微:生成出來的影片動得很順,在檢討會上看起來像「完成了」,於是大家開始討論這顆鏡頭的長相,而不是它該不該存在。動態分鏡是一個量時間的儀器。你加上去的每一分「完成感」,都會讓這個儀器變得更不準。
這份指南是怎麼準備的: 資料於 2026年11月16日核對:Wikipedia 的《Storyboard》條目(Animatics 與 Photomatic 兩節,包含 rip-o-matic,以及「分鏡常靠剪輯軟體做簡單的推拉搖移就動起來」這個說明)、Wikipedia 的《Leica reel》條目(配音錄完之後才組起來的故事卷),以及 StudioBinder 由 Brent Dunham 撰寫、2025年3月5日發佈的動態分鏡指南(定義、分鏡與動態分鏡的差別,還有《阿拉丁》那個一路走到動態分鏡階段才被砍掉的替代結局)。Ottermind 圖生影片流程的說明,取自 Ottermind 自己的工具頁。時間表、剪輯點密度的算法和工作表,是從「怎麼量一段序列」推出來的,不是引用某個公開標準。本文沒有在 Ottermind 裡跑過任何生成,也沒有把任何輸出當成實測結果。封面與分鏡插圖是 AI 生成的示意圖;時間軸那張圖是照本文自己的數字畫的。
動態分鏡是什麼,以及它常被搞混的四樣東西
這個區分重要,因為這幾份文件各自在定的是不同的決定;拿其中一份的標準去評另一份,檢討就會走偏。
| 文件 | 它定的是什麼 | 不該拿什麼標準評它 |
|---|---|---|
| 分鏡 | 構圖、場面調度與鏡頭順序,一格一格定 | 時間。沒有人指定長度之前,分鏡本身沒有長度 |
| 動態分鏡 | 長度、剪輯節奏,以及整段在有聲音的情況下讀不讀得通 | 完成度。它本來就該看起來像暫時的 |
| 動作測試 | 某一個特定動作行不行——一段走路循環、一次抬舉、一個轉身 | 整段序列。乾淨的動作測試照樣可能卡在一場時間排壞的戲裡 |
| 預演 | 鏡頭的機位、場面調度與物理可行性,通常用在實拍或視覺特效 | 角色表演 |
| 完成動畫 | 以上全部,再加上表演、重量感和算圖工藝 | 沒有——這就是成品本身 |
規劃之前,兩個業界習慣值得先知道。動畫裡的動態分鏡通常來得夠晚,聲音早就有了:Leica 卷(故事卷)——迪士尼那邊對同一個東西的舊稱——是在配音員錄完之後,用錄好的對白加上挑選過的效果音組起來的。廣告裡的動態分鏡則是一支便宜的概念廣告片;它的近親拼貼樣片(rip-o-matic),是從現成的電影、電視或廣告剪出來,模仿提案那支片子的長相。這兩個習慣指向同一件事:動態分鏡是繞著「已經存在、或做起來很便宜」的聲音搭的,不是繞著「還不存在的動畫」搭的。
StudioBinder 的指南把這一關存在的理由講得很直白:動畫裡你是在「拍攝」的同時「剪輯」,所以時間的決定沒辦法像實拍那樣,等到進剪輯室再講。他們舉的例子是《阿拉丁》的替代結局——那是砍在動態分鏡階段,不是砍在動畫做完之後。Wikipedia 從另一頭算同一筆經濟帳:傳統動畫裡幾分鐘的片長是好幾個月的工作,動畫做完才刪掉的每一場戲,都是直接報廢。
這一關的全部理由就是這樣。動態分鏡之所以存在,是為了讓一個值一個月畫工的決定,可以用一個下午、一支鉛筆、一條時間軸和一條臨時音軌就解決。
讓一段序列可以被討論的四個數字
量不出來的動態分鏡,沒辦法被討論。「感覺有點慢」讓檢討會直接結束;「第四顆鏡頭停了九秒,只扛一句台詞」則給了在場某個人一刀可以下的地方。這四個數字從任何一段組好的序列上撈出來都只要幾分鐘,而且各講各的事。
| 數字 | 怎麼量 | 一段能用的序列長什麼樣 | 它解釋的失敗 |
|---|---|---|---|
| 鏡頭長度 | 時間軸上每段影片的長度,以秒計 | 每一顆的長度對得上它扛的東西——一句台詞、一個動作、一個眼神 | 每顆都差不多長:整段就是一段有聲音的幻燈片 |
| 剪輯點密度 | 剪輯點數除以總長,再乘六十 | 一個你為這個形式選過的數字——解說片和追逐戲不是同一種樂器 | 一個沒有人決定過的數字:一頭在瞎忙,另一頭是整片冷場 |
| 頭尾定格 | 每顆鏡頭開頭與結尾,和隔壁畫面完全一樣的格數 | 兩端至少留幾格不動,讓剪輯點有地方落 | 第一格就已經在動,或最後一格還在動:接點上看得見的跳動 |
| 聲音錨點 | 一顆鏡頭裡的聲音事件——一句話結束、一扇門、一下撞擊——以及它落在哪一格 | 每顆要緊的鏡頭至少有一個錨點,而且畫面真的對上它 | 動作落在它回應的那句台詞之後,讀起來就是慢半拍的業餘剪法 |
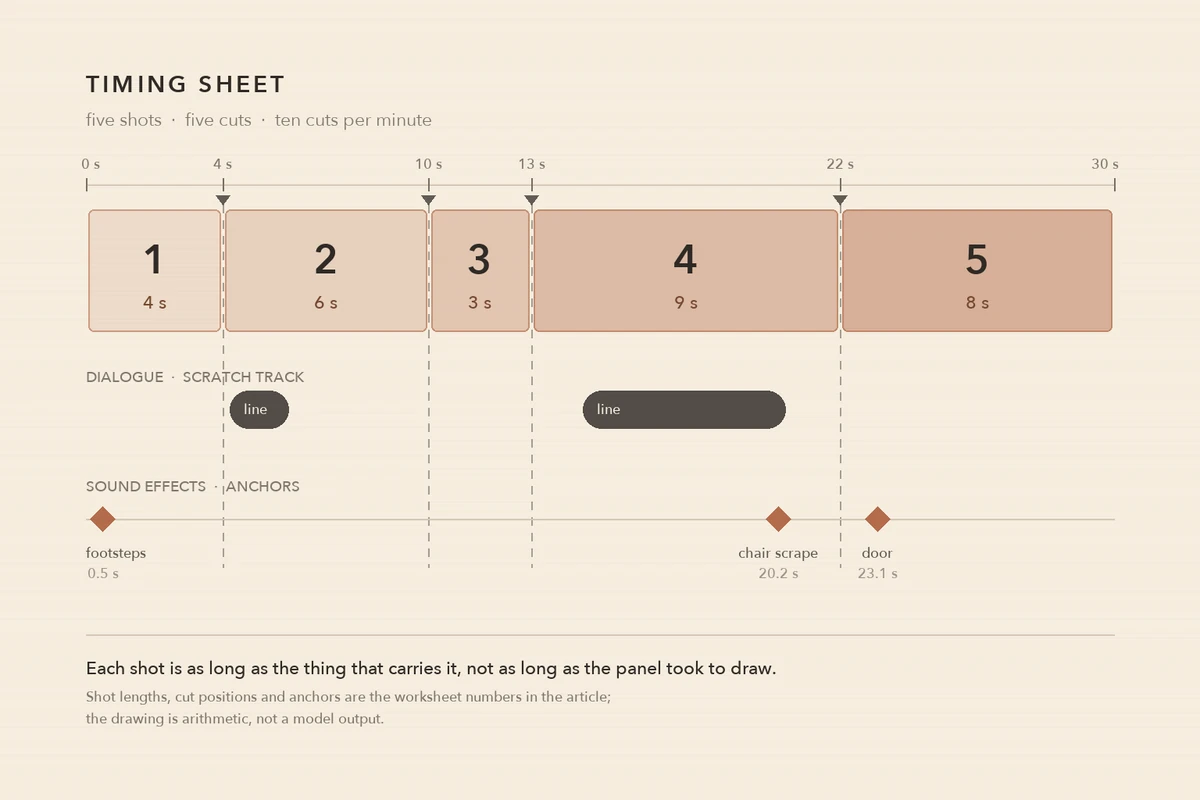
下面工作表裡那五顆鏡頭、剪輯點位置和錨點,先畫成一張圖,讓四個數字有個形狀。對白條顯示台詞講到哪裡;菱形是剪輯點可以落下的錨點。整張圖照本文自己的算術畫成,沒有動用任何模型:它是一張決定的圖,不是生成出來的某一格畫面。
鏡頭長度是最常被跳過的那一個,因為它感覺像創作決定,而不是測量。它兩者都是。在算任何圖之前先給每一格一個長度,把數字寫下來,然後拿你真正組出來的東西去對這個數字。兩者之間的差距,就是重工住的地方。
剪輯點密度是整段序列最容易做的現實檢查。五顆鏡頭的 30 秒動態分鏡,跑的是每分鐘 10 個剪輯點;90 秒的產品解說片用每分鐘 20 個,和同樣長度用 8 個,是兩種完全不同的東西。兩者都沒有錯。錯的是你沒選過的那個數字,因為那通常代表分鏡畫面是照當初畫的長度直接丟進去的。
頭尾定格和聲音錨點,決定的是一段序列「可以剪」還是只是「可以看」。如果一顆鏡頭的第一格和最後一格都已經在動,每個剪輯點都會跳,而解法不在剪輯裡——在鏡頭裡。
七段提示詞,每段只改一個變數
下面這些提示詞,是為「一格分鏡畫面加上文字指令」寫的,也就是 Ottermind 圖生影片 流程的用法:參考圖提供起始狀態和質感,文字提供動態、運鏡和終點。每段提示詞只改上面表格裡的一個性質。主體可以換,骨架的句子留著。
在動用任何一段之前:最基本的動態分鏡完全不需要生成動態。Wikipedia 提到,分鏡常常只是在剪輯軟體裡做簡單的推拉搖移就動起來,而那仍然是測一個剪輯點最便宜的方法。只有在「動態本身」就是你要丟給在場眾人的那個問題時,才去生成動態。
1. 鎖死的那一格
管的是:鏡頭漂移——這一格會不會始終是你畫的那個框。
把附上的分鏡畫面當成整個畫面。鏡頭固定在三腳架上:不推、不搖、不變焦、沒有視差、沒有手持晃動。只有煙囪冒出的煙在動,緩慢往左飄。其餘一切——屋頂、窗框、線條的粗細——都保持畫稿原樣。這個鏡頭停四秒,結尾回到開頭的構圖。把第一格和最後一格疊起來看。構圖只要偏了幾個像素,就是「鎖死鏡頭」那句輸給了模型預設要加動態的習慣,而你序列裡的每個剪輯點都會跟著漂。
2. 把長度講出來
管的是:鏡頭長度——你等一下要寫進工作表的那個數字。
這是一顆四秒的鏡頭,24 fps。第一秒的時候角色把箱子抬起來;到第三秒的時候箱子已經在架上;從第三秒到第四秒,除了角色的呼吸之外什麼都不動。箱子放上架之後,不要再加任何動作。數一下影片的實際長度,找出動作落在哪一格。如果模型兩秒就做完,之後還自己加戲,那是動作的描述太含糊——要講清楚什麼停下來、什麼時候停。
3. 從一格畫面推近
管的是:強調。它讓你不用再畫第二張,就得到一個更近的構圖。
從附上的完整分鏡畫面開始。慢慢朝角色的手推近,直到手佔滿大約三分之一的畫面,並在這顆三秒鏡頭結束時到達那個構圖。畫面放大的過程中,畫稿的線條粗細、紙張質感和顏色都保持不變。不要有任何新物件進入畫面。檢查畫稿是不是還是畫稿。如果推近把這一格重算成一張照片,就是「保留線條粗細」那句被忽略了——而正確答案是在剪輯軟體裡做一個靜態推近,不花成本,也不會漂。
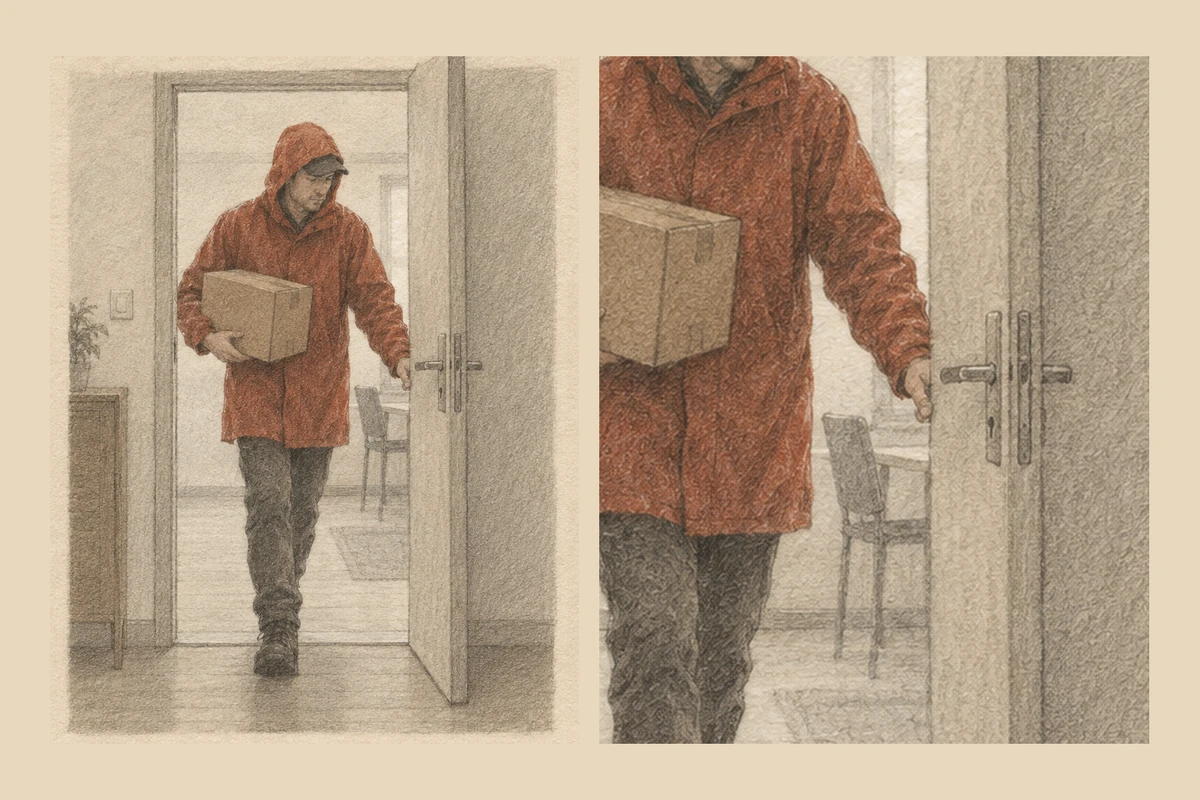
一次什麼都沒重畫的推近:左邊是原畫,右邊是同一張畫裁到手和門把上再放大——沒有第二次生成,也沒有新的線條粗細。這是剪輯師不必動用模型就能做的唯一一種運鏡,在「動態本身」成為問題之前,它應該是你的預設。本文的概念美術以圖像模型生成;兩個構圖是同一張圖,不是兩次生成。
4. 同一組角色,用同一套字描述
管的是:整個序列裡的角色走樣,也就是讓動態分鏡不能用的那種失敗。
同一個角色,跟參考圖一致:高個子的快遞員,鏽紅色雨衣、深色長褲、帆布斜背包掛在左臀、黑色短髮、不戴帽子。每一格都保持同樣的臉、同樣的外套顏色、背包掛在同一側。同一個房間,同樣從左邊進來的窗光,同樣的低飽和色調。只有他走路的方向改變。看背包在哪一側、外套什麼顏色、髮際線長什麼樣——三個很便宜就能看出來的線索。只要有一個變了,問題就不在描述本身,而在描述每段提示詞都換了說法。把角色描述原封不動貼進序列裡的每一段。
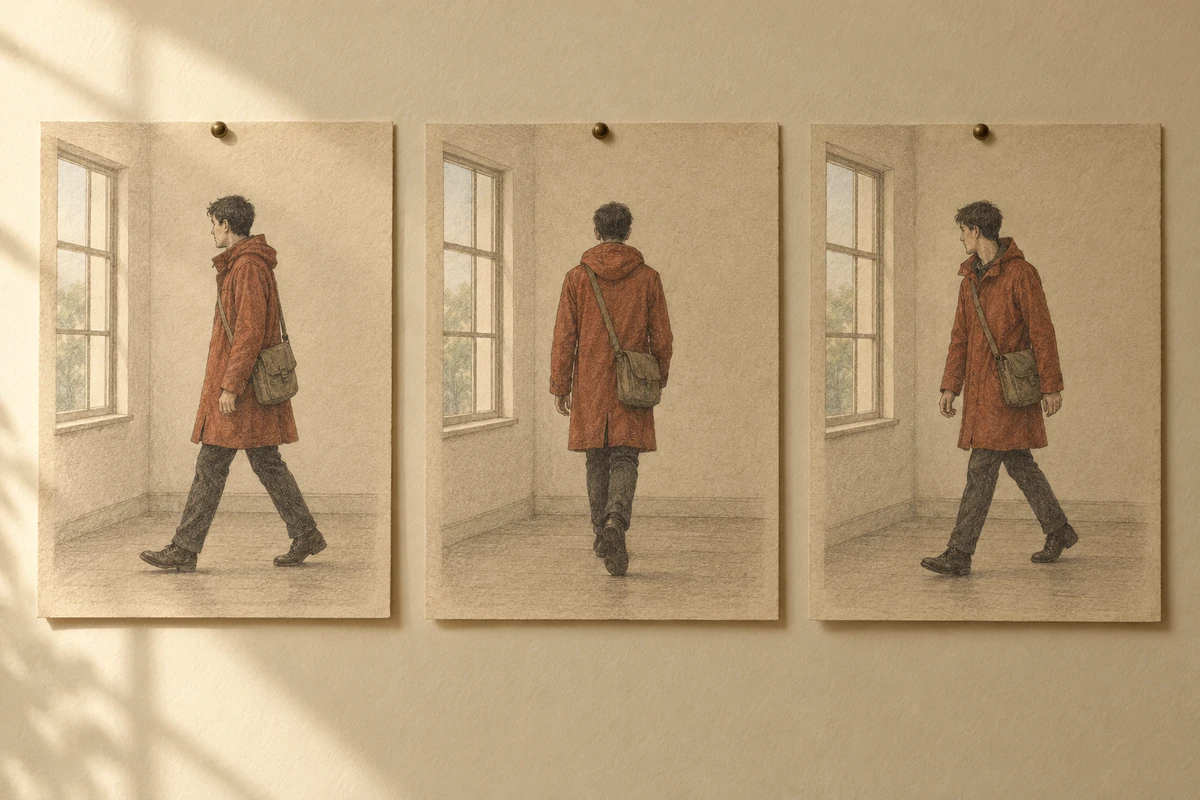
三格、一組角色、一個房間。背包在哪一側、外套什麼顏色,是觀眾用來判斷這是同一場戲還是三場戲的兩個細節。本文的概念美術以圖像模型生成;它示範的是提示詞必須講明的那些一致性,不是一次測過的多鏡頭生成。
5. 動態預算
管的是:變形,也就是模型被允許重新發明多少比例的畫面。
只有窗外的雨和杯子冒出的熱氣在動。桌子、杯子、兩張椅子和桌上的紙完全靜止——同樣的形狀、同樣的位置、同樣的陰影。不要增加或移除任何物件。不要重畫他身後海報上的字。與其要求「保持一致」,不如指名什麼不能變。一份受保護的清單可以核對;「保持一致」是一個願望。
6. 一個聲音錨點
管的是:動作相對於台詞落在哪裡,而這正是把聲音墊在分鏡畫面底下的全部意義。
門在台詞最後一個字說出來的同時關上。角色在鏡頭開始時進門,走到桌前,門在第四秒結束時關上——不早也不晚。最後半秒停在那扇關好的門上。播的時候把波形打開,標出門碰上門框的那一格。如果門比台詞晚一拍,這顆鏡頭不管畫得多好,都會讓人覺得慢。
7. 留給剪輯的餘裕
管的是:你剪輯上的餘裕,也就是下一顆鏡頭能不能壓在這顆上面。
讓鏡頭結束在一格靜止的畫面上:角色一定住之後,最後半秒保持這個姿勢不動,鏡頭鎖死。不要淡出、不要漂移,也不要在結尾起一個新動作。對照最後六格。如果它們完全相同,你就能重疊剪輯點、往兩邊修,也不必重新算圖就能重排整段的時間。
這顆按鈕只做一件事:把第一段提示詞填進本頁上方的輸入框。它只填,不送;在 Studio 裡繼續之前,什麼都不會生成。這個分界在這一頁特別要緊,因為這些提示詞裡的參考圖是佔位用的——真正進去的必須是你那一格。
把時間走一遍,寫出來
我們沒有可以下載的動態分鏡範本,這一頁也不會裝作有。賣範本的人真正在賣的是一張表格;有用的部分是你填進去的算術。下面是同一件事的文字版,數字加得起來。
| 鏡頭 | 分鏡畫面 | 長度(秒) | 這一顆靠什麼撐 | 進點/出點 | 聲音錨點 |
|---|---|---|---|---|---|
| 1 | 街道遠景,快遞員從左側入鏡 | 4 | 走進畫面的那幾步 | 直接切進;在他第一步踏出畫面時切 | 腳步聲從 0.5 秒開始 |
| 2 | 門口,手部特寫 | 6 | 那句台詞:「我不會收回」 | 在「收回」講完時切 | 台詞在 5.6 秒結束 |
| 3 | 室內,箱子在架上 | 3 | 兩人之間的那個眼神 | 提早切進,壓在前一句台詞上 | 沒有聲音;停住本身就是重點 |
| 4 | 雙人鏡,爭執 | 9 | 爭執的轉折 | 在椅子刮地聲上切 | 椅子刮地聲在 7.2 秒 |
| 5 | 遠景,門已關上 | 8 | 事後的餘波 | 停住;要不要淡出是另一個決定 | 門在 1.1 秒關上 |
| 合計 | 30 | 5 個剪輯點 → 每分鐘 10 個 |
三條規則讓這份工作表真的有用。
長度屬於「這一顆靠什麼撐」,不屬於「這格畫得多好」。 第三顆是三秒,因為那個眼神就是整個節拍;第四顆是九秒,因為爭執必須轉。如果你說不出這一顆靠什麼撐,那就是結論——不是格式問題。
剪在聲音事件上,不是剪在畫面節拍上。 動態分鏡裡的畫面本來就是暫時的;聲音才是完成品真正會有的東西。把錨點寫進那一列,然後檢查它落在哪一格。
把總數寫出來。 三十秒、五個剪輯點,是一句別人可以反駁的話。一堆分鏡畫面不是。
AI 在這一關幫得上忙的地方,以及它停下來的地方
圖生影片在這一關真的幫得上三種忙:分鏡畫不出來的動態(一個需要重量感的運鏡、一扇必須對上台詞的門)、同一格畫面的不同覆蓋版本,讓在場的人直接比較構圖,以及為提案做一個「上了妝」的版本,給讀不懂鉛筆稿的客戶看。Ottermind 的 圖生影片 流程會把參考圖和運動指令一起帶進 Studio;如果連分鏡畫面都還沒有、場景得從零描述,AI 影片生成器 處理的就是這種情況。
它停下來的地方有四個,每一個都值得在檢討會上講出口。
它不決定時間。 台詞需不需要六秒,模型都會照樣給你四秒。鏡頭長度是你的決定,算圖前寫下來,算圖後對一遍。
它給你動作的樣子,不給你被演出來的時間感。 手繪的動態分鏡能讓人看見動畫師在一個表情上下過的時間——反應之前的那一下停頓、轉身時多出來的兩格。生成影片是把你描述過的動作補間出來。它可以很漂亮,卻完全沒有表演,因為沒有人演過它。
它不是格對格的。 把一個 take 當 take 看。在時間軸上把生成影片拉長去填滿一個位置,會改變動作的速度,也就改變了表演——而那正是你在測的東西。要嘛按長度重新生成,要嘛修短,不要改它的時間。
它可以讓整段看起來完成到可以跳過檢討。 這一個最貴。一段打磨過的影片會招來「這看起來很棒」,而真正有用的意見是「這顆鏡頭長了兩秒」。先關聲音看,再只看聲音,最後兩者一起。
另外兩條界線屬於製作,不屬於工具。拼貼樣片是從現成的電影、電視或廣告剪出來的,臨時音軌通常是暫時借用的配樂;兩者都只在被放給看的那個房間裡有效,除此之外沒有授權。還有,動態分鏡不是完成動畫,不管生成出來的畫面多好看——完成品的工藝是畫功、表演和算圖,這三件事都不在這一關發生。
這一頁不確定的地方會直接講:那四個數字是量測定義,不是業界標準;Ottermind 的一次生成除了照你寫的指令走之外,還能多貼近導演的意圖,本文不做任何主張。這件事沒有為本文做過基準測試。
哪裡會出錯,以及修掉它的那句指令
| 檢討時你看到的 | 實際發生的事 | 修掉它的那句指令 |
|---|---|---|
| 每顆鏡頭都差不多長 | 分鏡畫面照當初畫的長度直接丟進去,沒有人指定時間 | 算圖前照工作表給每一顆鏡頭指定長度 |
| 整段畫面往旁邊漂 | 沒有鎖死鏡頭的句子,或它被埋在描述主體之後 | 把「鏡頭固定在三腳架上」放到最前面,再描述什麼在動 |
| 角色在每一格之間變了樣 | 角色描述每次重寫一遍 | 把同一句固定的角色描述貼進序列裡的每一段提示詞 |
| 剪輯點感覺慢半拍 | 動作落在它回應的聲音之後 | 指名錨點和它必須落下的那一秒,並標出那一格 |
| 接點會跳 | 沒有頭尾定格;第一格和最後一格都已經在動 | 要求頭尾各留靜止格,剪之前先對照第一格與最後一格 |
| 推近把畫稿變成照片 | 模型重畫了分鏡畫面,而不是把它放大 | 提示詞裡保留線條粗細和紙張質感,或直接在剪輯軟體裡推 |
| 大家誇畫面好看,沒有人動刀 | 動態分鏡完成度太高,評不下去 | 關聲音看、只看聲音、再兩者一起 |
| 影片長度不對,被硬拉 | 位置是在算圖之後才決定的 | 照這個位置的長度生成,或修掉多出來的;不要改它的時間 |
從扛著台詞的那一格開始
挑一格——扛著那句台詞的那一格——先給它長度,再給它動態。把數字寫下來。然後用鎖死鏡頭的提示詞,照這個長度算一個 take,墊到臨時音軌下面,關掉聲音看一次,再關掉畫面看一次。如果這顆鏡頭兩次都撐得住,時間就是做對了,動態只是裝飾。如果它只在兩者都有時才成立,你學到了這顆鏡頭的一件事,而那就是這一關的目的。
如果分鏡畫面還不夠乾淨、不能直接當參考圖,先用 AI 圖像生成 做一張。如果問題具體出在兩個姿勢之間的動態,補間 對間距、弧線和停格的說明比這裡塞得下的多。這些提示詞預設的動作詞彙,圖生影片提示詞教學 講得完整;時間談定之後,多顆鏡頭的序列怎麼組,Seedance 影片生成案例 有實例。
如果你想自動化重複的那一輪——同一個鎖死鏡頭算四十次——什麼是 AI 代理程式 講的是把這個迴圈交給系統、而不是交給人的那種工作流。它會是另一篇文章有它的理由:動態分鏡的決定仍然在你手上。
幾個值得回答的動態分鏡問題
動態分鏡不就是把分鏡存成影片檔嗎?
不是。分鏡本身沒有長度,直到有人指定為止;而動態分鏡的全部內容就是那些指定。分鏡畫面可以和分鏡稿一模一樣,動態分鏡照樣可以是錯的,因為剪輯節奏、停格和聲音,都是分鏡稿不必做的決定。
動態分鏡該做多長?
和完成品一樣長,一秒不差。這一關的重點就在這裡:一個 30 秒的時段就得用 30 秒的動態分鏡填滿,否則那個差距會在之後被發現,代價是十倍。如果是長片,就一段一段做,不要想一次握住整部片。
做之前一定得先有聲音嗎?
你需要一個可以對時間的東西。動畫裡通常是錄好的配音加上幾個效果音,Leica 卷就是這樣組起來的;廣告裡可以是臨時音軌。沒有聲音的動態分鏡還是可以測剪輯點,但測不出剪輯點有沒有「落地」,因為落地是畫面和聲音之間的關係。
AI 可以把我的分鏡變成動態分鏡嗎?
它可以把你每一格變成一顆會動的鏡頭,對運鏡和環境動態來說是真的省事。它不會替你指定長度、排剪輯順序,也不會告訴你哪一格是多餘的。預期要自己組、自己排時間——模型提供 take,不提供決定。
動態分鏡和預演有什麼不同?
預演管的是鏡頭的機位和實際場面調度,通常用在實拍或視覺特效,而且常在 3D 裡做。動態分鏡管的是長度和節奏,而且通常是畫出來的。實拍專案兩者都可能需要;兩分鐘的解說片通常只需要後者。
rip-o-matic 是同一件事嗎?
那是廣告裡的一個變體:用現成的電影、電視或廣告剪出來的動態分鏡,用來模仿提案那支片子的長相。時間的邏輯一樣,權利狀況不一樣——它是提案用的道具,不是交付物。
