提示詞指南
補間:關鍵影格、間距與中間影格
補間就是你已經定好的兩個姿勢之間的那些影格。輸入框裡已經填好本頁開頭的間距提示詞,你可以先讀一遍、改一改,再決定是否傳送。
選填
JPG / PNG / WebP
這是 Ottermind 的輸入框,不是 Dreamina 的介面。提示詞已經填好;傳送是另一個動作,會接著進入 Studio。
2026年11月12日 · 約 10 分鐘
補間(tweening)負責的,是你已經決定好的兩個影格之間的那段工作。 定義動作的姿勢是關鍵影格;觀眾在兩者之間看到的一切,都是補間。這些影格總得有人提供——坐在桌前的動畫師、對屬性做插值的動畫工具,或者現在被交代「該發生什麼」的影片模型。如果你講不出第一格和最後一格長什麼樣,就沒有東西可以補,出來的結果會像畫面在漂,而不是在動。
用得上的時機,是動作有起點、有終點,而中間那段才是問題的時候:產品要橫越整個佈景但不能被碰到、鏡頭推進該累積重量而不是平順滑過、五秒的循環必須收在開頭那個姿勢上。用不上的時候,是剪接本身就是重點的時候——一個急停、一個硬式對位剪接,或刻意從一個姿勢直接跳到另一個姿勢,只要被抹平,力道就沒了。
這份指南是怎麼準備的: 文中引用的公開頁面在 2026 年 11 月 12 日查核過:Dreamina 的補間說明與其 Multiframes 指南、New York Film Academy 關於迪士尼十二項動畫原則的頁面(用於姿勢對姿勢與弧線)、MDN 的 easing function 參考(用於下文引用的 cubic-bézier 數值),以及 RIFE(ECCV 2022)的影格插值專案(用於插值倍率與失敗模式)。Ottermind 圖生影流程的描述,來自 Ottermind 自家的工具頁面。這是一份工作指南,不是實測基準:本文沒有在 Ottermind 跑過任何生成,也沒有把任何輸出當成測試結果。封面與插圖是 AI 生成的示意圖;影格間距示意圖是依文中列出的算術畫出來的。文中出現的數字,不是引自上述來源,就是依你在螢幕上量測的方式定義出來的。
補間是什麼:拆成幾個決定來看
姿勢對姿勢(pose-to-pose)動畫會先設定關鍵姿勢,之後再回填中間的空隙;這和 straight-ahead(逐格順畫)相反——後者是每個影格照順序直接畫下去。New York Film Academy 對迪士尼動畫原則的整理,就是這樣描述姿勢對姿勢:先有關鍵影格,才有中間的動作。補間就是後面那一半。它不是風格,也不是氣氛;它是一個排程問題,產出可以被量測。
有四項屬性能決定補出來的影格看起來是動作,還是一張張幻燈片。
| 屬性 | 怎麼量 | 補間做對時的樣子 | 它對應的失敗 |
|---|---|---|---|
| 間距 | 移動元素連續兩個位置之間的距離;把每一段間距除以前一段 | 比值在動作過程中會變——間距往中段變寬,往結尾再收窄 | 比值從頭到尾卡在 1.0 附近:等速,也就是「貼紙被拖著走」的樣子 |
| 弧線 | 主體實際路徑與「起點連到終點的直線」之間的最大距離,換算成那條直線長度的比例 | 被拋出、被甩動或被抬起的物件,會偏離直線往外鼓 | 該彎的動作走成死直線,或路徑在中途出現折角 |
| 停格(hold) | 開頭與結尾各有幾格和相鄰影格完全相同 | 兩端各有兩格以上的靜止,讓影片可以被剪開或循環 | 第一格就已經在動:接點會出現明顯的跳動 |
| 峰值速度 | 最快的單格位移,除以整段的平均值 | 有加減速的動作會大於 1.0,因為中段比兩端快 | 你要求重量感,量出來卻正好是 1.0:你得到的是插值,不是動畫 |
這四項不是美術學校的抽象概念。每一項都能在幾分鐘內從一串影格裡量出來,而且每一項都會告訴你該改哪一句指令,而不是「再換一組更好的提示詞試試」。
影格數是這一切的地板。24 fps 下,四秒的動作是 96 格;60 fps 下是 240 格,而這 240 個狀態每一個都得說得通。這就是為什麼短片補間比長片可靠:同一句動作方向指令,能漂掉的空間比較少。
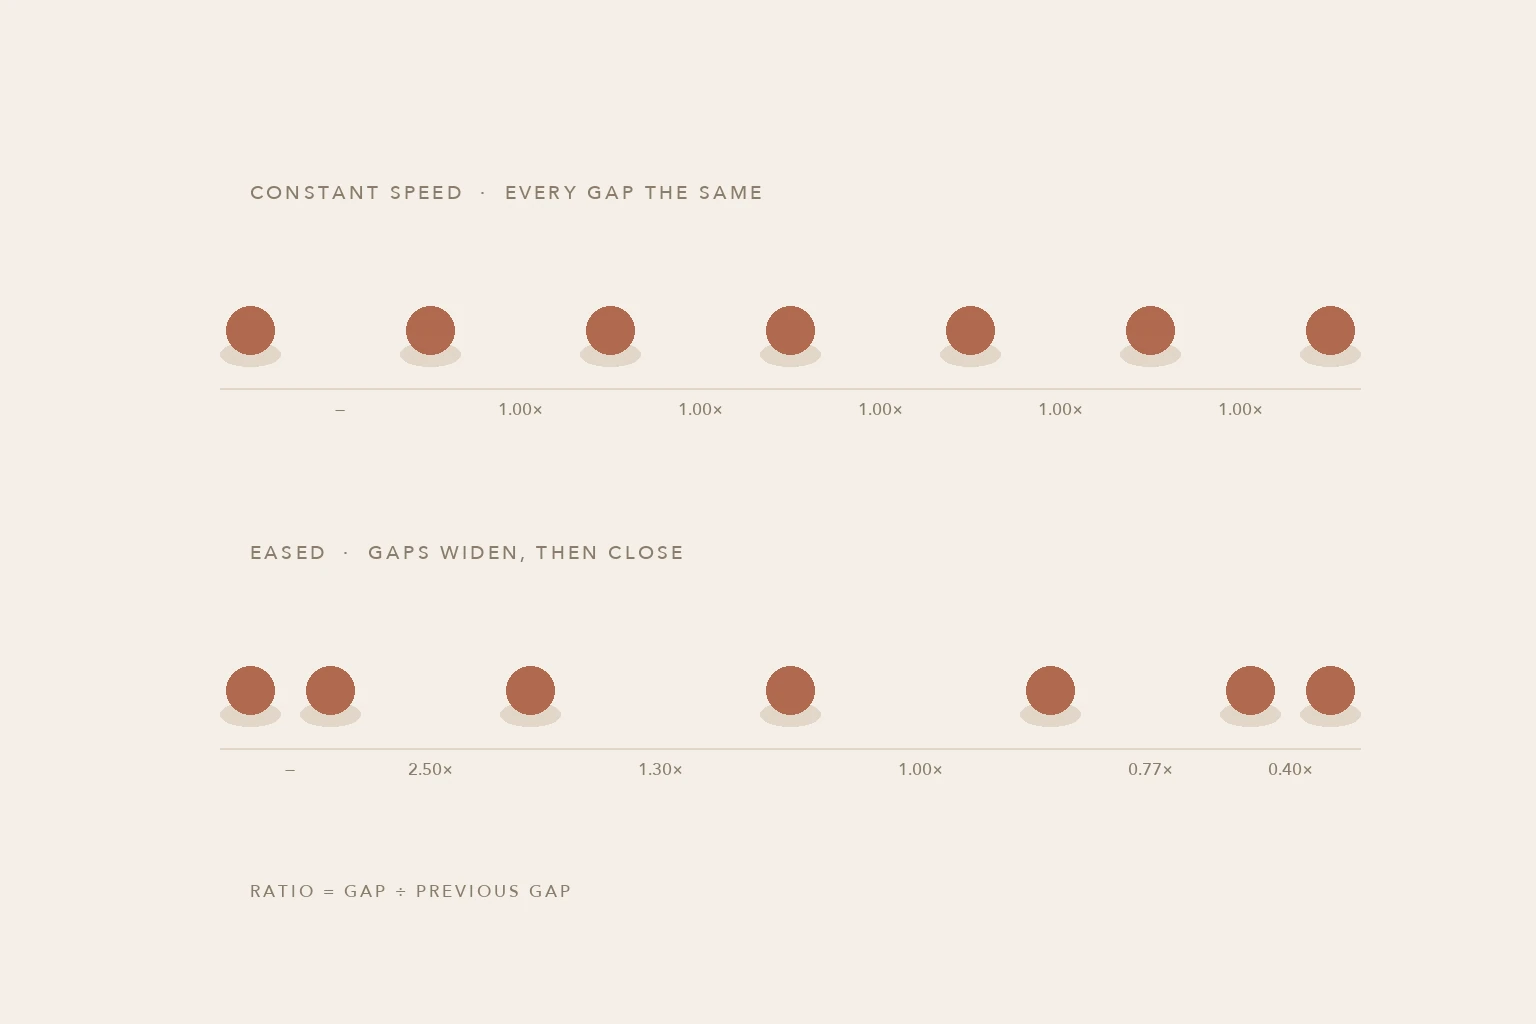
間距示意,依文中列出的算術畫成,不是模型輸出:同一趟移動上的七個位置,一次等速,一次用 smoothstep 加減速。每段間距下方的數字,是那段間距除以前一段的結果。比值持平,就是補間看起來像貼紙被拖過畫面;比值先升後降,才是你寫「緩慢停下」時真正在跟模型要的東西。
現在是誰在補中間的影格
四種安排,幾乎涵蓋你會實際跑到的每一種補間。
由人在兩個關鍵影格之間補。 這仍然是最標準的情況:關鍵影格畫好,中間影格照著它們的體積與線條畫,間距由動畫師親手控制。
把兩個關鍵影格交給影片模型。 你提供起始影格和結束影格,請它做出中間的過渡。這是軟體上最接近傳統補間的做法,也是控制最緊的一種安排,因為兩端都固定住了。
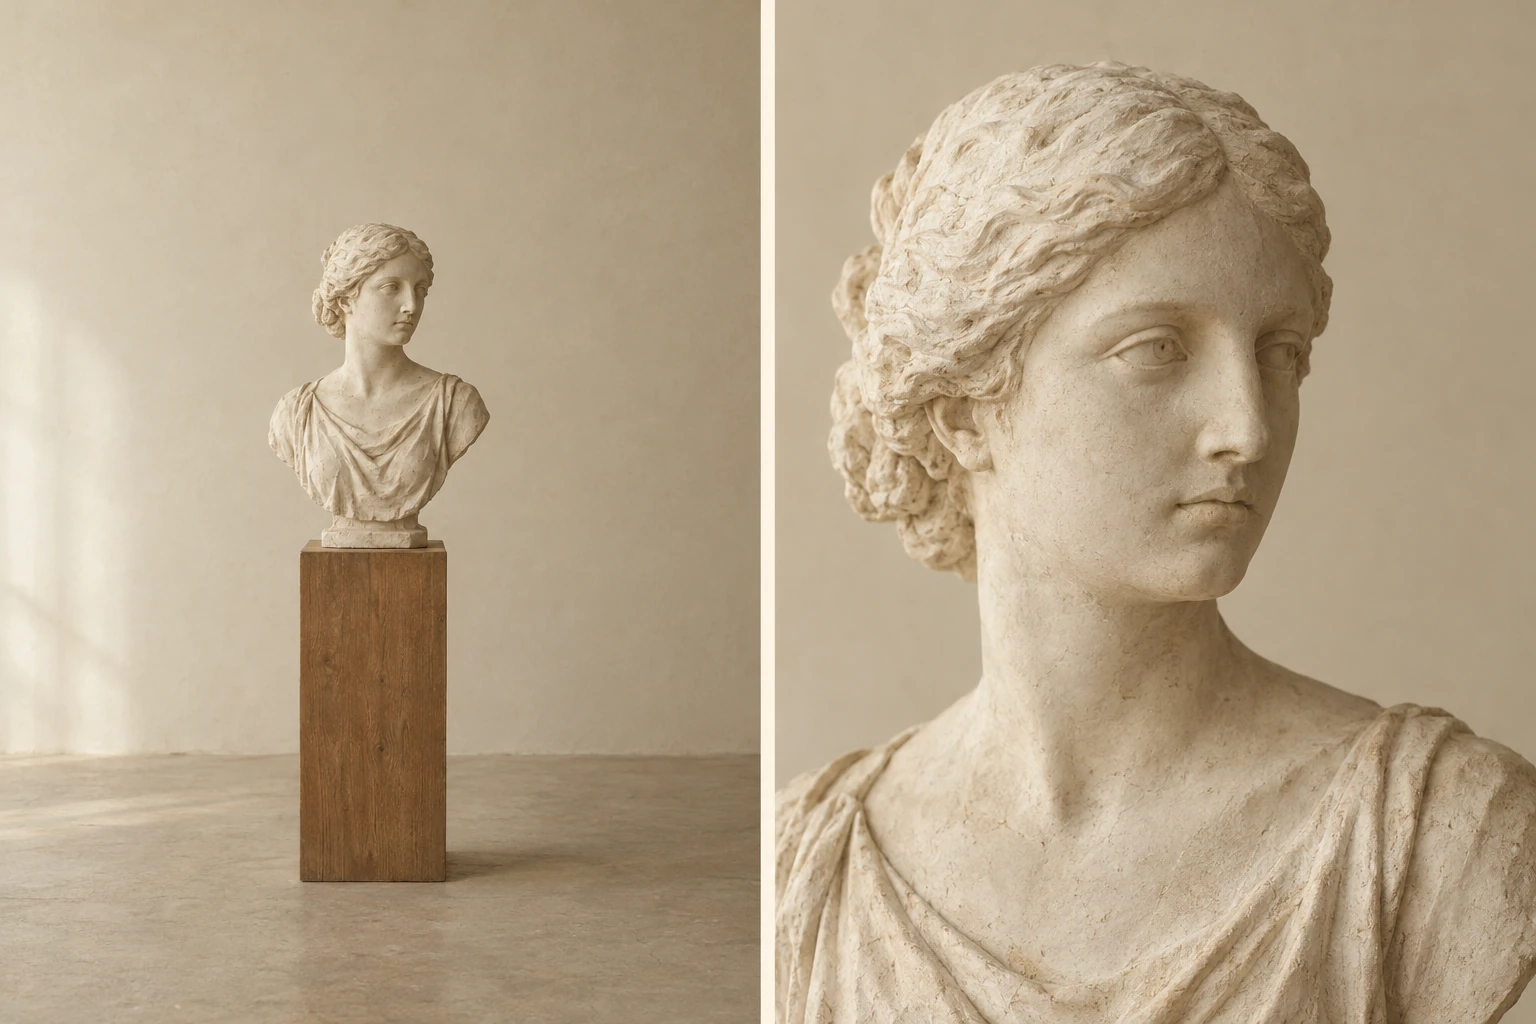
兩個關鍵影格,一段補間。左邊是開場影格。右邊是結尾影格,同一個主體、同一個角度、同一種光。兩者之間的一切都得由模型自己想出來,這也是為什麼把兩端都固定住,是控制補間最便宜的方法。本文的概念圖以影像模型生成;它示範的是雙關鍵影格的鏡頭長什麼樣,不是從某次生成裡抽出來的影格對。
規劃之前,先確認你用的工具真的有兩個輸入端——只有一個附檔位置的圖生影介面,不管行銷文案怎麼叫它,都不是雙關鍵影格補間。
一個關鍵影格,加上用文字描述的動作。 Ottermind 的圖生影流程吃一張參考圖和文字指示:主體動作、環境動態、鏡頭行為、節奏,以及預計停在哪一格。參考圖提供第一個狀態與質感;提示詞提供補間,包括它最後要停在哪裡。這是現在多數人講「AI 補間」時指的安排,也是最吃文字的一種。
一次給多個關鍵影格。 有些工具接受的是一串關鍵影格,而不是一對。Dreamina 的 Multiframes 說明(2026 年 11 月 12 日查核)寫的是上傳 2–10 張影格,每張指定 1–6 秒的時長,組成一鏡到底的長鏡頭。當一段補間其實是一連串動作時很好用,也提醒你:五段動作的序列是五段補間,不是一段。
加減速是最常被提示詞漏掉的那一句
有加減速的動作會慢慢起步、加速,再減速。線性動作不會。如果你的提示詞只寫了終點,通常會得到接近線性的結果,然後花三次重算去修那個感覺,卻始終沒說出原因。
這些曲線名稱都有確切數值,所以值得直接用,不必繞開。MDN 的 easing 參考(2026 年 11 月 12 日查核)寫明 ease-in 是 cubic-bezier(0.42, 0, 1, 1)、ease-out 是 cubic-bezier(0, 0, 0.58, 1)、ease-in-out 是 cubic-bezier(0.42, 0, 0.58, 1)。你可以把這些數字貼進提示詞,也可以換成下面那句白話——多數影片模型對白話反應更好,而你選的仍然是同一條曲線。
| 動作應該有什麼感覺 | 帶得出這個感覺的說法 | 對應的曲線 |
|---|---|---|
| 重物開始滑動 | 幾乎不動地起步,中段把速度拉起來,到結尾還在移動 | ease-in |
| 有東西到位並停穩 | 帶著速度進來,最後三分之一減速,然後直接停住 | ease-out |
| 鏡頭推進,但要輕輕落地 | 慢慢開始,中段快一點,收得溫和 | ease-in-out |
| 機械或輸送帶 | 等速,不加速,也不收尾 | linear |
| 彈跳或撞擊 | 往下加速,觸地即停,小幅回彈,然後靜止 | 落下用 ease-in,觸地停格 |
兩個習慣可以擋掉大部分的加減速失敗。第一,講速度變化的形狀(「幾乎不動地起步」、「最後三分之一減速」),而不是形容詞(「順」、「電影感」);第二,講出速度在哪一格、哪一刻改變,而不是只給總長。模型如果知道開頭還很慢、中段很快,就有東西可以插值;只被告知「慢」的模型,手上只有一種氣氛。
五組提示詞,每次只動一個變數
以下幾組是為「一張圖加文字指示」的流程寫的。每一組只動上表其中一項屬性,其他都不碰,這樣結果才能告訴你哪一句話有效。主體可以換掉,句型留著。
1. 間距與加減速
控制的變數:加速曲線,也就是整段動作中間距的比值變化。
把附上的產品照做成一鏡到底的動畫。鏡頭緩慢推進,開頭幾乎不動,在影片中段把速度拉起來,最後在最終構圖上緩慢停住。加速要平順連續——不要速度跳階,不要中途停頓,不要突然停住。看的是位置與位置之間的間距,不是總位移。如果每一秒走的距離都一樣,那句加速就被忽略了,你拿到的是線性推進。
2. 弧線
控制的變數:路徑,也就是主體走直線,還是偏離直線往外鼓。
鏡頭固定不動。把紙飛機從左下角往上、往右上帶,沿著一條向上鼓起的平滑弧線。機身順著弧線傾斜,並保持這個傾斜角直到離開畫面。它要從畫面外進來、從畫面外出去,而不是在畫面內起飛或停下。檢查弧高:從紙飛機進畫面的位置到離開的位置畫一條直線,看路徑偏離這條線多遠。路徑是直的,就代表弧線那句輸給了模型「把東西從 A 移到 B」的預設行為。
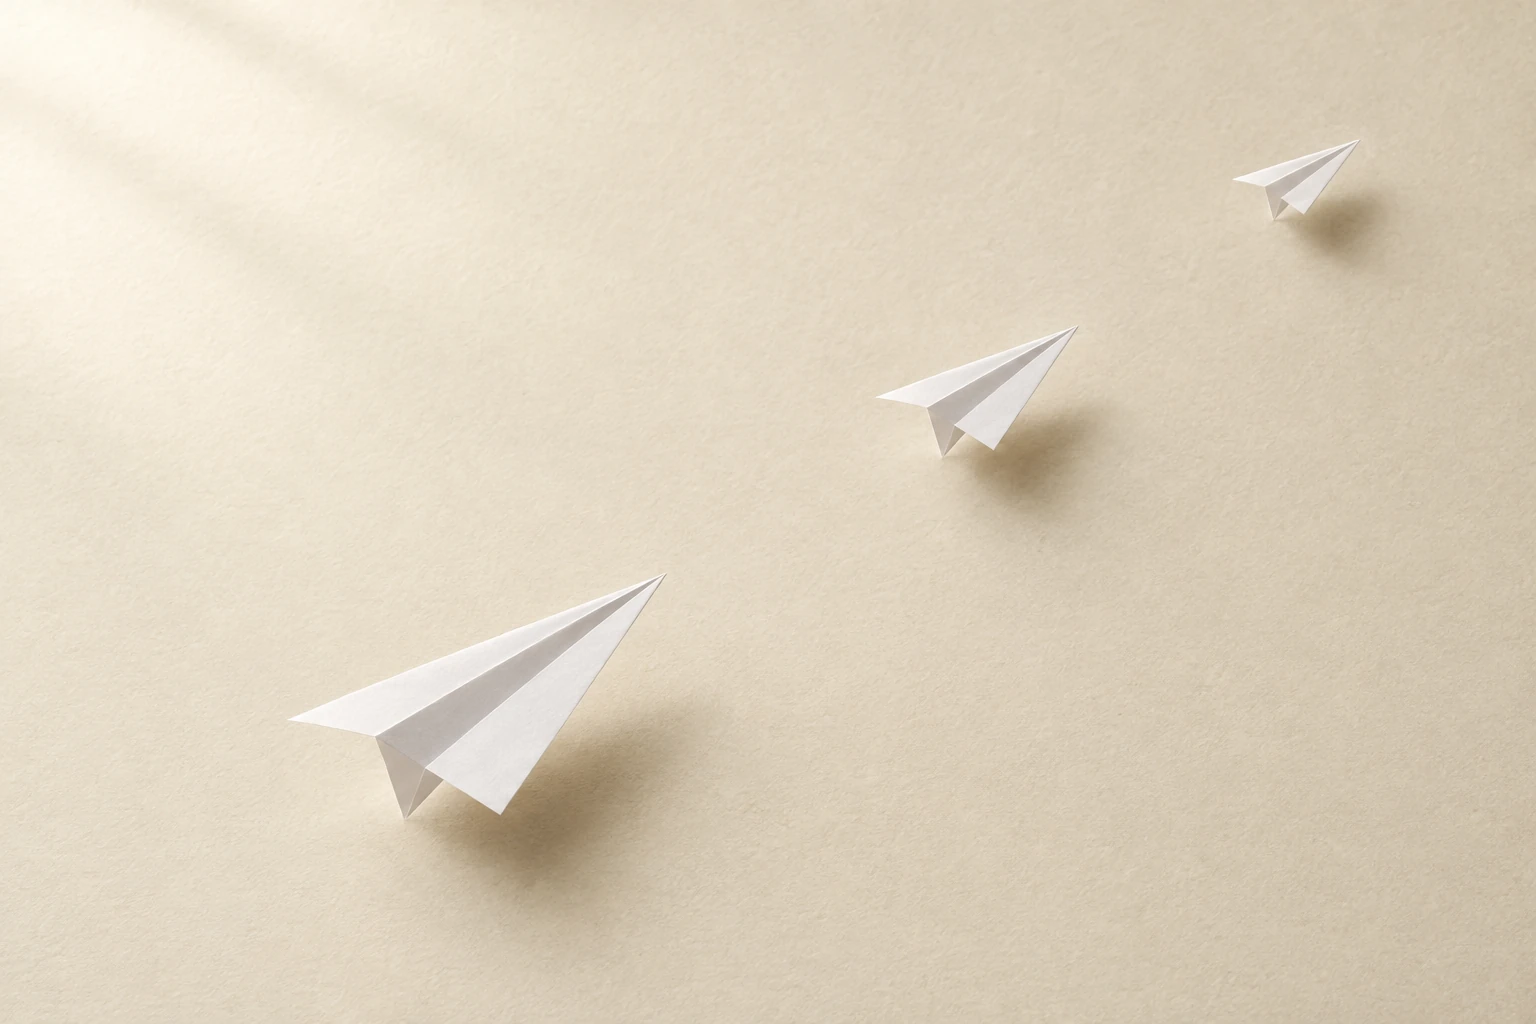
一個主體、三個瞬間、一條路徑。大小的變化告訴你路徑正在離開鏡頭,而三個印記之間的距離,就是間距的決定顯現出來的地方。本文的概念圖以影像模型生成;它示範的是關鍵影格之間有路徑這件事,不是實測的生成結果。
3. 結尾停格
控制的變數:兩端各有幾格靜止,也就是這段影片能不能乾淨地循環或剪開。
開場那一拍,第一格完全靜止不動,然後讓蒸氣開始往左上飄。最後一拍蒸氣沉下來,畫面回到它開頭那個同樣靜止的姿勢,這樣影片就能無縫循環。拿第一格和最後一格比。如果構圖或主體位置不一樣,循環就會跳;如果第一格就已經在動,跳動會出現在剪進來的接點上。
4. 變形額度
控制的變數:哪些像素可以改變,也就是模型可以重做多少參考圖。
只動我指定的部分:亞麻背景輕輕晃動,像有扇窗開著。瓶身、標籤、玻璃上的反光,以及它投下的影子,全部保持參考照裡的樣子——形狀一樣、字體一樣、位置一樣。不要重畫標籤,也不要在畫面任何地方加上新的文字。這一句能修掉大多數「AI 融化」的抱怨,因為它把一個模糊的期待(「保持一致」)換成一張「不准動」的清單。預期它會減少變形,而不是消除變形:文字和細密的花紋在長片裡還是會漂。
5. 鏡頭與主體
控制的變數:這個動作屬於鏡頭,還是屬於畫面裡的東西。
鏡頭固定在目視高度的腳架上,完全不動。主體是那個陶瓷馬克杯;只有蒸氣,以及沿著杯緣移動的那道反光在變。不要變焦,不要推進,不要視差,不要手持晃動,背景留在原位。一句提示詞裡放兩種動作,會互相抵銷。講清楚哪一種是被允許的,比在已經要求推進的提示詞尾巴補一句「不要有鏡頭運動」快得多。
按鈕會把第一組提示詞填進本頁上方的輸入框。它只負責填入,不會送出,也不會生成任何東西,要你在 Studio 繼續才會開始。這樣切開是刻意的,因為這些提示詞的主體只是佔位——在花一次生成之前,先換成你參考圖裡真正有的東西。
AI 補間常錯在哪裡
下面這些失敗是生成式補間特有的,所以在處理更熟悉的手藝問題之前,值得先檢查一輪。
| 你看到的 | 實際發生的事 | 修得掉它的指令 |
|---|---|---|
| 主體融化、彎掉,或多出第二個把手 | 模型在發明新影格,而不是對參考圖插值,而且變形額度從頭到尾沒講 | 講清楚什麼不能變:形狀、標籤、字體、位置。把影片縮短,讓它能漂的空間變小 |
| 細密花紋和臉在原地沸騰、閃爍 | 時間上的不穩定——每一格單看都合理,和隔壁那格卻對不上 | 減少動作、把畫面裡太雜的紋理拿掉,或把一段長動作拆成兩段短的 |
| 從第一格到最後一格,動作間距完全平均 | 預設就是線性插值;沒有人要求加減速 | 講出速度變化,以及它在哪裡發生,不是只講終點 |
| 補間衝過終點又彈回來 | 模型把「到位」當成撞擊,而不是停穩 | 要求它停住,並讓最後一拍靜止;在停穩那一格把影片切掉 |
| 鏡頭明明該鎖住,整個畫面卻在漂 | 鏡頭運動和主體運動都留著沒講 | 寫「鏡頭固定在腳架上」,而且要寫在主體描述之前,不是之後 |
| 手、翅膀或輪子轉過一個不可能的角度 | 補間跨過了一個模型沒有參考的構型 | 在那個不可能的姿勢把動作斷開,兩半各自補 |
| 循環在接點跳一下 | 沒有結尾停格,模型讓動作跑出了最後一格 | 把停格明確寫出來,然後在循環之前比對第一格與最後一格 |
補間不是影格插值,也不是形變
工具行銷會把三個詞混著用。它們回答的其實是不同的問題。
影格插值是在兩張已經存在的影格之間補格子,用來提高影格率,或把一個鏡頭放慢。它從像素去估動作,而不是發明一個場景。RIFE 專案(ECCV 2022,2026 年 11 月 12 日查核)對這個做法有最清楚的技術描述:它在一對影像之間以任意時間點插值,並標榜 2X、4X、16X 的倍率。因為輸入的影格是真的,插值沒辦法加入原本不在裡面的東西——而且它在遮蔽(occlusion)處會很明顯地失敗,也就是一個物件從另一個物件前面經過的地方,產生那種被人們怪罪到「AI 補幀」頭上的扭曲邊緣和殘影。如果你的問題是既有素材會頓,你要的是這一類工具;如果你的問題是動作的中段根本不存在,你要的是補間。
**形變(morphing)**是把一個東西刻意變成另一個東西:一張臉變成風景,一代產品變成下一代。它不是加減速做得更好的補間。補間在動作過程中維持主體的辨識性,把形狀當成固定的;形變則是刻意把那份辨識性溶掉,這正是為什麼當標籤、臉或標誌必須保持可辨時,它會是錯的選擇。如果需求寫的是「A 變成 B」,那你描述的是形變,就算你用的是「補間」這個詞。
動態圖像工具裡的關鍵影格動畫又是第三件事。在那裡,軟體對你設定的關鍵影格之間的數字——位置、縮放、不透明度——做插值,像素是確定性地跟著走。這就是為什麼 3D 或 2D 合成軟體能給你精確的間距控制,而 AI 模型給你的是對你指令的一種解讀。當元素是你自己擁有的圖形,用合成軟體;當影格本身必須被生成,用影片模型。
實際操作的順序
- 先把兩端定下來。 在寫其他任何東西之前,先用文字描述第一格和最後一格。如果你描述不出來,這個鏡頭還沒到可以補間的階段。
- 判斷問題是四項屬性裡的哪一項。 間距、弧線、停格,還是鏡頭與主體。每次只改一項;一次修好全部的提示詞,什麼都告訴不了你。
- 把主體寫成一張「不准變」的清單。 標籤、幾何、標誌、顏色、影子。這是對抗融化最便宜的保險。
- 先做短的,再延長。 兩秒讀得出來的動作,比六秒會漂的動作有價值;更長的序列可以用已經成立的片段接起來。
- 先量再判斷。 數影格、比對首尾、算間距比值。「就是怪怪的」只有在你看過之後,才會變成「間距比值是平的」。
當補間是一張靜圖開始動起來,參考圖和提示詞一樣重要。如果你需要先有一張更乾淨的起點圖,用 AI 圖像生成做一張,再把那個影格當參考帶進來。如果補間只是更長剪輯裡的其中一個鏡頭,Seedance 影片案例說明了多鏡頭序列怎麼組起來,而圖生影提示詞教學涵蓋了這一頁假設你已經會的動作詞彙。
幾個關於補間的常見問題
補間和動態圖像(motion graphics)是同一件事嗎?
不是。動態圖像是一門專業——為螢幕把字體和圖形動起來——而且通常靠關鍵影格插值來完成。補間則是「把兩個關鍵影格之間的影格補出來」這個特定動作。一支動態圖像片頭可以包含很多段補間;一個手繪角色鏡頭則可能一段都沒有,如果每一格都是照順序直接畫下去的。
中間的影格要補幾格才夠?
夠到讓動作在你交付的影格率下讀得出來。24 fps 下,四秒的動作有 96 格,而慢的動作比快的動作需要更多格,才不會看出明顯的跳格。實務上,限制不在影格數,而在模型:先要一段短的,確認動作對了,再延長,而不是硬撐著把一段長的補間維持住。
AI 可以自動補兩張圖之間的影格嗎?
只有在工具提供兩個關鍵影格輸入時才行。很多圖生影介面只收一張參考圖加一段文字指令,那就是單關鍵影格補間:結尾由模型決定。規劃雙關鍵影格鏡頭之前,先確認輸入端;如果只有一個位置,那就把結尾描述得精確一點——「停在左前方的四分之三視角」比「平順地移動」有用得多。
為什麼我的補間看起來像在滑動?
因為間距比值是平的。主體正以等速被移動,兩端都沒有加減速,看起來就像一張貼紙被拖過靜止畫面。講出加速、講出速度在哪裡改變,然後看動作的中段,而不是只看頭尾。
影格率會改變補間的結果嗎?
它會改變補間要做多少工。同一段四秒的動作,24 fps 下是 96 格,60 fps 下是 240 格,格子越多,小小的不一致就越容易被看出來。插值可以提高你手上素材的影格率,但救不回一段動作本身錯掉的補間——先修動作,再考慮影格率。
拿一張你自己的影格試一次
補間吃的是具體的指令,不是長的指令。拿一張主體清楚的靜圖,用各一句話寫出開頭和結尾,然後選一項你想改的屬性,只改那一項。Ottermind 的圖生影流程會把你的參考圖和動作指示帶進 Studio,在那裡你可以換一句指令重算,並拿同一個影格比較不同版本。
如果你還在挑模型而不是挑動作,AI 影片生成器比較整理了各家差異,而無露臉短影音工作流說明了兩秒的補間在一段更長的剪輯裡落在哪個位置。
