AI Fruits:如何做出撐得過一支影片的水果角色
AI fruits 是長著臉孔、有聲音、有行動理由的水果角色。單支影片是生成問題,連續劇集是連貫性問題。先固定一張角色圖,再為每支影片只寫一個動作。
選填
JPG / PNG / WebP
這是 Ottermind 的輸入框。簡述和參考圖都先留在草稿裡,按圓形箭頭才交給 Studio 審核。
2026年11月14日 · 約 13 分鐘
AI Fruits 是有臉、有聲音、還帶著一點點行動理由的水果造型角色,影片短到能在手機上看完。 這個格式在大概十八個月裡,從水果 ASMR、加字幕的迷因、會說話的農產品,一路走到連續劇式的水果劇,而現在它已經變成一種搜尋結果裡全是生成器、每個都帶著模板等你去改的關鍵字。
你今天就能做出一支這樣的影片。但第一次做,你沒辦法讓第六支看起來跟第一支一樣:同樣的表皮、同樣的籽排法、同樣的臉、同樣的世界。這正是模板頁面略過的部分,也是這篇指南從頭到尾圍繞的重點。一支影片是生成問題,一集節目是連貫性問題。
這篇指南怎麼做出來的: 公開頁面在 2026 年 11 月 14 日查閱:Media.io 的 AI Fruit Story 專區頁、Designkit 的 AI fruits 說明文(2026 年 8 月 13 日發布),以及 Ottermind 的 Image to Video、Photo to Video 與 AI Reel Maker 頁面。趨勢歷史依照這些頁面的描述呈現,包括它們歸給 Know Your Meme 的日期;某競爭者引用的觀看次數屬於行銷說法,這裡不當成事實重複。這是一篇工作流程指南,不是速度或品質的基準測試。本文沒有生成任何影片,因此不把任何片段當成成果展示。封面與三張圖是為本文以 Image 2.5 系列模型(GPT Image 2.5)生成,並標示為概念插畫;合成器截圖則是這個頁面的真實截圖。
大家實際上在做什麼
這個趨勢走了一年半,長出幾種差異很大的格式,一旦你決定發超過一則,差別就會立刻顯現。時間軸最常被引用的那篇趨勢整理把它拆成五個彼此重疊的階段:2025 年的水果 ASMR、大約 2025 年 7 月起有臉的水果吃同類、同年 8 月加字幕的水果迷因、2025 到 26 年會說話的水果,以及 2026 年的連續劇式水果劇。同一篇整理也提到,一齣全部由 AI Fruits 擔綱的戀愛實境節目惡搞劇在 2026 年 3 月於 TikTok 爆紅——那是這個格式不再只是單一玩笑、開始變成一齣節目的時刻。
這段歷史有一個很實際的意義:你在時間軸上走得越後面,每一支影片就越依賴前一支。自我進食的草莓是一個十五秒的點子。一個性格固定、會一再回來的水果,則是一份製作工作,需要卡司、需要定裝,還需要一套留下來可查的紀錄。
| 格式 | 畫面上發生什麼事 | 撐起影片的是什麼 | 重複製作的成本 |
|---|---|---|---|
| 水果吃自己 | 一顆水果被餵下同類的一小塊,咬一口、有反應 | 那一口、那一聲脆響、那種詭異的落差 | 低——換一顆水果就是一支新影片 |
| 嬰兒臉水果 | 圓潤的五官、超大眼睛、一個誇張的反應 | 可愛撞上某種說不出的不對勁 | 低,直到你想讓同一張嬰兒臉出現第二次 |
| 會說話的水果 | 角色對著鏡頭講一句台詞或一個笑話 | 節奏,以及清楚的嘴型動作 | 中——聲音和臉必須對得上 |
| 水果 ASMR | 切片、剝皮、擠壓,靠聲音撐起整支影片 | 表面質感與乾淨的音訊 | 低,但觀眾群很窄 |
| 短篇水果故事 | 一兩個角色走到一個笑點或一個決定 | 在影片內就能收束的衝突 | 中——第二個角色需要一套設計 |
| 連續劇式水果劇 | 固定班底、分集、懸而未決的張力 | 外觀、性格與世界觀的連貫 | 高——多數人的嘗試都敗在這裡 |
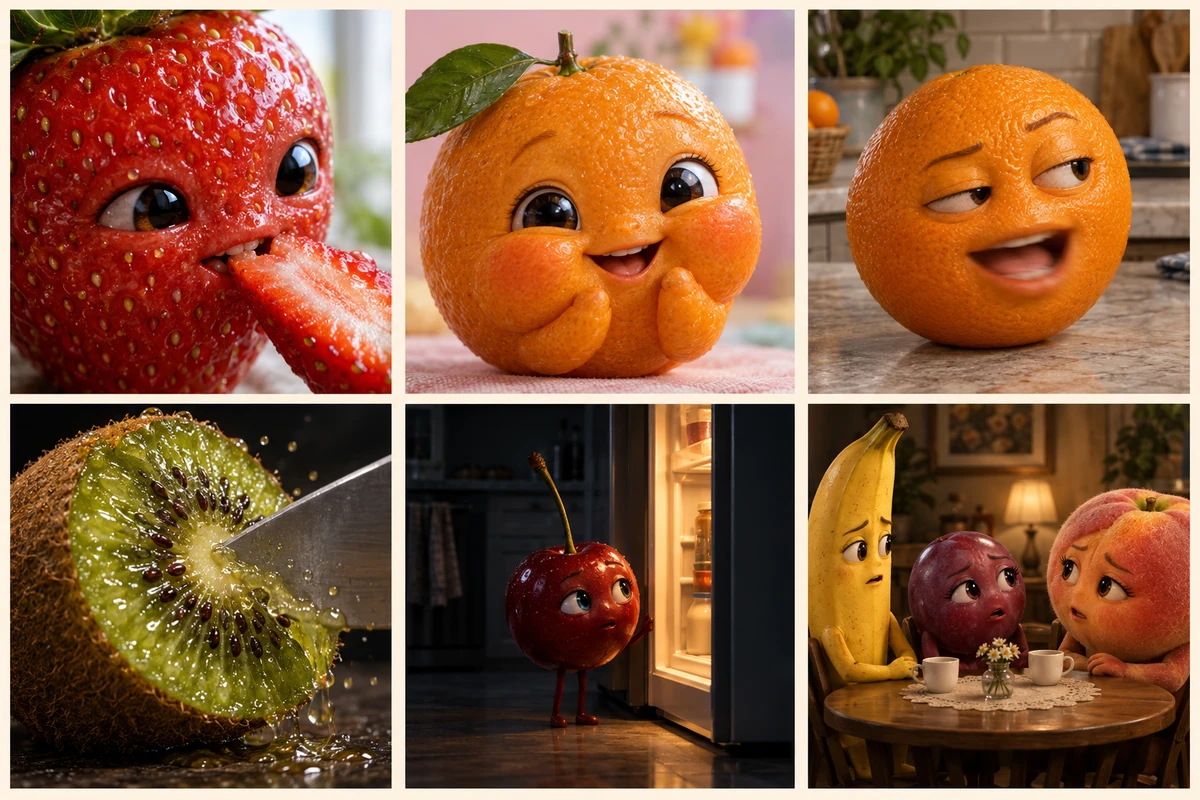
六種格式一張看完:咬一口、嬰兒臉、對嘴說話、ASMR 切片、單一故事節拍,以及圍坐桌邊的固定班底。本文以 Image 2.5 系列模型生成的概念插畫;不是截圖,不是已發布的範例,也不是推薦的成果。
最右邊那一欄值得讀兩次。生成器頁面會很樂意賣你左邊那一欄,因為一個能生出一支好笑影片的模板,本身就算是完整的產品。但如果你打算做系列,你要買的是最下面那一列,而最下面那一列取決於你在兩次工作之間留下了什麼,不是你選了哪個模型。
為什麼第六支影片看起來像換了一顆水果
每一次生成都從你交給它的圖片或文字開始。你給它一段文字,它就每次重新發明那顆草莓:新的籽密度、新的葉片角度、新的眼睛位置,還有一張悄悄變寬或變窄的嘴。這些差異單看都不明顯。疊上五次,整個卡司就等於被換掉了。
解法不是換一個更好的模型。解法是給模型一個可以回頭參照的參考圖,再加一段寫清楚「哪些部分固定不變」的指示。Designkit 的指南在建議固定角色改用圖生影、而不是文生影時,把話講得很白:參考圖能改善連貫性,但不保證連貫。這句話就是誠實的界線,值得你順著它設計流程,而不是跟它爭。
三個習慣就能撐起大部分工作:
- 一張定稿圖,多支影片。 角色圖只生成一次、檢查過,然後把那個檔案重複當成這一輪每支影片的視覺參考。
- 一支影片一個動作。 一份需求裡放兩個動作,就是給臉兩次跑掉的機會,因為模型得同時把兩件事都解決掉。
- 一段寫下來的角色身分區塊。 一小段文字,貼進每一個動作提示詞裡,明確點出絕對不能變的東西:表皮紅暈、籽的排列、葉冠、眼距、嘴寬。
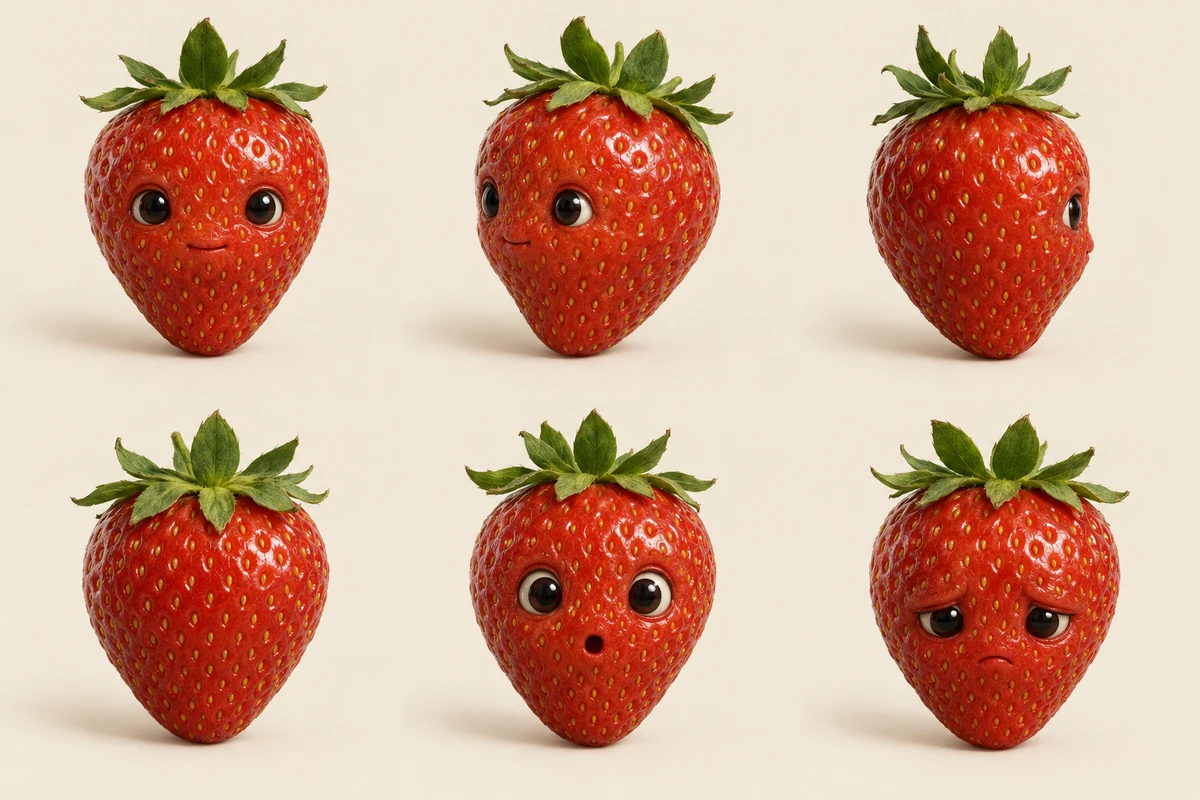
三視圖不是美術指導,而是一個你要留著的檔案。同一個草莓角色的六個視角,全在同一片米白背景上,全在同一個距離。其中任何一個視角都可以當成影片的參考。本文生成的概念插畫,不是 Ottermind 的輸出。
九個步驟的實作流程
下面的順序是刻意的。需求寫在角色之前,因為你該先弄清楚這個點子好不好笑,再決定要不要投資一組卡司。第二步之後的每一個步驟,都是為了保護你在第二步做出來的那個角色。
步驟 1:寫一支影片,不要寫一季
從一支你真的會發出去的直式影片開始。把主體、那一個動作、鏡頭、光線和結尾都寫出來。如果你沒辦法用一句話講完結尾,那這支影片就還沒有結尾。
這一段控制什麼: 動作、鏡頭行為、模型必須處理的變化量,以及這支影片能不能自己收尾。
製作一段 8 秒的直式影片。一顆光亮的紅草莓,表皮上嵌著兩隻小小的深色眼睛,嘴巴是緊閉的一小條,擺在溫暖的木質檯面上。一隻手把一支銀湯匙推過來,匙上放著一片草莓切片。草莓向前傾,咬一小口,咀嚼兩下,眼睛驚訝地睜大。固定不動的平視特寫,不推鏡、不切鏡。柔和的晨光從左方來。維持形狀、籽的排列與葉冠不變。畫面上不加文字,不放標誌。那段需求會填入本頁最上方的合成器。填入不等於送出:文字和你附加的參考圖都會停在草稿狀態,直到你按下圓形箭頭。如果你已經有角色定稿圖,送出前先附上;參考圖會引導生成,而不是把結果鎖成完全一樣的複本。
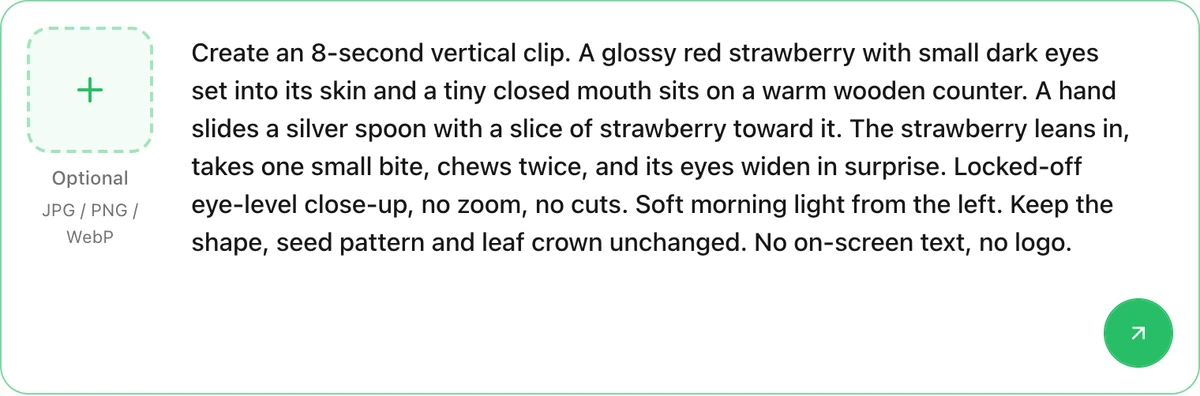
套用需求後的本文合成器:參考圖區塊是選填的,文字停在草稿,箭頭會把請求交給 Studio。這是本頁的真實截圖,示範的是請求準備,不是生成出來的影片。
步驟 2:生成角色定稿圖,然後停手
點子成立之後,把角色好好設計一次,然後定住。要求中性姿勢、乾淨背景、臉完整可見,然後把那個檔案留下來。這就是後面每一支影片都依賴的素材。
這一段控制什麼: 表皮質感、臉的構成方式、光線方向,以及之後每支影片都會繼承的鏡頭距離。
一張寫實的草莓角色靜態圖,單一主體,置中於溫暖的米白紙質背景上。臉融入表皮之中:兩隻小小的深色眼睛微微陷進表面,一張緊閉的小嘴,沒有描邊、沒有卡通陰影、沒有貼紙般的邊緣。整顆莓果都可見籽的排列,帶天然光澤與幾滴水珠,綠色葉冠挺立。柔和的窗光從左方進來,右側留一點淡影,50mm 鏡頭平視拍攝,淺景深。角色約占畫面高度的六成。不要文字、不要道具、不要手、不要第二個物件。步驟 3:把角色寫成一段身分區塊
文字比重新生成便宜。打開定稿圖,列出五個陌生人一眼就會注意到的細節,把它們寫成一段文字,之後附加在每個動作提示詞後面。清單只放觀眾一看就知道變了的東西。
這一段控制什麼: 固定不變的細節,以及當動作指令和這些細節衝突時,模型會依循的優先順序。
角色必須與參考圖完全一致:同樣的莓果形狀,寬肩、尖底;同樣排列成整齊行列的籽;同樣挺立、帶五片葉子的綠色葉冠;同樣兩隻微微陷進表皮的小深色眼睛,中間間隔約一個眼寬;同樣窄而緊閉的嘴。不要加牙齒、眉毛、頭髮或衣物。不要改變表皮光澤或光線方向。如果動作不改變臉就做不完,請保留臉,把動作簡化。最後那一句才是關鍵。它給模型一條保住角色的出路,而不是一條靠改掉主角來交差的路。
步驟 4:一支影片一個動作,分成三個節拍
一支看得懂的影片有預備、動作和反應。三個節拍塞得進一支直式短影音,五個就塞不進去。把每個節拍寫成獨立句子,弱的那個才好刪。
這一段控制什麼: 節奏、模型得同時處理幾件事,以及這支影片看起來像一個瞬間,還是一段摘要。
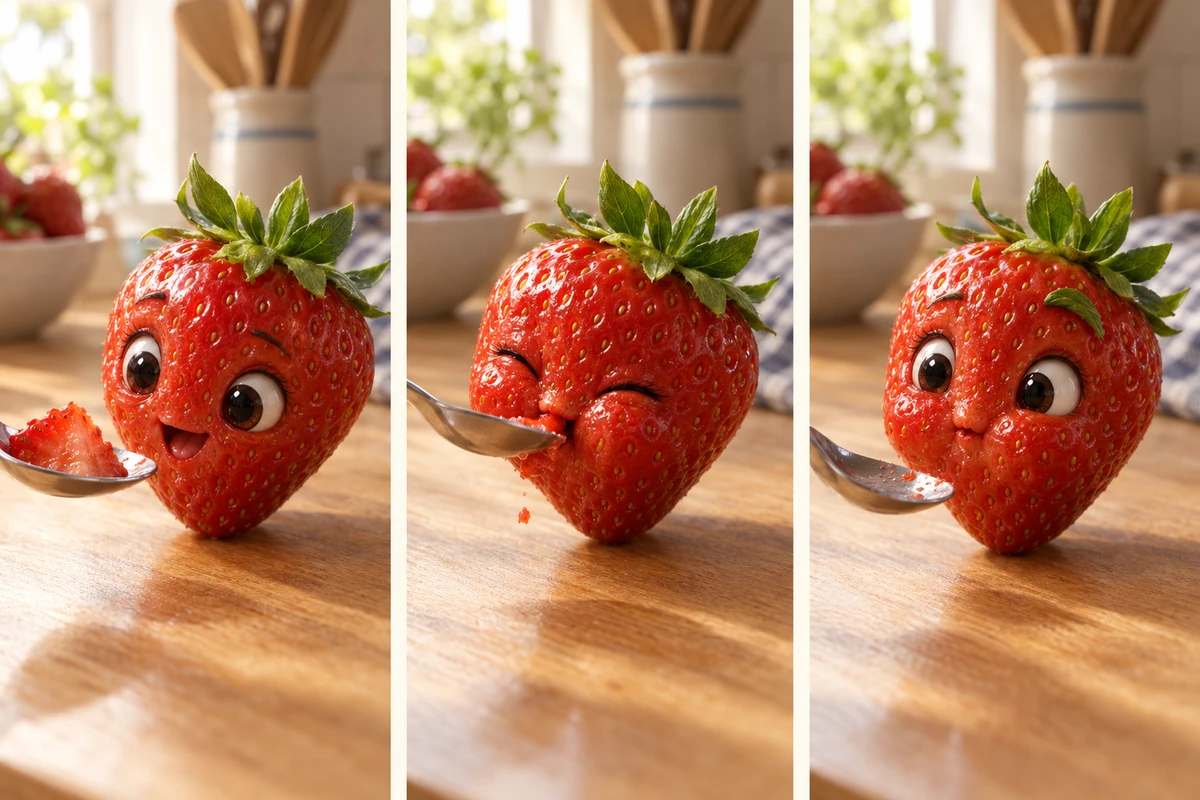
第一拍、第二拍、第三拍——同一個角色、同一張檯面、同一顆鏡頭。寫成三句,它就是一個提示詞。寫成一句,它就是三個互相打架的指令。本文生成的概念插畫。
第一拍,預備:草莓向湯匙傾身,眼睛睜大,嘴微微張開。第二拍,動作:咬下一小口,眼睛用力閉起,掉下一粒碎屑。第三拍,反應:咀嚼兩下,眼睛睜得很大,一片葉子像被嚇到一樣抬起來。連續鏡頭,節拍之間不切鏡,每個節拍約兩秒。莓果形狀、籽的排列與葉冠維持不變。檯面邊緣在整個過程中都保持在畫面同一個位置。步驟 5:給影片一個能當剪點的結尾
大多數生成出來的影片都是慢慢淡掉,因為需求裡沒說最後一格該長什麼樣。把最後的畫面寫出來。那一格也是你之後拿來當縮圖的畫面,而在系列裡,它就是下一支影片接上去的那一格。
這一段控制什麼: 最後一格、剪接點,以及交棒給下一集的接點。
草莓咀嚼完,吞下去,直視鏡頭眨一次眼。停留在那個眼神一秒,然後影片結束。最後一秒時湯匙已經離開畫面。表皮、籽的排列、眼睛與葉冠都和參考圖相同,鏡頭與光線也與第一拍保持一致。步驟 6:水果要開口,先寫台詞再寫嘴型
會說話的水果有一種很典型的失敗方式:嘴巴動得像傀儡,因為根本沒有台詞、也沒有時間節奏可以對。先把那句話寫出來,再描述嘴巴怎麼走完它。台詞要短到能在你手上的秒數裡講完。
這一段控制什麼: 對白長度、嘴巴的行為,以及這段演出讀起來是說話,還是單純的動作。
草莓看向鏡頭略偏左,說一句簡短的台詞:「你帶了我的一塊來野餐。」嘴型動作:一開始閉著,講到「帶了」時張開一次,逗號處閉上,講到「野餐」時再張開,最後收成一個小小的閉嘴微笑。結尾加一片抬起的葉子當標點。不要把字幕壓進畫面。臉、眼睛與表皮質感都和參考圖完全一致。十個字、兩次嘴型動作、結尾一個表情變化。這就是一個你可以好好檢查的鏡頭。同樣八秒裡塞一整段對白,就是一個你註定要重做的鏡頭。
步驟 7:用同一張定稿圖做第二集
第二支影片就是系列成形、或默默重來的分水嶺。重複使用同一張參考圖,用延續上一支結尾的一格開場,而且只改一個變數:一個新道具、一個新角色、一個新房間。一次改兩件事,觀眾就會覺得這是另一齣戲。
這一段控制什麼: 角色與世界的連貫,以及你要求觀眾接受多少新東西。
用同一個草莓角色再拍第二支 8 秒影片。開場是空湯匙擱在同樣的木質檯面上,草莓的位置與上一支影片最後一格相同。一顆小小的藍莓角色從右邊慢慢滾進畫面,停在它旁邊。草莓只轉動眼睛、不轉身體,低頭看它,然後面無表情地看回鏡頭。鏡頭與光線不變。草莓的臉、籽的排列與葉冠和參考圖完全相同。藍莓是圓的,深藍色、表面帶一層霧白果霜,兩隻小眼睛,沒有嘴。步驟 8:文案和揭露聲明一次寫完
文案是這個格式的一部分,不是事後補的:笑點在這裡收尾,觀眾也在這裡知道自己在看什麼。這件事可以交給文字助理或在 Studio 裡做,揭露聲明用一句白話講完就好,不要寫成一整段術語。
這一段控制什麼: 跟著影片一起發布的文字、你希望收到的回覆,以及合成媒體標示有沒有在別人開口問之前就放上去。
為一支直式影片寫三個文案選項,內容是草莓角色咬了一口草莓、露出驚訝的表情。每個選項在 90 個字以內,前兩個不要放主題標籤,第三個必須以一個邀請回覆的問句結尾。接著再用白話寫一行、100 個字以內,說明這支影片是 AI 生成,不要術語,也不要道歉。步驟 9:拿定稿圖對照,不要靠記憶
把新影片和角色定稿圖並排放,照這個順序檢查四件事:臉、表皮、光線、結尾。再檢查你打算拿來當封面的那一格——那通常是整支影片裡最不好看的一格。如果臉跑掉了,就用同一張參考圖重新生成,而不是一直改提示詞改到看起來差不多。
常見失敗,以及真的有效的解法
| 症狀 | 通常是什麼造成的 | 解法 |
|---|---|---|
| 臉在不同影片之間變形 | 用文字重新生成,沒有附上定稿圖 | 附上同一張定稿圖,並重複貼上身分區塊 |
| 水果看起來像貼在照片上的貼紙 | 用了「可愛卡通」或「kawaii」這類字眼,或把臉描述成疊上去的圖層 | 要求臉嵌進表皮、寫實質感、不要描邊、不要貼紙邊緣 |
| 八秒裡什麼都沒發生 | 一份需求塞三個動作,每個都只做一半 | 刪到一個動作、三個節拍,重新生成 |
| 影片沒有結尾 | 需求從頭到尾沒寫最後一格 | 寫出最後的畫面,並停留一秒 |
| 手變形融化,或湯匙彎掉 | 快速動作加上手,再加上會反光的道具 | 拿掉手、讓道具靜止不動,或把動作縮短 |
| 聲音和嘴型對不上 | 台詞根本沒寫,模型只能自己編動作 | 先寫台詞,再描述嘴型的開始、中間和結尾 |
| 每支影片都像同一支爆紅影片 | 你是從模板開始,而不是從角色開始 | 改一個結構性變數:物種、尺度,或它所在的世界 |
| 聲音像事後硬貼上去的 | 影片是靜音生成的,音樂是後來才加的 | 把聲音和動作一起規劃:咬、嚼、吞,然後在台詞前留白 |
| 貼文被平臺限制或標記 | 合成媒體揭露聲明漏了,或被埋在後面 | 把揭露聲明放在文案前幾行,並遵守平臺目前的規定 |
其中兩個比其他幾個更值錢。貼紙感是措辭問題,一行提示詞就能解決。沒有結尾是規劃問題,在你打開工具之前就該解決。
Ottermind 在流程裡的位置
步驟二到步驟七可以在 Ottermind 上跑,因為這套流程會把參考圖和寫下來的指示放在一起,而不是每改一次就要你從空白提示詞重來。
- 做出定稿圖:AI 圖像生成 會產出你之後要重複使用的角色圖。生成兩三個候選,挑一個,留著。
- 讓定稿圖動起來:Image to Video 吃一張參考圖,加上動作、鏡頭行為、節奏與目標影格的描述,然後讓你看過每一個 take 再重新渲染。這是做系列該走的路,因為定稿圖才是那個固定不變的東西。
- 也可以從照片開始: 如果你自己拍過真實的水果,Photo to Video 會從那張照片開始,而不是從生成的角色開始。同樣的動作需求,不同的來源。
- 把整集組起來:AI Reel Maker 是多場景社群影片序列的下一棒;三支影片的故事一旦接得起來,就會變成那樣的東西。
這條路線不保證任何事。參考圖能改善連貫性,但鎖不住它——要有重新生成某些 take 的心理準備。影片長度、解析度,以及任何點數費用,都取決於你的帳號和你生成當下在 Studio 選的模型,不是這篇文章能決定的。權利要你自己確認:用你自己拍的照片,或你有授權使用的照片;不要繞著別人的節目打造角色;發布的地方要求標示時就標示合成媒體。以上都不構成法律意見,也都不保證流量。
接下來可以做什麼
從格式表裡挑一列,對應你這週真的做得完的影片,然後做一個最小、最誠實的版本。
- 你想做系列: 先做定稿圖,再堅持一支影片一個動作。讀 Image to Video 提示詞教學,學會讓需求變具體的動作詞彙。
- 你想要短影音的製作紀律:不露臉短影音指南 從另一端處理同一個問題:怎麼在沒有主持人的情況下,做出可以重複的短影音。
- 你要兩支影片之間的轉場:變形(morphing) 是把一個東西變成另一個東西的格式,而分集之間常常就需要這個。
- 你要一種在小螢幕上還撐得住的角色風格: 當臉必須在縮圖尺寸下還看得懂,Q 版風格(chibi) 就是寫實風格的有效對照組。
- 你要逐格控制:補間(tweening) 說明兩張圖之間發生了什麼,而那正好就是水果角色開始不像自己的那一刻。
一支 AI Fruits 影片,就是一份有臉的草稿。臉是你擁有的部分,也是值得保護的部分。
AI Fruits 常見問題
我需要專門做水果的生成器嗎?
不需要。專門的 AI Fruits 生成器很方便,因為它直接附上已經行得通的格式模板,這確實是使用它的正當理由。但如果你想要自己的角色、想讓每支影片長得一致,或想做一個不會被看出是模板變體的系列,通用型的圖像與影片流程會是更好的選擇。
該用文生影還是圖生影?
一次性的影片、角色每次不一樣也沒關係,就用文生影。一旦臉、質感或配件必須跨影片延續,就改用圖生影。參考圖會縮小結果的範圍,但不會把結果固定住。
一支 AI Fruits 影片應該多長?
短到一個動作就能填滿它。這個格式通常被描述為十到三十秒,而真正的限制不是平臺上限,是觀眾在影片該結束之前跟得上幾個節拍。
我需要說明影片是 AI 生成的嗎?
規定依平臺、市場和題材而不同,所以要查你要發布的地方目前的政策,而不是相信一份摘要。實務上,在文案裡用白話寫一句不用付出什麼成本,卻能消掉一個觀眾不信任這則貼文的明顯理由。
這些影片可以販售或營利嗎?
這取決於工具的使用條款、你使用的素材,以及你發布的平臺。在把角色做成生意之前,先讀模型和平臺的商業條款,也不要以為生成一張圖,就等於取得別人擁有的知名角色的權利。
