
三条可以直接复制的水果短剧提示词
每条提示词都先固定一个水果角色、它所在的世界,再只给一个动作,这样首帧就已经接近你想拍的那个镜头。
单人说话镜头
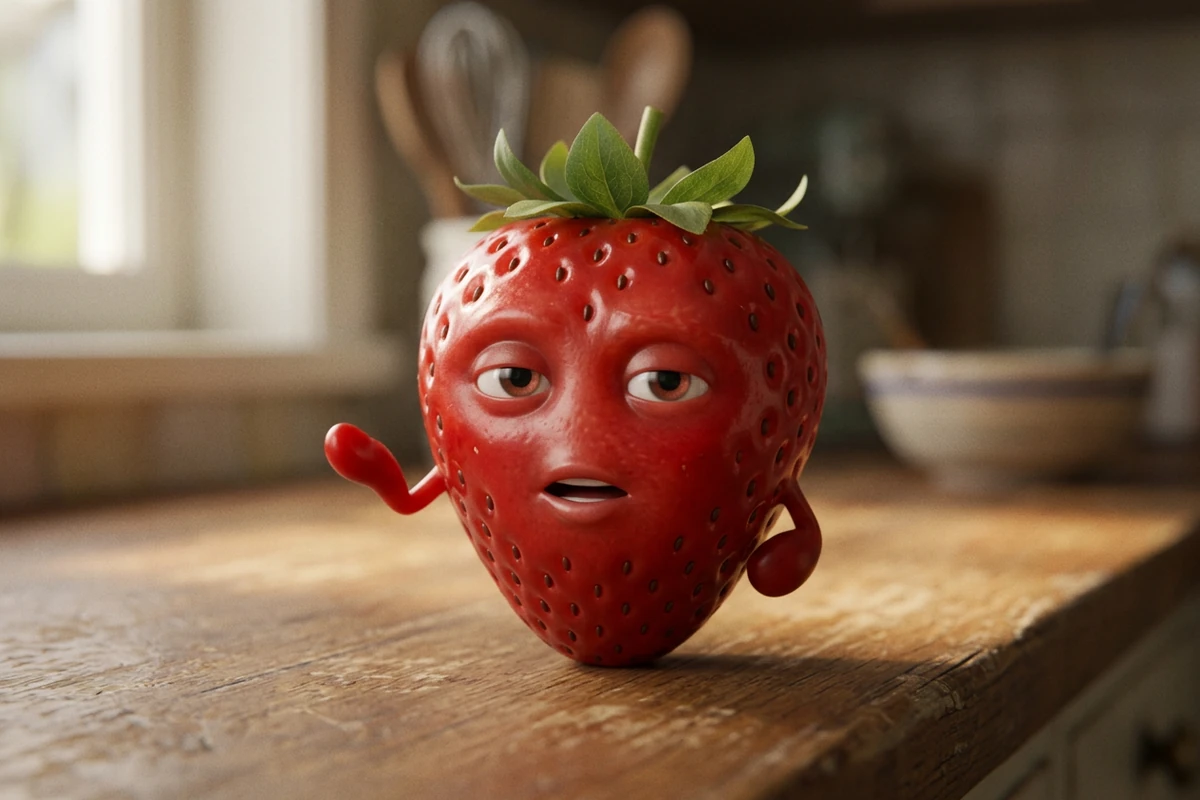
一个草莓角色,脸是它自己果皮的一部分,站在做旧的木厨房台面上,傍晚的光线里转身对着镜头说话,说到一半,一只小手臂抬起做了个克制的动作。绿色叶冠,果皮上的籽反着光,嘴是一道软缝,说话时把果皮压出褶皱。左侧温暖的窗光,背后虚化的厨房,一只陶瓷碗在焦外。四分之三近景,与视线齐平,浅景深,安静的 3D 动画质感,适合全年龄。每条片段里脸、叶冠和籽的位置保持一致,一个镜头只做这一个动作,画面里不要出现文字、字母、数字、标志、水印或签名。
两个水果的冲突镜头
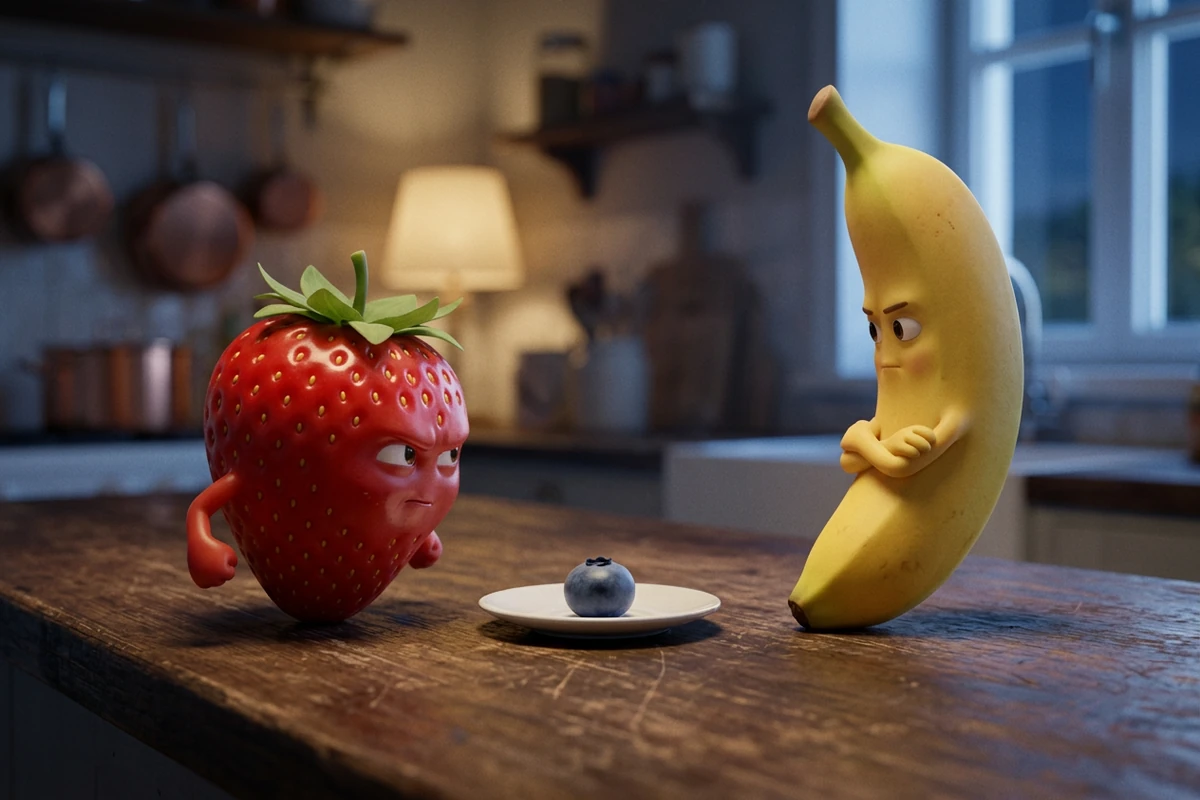
两个水果角色在傍晚的做旧木台面上对峙:左边一个光泽饱满的草莓身子前倾,正在争执;右边一个哑光的香蕉侧过身、抱着手臂,中间的小碟子上放着一颗蓝莓。两张脸都是果皮本身的一部分,反光和次表面散射与整块表皮完全一致。右侧是偏冷的傍晚光,左后方有一点暖色余光,背后是虚化的置物架。台面高度的双人镜头,浅景深,3D 动画质感,适合全年龄。锁死两个角色的设定和台面,让整条片段里它们不发生变化,画面里不要出现文字、字母、数字、标志、水印或签名。
老角色回归镜头
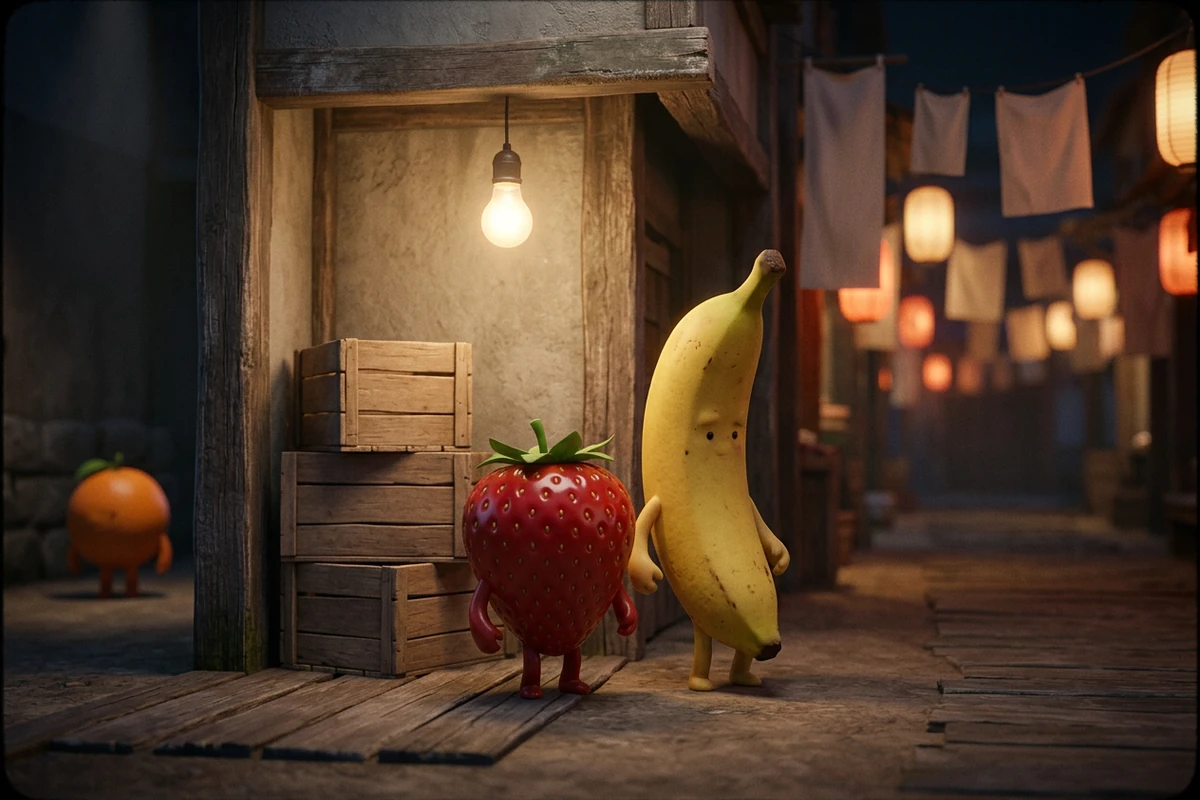
同样的草莓和香蕉回到一个新地方:夜晚市集小巷的木门口,头顶吊着一只灯泡,旁边堆着木箱,左后方还有一个橙色小角色在等。草莓站在前面正在解释,香蕉带着怀疑的表情在听。两个角色的设定、比例、眼睛风格和颜色要和前几条片段完全一致,门口和光线在整条片段里保持不变。中景,暖色灯泡和身后的深色阴影,3D 动画质感,适合全年龄,只做一个动作,画面里不要出现文字、字母、数字、标志、水印或签名。
大多数水果提示词为什么做不成
问题几乎从来不在提示词本身。脸像贴上去的、角色到第三集就变样、一条片段想讲完整段剧情,这才是浪费生成次数的原因。
脸必须长在水果上
水果角色和「照片上贴了张脸」的区别在质感。明确写出:嘴是一道把果皮压出褶皱的软缝,眼睛嵌在果皮里、和整块表皮有同样的高光和次表面散射,并且只有一束光照在脸和果皮上、把它们当成同一个物体。这一句通常就能避开贴纸感;结果还是平的时候,要改的是这句,而不是镜头或剧情。
两句固定,只换第三句
给水果写一句「角色句」,给表面、光线和时刻写一句「世界句」,然后把这两句原封不动粘进每一条提示词,只让「剧情句」变化。角色能活到第二集靠的就是这个:换了地方,草莓的叶冠、籽的排布和嘴还是原来那样,因为描述里没有任何一处动过。每次都重写角色,才会让一部剧看起来像一堆互不相干的片段。图片转视频 可以让已经确认的首帧接着往下做。
一条片只做一个动作,故事放在片段之间
四到六秒的一条片段只承载一个动作,而且要有看得见的结束:它探身、它别过脸、它注意到空碟子。把故事放进顺序里——起、冲突、反应——每个片段只给其中一个。一条提示词同时要求吵架、揭晓和反应,等于一次给模型三个难题,道具开始漂移、结尾消失就发生在这里。免费 AI 照片转视频 能把每条渲染好的片段并排放在一起看。
在 Ottermind 里做一集水果短剧
第 1 步:先写角色,再写世界
先给水果、脸和质感命名,再写它站在什么表面上、光线如何、是什么时刻。把这两句存在随手能粘贴的笔记里。图片转 AI 艺术生成器 负责渲染首帧,后面每一集要重复用的就是这两句。
第 2 步:确认首帧之后再去动它
盯着这张静帧看几秒。如果水果的脸像贴上去的,或者香蕉的渲染和草莓对不上,任何运镜都救不了这条片段。把确认过的首帧带进 图片转视频,动效只描述「会变化的部分」,不要重复画面里已经有的东西。
第 3 步:把一集拆成镜头,每次只改一行
把起、冲突、反应拆成各自独立的片段,每条只做一个动作。同一条镜头渲染两三个版本,对比之后再改其中一行——先改剧情,再改光线,最后改镜头——角色句和世界句保持不动。
水果短剧提示词真正有用的地方
当同一批角色需要在下一集回来,或者当一个荒诞镜头就足以撑起一条内容时,这些提示词才值得花时间。
有固定班底的连载
草莓和香蕉每周都回来。因为角色句和世界句从不改动,第二集只需要写一句新的剧情,而不是重做设计,观众在剧情开始前就能认出还是那两个角色。
给店铺或果汁吧的一条镜头
摊位、市集档口或果汁吧由一个水果角色和一个清楚的动作带出来。守住「只做一条镜头」,这条内容就仍然能当单条发布用,而不是一集。 图片转视频 可以把确认过的静帧变成这一条镜头。
属于你自己的梗,而不是复制
自己设定班底、名字和前提,不要去重做一个已经在更新的剧集的角色;同时让内容远离这个题材后来滑向的暴力或暗示方向。平台要求时标注这是 AI 生成内容,商用之前先看清所用工具的使用条款。
水果AI短剧常见问题
怎么让同一个水果角色出现在每一集里?
把描述冻结下来,并复用已经确认的首帧。写一句角色句——外形、脸、质感、颜色——再写一句世界句交代表面和光线,两句原封不动粘进每条提示词,只让剧情句变化。如果某条片段还是漂移,改角色句而不是改运镜,并且下一条片段从已经确认过的首帧开始,接进 图片转视频。
一定要用专门的水果短剧生成器吗?
不需要。无论是一条水果梗还是一整部连载,流程都一样:写场景、生成首帧、把首帧动起来。通用的图像加视频流程就够用,只要它能从参考帧开始、并且能对比多个版本。这套结构并不专属于水果,更通用的写法在 如何用 Ottermind 将图片生成视频:动作与运镜提示词。
该用文生视频还是图生视频?
用一个问题决定:这个角色需要回来吗?单独的镜头可以直接用文字提示词生成,更快也更自由。有固定班底的连载需要先确认一张首帧,因为承担脸和质感、要被动画保留下来的正是这张首帧。实际做的时候两者都会用到:先用文字找到镜头,再用 图片转视频 处理必须保持一致的镜头。
每条水果片段应该多长?
目标是四到六秒,一个动作,一个看得见的结束。更长的镜头要求模型同时解决好几件事,脸、道具和结尾开始漂移就出现在这里。如果某个镜头确实需要更长时间,把它拆成两条片段,并在两条里保持角色句完全一致。
为什么我的水果看起来像照片上贴了张脸?
因为脸被写成了「外加上去的东西」,而不是表面的一部分。要求嘴是一道把果皮压出褶皱的软缝、眼睛嵌在果皮里、并且只有一束光把脸和果皮照成同一个物体。这样写,质感通常会穿过表情,结果也就不再像贴纸。
镜头一动,背景为什么会变?
因为地点从来没有被固定,取景一变模型就重建一次。把表面、物体和光线写成一句固定的话,再让镜头在这句话里移动。如果你已经有一张背景满意的首帧,免费 AI 照片转视频 会从那张背景出发,而不是重新编一个。
水果应该说话,还是只做动作?
生成之前先定下来。要说话的镜头需要稳定、偏近的取景,一句短台词,以及一张读得清楚的嘴;动作镜头可以用更宽的景别,也完全不需要动嘴。长台词配上移动镜头是最容易崩的组合,所以这一页的提示词把说话的镜头压到一句台词,把动作镜头留成无声。
不抄那些爆火的剧集,也能做水果连载吗?
可以,而且更安全。自己设计班底、名字和前提,不要复用别的剧集的角色、场景或台词,让笑点远离暴力和暗示的方向,平台要求时标注为 AI 生成内容。有自己逻辑的固定班底,才会让一部剧看起来像一部剧而不是一堆片段;照搬别人的剧集,继承来的主要是下架风险。
把同一条提示词换到别的视频模型
把一个镜头接成下一集
把刚写好的角色句和世界句拿过来,两句都保持不动,继续生成下一个镜头,直到这一集是你真的会发出去的样子。