技术指南
如何使用 GPT-6:五类实用任务与提示词模板
开始使用 GPT-6 Astra,最有效的方法是给它一个明确的交付目标、完成目标所需的材料,以及清楚的成功标准。选择自己足够了解、能够审核的任务,例如研究简报、报告修订、表格检查、网站 QA,或困难故障调查。
当工作涉及多个相关来源或步骤时,Astra 值得一试。先从规模适中的任务开始,再推进大型项目。GPT-6 评测介绍了访问方式与总体优势;本文重点说明获得访问权限后,应该如何布置任务。
来源: OpenAI 访问指南; Claire Vo 的提前体验案例。核验日期:2026 年 9 月 7 日。下文中的测试结果和体验均注明作者。
从交付物开始
“研究一下我们的竞争对手”这类宽泛请求,会留下许多关键决策。有效的简报应说明待做决策、受众、来源范围、输出形式和审核标准。这样既给模型留出调查空间,也让最终结果符合预期。
为[受众]制作一份两页的决策简报。
需要决定的是[具体问题]。
使用[附件和允许使用的公开来源]。
按照[标准]比较[选项]。
为事实性主张附上来源,并标注缺失信息。
最后给出建议、取舍和下一步行动。
选择具有所需工具的使用入口。除非运行环境授予访问能力,否则聊天中的模型无法检查本地应用。OpenAI 的可用性指南区分 Chat、Work 和 Codex;你能看到的控制选项取决于套餐与产品。
五类适合入门的任务
| 任务 | 需要提供的材料 | 重点检查 |
|---|---|---|
| 研究简报 | 待做决策、来源清单、日期范围 | 主张是否与引用证据一致 |
| 报告修订 | 草稿、参考文件、受众 | 修改是否保留了原有事实 |
| 表格检查 | 工作簿及预期定义 | 公式、单位和汇总是否一致 |
| 网站 QA | 本地预览和关键用户流程 | 报告的问题能否复现 |
| 故障调查 | 复现步骤、日志、相关代码 | 提出的原因能否解释现象 |
将来源整理成研究简报
让 Astra 先比较证据,再起草叙述。事实清单只有能帮助作出决策时才有价值。先让它识别分歧、缺失日期和未经证实的假设。
阅读这些来源,建立主张与来源的对应表。
找出可能改变决策的分歧。
然后撰写比较两个选项的简报。
除非解释清楚,否则不要用不确定的主张支撑建议。
亲自打开几条引用,尤其是支撑建议的引用。写得流畅的回答仍可能误读来源,并按可重复的流程核查 AI 内容。
修订报告,同时保留原意
提供现有草稿,并指定具体读者。把事实修正与表达调整分开,方便分别接受。如果来源不支持某句话,让模型提出批注,而不是编造替代内容。
展示表格前先检查
说明哪些工作表和输出最重要。要求列出公式不一致、重复记录、缺失值及不兼容单位,再抽样核对原始记录。清理后的工作簿应保留原始数据,并解释调整内容。
利用浏览器访问开展 QA
Claire Vo 的提前体验节目将浏览器 QA 列为实际用途。一个可复用的方法是:给 Astra 三条关键用户流程,要求输出可复现的问题。每项发现应包含初始状态、操作、预期行为、实际行为和证据。最重要的失败应手动复查。
调查棘手故障
修改代码前,先让模型复现问题。有用的调查结果应包括失败路径、支持根因的证据,以及建议的最小改动。GPT-6 编程评测解释了为什么测试覆盖与实际功能行为需要分别检查。
选择合适的任务环境
写详细简报之前,先检查当前会话实际能访问什么。它能读取工作簿、打开预览、搜索网页并创建所需文件吗?让它尽早指出缺失输入。来源无法访问,或任务需要可编辑数据而工具只能返回截图时,再强的模型也无法弥补。
浏览器任务应提供起始页面和要使用的账户或工作区。文件任务应说明哪些文件是权威依据,以及新版本是否替代旧版本。研究任务应说明时间范围和市场。这些小细节能避免模型精心回答了错误的问题。
OpenAI 在 GPT-6 使用指南中提到,模型可能提出更多澄清问题,也可能使用超出用户预期的格式。应告诉它哪些日常选择可以自行决定,以及最终输出的形式。当你需要的是完成的草稿,而非对可能方案的讨论时,这尤其有用。
自行合理安排结构和措辞。
改变受众、范围或基本假设前先询问。
如果缺少一个细节,继续完成不依赖该细节的部分。
最终简报使用短段落和一张比较表。
完整示例:制作供应商决策简报
假设你需要在两家软件供应商之间作选择。手头有方案、内部需求清单、会议笔记,以及预估用量的表格。这是一个可以按需改编的示例:只有多个来源相互一致,建议才有实际价值。
第一步:确定比较规则
要求模型选出赢家之前,先定义决策标准。例如,实施工作量可能比少量许可证价差更重要。告诉 GPT-6 哪些需求是硬性要求,哪些只是偏好。缺失的必需功能不能被平均分掩盖。
根据需求文件比较方案 A 和方案 B。
区分硬性要求与偏好。
使用用量表格计算成本场景。
不要从供应商的笼统宣传中推断某项功能存在。
推荐供应商之前,先列出尚无答案的问题。
第二步:检查证据表
要求每项需求单列一行,标注支持它的文档与章节,并区分“有依据”“存在反证”“未找到”。“未找到”也是有价值的结果:它能形成需要供应商回答的精确问题,防止模型用猜测填补证据空缺。
优先检查可能改变决策的条目。与模糊的集成要求、不包含的服务或计价假设相比,轻微的措辞差异通常不值得同等关注。
第三步:生成简报和后续问题
证据表通过审核后,再要求给出建议、备选方案,以及在哪些条件下建议会改变。供应商问题应放在单独章节,方便同事直接使用,而不必从长篇叙述中提取。
最终成果应让没读过来源文件的人也能理解为什么这样选,并能轻松追溯决定性主张的依据。
三组日常工作提示词
报告编辑
将这份报告修改为适合运营总监阅读的版本。
保留数字、日期和已声明的假设。
减少重复,让建议更容易找到。
返回修订稿,以及一份简短的待解决事实问题清单。
不要擅自用新主张替换缺乏依据的主张。
分享草稿前先检查问题清单。如果模型指出来源冲突,应同时修正来源材料和正文。否则,同样的不一致会在下一份报告中再次出现。
表格分析
在我准备管理层摘要之前检查这个工作簿。
找出不一致的公式、单位、缺失值和重复项。
每个问题注明工作表、单元格或行,以及可能影响。
保持原始数据不变,单独提出修正建议。
只总结能够追溯到已验证计算的结果。
要求解释关键数字背后的计算。区分空白与零、实际值与预测值。即使公式正确,如果输入使用不同周期或货币,也可能得出错误结论。
网站 QA
在预览中检查这些流程:[三条流程]。
使用提供的测试数据。
记录初始状态、操作、预期结果和实际结果。
优先处理阻断问题,再考虑外观问题。
返回可复现的发现,并说明哪些内容无法测试。
除了成功路径,也检查空状态、加载状态和错误状态。如果表单看起来已经提交,应核实生成的记录或确认信息。仅仅按钮文字变了,并不能证明操作成功。
如何改进不理想的初次结果
结果太泛,就补充它必须支持的决策;结果太长,就说明读者和长度;遗漏约束,就指出违反了哪项要求,并让模型检查相关章节是否存在同样问题。这些修正比一句“再努力一点”更有效。
要求修订时,应保留已经做好的部分。例如:“保留证据表,只修改建议,因为实施时间现在是我们的首要标准。”这样能减少整体重写时丢失有用来源对应关系的风险。
如果项目反复停下或偏离方向,可参考 GPT-6 长任务指南中的里程碑和恢复示例。更大的上下文窗口并不意味着不再需要明确的当前目标。
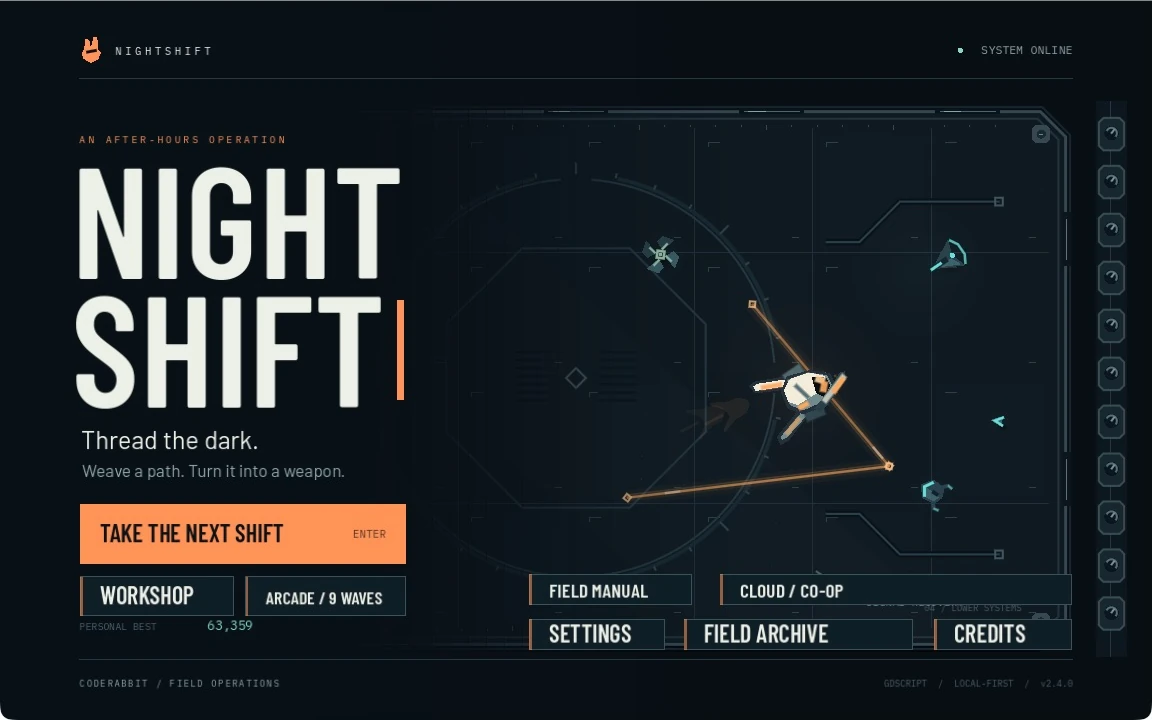
CodeRabbit 展示的 NIGHTSHIFT:在人类指导和反复迭代下,使用 GPT-6 制作的游戏。
控制首次运行的规模
设置时间或推理投入预算,并要求在任务无法完成时返回有用的阶段成果。研究任务可以交付已验证发现和待解决问题;编程任务可以交付复现步骤和修复方案;报告修订可以说明已检查及待检查章节。
不要只看最后一条消息来判断运行质量。打开交付物,检查困难部分,并统计需要修改多少内容。真正有用的比较,是结果达到可用状态之前还剩多少工作。
可复用的审核框架
- 检查所要求的交付物是否存在。
- 验证最重要的事实或行为。
- 找出模型在证据不足时作出的假设。
- 将审核时间与原有流程比较。
- 保留效果好的简报,用于下一次同类任务。
将来源文件、任务简报和审核笔记放入 Ottermind,组织连贯的研究或文档项目。从期望结果出发,选择适合任务的可用模型。
常见问题
第一次用 GPT-6 应该做什么?
选择有多个输入、结果可以检查的任务,例如基于来源的简报或限定范围的 QA。
提示词必须很长吗?
关键是简报清晰。包含目标、材料、约束、输出形式和验收标准;单纯增加长度没有帮助。
应该使用最高推理强度吗?
先使用当前界面提供的普通或中等设置。只有困难案例确实受益时,再提高强度。
可以复用同一份简报吗?
可以。保留任务结构,更新来源、日期和验收条件,并移除上一个项目遗留的假设。
如何知道任务真的完成了?
根据简报中的标准检查实际交付物。模型自信地宣布完成,并不足以作为依据。
