模型指南
GPT Image 2.5 Flare 与 Sunburst 怎么选?
如果要评估日常快速出图,可以先试 GPT Image 2.5 Flare;如果核心任务是精确修改已有素材,则可考虑 Sunburst。两者的官方定位不同,但最终选择取决于你的具体图片。用同一份任务说明比较合格结果、修改次数和总成本,比只看模型名称更可靠。
来源: 官方参考 1; 官方参考 2. 核对日期:2026 年 9 月 11 日。
本文把官方定位转成可执行的评估方法,没有进行受控对比实测。
先试哪个版本?
以下是起始假设,不是性能排名。
| 任务 | 建议起点 | 重点检查 |
|---|---|---|
| 探索多种视觉概念 | Flare | 是否有足够多可用且不同的方向 |
| 内部讨论用插图 | Flare | 含义清晰,等待时间可以接受 |
| 修改已确认的营销图 | Sunburst | 受保护的细节是否保留 |
| 需要放大审阅的商品图 | Sunburst | 标签、轮廓、材质与意外变化 |
这些是根据官方定位提出的编辑建议。Flare 可能满足严格要求,Sunburst 也可能生成不合格结果。
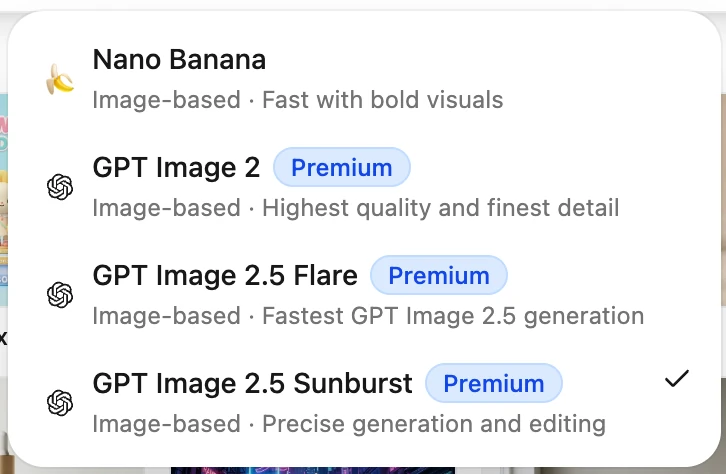
提供的 Ottermind 界面截图显示,模型菜单已列出 Flare 与 Sunburst,均标为 Premium,当前选中 Sunburst。
模型与质量档位要分开比较
两者官方页面都列出了 low、medium、high、xhigh、max 和 auto。模型名称与质量档位是不同设置;平台允许时,应使用相同设置对照。
如果同时换模型、尺寸、参考图和提示词,就很难知道结果差异来自哪里。先固定条件,再单独调整一个参数,判断提升是否值得。
记录平台显示的准确模型标识。“最佳质量”之类的界面名称不足以复现实验。
单价相同,不代表每张图片总成本相同
截至 2026 年 9 月 11 日,官方页面列出的两者价格相同:每百万文本输入 token 为 5 美元,图片输入为 8 美元,图片输出为 30 美元;缓存输入另有较低费率。这是 API token 价格,不是第三方平台订阅或积分价格。
预算还应包含失败重试:
每张合格图片成本 = 所有生成与编辑费用 ÷ 通过检查的图片数量。
人工审阅时间另行记录。请求便宜不代表成品便宜;如果较简单的设置已经合格,也没有必要仅因为“高级”而提高配置。
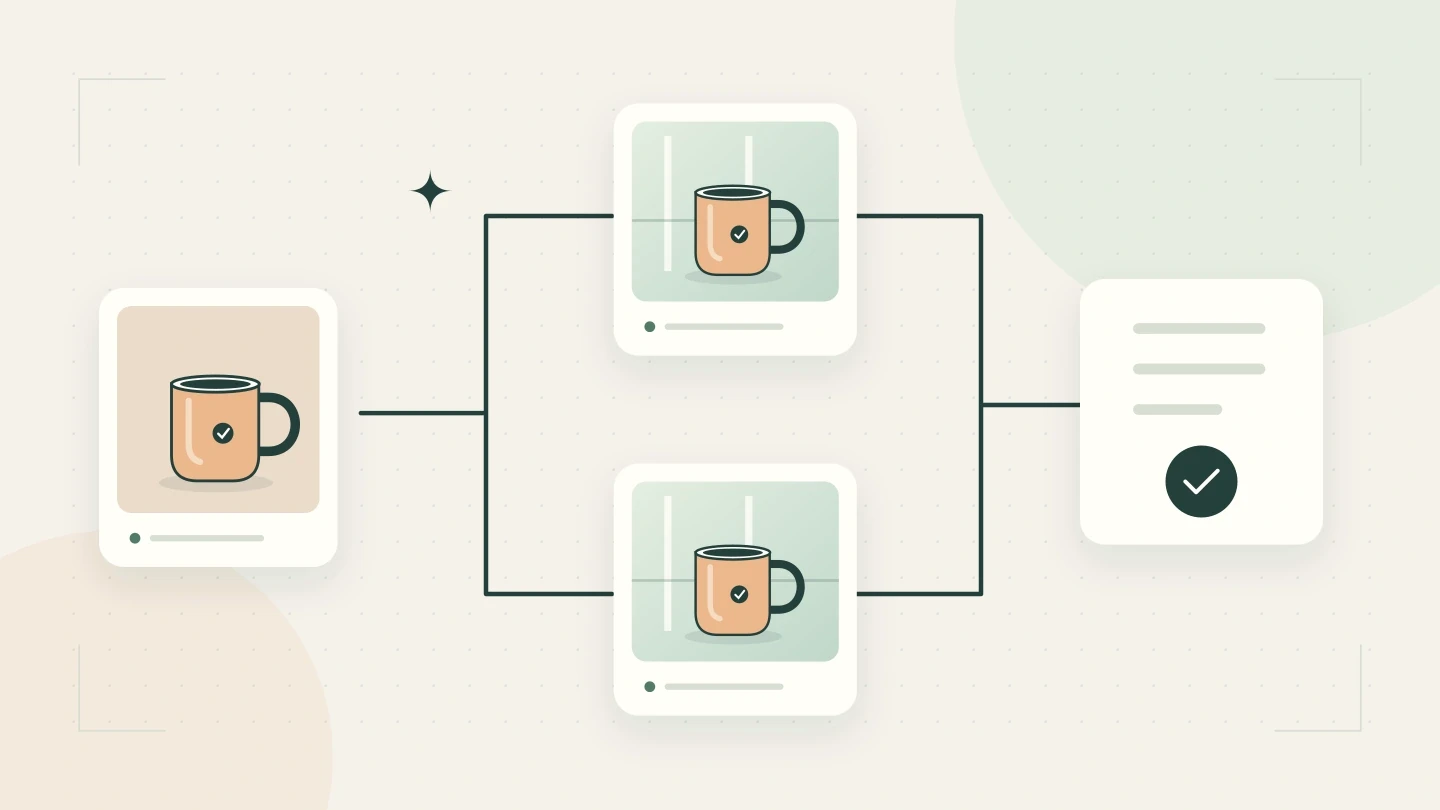
原创流程示意图,不是模型输出或性能实测。
一份可复用的对比记录表
选三个真实任务:新建插图、局部修改,以及对该修改再修订一次。两种模型使用相同输入,保留全部输出,包括失败结果。
| 每次记录什么 | 为什么记录 |
|---|---|
| 提示词、原始素材、模型 | 复现条件 |
| 质量档位、输出尺寸 | 区分模型与设置影响 |
| 耗时、实际账单 | 了解运行成本 |
| 是否完成指定变化 | 检查任务本身 |
| 是否保留关键细节 | 发现隐性返工 |
| 通过、拒绝还是人工修补 | 避免把好看的失败当成功 |
先定标准再看图片。商品图可要求标签正确、瓶盖不变、接触阴影合理;博客插图则可能更在意概念明确和标题留白。
不要仅凭一次偶然成功确定默认模型。做多次尝试,保持审阅标准一致,并记录每次拒绝的原因。
设定默认方案和切换条件
优先采用能稳定满足任务的配置,只有某项明确要求失败时才切换。“标签连续两次被改动,换模型再试”是具体规则;只因为名字听起来更高级就切换,不是。
把规则、合格样例和提示词放在一起。模型或工作类型变化后,再重新评估。
继续完成图片任务
ChatGPT Images 2.5 更新了什么?从一个实际任务开始 · 10 个 ChatGPT 图片提示词:商品图、营销配图与日常工作.
在 Ottermind 图片工作区使用你的创作说明. 请查看界面当前提供的模型。提供的 Ottermind 界面截图显示,模型菜单已列出 Flare 与 Sunburst,均标为 Premium,当前选中 Sunburst。