提示词指南
ChatGPT 漫画肖像:会夸张什么、会在哪里崩,以及六段站得住的提示词
ChatGPT 收到一句话就能把照片画成漫画。你没法在那句话里指定「夸张到什么程度」,所以把夸张写成数字,发出去之前先检查像不像。
可选
JPG / PNG / WebP
这是 Ottermind 的输入框。填入描述和发送是两个动作,不继续进入 Studio 就不会生成任何图片。
2026年11月14日 · 11 分钟阅读
能。ChatGPT 可以把一张照片画成漫画肖像,而且只要一条消息。 OpenAI 的帮助中心写明,图像生成与编辑在所有套餐里都属于 ChatGPT 的功能,你可以上传一张已有的图片并描述想改的地方,生成可能需要几分钟(ChatGPT 里的图像功能,2026年11月14日核对)。这件事没有隐藏门槛,也不是搜索结果暗示的那种付费专属功能。
麻烦的地方在控制。一张漫画肖像其实是两个决定:让人一眼认得出,同时把「像他」的地方夸张出来。提示词界面给这两件事的,只有一个文本框。你只说「来一张漫画肖像」,档位就由模型替你选,通常是那种客气的卡通,谁也不得罪,偶尔是一张头大到已经不像本人的画。2026年2月那波职场漫画肖像里拿到好结果的人,并没有用什么秘密提示词,他们只是检查了那张脸。
本文的资料说明: 官方页面均于 2026年11月14日核对:OpenAI 的ChatGPT 里的图像功能与用量上限两篇文章,以及 Wikipedia 的漫画肖像(Caricature)条目(版本 1385434321)。文中的图都是我们自己渲染的:一张虚构人物的照片,为本文生成,不是真人,2026年11月14日用 OpenAI 的 gpt-image-2.5-flare 模型通过 API 按下面引用的提示词,画了四个夸张档位和五个失败变体。我们用的是 API 而不是 ChatGPT 应用,这样每一张都对着同一张参考照片;提示词是按 ChatGPT 写的,附上照片后用法一样。这次测试里有一段提示词被安全系统拒绝,我们在发生的地方照实写了。图上的说明文字、标注和裁切属于编辑处理。那张输入框的图是本页的真实截图。下面没有任何一句是在断言模型内部如何运作,也没有任何生成图被当作付费客户的作品来展示。
漫画肖像是什么,滤镜不是什么
漫画肖像是一种肖像:既让人认得出是谁,又把那些让他与众不同的特征夸张出来。Wikipedia 的定义说,它是一张以「简化或夸张的方式」呈现对象特征的图像,并指出这个词来自意大利语 caricare,意思是「装载」,所以一张漫画肖像是一张「装得过满的肖像」(漫画肖像,2026年11月14日核对)。同一条目还提到,漫画肖像可以恭维人,也可以伤人。这后半句,多数提示词教程都跳过了。
这个定义给了你一个标准,用来检验每一张回来的图。风格滤镜(卡通、动漫、水彩)改的是画法,比例原封不动。漫画肖像改的是比例,画法是你另外单独决定的事。这两件事天天被混在一起,包括那些打着「漫画肖像生成器」旗号、实际只给一个卡通滤镜加一根滑杆的工具。
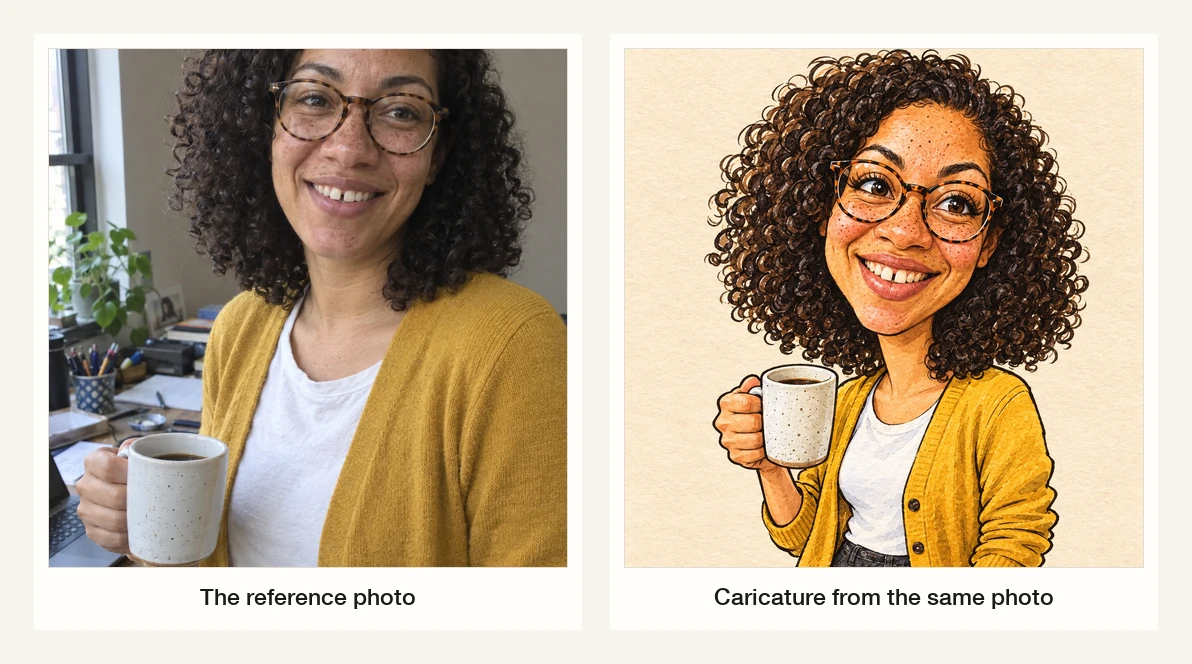
左:参考照片,一张为真实客户照片做的生成替身。右:同一张脸在经典档位的样子。没有任何东西被改成卡通;头、眼睛和笑容被放大,其余都保留了下来,包括眼镜、雀斑、牙缝和那件开衫。为本文用 gpt-image-2.5-flare 渲染,2026年11月14日。标注由我们添加。
ChatGPT 拿到照片之后到底做了什么
OpenAI 文档里有三个细节,决定了这段需求该怎么写。
它改的是你给它的东西。 生成第一张图之后,你可以选中画面的一部分再描述要改什么,也可以不选,直接在对话里描述这处改动。OpenAI 另外提醒,选区的高亮不一定精准,编辑可能超出你选中的范围,所以一句「把笑容拉宽」也可能把眼镜挪了位置。每次改完,把整张脸重看一遍,不要只看你瞄准的那一块。
画面比例由你决定。 现在的应用里有比例选择器,所以一个方形头像和一张 16:9 的卡片来自同一次生成,而不是事后再裁。
你的限额是账号级的,不是模型级的。 OpenAI 没有公布一个适用于所有人的数字;套餐额度显示在账号里,而且从 2026年12月起,公司表示 Plus、Pro 和 Business 的额度将改为与 Codex 共用的 token 计量(用量上限,2026年11月14日核对)。一批按八到十次试画来计划,不要按五十次;开始之前先看一眼用量指示。
界面没有给你的,是一根控制夸张程度的旋钮。这只能靠句子写出来,而句子里有数字,比有形容词管用。
夸张阶梯:挑一个倍数,不要挑形容词
「再搞笑一点」不是一个模型能校准的指令。「头部是真实比例的 1.5 倍,眼睛放大,笑容加宽,脖子收细」就是。我们把同一张照片按四个档位各渲染了一次,看每一档到底换来了什么。
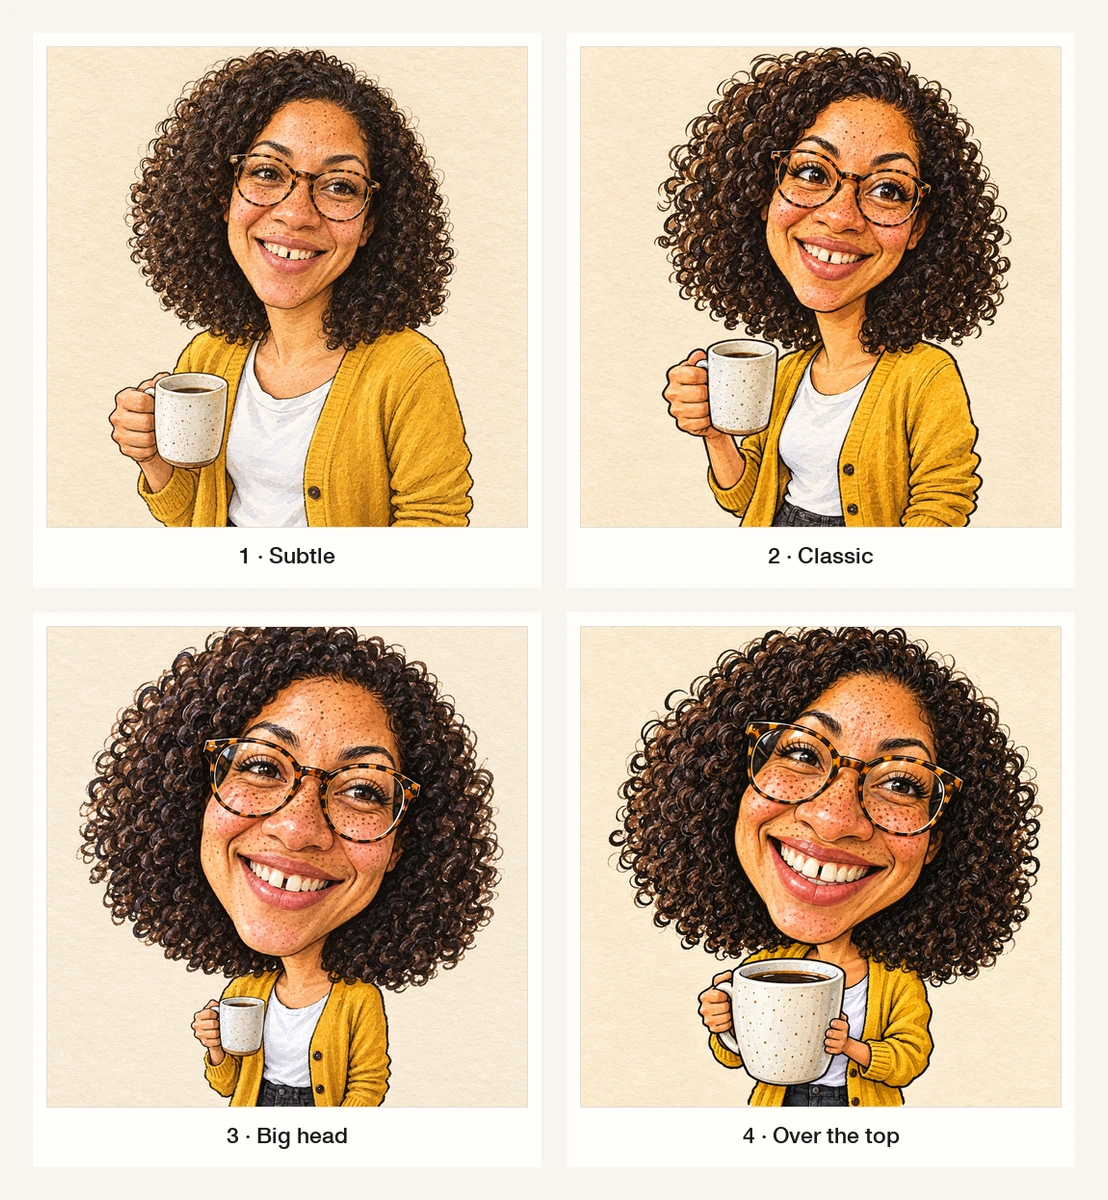
同一张参考照片出来的四张,每次只改一个数字。对象是生成的替身,不是真人。为本文用 gpt-image-2.5-flare 渲染,2026年11月14日;档位的名字是我们起的。
| 档位 | 改了什么 | 适合用在哪 | 会在哪失败 |
|---|---|---|---|
| 1 · 轻微 | 头部约 1.2×,其余几乎按原比例 | 头像、职场帖子、送给谨慎的人 | 读起来像一张插画肖像;没人会叫它漫画肖像 |
| 2 · 经典 | 头部约 1.5×,眼睛和笑容放大,脖子和肩膀收小 | 卡片、请帖、社交帖子的默认选择 | 依然客气;不是大家期待的那种刷屏式「大头」 |
| 3 · 大头 | 头部约 2.5×,配一个紧凑的身体 | 那股潮流的样子;派对邀请、团队页面 | 道具开始缩小或消失;手的选择变少 |
| 4 · 过火 | 头部约 3×,手很小,笑到最大 | 缩略图、海报、朋友之间的玩笑 | 体面和相似度一起掉;用在工作上通常是错的选择 |
这张阶梯上有两点值得记住。第一,你要的倍数是一个方向,不是一次测量:第 3 档和第 4 档回来的差距比数字看上去要小。第二,也更有用的一点,相似度在四个档位上都活了下来,因为参考照片够好,而提示词把字都花在了描述那张脸上。当我们拿掉照片、只说「画一张我的漫画肖像」时,模型整个编了另一个人。干活的是照片,不是形容词。
六段提示词,每段只改一个变量
每个框只改一件事。其余保持不变,否则你不会知道是哪条指令起了作用。
1. 经典游乐场档位
对照组。它点名了媒介、档位、比例,以及最关键的:哪些特征不许动。
只以我上传的这张照片为唯一参考。把照片里的人画成游乐场风格的漫画肖像,画在有纹理的米白纸上:温暖的黑色墨水线稿,平涂的水彩,看得见纸的纹理。经典档位:头部约为真实比例的 1.5 倍,眼睛放大,笑容加宽,脖子更细,肩膀更窄。头发的形状和质感、眼镜框、眉毛、鼻子、牙齿和衣服都严格照照片保留。腰部以上,四分之三侧面,纯纸张背景。不要文字,不要边框,不要签名。这一段改的是:画法和夸张档位两件事。如果结果太平,先把头的倍数提到 2.5,别的都别动。
2. 适合职场的版本
用在 LinkedIn 头像,或者同事的离职贺卡上,玩笑得撑得住被他上级看见。这段需求把比例留在几乎老实的位置,把效果交给画法。
用我上传的这张照片。画一张插画肖像,只做最轻微的漫画化夸张:保留真实比例,只把眼睛放大约 10%,笑容稍微加宽,让它看起来是一张手绘肖像,而不是一个玩笑。松弛的墨线,双色水彩,暖色纸张。头肩构图,正方形裁切,平静的中性背景,不要文字。这一段改的是:脸被推得有多远。其他,媒介、裁切、背景,都和第 1 段一样。
3. 礼物版本,加上名字
一块牌子会把一张画变成一件实物。短文字现在可靠到可以试,但每一个字都得事后读一遍。
用我上传的这张照片。画一张生日礼物用的大头漫画肖像:头部约为真实比例的 2.5 倍,配一个紧凑的身体,两只手捧着一只大马克杯,站姿,脚要露出来,墨水加水彩,暖色纸张。在人物下方加一条手绘缎带横幅,用大写字母写上名字“DANA”,再用很小的手写字写上“THANK YOU 2026”。两处都严格按原样拼写,不要再加任何其他文字。这一段改的是:构图和文字。它也是最可能需要第二遍的一段,所以在原尺寸下检查拼写。
4. 两个人画在一张里
多人图坏的方式很具体:第二张脸会变成一张通用的脸。把两个人的锚点都点名,并要求两张脸用同一个档位。
用我上传的这张两人合照。把两个人画进同一张漫画肖像,并排站着。两张脸用同一个经典档位夸张,各自用他自己最有辨识度的特征,也就是让人一眼认出他的那个地方,不要虚构任何东西:每个人的发型、眼镜、胡须和衣服都对照照片。两个人保持一样的比例,真实的身高差要保留。墨水加水彩,暖色纸张,纯色背景,不要文字。这一段改的是:模型怎么处理一个以上的对象。如果有一张脸漂了,就拆开做:各自画一张,之后再合。
5. 全身,在办公室
2 月那波里,多数人是请人画自己在工位上的样子。全身画面给了模型更多可以编的空间,所以把场景钉死。
用我上传的这张照片。画一张全身漫画肖像:这个人站在一张堆着东西的办公桌旁边,经典的头部夸张比例,头约为真实比例的 2 倍,一只手搭在马克杯上,桌上放着一台笔记本电脑和一本笔记本。衣服、发型和眼镜照照片保留。暖色调的办公室,身后有一扇窗和一盆植物,松弛的墨线加水彩,不要任何文字,笔记本电脑和马克杯上不要 logo。这一段改的是:场景。道具和背景正是编造细节出现的地方,「不要 logo、不要文字」这句挡掉了大部分。
6. 修补这一遍
最常见的下一步不是重画,而是小修一处。把「什么保持不变」说出来。
这张画其他地方完全不变,只改一件事:让头相对身体缩小约 15%。眼睛、笑容、头发、眼镜和衣服都不要动,纸张纹理、线条粗细和颜色保持一致,背景不要重画。不要加任何文字。这一段改的是:一个比例。这段适合在 ChatGPT 的编辑器里用,那里你还可以选中头部,只对这一块提要求。
上面的按钮会把第 1 段提示词填进本页的输入框。填和发送是两件事:在你到 Studio 里继续之前,什么都不会生成。
四十秒的相似度检查
在把这张画发给任何人之前,先跑一遍。它花的时间比重新生成一张少。
1. 剪影。 眯起眼睛,或者退到两米外看。发型、头的轮廓、肩膀、眼镜:那个黑色形状读起来是这个人吗?剪影要是通用的,再多细节也救不回来。
2. 锚点计数。 把能认出这个人的特征列出来:发际线、眼镜、胡子、雀斑、牙缝、耳环、一道疤、某个特定的下颌。数一数有几个活到了画里。三个以上通常就够了;只剩一个,那是一个穿着对衣服的陌生人。
3. 最大的应该是那个对的特征。 看看这张画最用力推的是哪个部位。如果那正好是你描述这个人时第一个会说的特征,这张漫画肖像就成立。如果鼻子长大了,而人人都注意的眼睛还是普通大小,那模型夸张的是一个模板,不是一个人。
4. 交给本人。 唯一算数的检验是当事人自己的反应,而这一步同时也是征求同意的步骤。发出去之前先问;夸张了某人在意的特征的一张画,和一张恭维他的画,是两场不同的对话。
通常坏在哪里
我们自己做出来的和市面上流传的坏结果,几乎都能归到四种失败。其中三种在下面这条图里。
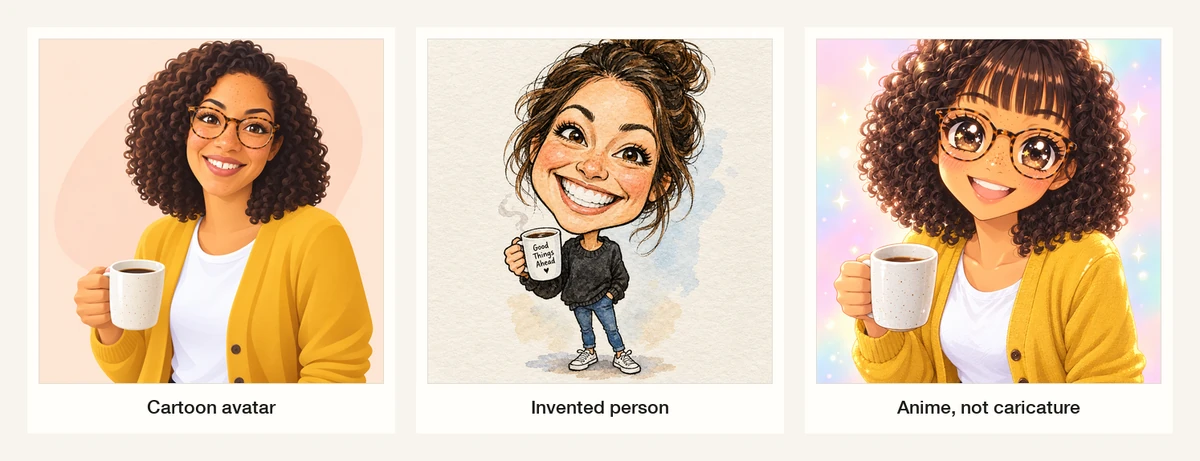
左:一张没有任何夸张的风格化头像。中:没有附照片时「画一张我的漫画肖像」回来的东西,一个陌生人,还外加一句没人要求的马克杯标语。右:风格泄漏,需求要的是漫画肖像,回来的却是动漫角色。为本文用 gpt-image-2.5-flare 渲染,2026年11月14日。
| 你看到的 | 为什么会这样 | 该改什么 |
|---|---|---|
| 一张顺滑的卡通头像 | 提示词描述了风格,从没描述比例 | 加上头部倍数,并点名两个要放大的特征 |
| 换了一个人 | 没附照片,或者附的是合影、其中主体很小 | 附一张清晰的单人照片,并描述那张脸 |
| 提示词盖过了照片 | 描述里写的是另一个人,发型不同、没有眼镜,模型于是照着文字走 | 让描述和照片一致;描述,不要替换 |
| 动漫、Q 版或 3D 渲染 | 风格词互相竞争,更强的那个赢了 | 只点名一种媒介,并加上「不要动漫,不要赛璐璐着色,不要 3D 渲染」 |
| 请求被直接拒绝 | 安全系统在生成之前就拦下了提示词;我们要求画一张刻薄、嘲讽的漫画肖像时撞上了这个 | 要求对一个特征做善意的夸张,而不是恶意的;并且尊重这次拒绝 |
拒绝这件事值得单独讲,因为这是一般人不会对画图工具预期的边界。当我们要求画一张嘲讽对方牙齿和鼻子的漫画肖像时,请求在输入阶段就返回了 moderation_blocked:没有图,没有扣费,只有一个错误。这是政策判断,不是 bug;它带来的实际后果是,这股潮流里「损朋友」的那一版,比恭维的那一版更难做出来。
文字、名字和日期
现代图像模型渲染短文字,比一年前好得多。我们的礼物测试在第一次尝试可读文字时就一遍做出了「DANA」牌子;而上面那个没有照片的失败,却给马克杯加上了一句没人要的「Good Things Ahead」。两件事指向同一个方向:文字是做得到的,不是保证的,而且不读一遍就永远不能信。
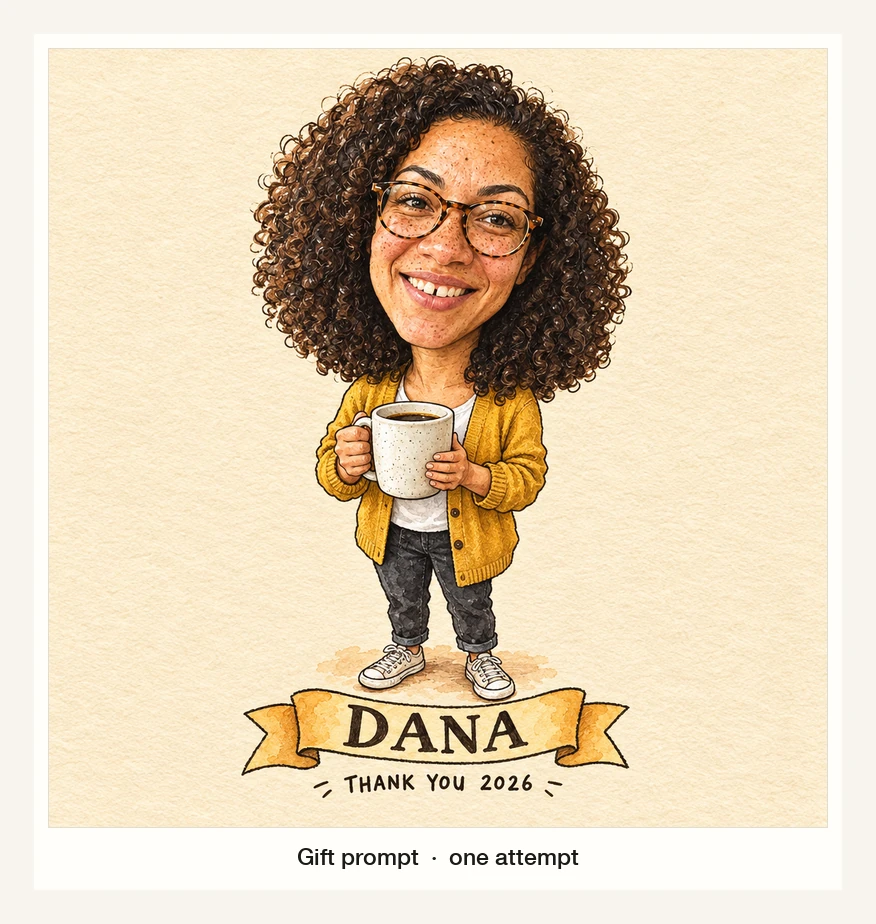
礼物版提示词,一次生成。缎带上的字没错,全身和马克杯都没有走形,一行都不用返工;而在没有照片时,同一个模型自己给杯子加了一行没人要求的标语。为本文用 gpt-image-2.5-flare 生成,2026 年 11 月 14 日。
管用的规则:文字只留一个名字,最多再加一行短句;把准确的拼写放进引号;写上「不要加其他任何文字」;然后放大到 100% 逐个字母检查。凡是要印出来的东西,卡片、马克杯、海报,都假设还要再来一遍,并把它算进预算。
同意、同事,以及一张画并不等于授权
这股潮流之所以讨喜,是因为画的是同事、老师和朋友。麻烦也从这里开始。
- 先问本人。 漫画肖像挑一个特征放大。你觉得是亲昵,对方可能读成在对他的鼻子、牙齿或体重发表意见。放到团队页面或公开账号上之前,先拿到一个「可以」。
- 注意职场细节。 同事在工位上的漫画肖像,可能带上屏幕、白板、客户名字或工牌。上面的提示词要求不要 logo、不要文字;背景仍然要自己看一遍。
- 一张画不等于一份授权。 用一张没经本人同意的照片,或者一个可识别的角色、品牌,是权利问题,生成一次并不能解决。你在 ChatGPT 里生成的东西怎么用,归 OpenAI 的条款管;Studio 这套流程归 Ottermind 的条款管。两者都不会转让肖像权,也不会替你清掉一张不属于你的照片。
- 把源文件和结果放在一起。 如果这张图要印出来或卖出去,把照片、提示词和日期存在一起,以便证明这张画是基于什么做的,也方便日后重新生成。
这些是审查层面的问题,不是法律意见。商业委托或公开发表之前,和照片的权利人确认使用范围。
在 Ottermind 里怎么做
本页顶部的输入框就是真实的请求界面:一个需求栏,一个可选的附件位放照片,一个发送动作,发送后进入 Studio。这里同样没有夸张滑杆,所以那个数字必须写进句子里。
本页的输入框。附件位放肖像,需求栏放六段提示词里的任意一段,绿色按钮只负责填入;发送是另一个动作,会进到 Studio 里继续。真实截图,2026年11月14日。
两个入口覆盖常见的起点,一个覆盖还没有照片的情况:
- AI Art Generator from Image 是照片先行的路线:上传肖像,描述画风和必须保持可辨识的细节,再比较几个方向。第 1 到第 5 段提示词都适合它,那些都以照片为参考。
- Unrestricted AI Image Generator 适合更长的需求,比如带道具、光线和衣着描述的全身办公场景。它自己的页面把这套做法说成是让详细的创作需求保持具体,而不是压平成一张通用图片。
- AI Image Generator 是还没有照片时的通用入口:先从一个文字需求开始,有了肖像再加进去。
这些都不保证某个固定的输出尺寸、固定的生成时间、固定的成本,也不保证相似度能扛过每一次编辑。它缩短的是「我知道我要哪个档位」和「我看得到我有没有拿到」之间的距离,而上面那套检查,才是让这个循环变成一张能用的画的关键。
相关阅读
- ChatGPT 图像提示词:如果你这是第一次指挥图像模型,这里讲视觉需求的通用结构。
- 在 ChatGPT 里编辑图片:第 6 段那遍修补背后的选区工具流程。
- Q 版风格:如果上面那个动漫风格的失败其实正是你想要的样子。风格和漫画肖像的区别,那篇指南讲的也是同一件事。
- GPT Image 2.5 Flare vs Sunburst:当你是在为一个批次选模型,而不是画一张。
- 海报创意:如果这张画要印成卡片或者挂上墙。
常见问题
ChatGPT 能用照片做漫画肖像吗?
能。附上一张照片,描述你要的画;OpenAI 的帮助中心写明了各档套餐都有的图像生成与编辑功能,包括上传已有图片并描述改动。出来的是一张漫画肖像还是一张卡通,取决于你的需求,而不是某个隐藏模式。
需要付费套餐吗?
OpenAI 说 ChatGPT Images 在所有套餐里都可用;不同的是你的套餐允许多少张、额度多久重置。去看你账号里的用量指示,别信某篇文章里的数字。
为什么我拿到的像卡通,而不是漫画肖像?
因为提示词描述了风格,从没描述比例。一张漫画肖像至少需要一个明确的夸张,头部倍数、加宽的笑容、放大的眼睛都行,外加上一份「必须保留」的特征清单。只有风格词,出来的就是一个滤镜。
没有照片能做吗?
能,但模型会自己编一个人。用来做演示或者吉祥物没问题,用来当礼物没用:那张画不会像任何一个具体的人。
用 ChatGPT 做一张漫画肖像,就是一段提示词加一道检查。生成之前先定档位,送卡片用 1.5×,开玩笑用 2.5×,把不许变的特征写进同一句话里,然后在发给他本人之前,先看一眼剪影。
