Guia do Comprador
Melhores Ferramentas de Observação de IA: Como Escolher Agentes e Fluxos de Trabalho de LLM
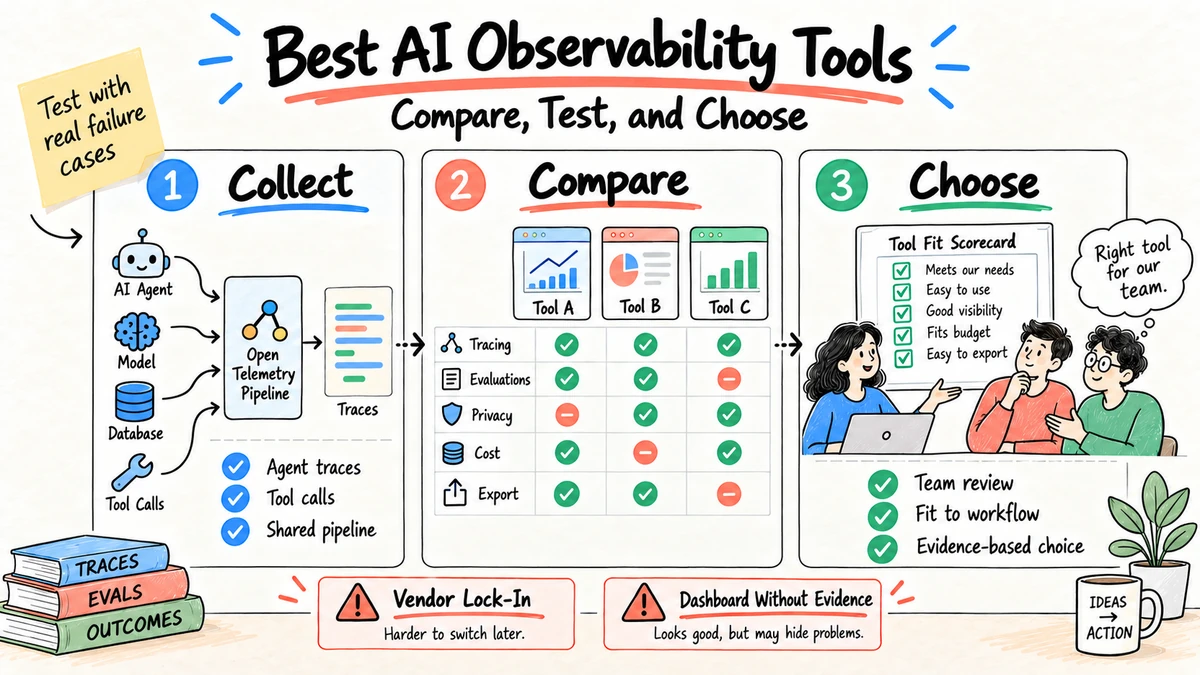
A melhor ferramenta de observabilidade de IA é aquela que conecta uma falha de produção à execução exata, à versão de prompt ou modelo, ao resultado de recuperação, à chamada de ferramenta, à avaliação e ao resultado do usuário. Escolha entre os requisitos, não a lista de características mais longa. A maioria das equipes precisa de traços interoperáveis, avaliações específicas de tarefas, controles de privacidade e um caminho de exportação mais do que de outro painel genérico.
Pesquisa e transparência: Este guia de compradores utiliza documentação pública de OpenTelemetry. LangSmith. Arize Phoenix. Confiança cerebral, e Datadog, revisado em 4 de Setembro de 2026. O Ottermind não é classificado como fornecedor de observabilidade. As características e os planos mudam; verifique-os com um teste representativo.
Lista curta por necessidade operacional
| Precisa | Ferramentas de avaliação | Por que eles entram na lista curta |
|---|---|---|
| Telemetria aberta e inspecção local | OpenTelemetry mais Arize Phoenix | Instrumentos abertos e um caminho para inspecionar os vestígios e as avaliações |
| Desenvolvimento de LangChain ou LangGraph | LangSmith | Fluxo de trabalho de rastreamento, conjunto de dados e avaliação estreito para esse ecossistema |
| Iteração do produto em primeiro lugar de avaliação | Confiança cerebral | Experimentos, marcadores, conjuntos de dados e registros de produção em um único ciclo |
| Monitoramento das empresas existentes | Observabilidade do Mestrado em Direito Jurídico Datadog | Os sinais de agentes ao lado da infraestrutura e dos incidentes de aplicação |
| Pipeline de dados neutra entre fornecedores | Colector OpenTelemetry mais backend escolhido | Convenções de eventos portáteis e controlo do roteamento |
Esta é uma lista curta por aptidão, não uma classificação universal. Adicione requisitos de segurança, residência de dados, retenção, implantação e preço antes de selecionar um produto.
Sete capacidades para testar
1. Traços de ponta a ponta
O rastreamento deve conectar chamadas de modelo, recuperação, uso de ferramentas, subagentes, retries e passos de aprovação. Verifique se o trabalho asincrono e as entregas continuam a fazer parte da mesma corrida.
- 2o. Experimentos de versão
Você precisa comparar alterações de prompt, modelo, ferramenta e recuperação no mesmo conjunto de dados. Um gráfico sem metadados de versão não pode explicar uma regressão.
3. Avaliação on-line e off-line
Procure verificações deterministas, classificações baseadas em modelos, revisão humana e resultados comerciais personalizados. Confirme que pode inspecionar falhas individuais por trás de uma pontuação agregada.
4. Atribuição de custos e latência
O produto deve atribuir tokens, custo e tempo a passos e ferramentas, não apenas ao pedido final. Caso contrário, um ciclo de retest pode esconder-se dentro de uma média aceitável.
5. Controle de privacidade
A redação de testes antes da exportação, o acesso baseado em funções, o rastreamento sem conteúdo, os controles de retenção e os registros de auditoria. Pergunte se as instruções e as saídas são utilizadas para a formação de fornecedores.
6. Exportação aberta
Confirmar que pode enviar ou exportar telemetria utilizando um formato documentado. A compatibilidade com a OpenTelemetry reduz o custo de alterar os backends e de conectar os traços de agentes com o monitoramento das aplicações.
7. Fluxo de trabalho operacional
O ponto final útil é uma correção: alerta, inspecção, etiqueta, adição de um caso de falha a um conjunto de dados, teste de uma alteração e verificação do resultado da produção. Certifique-se de que a ferramenta suporta esse ciclo sem arqueologia de planilhas.
Compreender as categorias de produtos
Padrões abertos de instrumentação
A OpenTelemetry não é um produto de observabilidade acabado por si só. Ele fornece API, SDKs, coletores e convenções semânticas que ajudam os aplicativos a descrever e rotear a telemetria de forma consistente. Ele pertence à lista seletiva quando a portabilidade, a infraestrutura de monitoramento existente ou o controlo sobre o encaminhamento de dados são questões.
Teste a maturidade da linguagem exata, do provedor de modelos e da instrumentação do framework do agente que utiliza. A compatibilidade em uma página do fornecedor não prova que as chamadas de ferramentas, o streaming, a recuperação, as entregas e os erros apareçam com os campos que a sua equipe precisa.
Plataformas de desenvolvimento de agentes
Plataformas como LangSmith conectam traços com o desenvolvimento de fluxo de trabalho rápido ou rápido, conjuntos de dados, experimentos, avaliadores e anotações. Eles podem reduzir a distância de uma corrida de produção falhada a um teste de regressão, especialmente quando a equipe já usa estruturas relacionadas.
A avaliação deverá ainda incluir uma aplicação estruturalmente neutra. Confirmar o que funciona através da integração nativa, o que requer instrumentação manual e como os dados podem ser exportados.
Plataformas de avaliação em primeiro lugar
Produtos como o Braintrust enfatizam conjuntos de dados, marcadores, experimentos, registros e comparações. Eles se encaixam em equipes que tratam a avaliação como o contrato de lançamento, em vez de um painel de controle ocasional.
Teste complexos traços de várias etapas, anotações humanas, amostragem de produção e o caminho de uma correção do revisor para um caso de teste permanente. Pergunte como as versões de avaliadores e as alterações no modelo de juiz afetam as comparações históricas.
Inspecção e experimentação em código aberto
Projetos como o Arize Phoenix podem apoiar a inspecção e avaliação de rastreamento local ou autogestionada. O código aberto dá às equipes opções de implantação e personalização, mas elas possuem atualizações, armazenamento, autenticação, backup, disponibilidade e resposta a incidentes a menos que um serviço gerenciado os cobre.
Faça a mesma revisão de segurança que faria para um serviço comercial. A auto-hosting muda a responsabilidade; não a elimina.
Monitoramento das aplicações das empresas
Plataformas como Datadog conectam sinais de IA com rastros de aplicativos, infraestrutura, registros, propriedade de serviços e fluxos de trabalho em chamada. Isso pode ser decisivo quando uma falha do agente cruza chamadas de modelo, API, bases de dados, filas e dependências de rede.
Verificar a profundidade dos fluxos de trabalho de avaliação específica do agente e de conjuntos de dados. A forte correlação entre infraestruturas não fornece automaticamente o ciclo editorial ou de qualidade de domínio de que a equipa de produtos necessita.
Aquaciona a ferramenta com a equipa
| Situação da equipa | Comece com: | Validação antes do compromisso |
|---|---|---|
| Uma pequena equipa, um protótipo de agente. | Ferramentas de localização nativas ou de ligação leve | Velocidade de depuração e custo máximo mínimo de configuração |
| Equipe de transporte semanal | Percebimento de experimentos e conjuntos de dados mais versões | Fluxo de trabalho de regressão e rotulagem do revisor |
| Múltiples estruturas e provedores | Instrumentos compatíveis com a OpenTelemetry | Campos consistentes e portabilidade de backend |
| Cargas de trabalho reguladas ou sensíveis | Serviço autogestionado ou fortemente controlado | Reedição, residência, acesso, retenção, auditoria |
| Programa de observabilidade das empresas existente | Extensão específica do APM atual mais do agente | Profundidade da avaliação da qualidade e correlação de rastreamento |
| Grupo de investigação ou avaliação | Plataforma de avaliação em primeiro lugar | Reprodução, marcadores personalizados, governança de conjuntos de dados |
Evite tratar o tamanho da organização como o único sinal. Um pequeno fluxo de trabalho legal pode necessitar de controles de captura mais rigorosos do que uma demonstração pública de grande volume, enquanto um protótipo interno grande pode necessitar de pouca infraestrutura de produção.
Cinco cenários de selecção
Cénario 1: Um agente de apoio dá uma resposta incorreta à política
Priorize os fios de várias voltas, traços de recuperação, metadados de versão de documento, avaliação de citações, anotação e um caminho rápido de uma correção de usuário para um caso de regressão. As métricas de infraestrutura por si só não mostram por que a política obsoleta venceu.
Cénario 2: Um agente de codificação consome tempo imprevisível e tokens
Priorizar as extensões de ferramentas e modelos aninhados, a visibilidade de redefinição e de loop, a atribuição de tokens e custos, eventos de sandbox e comparação de rotas entre versões. Teste uma execução que se espalha depois de mudar de arquivos, não apenas uma sugestão de código bem sucedida.
Cénario 3: Fluxo de trabalho de documentos regulamentados
Priorizar o rastreamento sem conteúdo, a redação antes da exportação, o armazenamento autogestionado ou controlado por região, o acesso baseado em funções, os registros de auditoria, a retenção e as validações deterministas. Uma ferramenta de baixo custo não é adequada se os revisores não podem provar qual a fonte e a versão que regem o resultado.
Cénario 4: Uma equipa de produtos compara as instruções e os modelos semanalmente
Priorizar conjuntos de dados, experimentos, versões de avaliadores, revisão de saída lado a lado, resumos estatísticos e feedback de produção. A equipa precisa de reprodução e de comparação de mudanças mais do que de uma interface madura para a chamada.
Cénario 5: Muitas equipes utilizam diferentes estruturas de agentes
Priorizar a compatibilidade OpenTelemetry, um esquema de eventos comum, controle de colecionador, rastreamento frame-neutral e exportação. Teste a consistência semântica em dois quadros; a simples aceitação do OTLP não garante intervalos de agentes comparáveis.
Utilize uma matriz de decisão ponderada
Defina pesos antes dos testes. O exemplo a seguir é adequado a um agente de trabalho de conhecimento de produção; adapta-o ao risco real.
| Critério | Peso | Candidato A | Candidato B | C. Candidato C |
|---|---|---|---|---|
| Completidade dos rastreamentos | 20 | |||
| Fluxo de trabalho de avaliação | 15 | |||
| Privacidade e acesso | 20 | |||
| Debug e revisão de usabilidade | 15 | |||
| Integração e portabilidade | 10 | |||
| Operações de produção | 10 | |||
| Custo total | 10 |
Ponha cada um de 0 a 5 usando provas da prova de conceito. Adicionar uma lista de passes/falhas separada para requisitos não negociáveis, como região, exclusão, SSO ou supressão de conteúdo. Uma pontuação ponderada elevada não deve substituir uma exigência legal ou de segurança falhada.
Exigir uma nota e testar atrás de cada pontuação. Caso contrário, a matriz transforma impressões de demonstração em decimais.
Utilização do revisor de testes
A observabilidade serve mais do que os engenheiros. Peça a um gerente de produto, especialista em domínio, revisor de segurança e operador de suporte para investigar as mesmas corridas rotuladas sem coaching.
Observe se podem:
- Encontrar a execução a partir de um relatório de utilizador ou de um ID de artefato;
- compreender a sequência sem ler JSON bruto;
- abrir o resultado exato da fonte e da ferramenta recuperados;
- distinguir os dados de produção dos comentários dos avaliadores;
- Marcar a falha e atribuir um proprietário;
- Comparar a versão falha com uma correção candidata;
- Exportar provas de um incidente ou auditoria;
- evitar ver conteúdos fora da sua autorização.
Registro de tempo de conclusão e erros. Uma plataforma que seja poderosa para o seu implementador, mas inutilizável para os revisores que julgam a qualidade deixará incompleto o ciclo de melhoria.
Avaliação da alerta e da resposta a incidentes
Crie três incidentes de teste: uma interrupção da ferramenta, um aumento repentino dos custos e uma regressão da qualidade da saída. Confirmar como os grupos de plataforma afetados executam, suprimem duplicados, alteram links, encaminham notificações e preservam evidências.
Os alertas de qualidade precisam de volume e calibração suficientes para evitar ruído. Uma única pontuação baixa do juiz modelo pode criar uma item de revisão; uma queda sustentada na conclusão aceita pode justificar um incidente. Os eventos de segurança e privacidade podem exigir uma resposta imediata de um caso confirmado.
Verificar se os alertas podem utilizar resultados de negócios, como entregas rejeitadas ou casos de apoio não resolvidos, e não apenas telemetria técnica. A falha de produção mais importante pode retornar HTTP 200.
Planejar a arquitetura de instrumentação
Aplicação de agente
-> instrumentação e redação em processo
-> OpenTelemetry ou SDK do fornecedor
-> colector ou gateway controlado
-> política de roteamento e amostragem
-> observabilidade backend
-> avaliação e anotação
-> incidentes, problemas e sistemas de implantação
Colocar a filtragem secreta e a classificação obrigatória tão perto da aplicação quanto possível. Use um coletor ou gateway para aplicar consistentemente roteamento, amostragem, enriquecimento e controle de destino. Mantenha o fluxo de trabalho e liberte metadados conectados aos registros de implantação para que uma mudança possa ser investigada.
Comportamento de falha de documentos. Se o backend de observabilidade não estiver disponível, decida se o buffer de telemetria, a queda ou o bloqueio do fluxo de trabalho. A maioria dos agentes orientados para os utilizadores não deve falhar apenas porque o rastreamento opcional não é adequado, mas os fluxos de trabalho de alto risco podem exigir um registro duradouro de auditoria antes de uma ação consequente ser tomada.
Evite as armadilhas de referência
As comparações de fornecedores muitas vezes contam com integrações ou apresentam latência sintética. Esses sinais não respondem se a sua equipa pode resolver os seus falhas. Use a mesma versão de agente, casos de teste, amostragem, modo de captura de conteúdo, retenção e definições de avaliador para cada candidato.
Não compare uma ferramenta de código aberto hospedada localmente com um serviço gerenciado, excluindo a infraestrutura interna e a mão-de-obra. Não compare o preço da lista quando os candidatos contem os espaços, tokens, armazenamento, avaliações e lugares de forma diferente. Normalização para custo por resultado de fluxo de trabalho aceito sob as mesmas suposições de volume.
Mantenha os resultados originais e as notas de pontuação. Se um candidato melhorar durante o teste, gravar a versão e reiniciar o teste fixo em vez de editar a velha pontuação da memória.
Escrever os requisitos de falhas
Transformar histórias de depuração em concreto em testes de aceitação:
Falha: O agente citou uma política ultrapassada após uma conversa de três voltas.
Evidências necessárias:
- Complete o fio de conversação e execute IDs
- Queria de recuperação e versões de documentos devolvidos
- Versões de prospecto, modelo e fluxo de trabalho
- Ferramenta e sequência de retorno
- Resultado da avaliação de citações
- Correção e resultado do utilizador final

Teste de aceitação:
Um revisor pode encontrar a recuperação obsoleta, adicionar a execução a um conjunto de dados,
Compare uma correção proposta e confirme a versão de produção corrigida.
Crie pelo menos cinco histórias: resposta errada, ciclo caro, dependência lenta, falha de permissão e rastreamento sensível à privacidade. Uma demonstração de fornecedor deve reproduzir essas histórias com a sua forma de dados em vez de apresentar um painel de controle preparado.
Um cartão de pontuação de prova de conceito de duas semanas
Teste dois fluxos de trabalho reais e ponta cada critério de 0 a 2.
| Critério | 0 | 1 | 2 |
|---|---|---|---|
| Completidade dos rastreamentos | Faltam passos importantes | A maioria dos passos visíveis | A execução completa é reconstruível |
| Aptidão para avaliação | Resultados gerais fixos | Alguma lógica personalizada | Específico de tarefa e versão |
| Tempo de depuração | Não há melhorias | Melhoria parcial | A causa raiz foi encontrada rapidamente |
| Privacidade | Conteúdo sempre armazenado | Controle manual | Minimização orientada por políticas |
| Portabilidade | Exportação fechada | Exportação parcial | Exportação aberta e documentada |
| Linha de resultados | Nenhum resultado do utilizador | Rótulos manuais | A cada corrida se junta o resultado |
Fluxo de trabalho:
Não reproduzir:
Campo de rastreamento necessário:
Campos sensíveis a suprimir:
Set de avaliação offline:
Resultados da produção:
Limite de alerta:
- O que é isso ?
Decisão de saída: adoção / prorrogação do teste / rejeição
Uma prova de conceito diária
Dia 1-2: Congelando o teste
Escolha dois fluxos de trabalho, dez corridas conhecidas, dez falhas e um caso sensível. Documente o tempo de depuração atual, custo, latência e taxa de aceitação. Finalize a rubrica de pontuação antes de os fornecedores configurarem o produto.
Dias 3-4: Instrumento
Conecte o fluxo de trabalho de fase. Registre os campos que aparecem automaticamente, as alterações de código necessárias, períodos faltantes e tempo de configuração. Verifique o streaming, retestes, trabalhos de fundo e erros de ferramenta em vez de parar após um bate-papo bem sucedido.
Dia 5-6: Avaliação
Importar ou criar um conjunto de dados, adicionar avaliadores deterministas e qualitativos e comparar duas versões controladas de fluxo de trabalho. Ter um revisor de domínio falhas de rótulo sem depender da pontuação padrão do fornecedor.
Dia 7-8: Operações de teste
Criar um alerta, investigá-lo, atribuir uma correção, adicionar a execução à regressão e verificar uma versão fixa. Dados de rastreamento e avaliação de exportação. Mudanças de função de teste e remoção do acesso de um utilizador.
Dias 9 a 10: Gerenciamento e custo de teste
Exercício de redação, retenção, exclusão, registros de auditoria e captura livre de conteúdo. Estimar ingestão mensal, armazenamento, avaliação, assentos, suporte e operação de engenharia. Assinatura de suposições e bandas de volume.
Acabe com uma decisão escrita. Uma prova de conceito polida pode ainda falhar porque a exportação é incompleta, os revisores não podem usá-la ou o custo de avaliação previsto é muito elevado.
Estimar o custo total da propriedade
Incluir mais do que o preço da assinatura:
| Área de custos | Perguntas |
|---|---|
| Ingestão | São cobrados os espaços, tokens, eventos ou bytes? O que é amostragem? |
| Reterção | Como os vestígios quentes, arquivados e apagados afetam o custo? |
| Avaliação | As chamadas de juízes são incluídas ou passadas? |
| Sessões | Que engenheiros, revisores, auditores e espectadores precisam de acesso? |
| Alojamento | Para ferramentas autogestionadas, quem é dono de computação, armazenamento, backup e atualizações? |
| Engenharia | Quanto instrumento e manutenção sob medida são necessários? |
| Migração | Podem ser exportados vestígios históricos, conjuntos de dados, rótulos e avaliadores? |
| Resposta a incidentes | A cobertura do apoio corresponde ao risco de produção e às zonas horárias? |
Modelo três volumes: corrente, uso esperado de doze meses, e um pico. A amostragem e a retenção devem ser explicitas em cada modelo. Ingestão barata pode tornar-se cara quando as instruções completas, as saídas e as avaliações dos juízes multiplicam cada corrida.
Revisão da segurança e da privacidade
Peça ao vendedor que demonstre, não apenas descreva:
- redação antes de os dados deixarem o seu pedido;
- O rastreamento apenas com metadados por classificação de fluxos de trabalho;
- Criptografia em trânsito e em repouso;
- Opções regionais de transformação e armazenamento;
- O isolamento dos inquilinos e o acesso baseado em funções;
- Registros de auditoria para visualização e exportação;
- A retenção configurável e a exclusão verificada;
- Tratamento de instruções, saídas e telemetria para formação de modelos;
- Subprocessadores e acesso de suporte;
- Detecção secreta em argumentos de ferramentas e mensagens de erro.
Criar um rastro de teste que contenha credenciais sintéticas e dados pessoais, e confirmar o bloco ou a redação esperados em cada destino. Nunca usem segredos reais para este teste.
Construir, comprar ou combinar
Compre uma plataforma gerenciadaQuando a velocidade, a colaboração, a avaliação e o suporte hospedados são mais importantes do que o controlo máximo da infraestrutura.
Auto-gerenciar uma pilha de código abertoQuando o controlo, a personalização ou a integração com a infraestrutura interna dos dados justifiquem a propriedade operacional em curso.
Extender a MAP existenteQuando predominam incidentes entre serviços e práticas estabelecidas em função da chamada, desde que possa ser adicionada uma avaliação da qualidade do agente.
Combinar instrumentação aberta com um backend escolhidoQuando a portabilidade for um requisito. Este é muitas vezes um caminho médio prático, mas apenas se o esquema comum retém os detalhes necessários para o backend.
Evite construir uma interface inteira apenas para evitar uma licença. Instrumentos personalizados e um pequeno relatório interno de qualidade podem ser razoáveis; recriar a pesquisa de rastreamento, avaliação, anotação, controle de acesso e retenção é um compromisso de produto.
Lista de verificação de migração e saída
[ ] Exportação de dados de rastreamento num formato documentado e utilizável.
[ ] Datasets preservam entradas, saídas esperadas, metadados e divisões.
[ ] Os rótulos humanos e as identidades dos revisores podem ser mantidos sob a política.
[ ] As definições e versões do avaliador podem ser recriadas em outros lugares.
[ ] As referências de versões de instantes e fluxos de trabalho continuam a ser significativas.
[ ] Alertas, painéis de controle e consultas guardadas são inventariadas.
[ ] A remoção do SDK não rompe o fluxo de trabalho de produção.
[ ] A exclusão do antigo serviço pode ser verificada.
Executa uma exportação durante o julgamento. A linguagem contratual não substitui a avaliação de se os dados resultantes podem reconstruir uma investigação útil.
Adopção após a compra
Comece com nomeação compartilhada, atributos necessários, modos de captura e campos de resultados do fluxo de trabalho. Publique um exemplo de instrumentação e revise-o como um contrato de API. Se cada equipa inventar a sua própria .agent_nameO instrumento central não pode criar visões comparáveis.
Criar proprietários para instrumentação, operação de plataforma, avaliação, revisão de domínio, privacidade e resposta a incidentes. Realizar uma revisão mensal de falhas que selecione um pequeno número de alterações e verifique o seu efeito de produção. Mais vestígios sem cadência de funcionamento criam armazenamento, não confiabilidade.
Audit salvou painéis de controle e alertas após cada grande alteração no fluxo de trabalho. Retire as métricas que não levam mais a uma decisão e teste se novas ferramentas ou entregas aparecem em vestígios antes da implantação.
Perguntas relativas a um pedido de pedido ou a uma chamada de fornecedor
- Quais são os quadros de agentes, os fornecedores de modelos e as linguagens que são suportados no nível de passo?
- Como são representados os fios de várias viradas, os subagentes, o trabalho assíncrono e as entregas?
- Quais convenções e vias de exportação da OpenTelemetry são apoiadas hoje?
- Podemos fazer avaliações deterministas, baseadas em modelos e humanas?
- Como estão conectados conjuntos de dados, avaliadores, instruções e versões de fluxo de trabalho?
- Onde ocorre a redação e pode a captura de conteúdo ser desativada por política?
- Qual é o prazo de retenção máximo e o prazo de retenção máximo?
- Como é auditado o acesso, a visualização de apoio e a exportação?
- O que acontece com os nossos dados durante a formação de modelos e a melhoria do serviço?
- Como os preços são afetados por espaços, armazenamento, avaliações e lugares?
- O que podemos exportar se sairmos e em que formato?
- Que limitações atuais afetariam as nossas falhas de prova de conceito?
Erros comuns na selecção
- Comprar painéis de controle atraentes antes de definir uma pergunta de depuração.
- Tratar o sentimento ou a relevância genéricos como prova do sucesso da tarefa.
- Capturar o conteúdo completo por padrão e projetar privacidade mais tarde.
- Comparar ferramentas com pedidos de chat de brinquedo em vez de falhas em vários passos.
- A fixação de instrumentos em um único backend sem testes de exportação.
- Medir o sucesso do pedido, ignorando se os utilizadores aceitam o trabalho.
Outro erro comum é selecionar de uma tabela de comparação sem confirmar a data de publicação. Os produtos de observabilidade dos agentes evoluem rapidamente. Tratar este guia como um quadro de requisitos, verificando, em seguida, todas as capacidades na documentação atual e no ambiente de teste.
O guia de observabilidade de agentes de IA define o modelo de eventos e revisão. O guia de fluxos de trabalho agênticos ajuda a identificar quais etapas e decisões humanas pertencem a um rastreamento.
FAQ
A observabilidade do LLM e a observabilidade do agente de IA são as mesmas?
Eles se sobrepõem, mas a observabilidade do agente abrange mais do que chamadas modelo. Deve incluir planejamento, recuperação, ferramentas, estado, entrega, retestes, permissões, aprovações e resultados finais.
Uma ferramenta de código aberto é sempre mais barata?
- Não, não. O custo da licença é apenas um componente. Incluir hospedagem, armazenamento, manutenção, controlo de acesso, integração em chamada e tempo de engenharia necessário para manter a instrumentação atual.
O monitoramento padrão das aplicações pode lidar com agentes?
Pode abranger a saúde das infraestruturas e dos serviços. Geralmente, é necessário rastrear e avaliar os agentes específicos para explicar as falhas comportamentais e a qualidade da tarefa.
Quantas ferramentas devemos experimentar?
Dois ou três são suficientes quando o cartão de pontuação e as falhas representativas são fixadas com antecedência. Uma turnê ampla produz capturas de tela, não uma decisão.
Precisamos de rastreamento e avaliação?
Sim, para a maioria dos agentes de produção. O rastreamento explica a sequência; a avaliação julga se o resultado e o comportamento cumpriram o contrato de tarefa. Cada um deles deixa uma lacuna importante.
Os dados de observabilidade devem permanecer na mesma região que os dados de produção?
Isso depende da política, dos contratos e da classificação dos dados aplicáveis. Tratar a telemetria como dados de produção potencialmente sensíveis e verificar os requisitos de processamento, armazenamento, acesso de apoio e transferência.
O que devemos exportar durante um julgamento?
Exportar traços representativos, conjuntos de dados, rótulos humanos, resultados de avaliação e definições de configuração. Confirme que outro engenheiro pode entendê-los e reutilizar sem a interface original.
Qual ferramenta de observação de IA é melhor para uma startup?
Não há vencedor automático de inicialização. Comece com a opção mais leve que reconstrui o fluxo de trabalho real e suporta um ciclo de falha para testar. Evite uma plataforma empresarial cuja operação exceda a complexidade do agente, mas mantenha um caminho de exportação.
Podemos trocar os retrospectivos de observabilidade mais tarde?
A instrumentação aberta ajuda, mas painéis de controle, definições de avaliador, anotações, conjuntos de dados, alertas e campos proprietários ainda podem criar bloqueio. Exportação e recreação de teste durante a prova de conceito.
Dever-se-ia proceder à avaliação de cada traço de produção?
Não é necessariamente. Utilize os controlos deterministas em geral quando não são caros, baseados em modelos de amostra e avaliação humana por risco e volume, e revise sempre os incidentes confirmados de alto impacto no âmbito da política.
Comece a avaliação com um fluxo de trabalho real no Ottermind e preserve o pacote de fontes, os dados de entrega aceitos e as correções do revisor como um caso de teste compartilhado.
