解説
AI エージェントのコンテキストエンジニアリング:信頼性を高める実践フレームワーク
2026-08-28·約12分·2026-08-28 更新
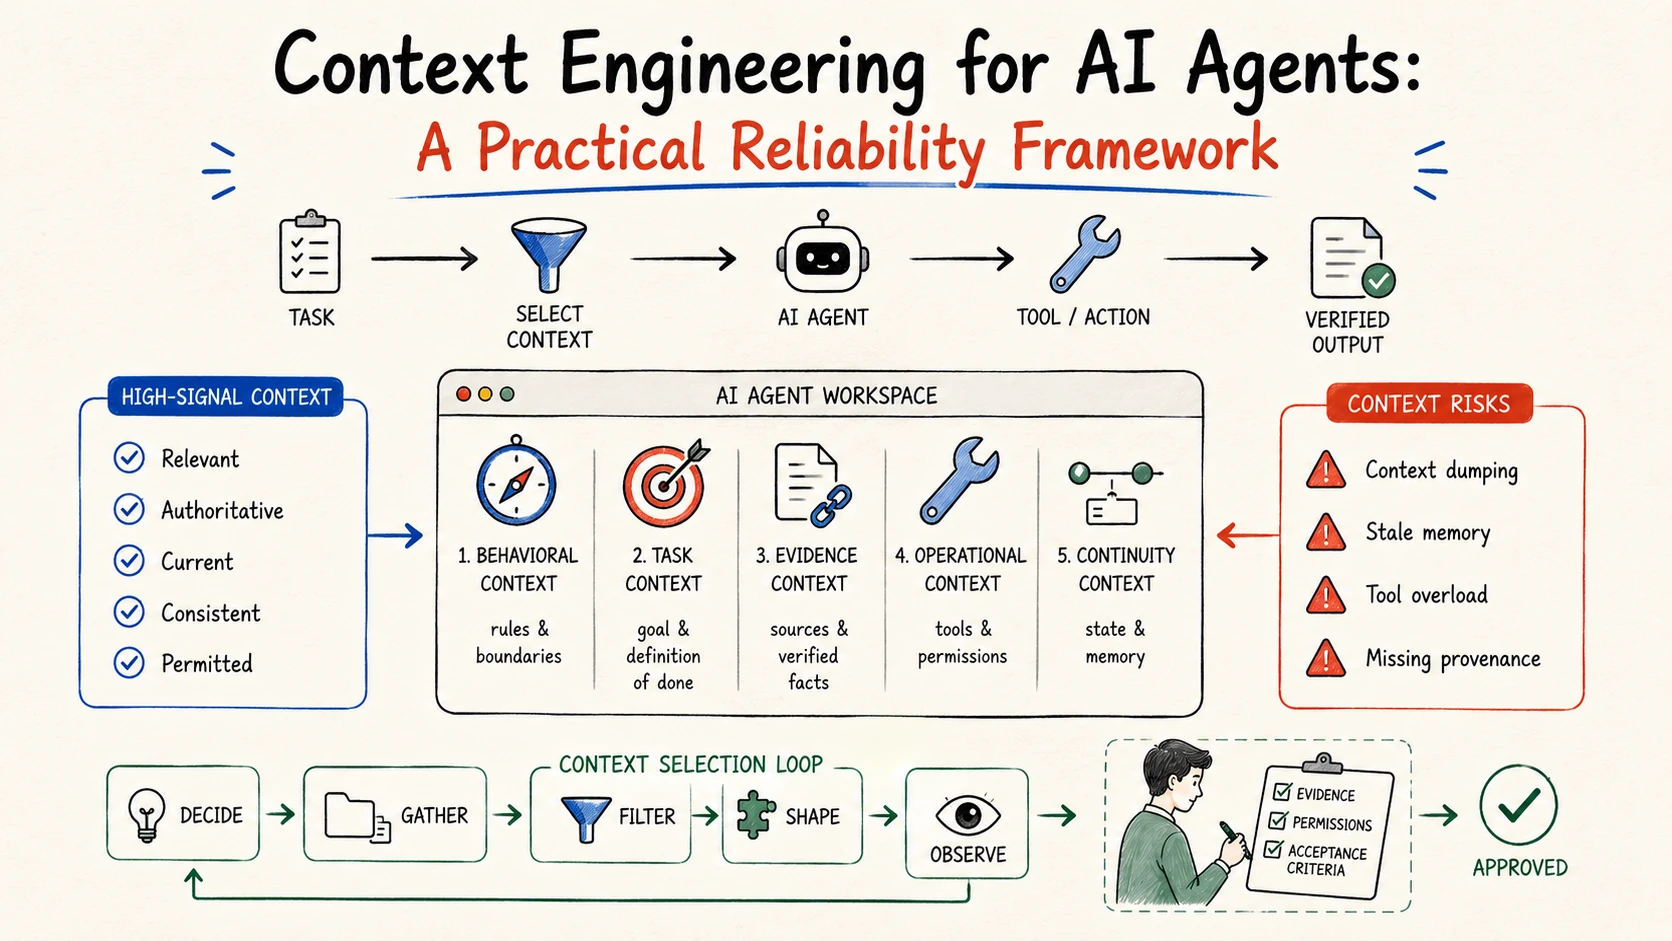
AI エージェントのコンテキストエンジニアリングとは、タスクの各段階で必要な情報、指示、ツール、状態、メモリを選ぶことです。最大量を渡すのではなく、次の判断に十分な最小の高品質コンテキストを渡し、検証可能な成果物につなげます。
調査と開示: Ottermind が公開する解説です。2026年8月28日に Anthropic、LangChain、OpenAI Agents SDK と Lost in the Middle を確認しました。以下のモデルと例は独自の編集フレームワークであり、Ottermind のベンチマークではありません。
なぜ重要なのか
エージェントは検索、ファイルの読取り、ツール実行、結果の観察、計画の修正を繰り返します。履歴をすべて渡すと、古い計画や重複した出力が重要な証拠を隠し、コストと遅延も増えます。長い入力の中央にある情報を使いにくくなることも研究で示されています。
プロンプトエンジニアリングとの違い
| 分野 | 問い | 範囲 |
|---|---|---|
| プロンプト | タスクをどう表現するか | 指示、例、役割、形式 |
| コンテキスト | 今、何を見せるか | 指示、証拠、ツール、状態、メモリ、権限 |
初期ブリーフは Ottermind のプロンプトガイドを参照してください。
コンテキストの五つの層
行動(ルールと境界)、タスク(目標と完了条件)、証拠(ファイルと出典)、運用(ツールと権限)、継続性(計画、決定、メモリ)に分けます。ID、接続情報、秘密情報などのローカルコンテキストは、必要でない限りモデルへ送らないでください。
Context Selection Loop
- 次の判断を定義する。
- 五つの層から候補を集め、出典と日付を残す。
- 関連性、権威性、鮮度、一貫性、権限で絞る。
- 指示と証拠を分け、重複を除き、承認済みの決定を残す。
- 結果を観察し、状態と次の判断を更新する。
実例とベストプラクティス
競合調査メモなら、最初にタスク契約とソースマップを作り、現在の証拠だけを選び、承認された判断から草稿を作り、基準で検証します。最小十分なコンテキストから始め、事実・指示・状態を分け、圧縮しても出典を保持し、同じタスクで改善を比較してください。
再利用できるテンプレート
Prompt
タスクと次の判断: [タスク]を完了し、[判断]を決める。
完了条件:成果物 [形式]、対象 [読者]、証拠 [出典]、基準 [品質]。
リスクや権限境界では停止して確認する。
行動: [ルール]に従い、承認なしに送信・公開・削除・変更しない。
証拠: [ファイルとリンク]を使い、引用と矛盾を残す。
運用: ツール [最小集合]、権限 [読む・下書き・書く・承認]。
継続性: 状態 [手順]、決定 [記録]、未解決 [不足情報]。
結果、出典、仮定、失敗した確認、次の判断を返す。
Agentic Workflow の解説、AI エージェントワークスペース、AI リサーチアシスタントも参照してください。