Guía para compradores
Mejores herramientas de observación de IA: Cómo elegir agentes y flujos de trabajo de LLM
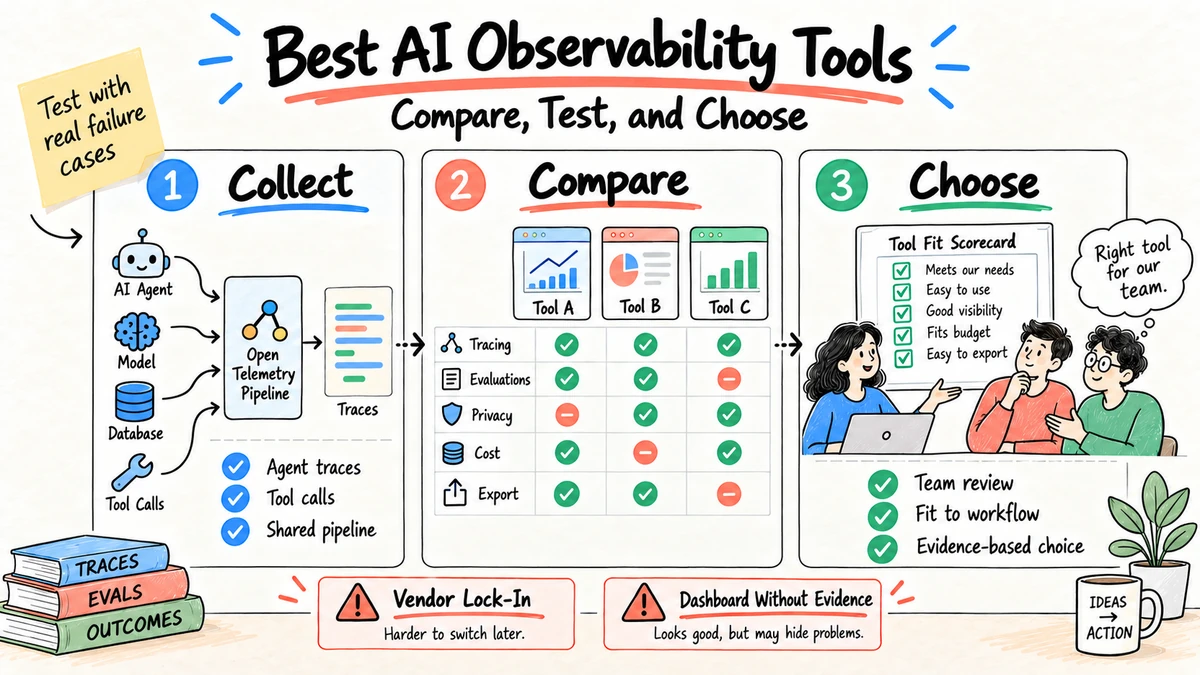
La mejor herramienta de observabilidad de IA es la que conecta un fracaso de producción con la ejecución exacta, la versión de pedido o modelo, el resultado de recuperación, la llamada de herramienta, la evaluación y el resultado del usuario. Elige entre los requisitos, no la lista de características más larga. La mayoría de los equipos necesitan rastros interoperables, evaluaciones específicas de tareas, controles de privacidad y una ruta de exportación más que necesitan otro panel genérico.
Investigación y transparencia: La guía de compradores utiliza documentación pública de Telemetría abiertaLangSmithArize PhoenixConfianza en el cerebro, y Datadog, revisado el 4 de septiembre de 2026. Ottermind no se clasifica como proveedor de observabilidad. Las características y los planes cambian; verifiquelas con un ensayo representativo.
Lista corta por necesidad de operación
| Necesidad | Herramientas para evaluar | Por qué se incluyen en la lista corta |
|---|---|---|
| Telemetría abierta y inspección local | OpenTelemetry más Arize Phoenix | Instrumentos abiertos y una vía para inspeccionar rastros y evaluaciones |
| Desarrollo de LangChain o LangGraph | LangSmith | Flujo de trabajo de seguimiento, conjunto de datos y evaluación estrecho para ese ecosistema |
| Iteración del producto en la evaluación | Confianza en el cerebro | Experimentos, marcadores, conjuntos de datos y registros de producción en un solo bucle |
| Monitoreo de las empresas existente | Datadog LLM Observabilidad | Las señales de agentes junto con la infraestructura de aplicaciones e incidentes |
| Línea de datos neutra entre proveedores | Colector de Telemetría abierta más backend elegido | Convenciones de eventos portátiles y control de enrutamiento |
Esta es una lista corta por ajuste, no un ranking universal. Añadir requisitos de seguridad, residencia de datos, retención, implementación y precio antes de seleccionar un producto.
Siete capacidades para probar
1. El número de personas Trazas de extremo a extremo
El rastro debe conectar las llamadas de modelo, la recuperación, el uso de herramientas, los subgentes, los retemplazos y los pasos de aprobación. Compruebe si el trabajo asincrónico y las entregas siguen formando parte de la misma carrera.
El 2o. Experimentos con versiones
Necesitas comparar cambios de prompt, modelo, herramienta y recuperación en el mismo conjunto de datos. Un gráfico sin metadatos de versión no puede explicar una regresión.
3. El número de personas Evaluación en línea y fuera de línea
Busque controles deterministas, calificaciones basadas en modelos, revisión humana y resultados comerciales personalizados. Confirme que puede inspeccionar los fracasos individuales detrás de una puntuación agregada.
4. Atribución de costes y latencia
El producto debe atribuir tokens, costo y tiempo a los pasos y herramientas, no solo a la solicitud final. De lo contrario, un ciclo de retoma puede esconderse dentro de un promedio aceptable.
5. El mismo. Control de privacidad
Reducción de pruebas antes de la exportación, acceso basado en funciones, seguimiento sin contenido, controles de retención y registros de auditoría. Pregunte si se utilizan las instrucciones y las salidas para la formación de los proveedores.
6. El número de personas Exportación abierta
Confirmar que puede enviar o exportar telemetría utilizando un formato documentado. La compatibilidad con OpenTelemetry reduce el coste de cambiar los backends y conectar las huellas de los agentes con el monitoreo de las aplicaciones.
7. ¿Qué es esto? Flujo de trabajo operativo
El punto final útil es una corrección: alerta, inspección, etiqueta, añadir un caso de falla a un conjunto de datos, probar un cambio y verificar el resultado de producción. Asegúrate de que la herramienta soporte ese bucle sin arqueología de hoja de cálculo.
Comprender las categorías de productos
Normas abiertas de instrumentación
OpenTelemetry no es un producto de observabilidad terminado por sí mismo. Proporciona API, SDK, coleccionistas y convenciones semánticas que ayudan a las aplicaciones a describir y dirigir la telemetría de manera consistente. Pertenece a la lista corta cuando se trata de la portabilidad, la infraestructura de monitoreo existente o el control sobre el enrutamiento de datos.
Prueba la madurez del lenguaje exacto, proveedor de modelos y instrumentación de marco de agente que utilice. La compatibilidad en una página del vendedor no prueba que las llamadas de herramientas, transmisión, recuperación, entregas y errores aparezcan con los campos que su equipo necesita.
Plataformas de desarrollo de agentes
Plataformas como LangSmith conectan rastros con desarrollo de flujo de trabajo rápido o rápido, conjuntos de datos, experimentos, evaluadores y anotaciones. Pueden acortar la distancia desde una carrera de producción fallida hasta una prueba de regresión, especialmente cuando el equipo ya utiliza marcos relacionados.
La evaluación debe seguir incluyendo una aplicación en el marco neutral. Confirmar qué funciona mediante la integración nativa, qué requiere instrumentación manual y cómo se pueden exportar los datos.
Plataformas de evaluación en primer lugar
Productos como Braintrust hacen hincapié en conjuntos de datos, marcadores, experimentos, registros y comparaciones. Se ajustan a los equipos que tratan la evaluación como el contrato de liberación en lugar de un tablero de control ocasional.
Prueba de complejos rastros de múltiples pasos, anotación humana, muestreo de producción y el camino desde una corrección del revisor hasta un caso de prueba permanente. Pregunte cómo las versiones de evaluadores y los cambios en el modelo de juez afectan a las comparaciones históricas.
Inspección y experimentación de código abierto
Proyectos como Arize Phoenix pueden apoyar la inspección y evaluación de rastro local o autogestionada. El código abierto ofrece a los equipos opciones de implementación y personalización, pero poseen actualizaciones, almacenamiento, autenticación, respaldo, disponibilidad y respuesta a incidentes a menos que un servicio administrado los cubra.
Realice la misma revisión de seguridad que aplicaría a un servicio comercial. El autoacogida cambia la responsabilidad; no la elimina.
Monitoreo de las aplicaciones de las empresas
Plataformas como Datadog conectan señales de IA con rastros de aplicaciones, infraestructura, registros, propiedad de servicios y flujos de trabajo en llamadas. Esto puede ser decisivo cuando un fallo de agente cruza llamadas de modelo, API, bases de datos, colas y dependencias de red.
Verificar la profundidad de los flujos de trabajo de evaluación específica de los agentes y de los conjuntos de datos. Una fuerte correlación de infraestructura no proporciona automáticamente el bucle editorial o de calidad de dominio que necesita un equipo de productos.
Aparezca la herramienta con el equipo
| Situación del equipo | Comience con | Validación antes de comprometerse |
|---|---|---|
| Un pequeño equipo, un prototipo de agente | Herramienta de localización nativa o de apertura ligera | Velocidad de desarreglamiento y gastos generales mínimos de configuración |
| El equipo de envío de productos semanal | Trazación de experimentos y conjuntos de datos con versiones | Flujo de trabajo de regresión y etiquetado de revisores |
| Múltiples marcos y proveedores | Instrumentos compatibles con OpenTelemetry | Campos coherentes y portabilidad de backend |
| Cargas de trabajo reguladas o sensibles | Servicio autónomo o controlado | Reedición, residencia, acceso, retención, auditoría |
| Programa de observabilidad de las empresas existente | Extensión de la APM actual más específica de agente | Profundidad de la evaluación de la calidad y correlación de rastro |
| Grupo de investigación o evaluación | Plataforma de evaluación en primer lugar | Reproducibilidad, marcadores personalizados, gobernanza de conjuntos de datos |
Evite tratar el tamaño de la organización como la única señal. Un pequeño flujo de trabajo legal puede necesitar controles de captura más estrictos que una demostración pública de gran volumen, mientras que un prototipo interno grande puede necesitar poca infraestructura de producción.
Cinco escenarios de selección
Cénario 1: Un agente de apoyo da una respuesta incorrecta a la política
Priorizar los hilos de múltiples giros, las huellas de recuperación, los metadatos de la versión del documento, la evaluación de citas, la anotación y un camino rápido desde una corrección de usuario hasta un caso de regresión. Las métricas de infraestructura por sí solas no mostrarán por qué ganó la política obsoleta.
Escenario 2: Un agente de codificación consume tiempo y tokens impredecibles
Priorizar las herramientas y modelos anidados, volver a probar y la visibilidad de bucle, la atribución de tokens y costos, eventos de sandbox y comparación de rutas entre versiones. Prueba una ejecución que se repite después de cambiar archivos, no sólo una sugerencia de código exitosa.
Cénario 3: Flujo de trabajo de documentos regulados
Priorizar el seguimiento sin contenido, la redacción antes de la exportación, el almacenamiento autónomo o controlado por región, el acceso basado en funciones, los registros de auditoría, la retención y las validaciones deterministas. Una herramienta de menor coste no es adecuada si los revisores no pueden probar qué fuente y versión gobernaron el resultado.
Escenario 4: Un equipo de productos compara las instrucciones y modelos semanalmente
Priorizar conjuntos de datos, experimentos, versiones de evaluadores, revisión de resultados lado a lado, resúmenes estadísticos y retroalimentación de producción. El equipo necesita reproductibilidad y comparación de cambios más que una interfaz madura en llamada.
Escenario 5: Muchos equipos utilizan diferentes marcos de agentes
Priorizar la compatibilidad de OpenTelemetry, un esquema de eventos común, control de colectores, seguimiento de marco neutro y exportación. Prueba de consistencia semántica en dos marcos; el mero hecho de aceptar OTLP no garantiza amplitudes de agentes comparables.
Utilice una matriz de decisión ponderada
Establezca pesas antes de los ensayos. El siguiente ejemplo se adapta a un agente de trabajo de conocimiento de producción; adapta a los riesgos reales.
| Criterio | Peso | El candidato A | El candidato B | El candidato C |
|---|---|---|---|---|
| Completidad de los rastros | 20 | |||
| Flujo de trabajo de evaluación | 15 de la Comisión | |||
| Privacidad y acceso | 20 | |||
| Debug y revisión de la usabilidad | 15 de la Comisión | |||
| Integración y portabilidad | 10 | |||
| Operaciones de producción | 10 | |||
| Costo total | 10 |
Ponte cada uno de 0 a 5 utilizando pruebas de la prueba de concepto. Añadir una lista de pasos/fallas separados para los requisitos no negociables, como región, eliminación, SSO o supresión de contenido. Una puntuación ponderada elevada no debe anular un requisito legal o de seguridad fallido.
Requerir una nota y hacer pruebas detrás de cada puntaje. De lo contrario la matriz convierte las impresiones de demostración en decimales.
Uso del revisor de pruebas
La observabilidad sirve más que a los ingenieros. Pida a un gerente de producto, especialista en dominios, revisor de seguridad y operador de soporte que investigue las mismas carreras etiquetadas sin coaching.
Observe si pueden:
- encontrar la ejecución de un informe de usuario o de un ID de artefacto;
- entender la secuencia sin leer JSON en bruto;
- abrir el resultado exacto de la fuente y de la herramienta recuperados;
- distinguir entre los datos de producción y los comentarios de los evaluadores;
- etiquetar la falla y asignar un propietario;
- comparar la versión fallida con una solución candidata;
- la exportación de pruebas de un incidente o auditoría;
- evitar ver contenido fuera de su autorización.
Registra el tiempo de finalización y los errores. Una plataforma que sea poderosa para su implementador pero inutilizable para los revisores que juzgan la calidad dejará incompleto el ciclo de mejora.
Evaluar la alerta y la respuesta a los incidentes
Crear tres incidentes de prueba: una interrupción de la herramienta, un aumento repentino de costos y una regresión de la calidad de salida. Confirmar cómo los grupos de plataformas afectados ejecutan, suprimen los duplicados, enlazan los cambios, enlazan las notificaciones y conservan la evidencia.
Las alertas de calidad necesitan un volumen y una calibración suficientes para evitar el ruido. Una única puntuación baja del juez modelo puede crear un elemento de revisión; una caída sostenida en la finalización aceptada puede justificar un incidente. Los eventos de seguridad y privacidad pueden requerir una respuesta inmediata de un caso confirmado.
Verifique si las alertas pueden utilizar resultados comerciales, como entregas rechazadas o casos de apoyo no resueltos, no sólo telemetría técnica. La falla de producción más importante puede devolver HTTP 200.
Planificar la arquitectura de los instrumentos
Aplicación de agente
-> instrumentación y redacción en proceso
-> OpenTelemetry o SDK del proveedor
-> colector o puerta de entrada controlada
-> política de enrutamiento y muestreo
-> backend de observabilidad
-> evaluación y anotación
-> incidentes, problemas y sistemas de despliegue
Coloque el filtrado secreto y la clasificación obligatoria lo más cerca posible de la aplicación. Utilice un colector o una puerta de entrada para aplicar de manera consistente los controles de enrutamiento, muestreo, enriquecimiento y destino. Mantenga el flujo de trabajo y libere metadatos conectados a los registros de implementación para que se pueda investigar un cambio.
El comportamiento de fallo de documentos. Si el backend de observabilidad no está disponible, decida si el buffer de telemetría, baja o bloquea el flujo de trabajo. La mayoría de los agentes orientados a los usuarios no deben fallar únicamente porque el seguimiento opcional está reducido, pero los flujos de trabajo de alto riesgo pueden requerir un registro de auditoría duradero antes de que se proceda a una acción consecuente.
Evita las trampas de referencia
Las comparaciones de proveedores a menudo cuentan con integraciones o presentan latencia sintética. Esas señales no indican si su equipo puede resolver sus fallos. Utilice la misma versión de agente, casos de prueba, muestreo, modo de captura de contenido, retención y definiciones de evaluador para cada candidato.
No comparar una herramienta de código abierto alojada localmente con un servicio administrado, excluyendo la infraestructura interna y la mano de obra. No comparar el precio de la lista cuando los candidatos cuenten las franquicias, tokens, almacenamiento, evaluaciones y asientos de manera diferente. Normaliza al costo por resultado de flujo de trabajo aceptado bajo los mismos supuestos de volumen.
Mantenga los resultados de las pruebas originales y las notas de puntuación. Si un candidato mejora durante el ensayo, graba la versión y vuelva a ejecutar la prueba fija en lugar de editar la antigua puntuación de memoria.
Escriba los requisitos de los fallos
Convierta historias de defecto de concreto en pruebas de aceptación:
Fallo: El agente citó una política obsoleta después de una conversación de tres vueltas.
Prueba requerida:
- Completa el hilo de conversación y ejecuta las identificaciones
- Las versiones de la consulta de recuperación y de los documentos devueltos
- Las versiones de la plantilla, el modelo y el flujo de trabajo
- Herramienta y secuencia de retroceso
- Resultado de la evaluación de las citas
- Corrección y resultado del usuario final

Prueba de aceptación:
Un revisor puede encontrar la recuperación obsoleta, agregar la ejecución a un conjunto de datos,
comparar una corrección propuesta y confirmar la versión de producción corregida.
Crear al menos cinco historias: respuesta equivocada, circuito caro, dependencia lenta, falla de permisos y rastro sensible a la privacidad. Una demostración de proveedor debe reproducir estas historias con su forma de datos en lugar de presentar un tablero de control preparado.
Una tarjeta de puntaje de dos semanas para la prueba de concepto
Prueba dos flujos de trabajo reales y califique cada criterio de 0 a 2.
| Criterio | 0 | 1 de la Comisión | 2 de la Comisión |
|---|---|---|---|
| Completidad de los rastros | Se faltan pasos importantes | La mayoría de los pasos visibles | El funcionamiento completo es reconstruible |
| Aplicación de la evaluación | Puntos genéricos fijos | Algunas lógicas personalizadas | Específico de tarea y versionado |
| Tiempo de depuración | No hay mejoras | Mejora parcial | La causa raíz se encuentra rápidamente |
| La privacidad | Contenido siempre almacenado | Control manual | Minimizar las políticas |
| Portable | Exportación cerrada | Exportación parcial | Exportación abierta y documentada |
| Enlace de resultados | No hay resultado para el usuario | Etiquetas manuales | El resultado se une a cada carrera |
Flujo de trabajo:
No reproducirse:
Campos de rastreo requeridos:
Campos sensibles para suprimir:
conjunto de evaluación fuera de línea:
Resultado de la producción:
Térmico de alerta:
El crítico:
Decisión de salida: adoptar / ampliar el ensayo / rechazarlo
Una prueba de concepto día a día
Día 1-2: Congela la prueba
Elija dos flujos de trabajo, diez carreras conocidas, diez fallos y un caso sensible. Documenta el tiempo de depuración actual, el costo, la latencia y la tasa de aceptación. Finaliza la rúbrica de puntuación antes de que los proveedores configuren el producto.
Días 3-4: Instrumento
Conecte el flujo de trabajo de puesta en escena. Registra los campos que aparecen automáticamente, los cambios de código requeridos, las distancias faltantes y el tiempo de configuración. Verifique la transmisión, retas, trabajos de fondo y errores de herramientas en lugar de detenerse después de un chat exitoso.
Días 5-6: Evaluar
Importa o crea un conjunto de datos, añade evaluadores deterministas y cualitativos y compara dos versiones de flujo de trabajo controladas. Tener un revisor de dominio etiqueta fallos sin depender de la puntuación predeterminada del proveedor.
Días 7-8: Operaciones de ensayo
Crear una alerta, investigarla, asignar una corrección, agregar la ejecución a la regresión y verificar una versión fija. Datos de rastreo y evaluación de exportación. Cambios de rol de prueba y eliminación del acceso de un usuario.
Días 9-10: Gobierno y coste de prueba
Ejercicio de la redacción, retención, eliminación, registros de auditoría y captura libre de contenido. Estimar la ingesta mensual, el almacenamiento, la evaluación, los asientos, el soporte y el funcionamiento de ingeniería. Registración de supuestos y bandas de volumen.
Terminemos con una decisión escrita. Una prueba de concepto pulida puede fallar aún porque la exportación es incompleta, los revisores no pueden utilizarla o el costo proyectado de la evaluación es demasiado alto.
Estimar el coste total de propiedad
Incluir más que el precio de suscripción:
| Área de costes | Las preguntas |
|---|---|
| Ingestión | ¿Se facturan las franquicias, tokens, eventos o bytes? ¿Qué se muestra? |
| Retener el producto | ¿Cómo afectan los costos los rastros calientes, archivados y eliminados? |
| Evaluación | ¿Se incluyen o se pasan las llamadas de los jueces? |
| Silla de trabajo | ¿A qué ingenieros, revisores, auditores y espectadores se les necesita acceso? |
| Alojamiento | Para herramientas autogestionadas, ¿quién es el dueño de la computación, almacenamiento, respaldo y actualizaciones? |
| Ingeniería | ¿Cuánto equipo y mantenimiento personalizado se requiere? |
| Migración | ¿Se pueden exportar rastros históricos, conjuntos de datos, etiquetas y evaluadores? |
| Respuesta a incidentes | ¿La cobertura de apoyo coincide con el riesgo de producción y las zonas horarias? |
Modelo de tres volúmenes: actual, uso esperado de doce meses, y un pico. La toma de muestras y la retención de muestras deben ser explícitas en cada modelo. La ingestión barata puede volverse costosa cuando las instrucciones completas, las salidas y las evaluaciones del juez se multiplican cada vez que se ejecuta.
Revisión de la seguridad y la privacidad
Pida al vendedor que demuestre, no simplemente describa:
- redacción antes de que los datos salgan de su solicitud;
- el seguimiento de metadatos únicamente por clasificación de flujos de trabajo;
- cifrado en tránsito y en reposo;
- opciones regionales de transformación y almacenamiento;
- aislamiento de los inquilinos y acceso basado en el papel;
- registros de auditoría para visualización y exportación;
- la retención configurable y la eliminación verificada;
- tratamiento de las instrucciones, salidas y telemetría para la formación de modelos;
- los subprocesadores y el acceso de soporte;
- detección secreta en los argumentos de herramientas y en los mensajes de error.
Crear un rastro de prueba que contenga credenciales sintéticas y datos personales, y luego confirmar el bloqueo o la redacción esperados en cada destino. Nunca uses secretos reales para esta prueba.
Construir, comprar o combinar
Comprar una plataforma gestionadacuando la velocidad, la colaboración, la evaluación y el soporte alojados son más importantes que el control máximo de la infraestructura.
Autogestión de una pila de código abiertocuando el control de datos, la personalización o la integración con la infraestructura interna justifiquen la propiedad operativa en curso.
Extensión de la MAP existentecuando predominen incidentes entre servicios y prácticas establecidas en el momento de la llamada, siempre que se pueda añadir una evaluación de calidad de los agentes.
Combina la instrumentación abierta con un backend elegidocuando la portabilidad es un requisito. Este es a menudo un camino medio práctico, pero sólo si el esquema común conserva los detalles necesarios para el backend.
Evite construir una interfaz completa sólo para evitar una licencia. La instrumentación personalizada y un pequeño informe interno de calidad pueden ser razonables; recrear la búsqueda de rastro, la evaluación, la anotación, el control de acceso y la retención es un compromiso de producto.
Lista de control de migración y salida
[ ] Exportación de datos de rastreo en un formato documentado y utilizable.
[ ] Datasets conservan entradas, salidas esperadas, metadatos y divisiones.
[ ] Las etiquetas humanas y las identidades de los revisores pueden conservarse bajo la política.
[ ] Las definiciones y versiones de evaluador se pueden recrear en otros lugares.
[ ] Las referencias de las versiones de la aplicación y del flujo de trabajo siguen siendo significativas.
[ ] Las alertas, los paneles y las consultas guardadas están inventariadas.
[ ] La eliminación de SDK no rompe el flujo de trabajo de producción.
[ ] Se puede verificar la eliminación del servicio anterior.
Realice una exportación durante el juicio. El lenguaje de contrato no sustituye a ver si los datos obtenidos pueden reconstruir una investigación útil.
Adopción después de la compra
Comience con nombres compartidos, atributos requeridos, modos de captura y campos de resultados del flujo de trabajo. Publica un ejemplo de instrumentación y revisa como un contrato de API. Si cada equipo invente su propio .agent_nameLa información de la información, el estado y los resultados de los usuarios, no pueden ser comparados.
Crear propietarios para la instrumentación, la operación de la plataforma, la evaluación, la revisión de dominio, la privacidad y la respuesta a incidentes. Realizar una revisión mensual de los fallos que seleccione un pequeño número de cambios y verifique su efecto productivo. Más huellas sin cadencia de funcionamiento crean almacenamiento, no fiabilidad.
Audit guardó tablas de control y alertas después de cada cambio importante en el flujo de trabajo. Retirar las métricas que ya no conducen a una decisión, y probar que aparecen nuevas herramientas o entregas en huellas antes de su implementación.
Preguntas para una solicitud de solicitud o para una llamada de proveedor
- ¿Qué marcos de agentes, proveedores de modelos y lenguajes se admiten a nivel de paso?
- ¿Cómo se representan los hilos de varios giros, los subagentes, el trabajo asincrónico y las entregas?
- ¿Qué convenciones y vías de exportación de OpenTelemetry se apoyan hoy en día?
- ¿Podemos ejecutar evaluaciones deterministas personalizadas, basadas en modelos y humanas?
- ¿Cómo se conectan conjuntos de datos, evaluadores, instrucciones y versiones de flujo de trabajo?
- ¿Dónde ocurre la redacción y puede la captura de contenido ser desactivada por política?
- ¿Cuáles son los períodos de impago y los períodos máximos de retención?
- ¿Cómo se auditó el acceso, la visualización de apoyo y las exportaciones?
- ¿Qué sucede con nuestros datos durante la formación de modelos y la mejora del servicio?
- ¿Cómo se influye en el precio de los espacios, el almacenamiento, las evaluaciones y los asientos?
- ¿Qué se puede exportar si nos vamos, y en qué formato?
- ¿Qué limitaciones actuales afectarían a nuestros fracasos en la prueba de concepto?
Errores comunes en la selección
- Comprando para los paneles atractivos antes de definir una pregunta de depuración.
- Tratar el sentimiento o la relevancia genéricos como prueba del éxito de la tarea.
- Capturar el contenido completo por defecto y diseñar la privacidad más tarde.
- Comparar herramientas con pedidos de chat de juguete en lugar de fallas en varios pasos.
- Bloqueo de la instrumentación en un extremo posterior sin realizar pruebas de exportación.
- Medir el éxito de la solicitud mientras se ignora si los usuarios aceptan el trabajo.
Otro error común es seleccionar de una tabla de comparación sin confirmar la fecha de publicación. Los productos de observabilidad de agentes evolucionan rápidamente. Trate esta guía como un marco de requisitos, y luego verifique cada capacidad en la documentación actual y en el entorno de ensayo.
La Guía de observabilidad de agentes de IA define el modelo de evento y de revisión. El explicación del flujo de trabajo de los agentes ayuda a identificar qué pasos y decisiones humanas pertenecen a un rastro.
Las preguntas frecuentes
¿Son la observabilidad del LLM y la observabilidad de los agentes de IA lo mismo?
Se superponen, pero la observabilidad del agente cubre más que las llamadas modelo. Debe incluir planificación, recuperación, herramientas, estado, entregas, retemplazos, permisos, aprobaciones y resultados finales.
¿Es una herramienta de código abierto siempre más barata?
No. El coste de la licencia es sólo un componente. Incluir alojamiento, almacenamiento, mantenimiento, control de acceso, integración en llamada y el tiempo de ingeniería necesario para mantener la instrumentación al día.
¿Puede el monitoreo estándar de aplicaciones manejar agentes?
Puede cubrir la salud de las infraestructuras y de los servicios. Por lo general, necesita rastros y evaluaciones específicas de los agentes para explicar los fallos de comportamiento y la calidad de la tarea.
¿Cuántas herramientas debemos probar?
Dos o tres son suficientes cuando se fijan de antemano las fallas de la tarjeta de puntuación y de los representativos. Una gira amplia produce capturas de pantalla, no una decisión.
¿Necesitamos rastreo y evaluación?
Sí para la mayoría de los agentes de producción. El seguimiento explica la secuencia; la evaluación juzga si el resultado y el comportamiento cumplen con el contrato de tarea. Uno de ellos deja una brecha importante.
¿Deberían los datos de observabilidad permanecer en la misma región que los datos de producción?
Esto depende de la política, los contratos y la clasificación de los datos aplicables. Tratar la telemetría como datos de producción potencialmente sensibles y verificar los requisitos de procesamiento, almacenamiento, acceso de soporte y transferencia.
¿Qué debemos exportar durante un juicio?
Exporta trazas representativas, conjuntos de datos, etiquetas humanas, resultados de evaluación y definiciones de configuración. Confirme que otro ingeniero puede entender y reutilizarlos sin la interfaz original.
¿Qué herramienta de observabilidad de IA es mejor para una startup?
No hay ganador automático de inicio. Comience con la opción más ligera que reconstruye el flujo de trabajo real y admite un bucle de prueba de falla. Evite una plataforma empresarial cuya operación exceda la complejidad del agente, pero conserve una vía de exportación.
¿Podemos cambiar las retrocesas de observabilidad más tarde?
La instrumentación abierta ayuda, pero los paneles de control, las definiciones de evaluador, la anotación, los conjuntos de datos, las alertas y los campos propietarios aún pueden crear bloqueo. Exportación y recreación de ensayo durante la prueba de concepto.
¿Debería la evaluación llevarse a cabo en cada rastro de producción?
No necesariamente. Utilice controles deterministas en general cuando sean baratos, basados en modelos de muestra y evaluaciones humanas por riesgo y volumen, y revise siempre los incidentes confirmados de alto impacto en el marco de la política.
Comienza la evaluación con un flujo de trabajo real en Ottermind y conserva el paquete de fuentes, el entregable aceptado y las correcciones del revisor como caso de prueba compartido.
