Technischer Leitfaden
GPT-6 beim Coding: dateiübergreifende Fehler, kleine Patches und Tests
GPT-6 Astras interessantester Coding-Vorteil ist das Verknüpfen verteilter Informationen in einer Codebasis. Frühe Tests zeigen einen größeren Nutzen bei schwierigen Reviews über mehrere Dateien als bei kleinen Änderungen. Das macht es für die Untersuchung von Änderungsfolgen interessant; Routineimplementierung braucht weiterhin einen Kosten- und Geschwindigkeitsvergleich.
Zwei externe Bewertungen untersuchen unterschiedliche Dinge: CodeRabbit misst, ob Review-Befunde markierte Fehler entdecken. Real Python prüft Verhalten anhand von fünf festen Prompts. Zusammen liefern sie einen praktischeren Ausgangspunkt als eine einzelne Coding-Rangliste.
Quellen: CodeRabbit-Bewertung; Real-Python-Tests; OpusBooster-Vergleich. Geprüft am 7. September 2026. Ergebnisse und Erfahrungen werden im Text den jeweiligen Autoren zugeordnet.
Was CodeRabbit gemessen hat
In der Bewertung vom 4. September nennt CodeRabbit folgende Fehlerabdeckung durch umsetzbare Befunde:
| Review-Menge | Astra | Sol | Unterschied |
|---|---|---|---|
| Gesamt | 61,3 % | 59,0 % | 2,3 Prozentpunkte |
| Schwierige dateiübergreifende Teilmenge | 57,1 % | 47,6 % | 9,5 Prozentpunkte |
Die relative Verbesserung von ungefähr 20 % in der schwierigen Teilmenge entspricht nicht 20 Prozentpunkten. Sie bedeutet auch nicht, dass jedes Team 20 % weniger Fehler ausliefert. Die Metrik erfasst identifizierte Fehler in dieser Bewertung; die zwei Zeilen haben verschiedene Schwierigkeitsverteilungen.
Das Ergebnis spricht für Astra-Tests bei Änderungen mit verteilten Folgen. Es beweist weder, dass jeder Kommentar stimmt, noch dass alle wichtigen Fehler gefunden werden oder kleine Patches das teuerste Modell benötigen.
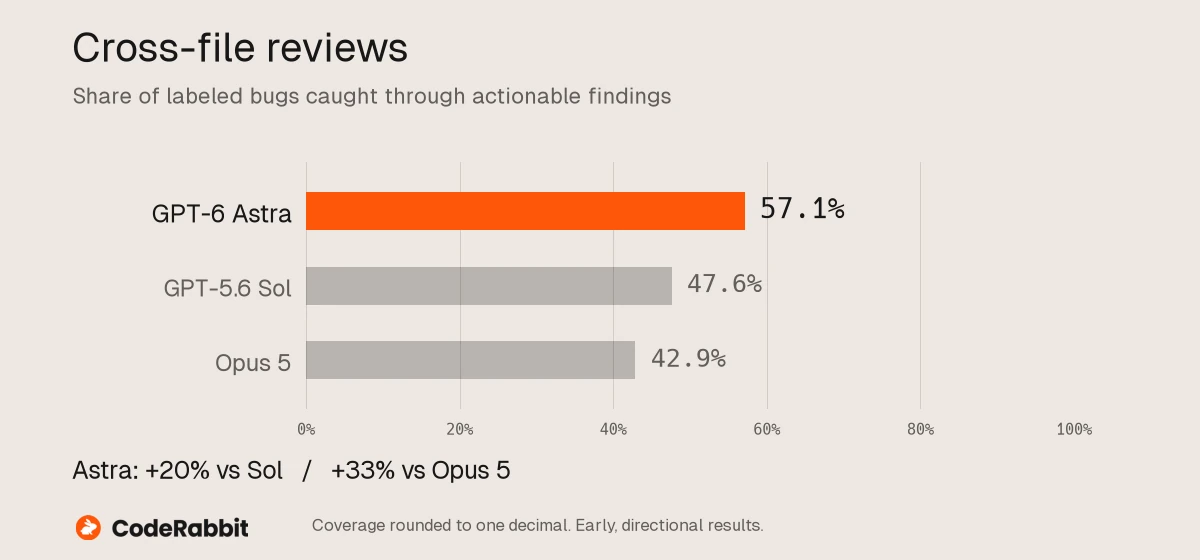
Dateiübergreifende Review-Ergebnisse von CodeRabbit. Frühe Befunde, kein Maß für die gesamte Review-Qualität.
Was Real Python geprüft hat
Der Fünf-Prompt-Test von Real Python verwendet Astra über OpenRouter mit Standardreasoning, einem Versuch je Prompt und ohne Systemprompt. Die Ausgaben sind öffentlich einsehbar.
Das Modell erkannte, dass eine erfundene Standardbibliotheksfunktion nicht existierte. Beim Ergänzen einer kleinen Option änderte es 11 Zeilen gegenüber einem Minimum von sieben. Die fünf Aufgaben kosteten in diesem Lauf 0,31 US-Dollar. Das ist eine nützliche Testform: erfundene APIs, Patchgröße und Ausführung prüfen, statt Code allein aufgrund plausiblen Aussehens anzunehmen.
Fünf Prompts sagen nicht das Verhalten im gesamten Repository voraus. Sie können aber kleine Eigenschaften aufdecken, die breite Benchmarks übersehen.
Warum grüne Tests die Funktion verfehlen können
Ein produktiver Astra-Terra-Aufgabenvergleich zeigte zwei Implementierungen mit bestandener Testsuite, obwohl eine gekoppelte Seitennavigationszustände falsch behandelte. Astra erhielt die Beziehung und fügte die entsprechende Prüfung hinzu.
Die allgemeine Lehre ist, den veränderten Funktionsvertrag zu prüfen. Bestehende Tests führen möglicherweise nie die Interaktion aus, die eine neue Funktion nützlich macht. Fragen Sie, ob der Nutzerablauf abgedeckt ist, nicht nur die neue Funktion im Code.
Den Patch hinter dem Punktwert lesen
Real Python veröffentlicht den kleinen Diff und seine Zeilenzahl. Zusätzliche Zeilen betreffen auch Argumentformatierung; das Überschreiten des Minimums beweist allein keine schädliche Überkomplexität. Relevant ist, ob Verhalten außerhalb des Auftrags verändert wird. Der anschließende Praxisteil war bei Prüfung noch nicht fertig. Deshalb sollten die fünf festen Prompts anhand ihrer eigenen Aussagekraft bewertet werden. Test und Patch ansehen.
Das gilt für jeden Coding-Agenten. Ein größerer Patch kann klarer sein, ein kleiner eine Inkompatibilität verstecken. Prüfen Sie die Wirkung des zusätzlichen Codes, geänderte Altverhalten und ob die neuen Tests ohne Korrektur fehlschlagen würden.
Nutzen Sie Benchmarks zur Kandidatenauswahl und anschließend Artefakte zur Beurteilung der Repository-Eignung. Produktdemo, Fehlerabdeckung und feste Prompts beantworten verschiedene Fragen.
Beispiel: eine gemeinsame Seitennavigation prüfen
Stellen Sie sich eine Seite mit zwei unabhängig paginierten Listen vor. Der Nutzer wechselt die erste Liste auf Seite drei und blättert danach in der zweiten. Die erste muss auf Seite drei bleiben. Beide Paginatoren können einzeln funktionieren, während ihr Zusammenspiel fehlschlägt.
Ein Reviewer sollte URL-Erstellung, Parameterverarbeitung, Komponentenzustand und Browsernavigation verfolgen. Enthält der neue Link nur den Parameter der zweiten Liste, kann er die erste Auswahl löschen. Ein isolierter Unit-Test eines Paginators übersieht das eventuell.
Ausgangs-URL: /results?customersPage=3&invoicesPage=1
Aktion: Rechnungen auf Seite 2 weiterblättern
Erwartet: /results?customersPage=3&invoicesPage=2
Zusätzlich prüfen: Neuladen, Zurücknavigation und ungültige Seitennummer
Der OpusBooster-Fall zeigt, warum solche Beziehungen wichtig sind. Er erinnert zugleich an Abnahmebeispiele vor der Implementierung. Das gibt Agent und Prüfer ein konkretes Ziel und lässt Raum für vorhandene Hilfsfunktionen.
Fehlerabdeckung und Review-Qualität trennen
Wer mehr bekannte Fehler findet, kann dennoch störende Fehlalarme liefern. Erfassen Sie lokal akzeptierte und abgelehnte Befunde sowie die Zeit für beide Prüfungen. Vage Bedenken ohne Auslöser können mehr Aufmerksamkeit kosten als sparen.
| Review-Ergebnis | Was erfassen? | Warum wichtig? |
|---|---|---|
| Bestätigter Fehler | Reproduktion und betroffenes Verhalten | Belegt einen hilfreichen Befund |
| Falscher Befund | Warum der Code korrekt ist | Misst Review-Rauschen |
| Offener Verdacht | Fehlende Belege oder Umgebung | Verhindert, dass Unsicherheit zur Fehlerbehauptung wird |
| Übersehener Fehler | Historischer Bug oder spätere Reproduktion | Zeigt Abdeckungslücken |
Lassen Sie Maintainer möglichst ohne Kenntnis des Modells urteilen. Halten Sie Schwierigkeit sichtbar: Eine kleine Konfiguration und eine dienstübergreifende Migration sollten nicht in einer unerklärten Durchschnittsnote verschwinden.
Genug Kontext für die Folgenprüfung bereitstellen
Beginnen Sie mit Änderungsauftrag und Diff, danach mit betroffenen Aufrufern und Tests. Nennen Sie leicht übersehene Kompatibilität: ältere API-Clients, persistierte Datenformate oder öffentliche Befehle, deren Ausgabe Skripte auswerten.
Laden Sie nicht wahllos fremdes Repository-Material in den Prompt. Lassen Sie das Modell betroffene Pfade verfolgen und notwendige Lektüre erklären. Das macht das Review prüfbar und zeigt wichtige, nie berücksichtigte Abhängigkeiten.
Bei gemeinsamen Typen prüfen Sie Erzeuger und Verbraucher. Bei Datenbankmigrationen nennen Sie Upgrade- und Rollbackannahmen. Bei Oberflächen definieren Sie erwartete Zustandswechsel. Der Leitfaden zur KI-Agenten-Architektur erklärt Kontext und Werkzeuge um das Modell herum.
Testumfang auf die Änderung abstimmen
OpenAIs GPT-6-Prompting-Leitfaden weist darauf hin, dass Coding-Aufgaben mehr Tests auslösen können, als kleine Änderungen benötigen. Definieren Sie vorab gezielte Prüfung, nachgewiesenes Verhalten und Bedingungen für eine größere Suite.
Eine Tippfehlerkorrektur braucht andere Validierung als eine gemeinsame Authentifizierungsänderung. Wiederholte Komplettläufe bringen kleinen Patches wenig zusätzliche Belege; ein einzelner Unit-Test reicht bei gemeinsamer Logik möglicherweise nicht. Lassen Sie die Reichweite der Prüfungen aus dem betroffenen Verhalten begründen.
Beginnen Sie mit Tests des veränderten Verhaltens.
Erweitern Sie die Prüfung bei gemeinsam genutzten Verträgen
oder wenn gezielte Ergebnisse eine breitere Regression zeigen.
Nennen Sie das durch jeden Check belegte Verhalten.
Kann ein Test nicht laufen, liefern Sie Befehl und Hindernis.
Ein Agent darf eine Suite nicht durch das Abschwächen unbeteiligter Assertions grün machen. Prüfen Sie entfernte Tests und veränderte Erwartungen im Patch mit. Erfolg ist nur aussagekräftig, wenn Tests den vorgesehenen Vertrag weiterhin ausdrücken.
Die Kosten bis zur Abnahme vergleichen
Erfassen Sie Modellnutzung, Werkzeugzeit, Versuche und Maintainer-Prüfzeit pro Fall. Vergleichen Sie den Weg bis zum akzeptierten Patch. Ein günstiger Erstversuch kann nach zwei Reparaturrunden teuer sein; ein teures Modell kann Zeit mit unnötigem Neuentwurf verschwenden.
Beginnen Sie mit kleiner Aufgabenteilung: schwierige dateiübergreifende Reviews zu GPT-6, Routinepatches beim bisherigen Modell. Erweitern Sie nur bei mehr akzeptierten Befunden oder weniger Korrekturarbeit. Übertragen Sie Review-Erfolge nicht ohne separate Tests auf Implementierung, Dokumentation oder visuelle Gestaltung.
Vier Fälle für eigene Coding-Tests
| Fall | Aufgabe | Abnahmeprüfung |
|---|---|---|
| Kleine Änderung | Option zu bestehendem Befehl ergänzen | Ohne Option bleibt die alte Ausgabe gleich |
| Dateiübergreifende Änderung | Gemeinsames Datenfeld ändern | Alle Erzeuger und Verbraucher folgen dem neuen Vertrag |
| Debugging | Reproduzierbaren Fehler untersuchen | Korrektur löst ihn und erhält benachbartes Verhalten |
| Review | Historischen fehlerhaften Patch prüfen | Befunde erkennen echte Defekte ohne Spekulation |
Jeder Kandidat startet von einem sauberen Snapshot mit gleichen Anweisungen, Werkzeugen und Budgets. Erfassen Sie tatsächlichen Patch, Teständerungen, Review-Korrekturen und Zeit bis zur Abnahme. Modellvergleiche finden Sie unter GPT-6 vs. GPT-5.6.
Prompt-Vorlage für Code-Reviews
Prüfen Sie diese Änderung gegen das gewünschte Verhalten: [Ziel].
Verfolgen Sie betroffene Aufrufer, Datenverbraucher und Fehlerpfade.
Liefern Sie je Befund:
- Die konkrete Auslösebedingung
- Das betroffene Verhalten und passende Dateiverweise
- Eine Reproduktion oder einen aufdeckenden Test
Priorisieren Sie umsetzbare Fehler und kennzeichnen Sie Unsicherheit.
Bearbeiten Sie beim Review keine Dateien.
Prompt-Vorlage zur Implementierung
Implementieren Sie [Verhalten] nach den bestehenden Repository-Mustern.
Lesen Sie relevanten Code und Tests vor der Lösungswahl.
Erhalten Sie [Invarianten und Kompatibilitätsanforderungen].
Prüfen Sie [konkreten Nutzerablauf] zusätzlich zu gezielten Tests.
Liefern Sie Änderung, Prüfergebnisse und verbleibende Einschränkungen.
Machen Sie Invarianten konkret: andere Filterauswahl behalten, Befehlsausgabe erhalten oder öffentliches Antwortschema nicht verändern. Das ist besser prüfbar als „Schreiben Sie produktionsreifen Code“.
Wann sich der Wechsel auszahlt
Probieren Sie Astra bei sorgfältigem Denken über mehrere Module oder dominanter Reviewerzeit. Behalten Sie günstigere Modelle für repetitive, leicht prüfbare Änderungen. Generierte Zeilen oder Kommentare sind keine gute Produktivitätsmetrik: Unnötige Änderungen erhöhen den Review-Aufwand.
Für Projekte aus Recherche, Anforderungen und Implementierungsplanung bündeln Sie Auftrag und Materialien in Ottermind. Codeprüfungen bleiben im Repository; ihre Ergebnisse werden mit der übergeordneten Projektentscheidung verbunden.
Häufige Fragen
Ist GPT-6 bei Code-Reviews besser?
CodeRabbits frühe Bewertung zeigte mehr umsetzbare Fehlerfunde, besonders in der schwierigen dateiübergreifenden Teilmenge. Prüfen Sie das an eigenem Code.
Kann bei höherem Punktwert das Review entfallen?
Nein. Die Abdeckung ist unvollständig, und hilfreiche Befunde müssen vor Codeänderungen validiert werden.
Ist Astra bei kleinen Patches immer die beste Wahl?
Die veröffentlichten Daten belegen das nicht. Vergleichen Sie Korrektheit, unnötige Änderungen, Geschwindigkeit und Kosten.
Was zählt neben bestandenen Tests?
Funktionsvertrag, Regressionsrisiko, entfernte Abdeckung, Prüferkorrekturen und Zeit bis zum akzeptierten Patch.
Womit sollten Entwickler anfangen?
Mit den obigen Aufgabenfällen und anschließend dem GPT-6-API-Leitfaden für die Integration.
