AI Fruits: Wie du eine Fruchtfigur baust, die länger als einen Clip hält
AI Fruits sind Früchte mit Gesicht, Stimme und einem Grund zu handeln. Ein Clip ist ein Generierungsproblem, eine Serie ein Kontinuitätsproblem. Fixiere ein Standbild und schreibe eine Aktion pro Clip.
Optional
JPG / PNG / WebP
Das ist das Eingabefeld von Ottermind. Brief und eventuelle Referenz bleiben als Entwurf, bis du sie sendest; der runde Pfeil übergibt die Anfrage zur Prüfung an Studio.
14. November 2026 · 13 Min. Lesezeit
AI fruits sind fruchtförmige Charaktere mit Gesicht, Stimme und einem kleinen Grund, etwas zu tun – gefilmt so kurz, dass man sie auf dem Handy anschaut. Das Format hat in rund achtzehn Monaten Frucht-ASMR, Memes mit Untertiteln, sprechendes Obst und serialisiertes Fruchtdrama durchlaufen, und inzwischen ist es die Art Suche, bei der jedes Ergebnis ein Generator mit Vorlagen ist, die nur darauf warten, verdreht zu werden.
Einen dieser Clips kannst du heute machen. Was du beim ersten Versuch nicht hinbekommst: dass der sechste Clip aussieht wie der erste – gleiche Haut, gleiches Kernmuster, gleiches Gesicht, gleiche Welt. Genau das lassen die Vorlagenseiten weg, und genau darauf ist dieser Leitfaden ausgerichtet. Ein Clip ist ein Generierungsproblem. Eine Episode ist ein Kontinuitätsproblem.
Wie dieser Leitfaden entstanden ist: Die veröffentlichten Seiten wurden am 14. November 2026 geprüft: die Seite „AI Fruit Story“ von Media.io, die AI-fruits-Erklärung von Designkit (erschienen am 13. August 2026) sowie die Seiten Image to Video, Photo to Video und AI Reel Maker von Ottermind. Die Trendgeschichte wird so wiedergegeben, wie diese Seiten sie beschreiben, einschließlich der Daten, die sie Know Your Meme zuschreiben; die von einem Wettbewerber genannten Aufrufzahlen sind Marketingaussagen und werden hier nicht als Tatsache wiederholt. Das ist ein Workflow-Leitfaden, kein Tempo- oder Qualitätsvergleich. Für diesen Artikel wurde kein Video generiert, deshalb wird auch kein Clip als Ergebnis präsentiert. Titelbild und die drei Abbildungen wurden mit einem Modell der Image-2.5-Reihe (GPT Image 2.5) für diesen Artikel erzeugt und sind als Konzeptgrafik gekennzeichnet; der Screenshot des Composers ist eine echte Aufnahme dieser Seite.
Was daraus tatsächlich gebaut wird
Anderthalb Jahre dieses Trends haben eine Handvoll Formate hervorgebracht, die sich sehr unterschiedlich verhalten, sobald du dich auf mehr als einen Post festlegst. Der für die Zeitleiste meistzitierte Text teilt sie in fünf überlappende Phasen: Frucht-ASMR 2025, Früchte mit Gesichtern, die ab etwa Juli 2025 ihresgleichen essen, Frucht-Memes mit Untertiteln im selben August, sprechendes Obst 2025–26 und serialisiertes Fruchtdrama 2026. Derselbe Text beschreibt eine Datingshow-Parodie, deren Cast komplett aus AI fruits besteht und die im März 2026 auf TikTok viral ging – der Moment, in dem das Format aufhörte, ein einzelner Witz zu sein, und anfing, eine Show zu sein.
Diese Geschichte ist aus einem praktischen Grund wichtig: Je weiter du auf der Zeitleiste gehst, desto stärker hängt jeder Clip vom Clip davor ab. Eine Erdbeere, die sich selbst isst, ist eine Fünfzehn-Sekunden-Idee. Eine Frucht mit wiederkehrender Persönlichkeit ist eine Produktionsaufgabe mit Cast, Look und Papierkram.
| Format | Was auf dem Bildschirm passiert | Was den Clip trägt | Aufwand beim Wiederholen |
|---|---|---|---|
| Frucht isst sich selbst | Einer Frucht wird ein Stück ihrer eigenen Art hingehalten, sie beißt zu, reagiert | Der Biss, das Knacken, der unheimliche Kontrast | Gering – eine neue Frucht ist ein neuer Clip |
| Frucht mit Babygesicht | Runde Züge, übergroße Augen, eine übertriebene Reaktion | Niedlichkeit, die mit etwas leicht Falschem zusammenstößt | Gering – bis du dasselbe Babygesicht ein zweites Mal willst |
| Sprechende Frucht | Eine Figur spricht die Kamera mit einer Pointe oder einem Satz an | Timing und eine klare Mundbewegung | Mittel – Stimme und Gesicht müssen zusammenpassen |
| Frucht-ASMR | Schneiden, Schälen, Ausquetschen, der Ton trägt den Clip | Oberflächenstruktur und sauberes Audio | Gering, aber die Zielgruppe ist klein |
| Kurze Fruchtgeschichte | Ein oder zwei Figuren kommen zu einer Pointe oder einer Entscheidung | Ein Konflikt, der sich im Clip auflöst | Mittel – die zweite Figur braucht ein Design |
| Serialisiertes Fruchtdrama | Wiederkehrender Cast, Episoden, unaufgelöste Spannung | Kontinuität von Look, Persönlichkeit und Welt | Hoch – hier scheitern die meisten Versuche |
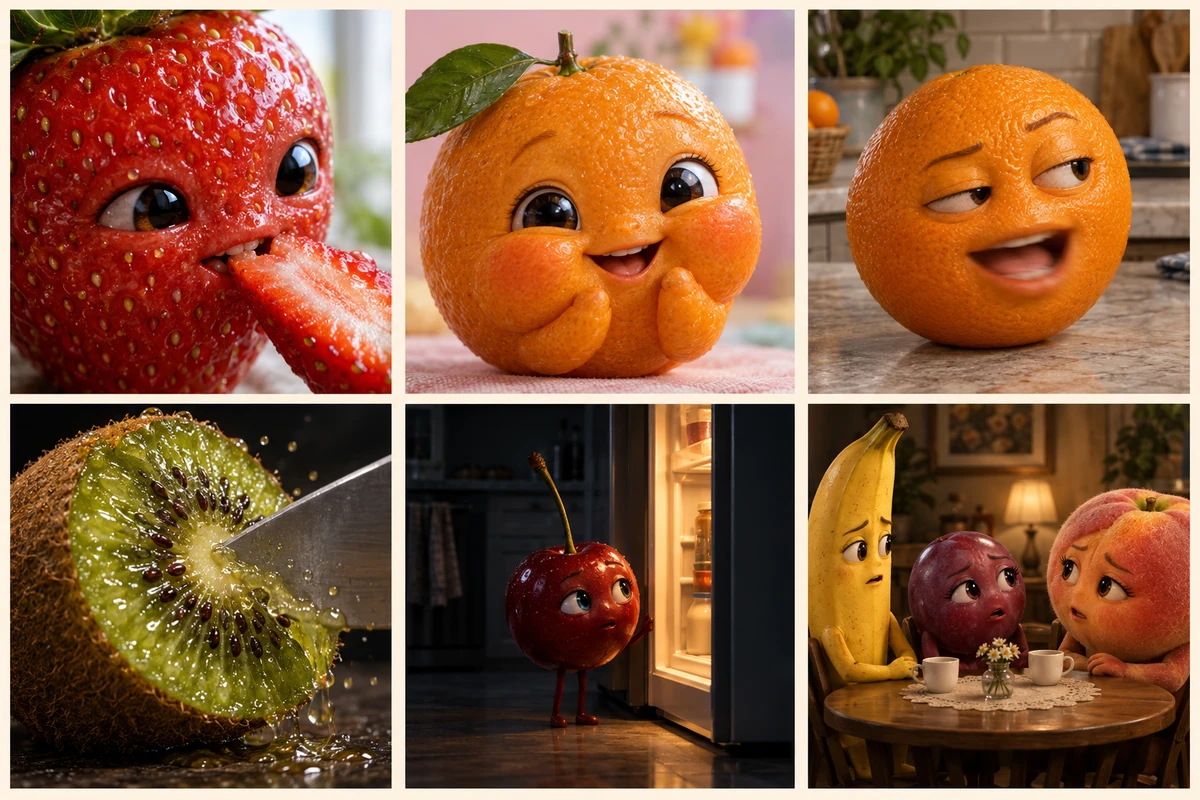
Die sechs Formate in einem Bild: Biss, Babygesicht, sprechender Kopf, ASMR-Schnitt, ein einzelner Handlungsschritt und ein wiederkehrender Cast an einem Tisch. Konzeptgrafik, für diesen Artikel mit einem Modell der Image-2.5-Reihe erzeugt; kein Screenshot, kein veröffentlichtes Beispiel und kein empfohlenes Ergebnis.
Die rechte Spalte solltest du zweimal lesen. Eine Generatorseite verkauft dir gerne die linke Spalte, denn eine Vorlage, die einen lustigen Clip produziert, ist ein vollständiges Produkt. Wenn du eine Serie planst, kaufst du die untere Zeile – und die untere Zeile entscheidet sich danach, was du zwischen den Sessions behältst, nicht danach, welches Modell du wählst.
Warum der sechste Clip wie eine andere Frucht aussieht
Jede Generierung beginnt bei dem Bild oder den Worten, die du ihr gibst. Gib ihr einen Absatz, und sie erfindet die Erdbeere jedes Mal neu: neue Kerndichte, neuer Blattwinkel, neue Augenposition und ein Mund, der unauffällig breiter oder schmaler geworden ist. Einzeln sieht keine dieser Abweichungen nach viel aus. Fünf davon übereinander, und der Cast ist neu besetzt.
Die Lösung ist kein besseres Modell. Es ist eine Referenz, zu der das Modell zurückkehren kann, plus eine schriftliche Anweisung, die festlegt, welche Teile fest sind. Der Leitfaden von Designkit sagt es deutlich, als er für eine wiederkehrende Figur Image to Video statt Text to Video empfiehlt: Ein Referenzbild verbessert die Kontinuität, ohne sie zu garantieren. Dieser Satz ist die ehrliche Grenze, und es lohnt sich, um sie herum zu planen statt gegen sie zu argumentieren.
Drei Gewohnheiten erledigen den Großteil der Arbeit:
- Ein Standbild, viele Clips. Erzeuge ein Charakterbild einmal, prüfe es und verwende dieselbe Datei als visuelle Referenz für jeden Clip in dieser Serie.
- Eine Aktion pro Clip. Zwei Aktionen in einem Briefing sind zwei Gelegenheiten, dass das Gesicht abdriftet, während das Modell beide auflöst.
- Ein schriftlicher Identitätsblock. Ein kurzer Absatz, der in jeden Bewegungs-Prompt kopiert wird und genau benennt, was sich nicht ändern darf: die Röte, das Kernmuster, die Blattkrone, der Augenabstand, die Mundbreite.
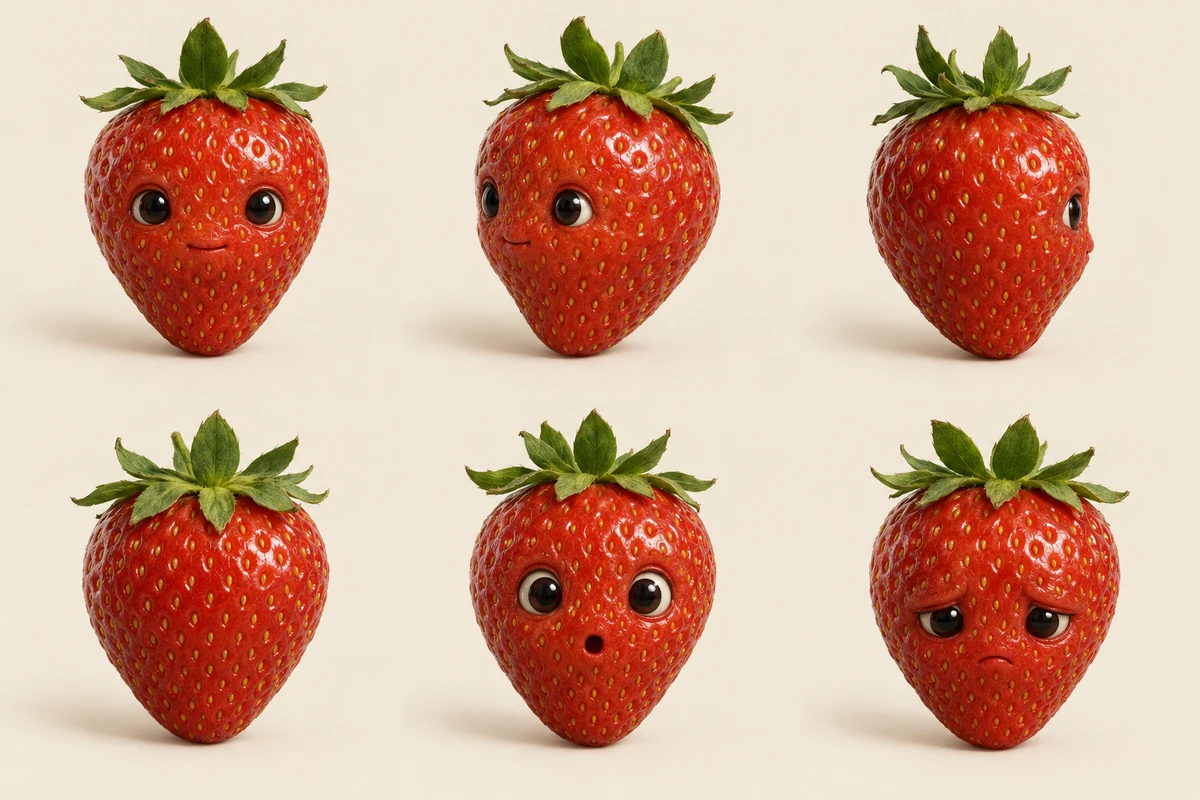
Ein Turnaround ist keine Art Direction, sondern eine Datei, die du behältst. Sechs Ansichten einer Erdbeerfigur, alle auf demselben cremefarbenen Grund, alle im selben Abstand. Jede davon kann die Referenz für einen Clip sein. Konzeptgrafik, für diesen Artikel erzeugt, kein Ottermind-Ergebnis.
Der Aufbau in neun Schritten
Die Reihenfolge unten ist Absicht. Das Briefing kommt vor der Figur, weil du herausfinden solltest, ob die Idee lustig ist, bevor du in einen Cast investierst. Alles nach Schritt zwei existiert, um die Figur aus Schritt zwei zu schützen.
Schritt 1: Schreib einen Clip, keine Staffel
Fang mit einem einzelnen vertikalen Clip an, den du wirklich posten würdest. Benenne das Motiv, die eine Aktion, die Kamera, das Licht und das Ende. Wenn du das Ende nicht in einem Satz beschreiben kannst, hat der Clip noch keins.
Was das steuert: die Aktion, das Kameraverhalten, die Menge an Veränderung, die das Modell auflösen muss, und ob der Clip von selbst enden kann.
Erzeuge einen 8-sekündigen vertikalen Clip. Eine glänzende rote Erdbeere mit kleinen dunklen Augen, die in die Haut eingelassen sind, und einem winzigen geschlossenen Mund sitzt auf einer warmen Holztheke. Eine Hand schiebt ihr einen silbernen Löffel mit einer Scheibe Erdbeere hin. Die Erdbeere lehnt sich vor, nimmt einen kleinen Bissen, kaut zweimal, und ihre Augen weiten sich überrascht. Statische Nahaufnahme auf Augenhöhe, kein Zoom, keine Schnitte. Weiches Morgenlicht von links. Form, Kernmuster und Blattkrone unverändert lassen. Kein Text im Bild, kein Logo.Dieses Briefing füllt den Composer oben auf dieser Seite. Füllen ist nicht Senden: Der Text und eine angehängte Referenz bleiben im Entwurf, bis du den runden Pfeil wählst. Wenn du schon ein Charakterstandbild hast, häng es vor dem Senden an; die Referenz führt die Generierung, statt das Ergebnis auf eine exakte Kopie festzulegen.
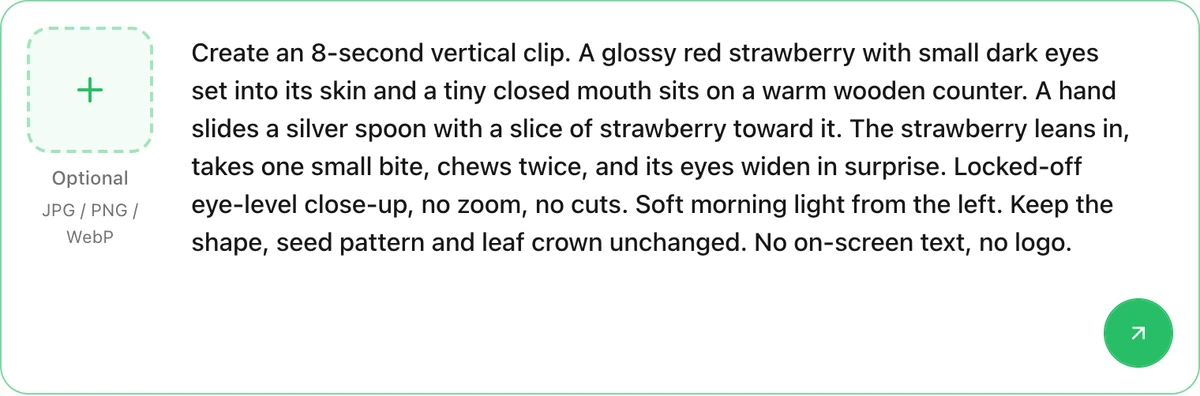
Der Composer dieser Seite nach dem Briefing: Die Referenz-Kachel ist optional, der Text bleibt im Entwurf, und der Pfeil übergibt die Anfrage an Studio. Eine echte Aufnahme dieser Seite, die die Vorbereitung einer Anfrage zeigt – kein generierter Clip.
Schritt 2: Erzeuge das Charakterstandbild, dann hör auf
Wenn die Idee funktioniert, gestalte die Figur richtig und friere sie ein. Verlange eine neutrale Pose vor einem schlichten Hintergrund mit vollständig sichtbarem Gesicht und behalte die Datei. Von diesem Bild hängt jeder spätere Clip ab.
Was das steuert: die Hauttextur, den Gesichtsaufbau, die Lichtrichtung und den Kameraabstand, die alle späteren Clips übernehmen.
Fotorealistisches Standbild einer Erdbeerfigur, ein Motiv, zentriert vor einem warmen cremefarbenen Papierhintergrund. Das Gesicht ist in die Haut integriert: zwei kleine dunkle Augen, leicht in die Oberfläche eingelassen, ein winziger geschlossener Mund, keine Kontur, keine Cartoon-Schattierung, keine Sticker-Ränder. Sichtbares Kernmuster über die ganze Beere, natürlicher Glanz und ein paar Wassertropfen, eine aufrecht stehende grüne Blattkrone. Weiches Fensterlicht von links mit einem sanften Schatten rechts, 50-mm-Objektiv auf Augenhöhe, geringe Schärfentiefe. Die Figur füllt etwa sechzig Prozent der Bildhöhe. Kein Text, keine Requisiten, keine Hände, kein zweites Objekt.Schritt 3: Übersetze die Figur in einen schriftlichen Identitätsblock
Worte sind billiger als Wiederholungen. Öffne das Standbild, liste die fünf Details auf, die einem Fremden auffallen würden, und schreib sie als einen Block, den du an jeden Bewegungs-Prompt anhängst. Nimm nur Dinge in die Liste, die einem Zuschauer auffallen würden, wenn sie sich ändern.
Was das steuert: die festen Details und die Reihenfolge der Prioritäten, der das Modell folgt, wenn die Bewegungsanweisung dagegenzieht.
Halte die Figur genau wie im Referenzbild: dieselbe Beerenform mit breiter Schulter und spitzer Spitze, dasselbe Kernmuster in gleichmäßigen Reihen, dieselbe aufrecht stehende grüne Blattkrone mit fünf Blättern, dieselben zwei kleinen dunklen Augen, leicht in die Haut eingelassen, mit einem Abstand von einer Augenbreite dazwischen, und derselbe schmale geschlossene Mund. Keine Zähne, keine Augenbrauen, keine Haare, keine Kleidung. Den Glanz der Haut und die Lichtrichtung nicht verändern. Wenn die Aktion nicht ohne Veränderung des Gesichts zu Ende gebracht werden kann, halte das Gesicht und vereinfache die Aktion.Der letzte Satz ist der nützliche. Er gibt dem Modell einen Ausweg, der deine Figur bewahrt, statt ihm einen Weg zu geben, die Anweisung durch ein neues Design des Motivs zu erfüllen.
Schritt 4: Eine Aktion pro Clip, in drei Beats
Ein lesbarer Clip hat eine Vorbereitung, eine Aktion und eine Reaktion. Drei Beats passen in einen kurzen vertikalen Clip, fünf nicht. Schreib die Beats als eigene Sätze, damit sich ein schwacher leicht herausschneiden lässt.
Was das steuert: das Tempo, wie viele Dinge das Modell gleichzeitig auflösen muss und ob der Clip wie ein Moment oder wie eine Zusammenfassung wirkt.
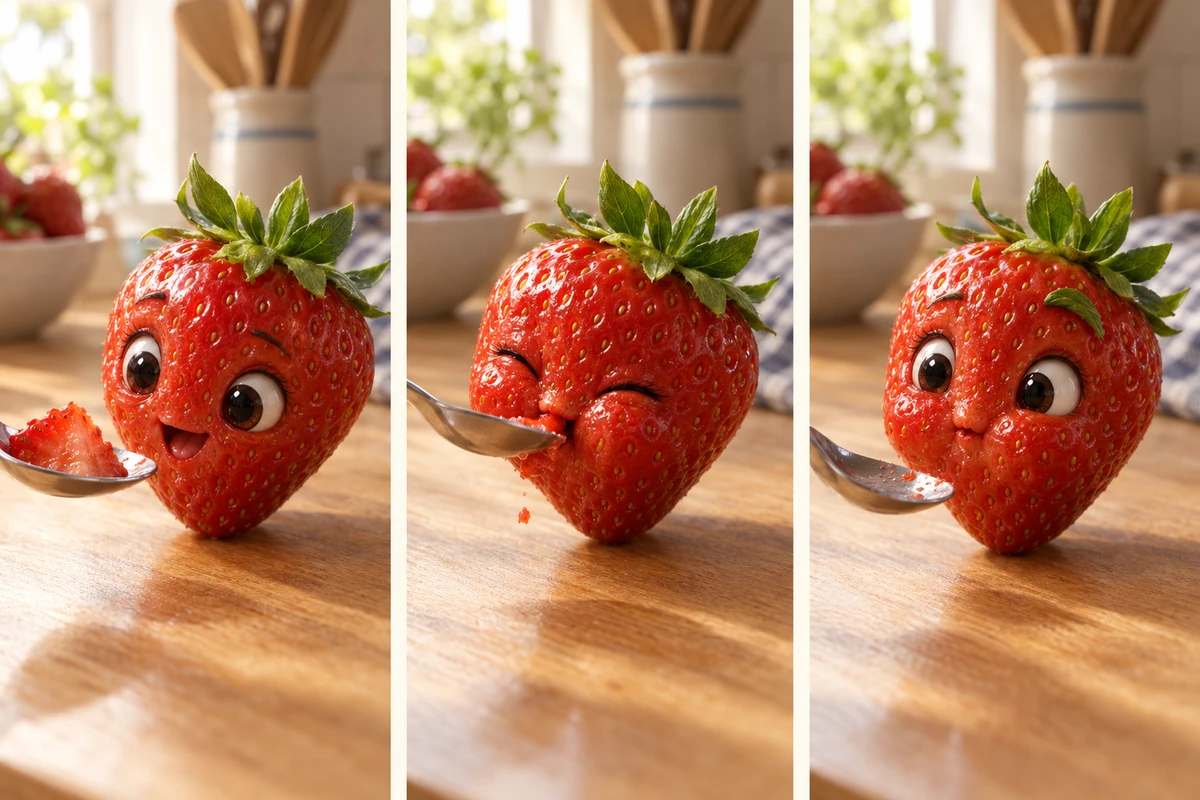
Beat eins, Beat zwei, Beat drei – dieselbe Figur, dieselbe Theke, dieselbe Optik. Als drei Sätze geschrieben ist das ein Prompt. Als ein Satz geschrieben sind es drei konkurrierende Anweisungen. Konzeptgrafik, für diesen Artikel erzeugt.
Beat 1, Vorbereitung: Die Erdbeere lehnt sich zum Löffel, Augen weit offen, Mund leicht geöffnet. Beat 2, Aktion: Sie nimmt einen kleinen Bissen, Augen fest geschlossen, ein einziges Krümelchen fällt. Beat 3, Reaktion: Sie kaut zweimal und öffnet die Augen sehr weit, ein Blatt hebt sich, als wäre sie überrascht. Durchgehende Einstellung, keine Schnitte zwischen den Beats, jeder Beat etwa zwei Sekunden. Beerenform, Kernmuster und Blattkrone unverändert lassen. Die Kante der Theke bleibt durchgehend an derselben Stelle im Bild.Schritt 5: Gib dem Clip ein Ende, auf das du schneiden kannst
Die meisten generierten Clips verlaufen im Sande, weil im Briefing nirgends stand, wie das letzte Bild aussehen soll. Benenne das Schlussbild. Es ist auch das Bild, das du als Vorschaubild nimmst, und in einer Serie das Bild, an dem der nächste Clip ansetzt.
Was das steuert: das letzte Bild, den Schnittpunkt und die Übergabe in die nächste Episode.
Die Erdbeere kaut zu Ende, schluckt, blickt direkt in die Linse und blinzelt einmal. Halte diesen Blick eine Sekunde, dann endet der Clip. In der letzten Sekunde ist der Löffel nicht mehr im Bild. Dieselbe Haut, dasselbe Kernmuster, dieselben Augen und dieselbe Blattkrone wie im Referenzbild, und Kamera und Licht unverändert gegenüber dem ersten Beat.Schritt 6: Wenn die Frucht spricht, schreib die Zeile vor den Mund
Sprechendes Obst scheitert auf eine sehr bestimmte Weise: Der Mund bewegt sich wie bei einer Puppe, weil es keine Zeile und kein Timing gab, an dem er sich orientieren konnte. Schreib den Satz und beschreibe dann, wie der Mund ihn durchläuft. Halte die Zeilen kurz genug, um sie in der verfügbaren Zeit zu lesen.
Was das steuert: die Länge des Dialogs, das Mundverhalten und ob die Darbietung als Sprache statt als Bewegung gelesen wird.
Die Erdbeere blickt leicht links an der Linse vorbei und sagt eine kurze Zeile: „Du hast ein Stück von mir mitgebracht, zu deinem Picknick.“ Mundbewegung: am Anfang geschlossen, öffnet sich einmal bei „mitgebracht“, schließt sich am Komma, öffnet sich wieder bei „Picknick“ und geht dann in ein kleines geschlossenes Lächeln über. Setze ein einzelnes angehobenes Blatt als Punkt am Ende. Keine eingebrannten Untertitel im Bild. Gesicht, Augen und Hauttextur exakt wie im Referenzbild.Zehn Wörter, zwei Mundbewegungen, ein Ausdruckswechsel am Ende. Das ist eine Einstellung, die du prüfen kannst. Ein Absatz Dialog in denselben acht Sekunden ist eine Einstellung, die du neu machen wirst.
Schritt 7: Baue Episode zwei aus demselben Standbild
Beim zweiten Clip entscheidet sich, ob eine Serie existiert oder unbemerkt neu anfängt. Verwende die Referenz weiter, eröffne mit einem Bild, das an das letzte anschließt, und ändere nur eine Variable: eine neue Requisite, eine neue Figur, ein neuer Raum. Wenn zwei Dinge gleichzeitig wechseln, liest das Publikum es als andere Show.
Was das steuert: die Kontinuität von Figur und Welt und die Menge an Neuheit, die du einem Publikum zumutest.
Setze dieselbe Erdbeerfigur in einem zweiten 8-sekündigen Clip fort. Beginne mit dem leeren Löffel auf derselben Holztheke, die Erdbeere in derselben Position wie im letzten Bild des vorigen Clips. Eine kleine Heidelbeerfigur rollt langsam von rechts ins Bild und bleibt neben ihr stehen. Die Erdbeere dreht die Augen, nicht den Körper, um nach unten zu schauen, und blickt dann mit flachem Ausdruck zurück in die Linse. Kamera und Licht unverändert. Gesicht, Kernmuster und Blattkrone der Erdbeere identisch zum Referenzbild. Die Heidelbeere ist rund, tiefblau mit mattem Reif, zwei kleine Augen und kein Mund.Schritt 8: Schreib Caption und Kennzeichnung im selben Durchgang
Die Caption gehört zum Format, sie ist kein Nachgedanke: Hier wird der Witz zu Ende gebracht, und hier erfährt das Publikum, was es anschaut. Mach das in einem Textassistenten oder in Studio, und beschränke die Kennzeichnung auf einen schlichten Satz statt auf einen Absatz voller Fachjargon.
Was das steuert: den Text, der mit dem Clip geht, die Antwort, die du einlädst, und ob der Hinweis auf synthetische Medien da ist, bevor jemand danach fragt.
Schreibe drei Caption-Varianten für einen vertikalen Clip, in dem eine Erdbeerfigur in eine Erdbeere beißt und überrascht schaut. Jede Variante unter 90 Zeichen, in den ersten beiden keine Hashtags, und die dritte endet mit einer Frage, die eine Antwort einlädt. Schreib dann eine Zeile in einfacher Sprache, unter 100 Zeichen, die offenlegt, dass der Clip mit KI erzeugt wurde – ohne Fachbegriffe und ohne Entschuldigung.Schritt 9: Prüf gegen das Standbild, nicht gegen deine Erinnerung
Leg den neuen Clip neben das Charakterstandbild und prüfe vier Dinge in dieser Reihenfolge: das Gesicht, die Haut, das Licht und das Ende. Prüf dann das Bild, das du als Cover veröffentlichen willst – oft das hässlichste Bild im Clip. Wenn das Gesicht abgedriftet ist, generiere aus derselben Referenz neu, statt den Prompt zu bearbeiten, bis es ungefähr passt.
Typische Fehler und die Lösung, die wirklich funktioniert
| Symptom | Woran es meistens lag | Die Lösung |
|---|---|---|
| Das Gesicht verändert zwischen Clips seine Form | Eine neue Generierung aus Text, ohne angehängtes Standbild | Dasselbe Standbild anhängen und den Identitätsblock wiederholen |
| Die Frucht wirkt wie ein Sticker auf einem Foto | Formulierungen wie „süßer Cartoon“ oder „kawaii“, oder ein Gesicht, das als Overlay beschrieben wird | Ein Gesicht verlangen, das in die Haut eingelassen ist, fotorealistische Textur, keine Kontur, keine Sticker-Ränder |
| In acht Sekunden passiert nicht viel | Drei Aktionen in einem Briefing, jede nur halb aufgelöst | Auf eine Aktion mit drei Beats kürzen und neu generieren |
| Der Clip hat kein Ende | Das Briefing hat das Schlussbild nie benannt | Das letzte Bild benennen und eine Sekunde halten |
| Hände verschmelzen oder der Löffel verbiegt sich | Schnelle Bewegung plus Hände plus eine reflektierende Requisite | Die Hand entfernen, die Requisite ruhig halten oder die Aktion verkürzen |
| Die Stimme passt nicht zum Mund | Es gab keine geschriebene Zeile; das Modell hat die Bewegung improvisiert | Die Zeile schreiben und dann Anfang, Mitte und Ende der Mundbewegung beschreiben |
| Jeder Clip sieht aus wie dasselbe virale Video | Du hast mit einer Vorlage angefangen statt mit einer Figur | Eine strukturelle Variable ändern: die Art, den Maßstab oder die Welt, in der sie lebt |
| Der Ton wirkt angeschraubt | Der Clip wurde stumm generiert, die Musik kam erst danach dazu | Den Ton mit der Aktion planen: Biss, Kauen, Schlucken, dann Stille vor der Zeile |
| Eine Plattform drosselt oder markiert den Post | Der Hinweis auf synthetische Medien fehlte oder war versteckt | Die Kennzeichnung in die ersten Zeilen der Caption setzen und die aktuellen Regeln der Plattform befolgen |
Zwei davon sind mehr wert als alle anderen. Das Sticker-Problem ist ein Formulierungsproblem und mit einer Zeile Prompt behoben. Das Problem mit dem fehlenden Ende ist ein Planungsproblem und behoben, bevor du überhaupt ein Tool öffnest.
Wo Ottermind in den Aufbau passt
Ottermind ist ein vernünftiger Ort für die Schritte zwei bis sieben, weil der Workflow Referenz und schriftliche Regie zusammenhält, statt dich bei jeder Revision wieder bei einem leeren Prompt beginnen zu lassen.
- Das Standbild machen: Die KI-Bildgenerierung erzeugt das Charakterbild, das du weiterverwendest. Erzeuge zwei oder drei Kandidaten, wähle einen und behalte ihn.
- Dieses Standbild animieren: Image to Video nimmt ein Referenzbild plus eine Beschreibung von Bewegung, Kameraverhalten, Tempo und Zielbild und lässt dich dann jeden Take prüfen und neu rendern. Das ist der Weg für eine Serie, weil das Standbild das ist, was fest bleibt.
- Stattdessen von einem Foto starten: Wenn du eine echte Frucht selbst fotografiert hast, startet Photo to Video mit diesem Foto statt mit einer generierten Figur. Gleiches Bewegungsbriefing, andere Quelle.
- Die Episode zusammensetzen: AI Reel Maker ist die Übergabe an eine mehrszenige Social-Sequenz – das, was aus einer Geschichte mit drei Clips wird, sobald die Clips zusammenhalten.
Was dieser Weg nicht leistet: irgendetwas garantieren. Ein Referenzbild verbessert die Kontinuität und legt sie nicht fest – rechne damit, einige Takes neu zu generieren. Clip-Länge, Auflösung und etwaige Credit-Kosten hängen von deinem Konto und dem in Studio gewählten Modell im Moment der Generierung ab, nicht von diesem Artikel. Die Rechte musst du selbst prüfen: Verwende ein Foto, das du gemacht hast oder für das du eine Lizenz hast, baue keine Figur um die Show von jemand anderem und kennzeichne synthetische Medien dort, wo das Ziel es verlangt. Nichts davon ist Rechtsberatung, und nichts davon ist ein Versprechen auf Reichweite.
Was du als Nächstes tun kannst
Nimm die Zeile der Format-Tabelle, die zu dem Clip passt, den du diese Woche fertig bekommst, und baue dann die kleinste ehrliche Version davon.
- Du willst eine Serie: Mach zuerst das Standbild und leg dich dann auf eine Aktion pro Clip fest. Lies Image to Video Prompting für das Bewegungsvokabular, mit dem das Briefing konkret wird.
- Du willst Disziplin in der Kurzvideo-Produktion: Der Faceless-Reels-Leitfaden behandelt dasselbe Problem von der anderen Seite – wie du ein wiederholbares Kurzvideo ohne Person vor der Kamera baust.
- Du willst den Übergang zwischen zwei Clips: Morphing ist das Format, um eines in ein anderes zu verwandeln – genau das, was ein Episodenbruch oft braucht.
- Du willst einen Figurenstil, der auf kleinen Displays überlebt: Chibi-Stil ist das nützliche Gegengewicht zum Fotorealismus, wenn das Gesicht in Vorschaubild-Größe lesbar sein muss.
- Du willst Kontrolle Bild für Bild: Tweening erklärt, was zwischen zwei Bildern passiert – genau der Moment, in dem eine Fruchtfigur aufhört, wie sie selbst auszusehen.
Ein AI-fruits-Video ist ein Entwurf mit Gesicht. Das Gesicht ist der Teil, der dir gehört, und der Teil, den es zu schützen lohnt.
AI fruits FAQ
Brauche ich einen Generator speziell für Früchte?
Nein. Ein eigener AI-fruits-Generator ist praktisch, weil er Vorlagen für Formate mitliefert, die schon funktionieren, und das ist ein legitimer Grund, einen zu nutzen. Ein allgemeiner Bild- und Video-Workflow ist die bessere Wahl, wenn du eine eigene Figur willst, einen konsistenten Look über alle Clips hinweg oder eine Serie, die nicht wie eine Variante einer Vorlage wirkt.
Text to Video oder Image to Video?
Text to Video für einen einmaligen Clip, bei dem die Figur jedes Mal anders sein darf. Image to Video, sobald ein Gesicht, eine Textur oder ein Accessoire über mehrere Clips hinweg tragen muss. Die Referenz verengt die Bandbreite der Ergebnisse, sie legt sie nicht fest.
Wie lang sollte ein AI-fruits-Clip sein?
Kurz genug, dass eine Aktion ihn füllt. Das Format wird meist im Bereich von zehn bis dreißig Sekunden beschrieben, und die praktische Grenze ist nicht das Plattformlimit, sondern die Zahl der Beats, denen ein Zuschauer folgen kann, bevor der Clip enden muss.
Muss ich sagen, dass das Video mit KI erzeugt wurde?
Die Regeln unterscheiden sich je nach Plattform, Markt und Thema – prüf also die aktuellen Regeln der Zielplattform, statt dich auf eine Zusammenfassung zu verlassen. In der Praxis kostet eine Zeile in einfacher Sprache in der Caption nichts und nimmt einem Zuschauer einen offensichtlichen Grund, dem Post zu misstrauen.
Kann ich diese Clips verkaufen oder monetarisieren?
Das hängt von den Bedingungen der Tools ab, vom Ausgangsmaterial, das du verwendet hast, und von der Plattform, auf der du veröffentlichst. Lies die kommerziellen Bedingungen des Modells und der Plattform, bevor du ein Geschäft auf eine Figur baust, und geh nicht davon aus, dass dir das Generieren eines Bildes Rechte an einer wiedererkennbaren Figur gibt, die jemand anderem gehört.
