提示词指南
ChatGPT 能做视频吗:它做完哪一段,剩下的交给谁渲染
聊天负责写镜头,渲染得交给另一件工具。把下面这段运动描述粘进去,再附上它描述的那张静帧,就是本页要讲的那次交接——对话里并不需要视频模型。
可选
JPG / PNG / WebP
这是 Ottermind 自己的输入框。填入描述和发送是两个动作,不继续进入 Studio 就不会生成任何视频。
2026年11月14日 · 11 分钟阅读
自己做不到,接上别的东西就能做到。 ChatGPT 能写脚本、写镜头表、写运动描述,也能生成一个镜头起始的那张静帧。它做不到的,是在没有别的工具接上的情况下渲染出一个能播放的视频文件——截至 2026 年 11 月 14 日,对话里没有官方自带的视频模型:OpenAI 的 Sora 网页版和 App 已于 2026 年 4 月 26 日停运,Sora API 随后在 2026 年 9 月 24 日关闭。
ChatGPT 图像功能也在逐步开放循环 GIF。若你的账号已支持,可以直接在对话中让静图动起来。要输出 MP4 等视频文件,仍需使用视频生成工具。 (OpenAI Help Center)
这一个事实把整件事重新排了一遍。有用的问题不是「ChatGPT 能不能做视频」,而是「视频里哪一部分由 ChatGPT 做完,剩下的交给谁渲染」。人之所以卡住,通常是因为在一个文本框里要一条成片,或者把一句想法扔进生成器,指望那些还没做的决定自己补上。这两种失败都出在交接上,不在模型身上。
本文的资料说明: OpenAI 帮助中心的《关于 Sora 停运需要知道的事》(2026 年 11 月 6 日更新)和《ChatGPT 中的插件》(2026 年 10 月下旬更新),于 2026 年 11 月 14 日读取,用于核对日期,以及插件的安装和付费方式。Pika 发布于 2026 年 10 月 16 日的插件公告,以及 Runway 在 OpenAI 站点上的插件条目,于同日读取。本文由 Ottermind 发布,下文流程里用到的渲染器也由 Ottermind 提供。封面、桌面那张场景图和三帧横图都是用 GPT Image 2.5 Flare 为本文生成的;它们是插图和一个示例素材,不是任何渲染器的输出,也不是 ChatGPT 的截图。本页顶部的输入框是真的,可以直接用。
你搜到的答案,大多已经过期
搜这个问题,仍然会撞见一些页面,把 ChatGPT 描述成一个能直接做视频的对话,或者把「ChatGPT 视频生成器」当成一个产品来列。它们大多写于 Sora 还在的时候,或者写于某个自定义 GPT 顶替它的时候。日期值得记一下,因为它决定了哪些说法今天还能照做:
| 日期 | 结束的是什么 | 对你意味着什么 |
|---|---|---|
| 2026 年 4 月 26 日 | Sora 网页版和 App | 独立入口没了;已有内容可以从 sora.chatgpt.com/sunset 导出 |
| 2026 年 9 月 24 日 | Sora API | 通过 API 也不会再有新的 Sora 渲染 |
| 2026 年 10 月 | 插件目录还在扩张 | 现在 ChatGPT 里的「视频」,指的是从对话里调用某家厂商的渲染器 |
OpenAI 的停运说明里还提到,已购买的 ChatGPT 或 Sora 积分仍然可以用于 Codex。截至 2026 年 11 月 14 日,OpenAI 的帮助页面里没有任何一处把视频模型写成 ChatGPT 自带的能力,所以看到承诺这一点的页面,先当成需要你在自己账号里核实的东西。
「做个视频」背后是四件不同的事
这句话至少盖住四件事,输入、成本和失败方式各不相同。动笔之前先选中一件,因为只有其中一件是从一张照片开始的。
| 你想要的视频 | ChatGPT 单独能做的 | 谁来渲染文件 | 坑在哪 |
|---|---|---|---|
| 从一个想法或一张静帧做成短片——一个镜头 | 写描述、写连续性要点、写时间安排 | 文生视频或图生视频渲染器,在插件里或在对话外 | 难的是运动,而描述运动的词不是人平时用的词 |
| 一个说话的主播或数字人 | 写脚本和口播提示 | 数字人工具,通常要开厂商的付费账号 | 脸是厂商授权的,套餐决定你能用多少分钟 |
| 从笔记、PDF 或文档做讲解片 | 把素材拆成幻灯片、旁白和解说图规划 | 一个插件或一家讲解视频服务 | 你拿到的是排好的幻灯片,不是实拍素材;画面里不会有人出镜 |
| 剪辑你手上已经拍好的素材 | 写剪辑清单和字幕 | 一个剪辑器,通常是能接受对话指令的那种 | 材料得先存在,对话才帮得上忙 |
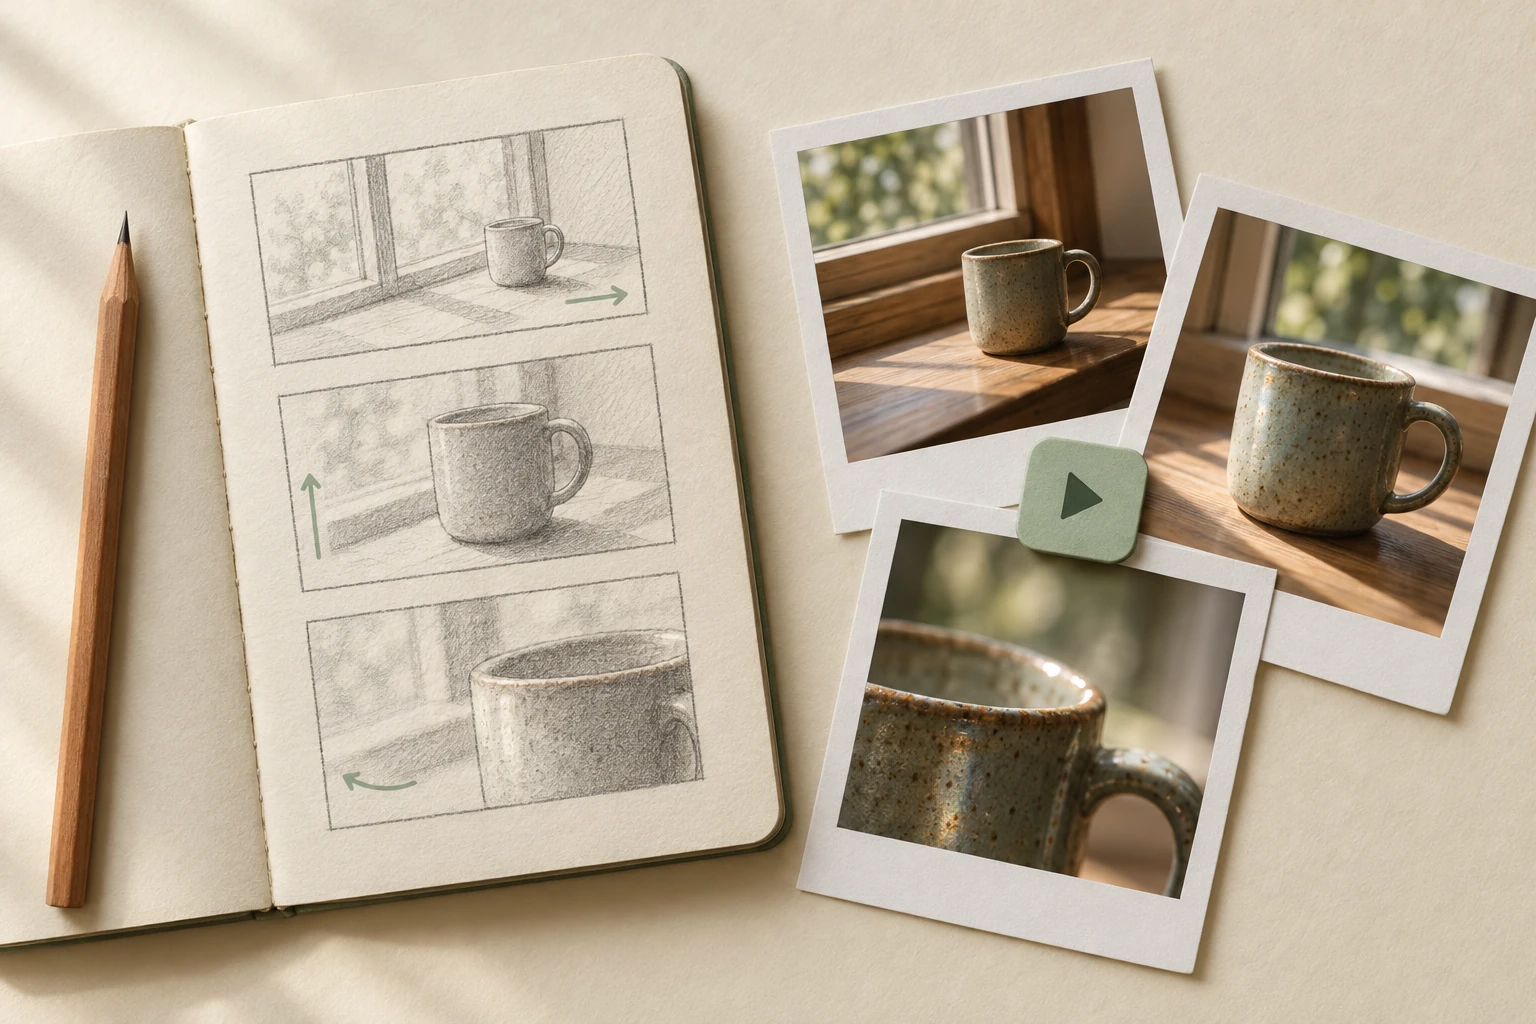
一张照片里的三件事:左边是写下来的,右边是拍出来的。笔记本是对话能填的那部分——景别、运动、什么不许变。照片是得由别的东西产出的那部分。本文的 AI 生成插图,不是截图,也不是渲染结果。
大多数人问这个问题,指的是第一行:一个短镜头,常常从一张产品图或一张人像开始。这一行也正好是交接最容易做对的一行,因为图生视频渲染器要的,恰好就是对话最擅长产出的两样东西——一张静帧和一段写好的描述。
在这件事上,对话真正擅长什么
写描述不是什么安慰奖。大多数烂片就是在这一步定下来的;模型面前摆着你的素材时,有四件事它做得不错:
- 点名什么不许变。「把手留在右边、釉面不变、咖啡液面不变」这句话,你自己多半会忘记写,而正是这句话拦住了产品慢慢变形。
- 把一个想法拆成节拍。 一个六秒镜头,一个动作加一次运镜,能活;一个六秒镜头塞三个动作,活不了——而对话在你要求短版本之前,两种都乐意写。
- 算时间。 二十秒旁白,按自然语速大约是 45 到 55 个口语词。对话可以一边改写一边把这个数守住。
- 让描述可以搬走。 同一段话,下周换一个渲染器也得能用。对话能把它压短,同时不丢掉身份锁定。
它也能做那张静帧。ChatGPT 的图像生成是官方自带的能力——见 Images 2.5 改了什么——所以手里没有照片的读者,可以在同一个对话里生成一张参考帧,再把那张帧交给渲染器。这条链确实有用,本指南搭的就是它。
对话做不到的一件事,是看你的渲染结果。它不会盯着这条片子告诉你哪一帧坏了;你得把错在哪说清楚。下面每一段提示词都是按这个前提写的:你汇报,它改写。
提示词不是镜头描述
「给我的产品做个视频」失败的原因很无聊:它把八个决定留给渲染器,渲染器就把这八个决定全在看不见的地方做完了。镜头描述会按一个固定的顺序把它们定下来,而顺序比措辞更重要。
| 栏位 | 它定下什么 | 跳过它会怎样 |
|---|---|---|
| 素材 | 这一帧是你给的静帧,还是从文字里编出来的场景 | 渲染器编出一个不是你的产品 |
| 身份锁定 | 必须活下来的那两三个细节——标签、把手在哪一侧、咖啡液面 | 图生视频最常见的失败:主体悄悄换了 |
| 动作 | 画面里唯一的那一个动作 | 几个小动作互相抢戏,片子看起来发飘 |
| 相机 | 推、拉、摇、环绕、固定,以及幅度多大 | 镜头动得太快看不清,或者根本不动 |
| 光线 | 方向、质感,以及它变不变 | 情绪在两条片子之间漂移,越拍越对不上 |
| 时间 | 时长,以及开头和结尾各发生什么 | 最后一帧不能用,这条片子就没法剪 |
| 画幅 | 比例,以及什么必须留在安全区内 | 把手或字幕在投放平台上被裁掉 |
下面八段描述,每段只控制一件事,所以两条片子之间的差异可以追到某一句话上。八段用的是同一个主体——木窗台上的一只斑点炻器马克杯——因为主体固定,两次尝试才比得了。
1. 运动描述:一个素材,一次运动
把这张照片——木窗台上的斑点炻器马克杯——做成四秒的动态镜头。杯子保持照片里的样子:同样的轮廓、同样的釉面斑点、把手在右侧、杯里的咖啡液面高度不变。加一层热气,从杯口慢慢升起,略微向左飘。四秒内镜头向前推大约百分之十——不横移、不环绕、不拉远。窗光保持柔和偏冷;不偏色、不换背景、不添加物体、不出现手、不出现文字、不出现标识。这一段同时管住了动作和身份锁定。判断方法是冻住第一帧和最后一帧:两只杯子应该是同一只,变的只有距离。
2. 只动相机:画面里什么都不动
同一张图,同一个时刻:只有相机在动。从整个窗台开始,杯子略偏画面中心右侧;然后用四秒向左、略向下移动,像一位摄影师探身去看那只杯子,结束时杯子落在画面左三分之一。杯子不动,热气的节奏不变,窗台上树枝影子的形状也不变。不缩放,不拉焦,不出现文字。这一段只管相机行为。如果按第一段拍出来的片子跑偏了,再跑第二段,就能判断问题出在相机还是主体。
3. 三个节拍,一个主体
为一段六秒的短片写一个三节拍分镜:早上九点,木窗台上的一只斑点炻器马克杯。节拍 1,0 到 2 秒:全景,杯子静止,热气刚刚起来,窗光冷淡而平。节拍 2,2 到 4 秒:同样的构图,热气升起,晨光从左侧进来,把釉面照暖。节拍 3,4 到 6 秒:同一只杯子更近的视角,热气卷曲,一道柔和的树影扫过窗台。每个节拍都给出景别、什么在动、什么必须保持一致,以及一句我能直接粘进图生视频工具的运动指令。杯子的形状、釉面、把手在哪一侧和咖啡液面,在三个节拍里必须完全一致。这一段管的是跨镜头的连续性。检查点在于第三个节拍里把手是不是还在同一侧——如果渲染器换了边,要在描述里修,不是在渲染结果里修。
4. 装得进时长的镜头表
把这个想法做成一条十五秒竖版产品片的镜头表,输出一张五列的 markdown 表格:镜号、时长(秒)、景别、发生了什么、锁定了什么。主体还是木窗台上那只斑点炻器马克杯,光线从清冷的早晨过渡到温暖的日光,竖版画面必须始终让把手和咖啡液面留在画内。五个镜头,时长加起来正好十五秒,每个镜头不短于两秒。表格之后,列出渲染器最可能弄坏的三处细节,以及我该往每个镜头里加的那句话,用来保住它们。这一段管时间预算,顺手把护栏也产出来。镜头表加起来正好 15 秒,区别在于你拿到的是能配乐剪出来的片子,还是一堆用不上的散帧。
5. 配得上剪辑的旁白
为杯子这条片子写一段十五秒的旁白,不超过三十八个口语词,这样按自然语速放得下。把它分到上面表格里的五个镜头上,每一句给出起始秒数和词数。声音:平静、具体,不用形容品质的形容词,不用感叹号。然后把同一份稿子做成屏幕字幕卡,每张不超过六个词;再告诉我,如果渲染回来短了一秒,先删哪一句。这一段管节奏,同时给你一个退路。删句顺序要明确说,不然你会在赶时间的剪辑里删错那一句。
6. 给失败片子的返修描述
上一版片子的错误是:杯子的把手跑到了左侧,热气变成一道实心的白条,推镜过头,到第四秒杯口被裁出了画面。我原来的描述里写的是「杯子保持照片里的样子」「热气慢慢上升」「向前推大约百分之十」。重写这段描述,让每处错误都有自己的一句话来回应,不要加任何新指令。修正按这个顺序放:身份锁定、热气行为、相机距离。然后告诉我,如果下一条只能修三处中的一处,先改哪一句。这一段管的是返修卫生:一个错误,一句话,不许夹带新想法。修前三处的时候又塞进第四条指令,正是片子一边变糟、一边看起来更详细的原因。
7. 可以搬走的段落
把已经通过的杯子描述改写成一段话,让另一个视频生成器在没有原始对话的情况下也能读懂。它必须按这个顺序说明:素材图是什么、什么不许变、那一个动作、相机怎么动、光线、时长、画幅比例,以及什么不许出现。不写工具名,不超过一百一十个词。然后输出一个六十词的版本,仍然保住身份锁定和那个动作。这一段管的就是交接本身,也是本页最有用的一段提示词。只活在一个对话里的描述,没法复用、没法比较,也没法搬到一个更适合这个镜头的渲染器上。
8. 从一个通过的镜头做画幅变体
从已通过的宽屏杯子描述出发,做两个变体:一个 9:16 竖版,用于社交平台发布;一个 1:1 方版,用于信息流。每个变体只重述变化的部分——构图、杯子在画面里的位置、留多少顶部空间、相机向前推多少。光线、热气和身份锁定与宽屏版保持一致。不要改时长。这一段管输出形状。只重述差异,才不会让一个镜头的三个版本变成三个互不相干的镜头。
按钮会把第一段描述填进本页顶部的输入框。它只负责填,发送是另一个动作;在你到 Studio 里继续之前,什么都不会生成。
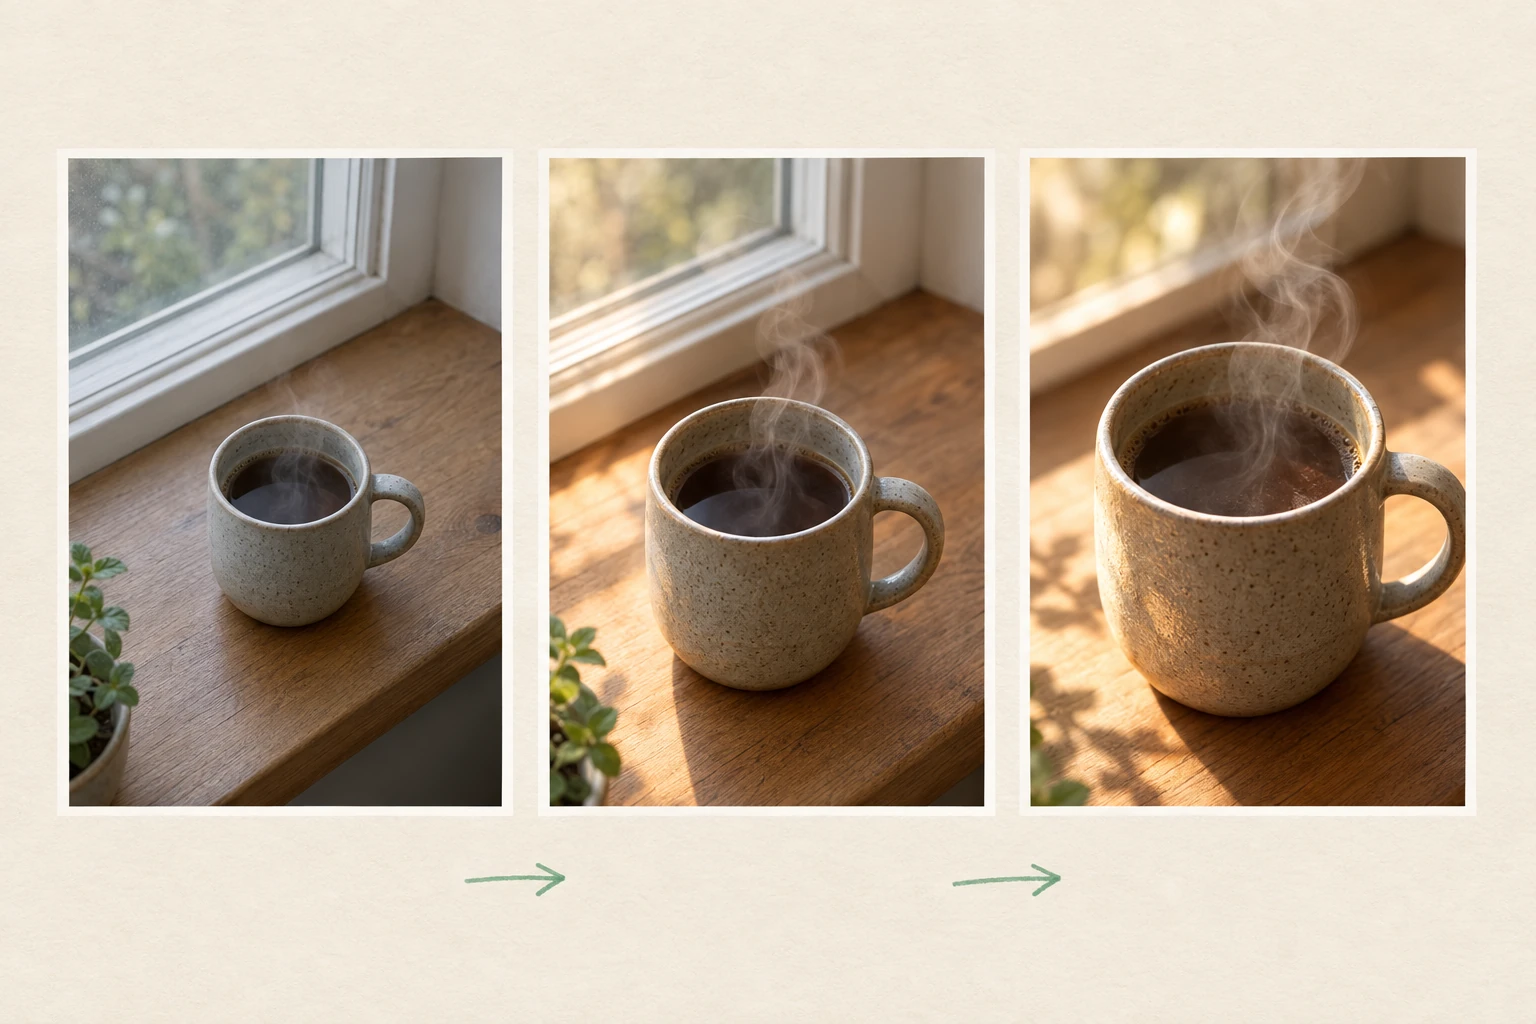
一个站得住的镜头:宽而冷,然后阳光进来变暖,然后更近,杯子还是那只。三帧,一个主体,一个运镜方向。本文的 AI 生成插图;这几帧展示的是一段描述应该保住什么,不是某个渲染器的实际输出。
哪里会出错
九种失败,基本盖住了大多数人会怪到模型头上的烂片。其中七种是描述本身的错误,这算好消息:描述一分钟就能改。
| 你看到的 | 为什么会这样 | 怎么修 |
|---|---|---|
| 产品悄悄变了——把手在哪侧、标签、比例 | 身份锁定只在心里想过,没写成字 | 点名两三个细节,并在每条片子的描述里重复它们 |
| 热气、烟或头发变成一道实心的条 | 描述写的是结果,不是行为 | 描述运动的曲线:慢慢升起、向左卷、靠近顶部时变薄 |
| 相机冲过头,把主体裁掉了 | 「向前推」没有距离,也没有结束位置 | 给一个百分比和一个终点:大约百分之十,杯子落在左三分之一 |
| 几样东西同时动,一样都看不清 | 一句话里要了两个动作 | 一个镜头一个动作;其余的挪到下一个镜头 |
| 片子看着还行,但最后一帧没法用 | 没人写结尾发生什么 | 明确写出结束帧,并在那里停半秒 |
| 画面里冒出文字——价格、单词、水印 | 描述留了空白,而文字在对话别处出现过 | 加上「不出现文字、不出现标识、不出现水印」,屏幕上的字样留到剪辑时再加 |
| 竖版导出把脸或把手切掉了 | 比例是渲染之后才定的 | 写描述之前先定画幅,并让主体待在中段 |
| 拿一个普通的视频生成器,指望出个说话的人 | 这件事属于表格里另外三行之一 | 走数字人或讲解视频那条路,并把账号成本算进去 |
| 对话在描述步骤,而不是给出文件 | 对话上没有挂任何渲染器 | 装一个插件,或者把描述拿到图生视频工具里去——见下文 |
第九行才是让人以为自己操作错了的那一行。他们没做错:一段纯文字对话,在装上或打开某个东西之前,是没有渲染器的。OpenAI 的插件帮助页也写明,安装或使用单个插件取决于你的套餐、工作区、角色和地区,所以你读到的那个插件,在你的账号里可能根本不可用。
这几条路都别指望的东西
- 没有固定的生成时间。 插件也好,渲染器也好,都不承诺一条片子在多少秒内完成。
- 没有固定的输出规格。 时长、分辨率和音频支持,取决于你用的工具;如果是插件,还取决于厂商自己的服务。
- 没有能靠二手信息算出来的积分。 插件通过厂商的账号和积分渲染——比如 Pika 自己的公告就把插件生成绑定在 Pika 积分上——所以成本属于那家厂商当前的定价,不属于 ChatGPT。
- 没有权利上的捷径。 生成出来的片子不等于产品、脸、标识或音乐的授权。发布之前分开去核对。
- 没有代替你看一遍的办法。 总得有人把片子播一遍,检查产品、边缘、最后一帧和声音。
从描述到渲染出来的片子
描述有了之后,选渲染器就是一个选工具的决定,Ottermind 的两条路覆盖了常见的情况:
- Image to Video ——你上传一张参考图,描述运动、镜头感觉、氛围和画幅。页面自己的说法是,每条片子由你回看并逐步调整,这正好就是上面那段返修描述的用处。手上已经有静帧的时候用它:产品照、人像、已确认的视觉稿。
- Photo to Video AI Free ——同一件事的照片专用版本,附一次免费试用;该页目前写的是注册送 60 积分、每天 20 积分,下载不带水印。按这些条款规划之前,先去那页读一遍当前条款;额度会变。
发送之前有两件事值得知道。第一,本站不承诺固定的生成时间、固定的分辨率或固定的积分消耗,看到哪篇文章承诺了,就当它说的是另一个产品。第二,你带过去的那份描述,应该是第 7 段提示词里的那个可搬走的段落,不是整段对话记录。渲染器读的是那段话,它不读你的思考过程。
如果静帧还不存在,先做出来:ChatGPT 的图像生成可以给你那一帧,ChatGPT 图像提示词写法讲了光照和参考的选择,那些决定了这一帧能不能当素材用。如果你更想从一张已经信得过的静帧开始,图生视频提示词教程把运镜语言讲得更细,不出镜短视频讲的是等你攒够五条风格一致的片段之后,拿它们做什么。
几个值得回答的问题
ChatGPT 现在还有 Sora 吗?
没有了。OpenAI 的帮助中心写明,Sora 的网页版和 App 于 2026 年 4 月 26 日停运,Sora API 于 2026 年 9 月 24 日停用。已有内容可以从 sora.chatgpt.com/sunset 导出,已购买的 ChatGPT 或 Sora 积分仍然可以用于 Codex。
ChatGPT 能从照片做视频吗?
不能自己渲染。它能读这张照片、写出运动描述、把身份细节理清楚,然后由渲染器把照片和这段描述变成片段。在本站,这一步是 Image to Video。
能免费用吗?
一部分可以,但不在一个地方。对话这一半——脚本、镜头表、描述——包含在你本来就在用的 ChatGPT 套餐里。免费额度在渲染那一半,而每一份都有自己的条款:插件的免费层归厂商,渲染器的试用归那个渲染器。在依赖某个数字之前,先读一遍当前的页面。
一定要装插件吗?
不用。插件这条路把一切都留在一个对话里,素材本来就在的时候很方便。手上有一张参考图、又想把同一个镜头的几条片子放在一起比的时候,把描述拿到专门的图生视频工具里往往更合适——而且当你的套餐或地区用不了插件时,它照样能用。
老实一点的总结:对话负责写,别的东西负责渲染。写描述的时候把身份锁定和结束帧写进去,让它能搬走,然后用同样那两三个细节去判断每一条片子。就是这个顺序,把「看起来像你的产品」和「只是有点像」分开。
