提示词指南
动漫头像:七段提示词,外加一道裁切检查
头像最终以圆形显示:四角被裁掉,脸比在编辑器里看到的更小。下面这段提示词的作用就是保住照片里“像你”的部分——先固定不能改的特征,再把头部定到方形画面约六成的高度。
可选
JPG / PNG / WebP
这是 Ottermind 自己的输入框。填入提示词和发送是两个动作,不继续进入 Studio 就不会生成任何图片。
2026年11月14日 · 约 12 分钟
动漫头像是一张方图,平台会把它裁成圆的。 这一条就决定了后面大半的工作。你为四个角做的那点安排会被切掉,脸比在编辑器里看着更小,贴着边缘的东西直接就没了。做一张动漫图不难。难的是缩到 96 像素还读得出来是一张脸,大多数尝试都败在这一步。
卡住人的通常是三件事,没有一件是生成器的问题。你说不清自己要的是上百种「动漫」里的哪一种,于是每次出图都落在某个陌生画师的默认风格上。你手上有一张自己的照片,却不知道哪几处特征必须在这次转换里活下来。或者你正准备用图库里的一张画,又说不清自己到底被允许拿它做什么。这一页按这个顺序处理它们:先选路线,再写一段点明「什么不许变」的提示词,最后按别人实际看到的尺寸验收。
这篇指南是怎么做的: 2026 年 11 月 14 日,我们在美国英语的桌面浏览器里读了「anime profile picture」的搜索结果,以及排在它前面的那些页面:Dreamina 的资源页、Phot.AI 的 Anime PFP Maker,还有下面列出的图库和素材站。同一天,我们对着营销仓库的检出(origin/main,0c719e88)核对了 Ottermind 自己的 Photo to Anime Converter 和 Avatar Maker 两个页面,包括它们写明的限制。文中的角色插画是 2026 年 11 月 14 日用 GPT Image 2.5 Sunburst 按下文印出的提示词为本文生成的,那张裁切示意图是拿这些插画拼的,没有单独生成。输入框那张图是本页的真实截图。这篇文章没有向 Ottermind 提交任何生成,所以这里的任何东西都不被写成承诺的结果,也没有对价格、积分、生成时长或输出格式做任何声明。
排在前面的那些页面,答了什么
这个词的搜索结果分成三种完全不同的活,也正因为如此,一个这么常见的词,在难度上反而算低。
| 这活是 | 谁排在前面 | 它给你什么 |
|---|---|---|
| 找一个现成的 | pfps.gg、Alpha Coders、Wallpapers.com、Pinterest 图板、Adobe Stock 和 Shutterstock | 一张图,按情绪、角色或者「可爱」分好类 |
| 自己做一个 | Phot.AI、Fotor、AnimePFP、Craiyon、Dreamina 的资源页 | 一个带风格菜单的生成器 |
| 先看思路 | Reface 的创意指南 | 分类和例子,让你有东西可以反应 |
这些生成器的做法都是同四步的变体。Phot.AI 那一页(2026 年 11 月 14 日核对)写的是:上传或描述,从五个具名方向里挑一个风格,生成,然后下载、设成头像。Dreamina 的页面标题承诺三种方法——生成、照片风格化,还有一个角色构建器——描述里则把整页说成「三个简单办法,拿到一张动漫头像」。
这些说法都没错,只是它们对准的是结果还不存在的那一刻。一张图挂上主页之后还成不成立,取决于两个决定,而生成器页面一个都没讲:圆形裁切会对构图做什么,以及事后你能对这张图诚实地主张什么。这一页就写这两件事,里面的提示词可以直接粘进上面任何一个工具,包括我们自己的。
三种路线,通向同一张图
先选路线,再选风格,因为每条路断掉的地方不一样。
| 路线 | 你需要 | 你得到 | 它断在哪 |
|---|---|---|---|
| 从图库下载 | 什么都不用 | 一分钟内拿到一张成品 | 你通常说不清自己被允许拿它做什么;同一张图挂在成千上万个主页上;它没有一处是你的 |
| 把自己照片转一遍 | 一张清楚的照片、照片里其他人的许可,再加一份「必须保留」的特征清单 | 一个认得出、能指着说是谁的类型化版本 | 长相会漂;模型会替你做你没要求的决定;原图一软一乱,每次尝试都更差 |
| 按一段文字提示词生成 | 一段描述:头发、眼睛、配色、线条、构图 | 风格完全可控,也没有要保住的原始素材 | 每一样都得自己说出来,而且只有你留着那段提示词,两张图才对得上 |
如果结果必须像某个具体的人,只有第二条能拿东西来对照。如果结果要的是一种样子——一张赛博朋克人像、一格复古赛璐璐、两个账号的一对配套头像——第三条比照片转换更可控,因为这里没有「像不像」可丢。
裁切比风格更能决定成败
圆形头像取的是能塞进你那个方形的最大圆,占画面面积的 78.5%。剩下的 21.5%——四个角——在任何人看到之前就已经被丢掉了。这个圆里,一个转 45°、贴着圆边塞进去的正方形,是能保证活下来的最大面积:它的边长是画面宽度的 70.7%,所以放在中间这 70% 方块里的东西,永远都在。
几何就这么多,它能推出一条实用的规则:按圆构图,别按方构图。头在上三分之一的宽幅照片,是一张好照片、一个坏头像——裁切留下中间,扔掉的正是头顶。
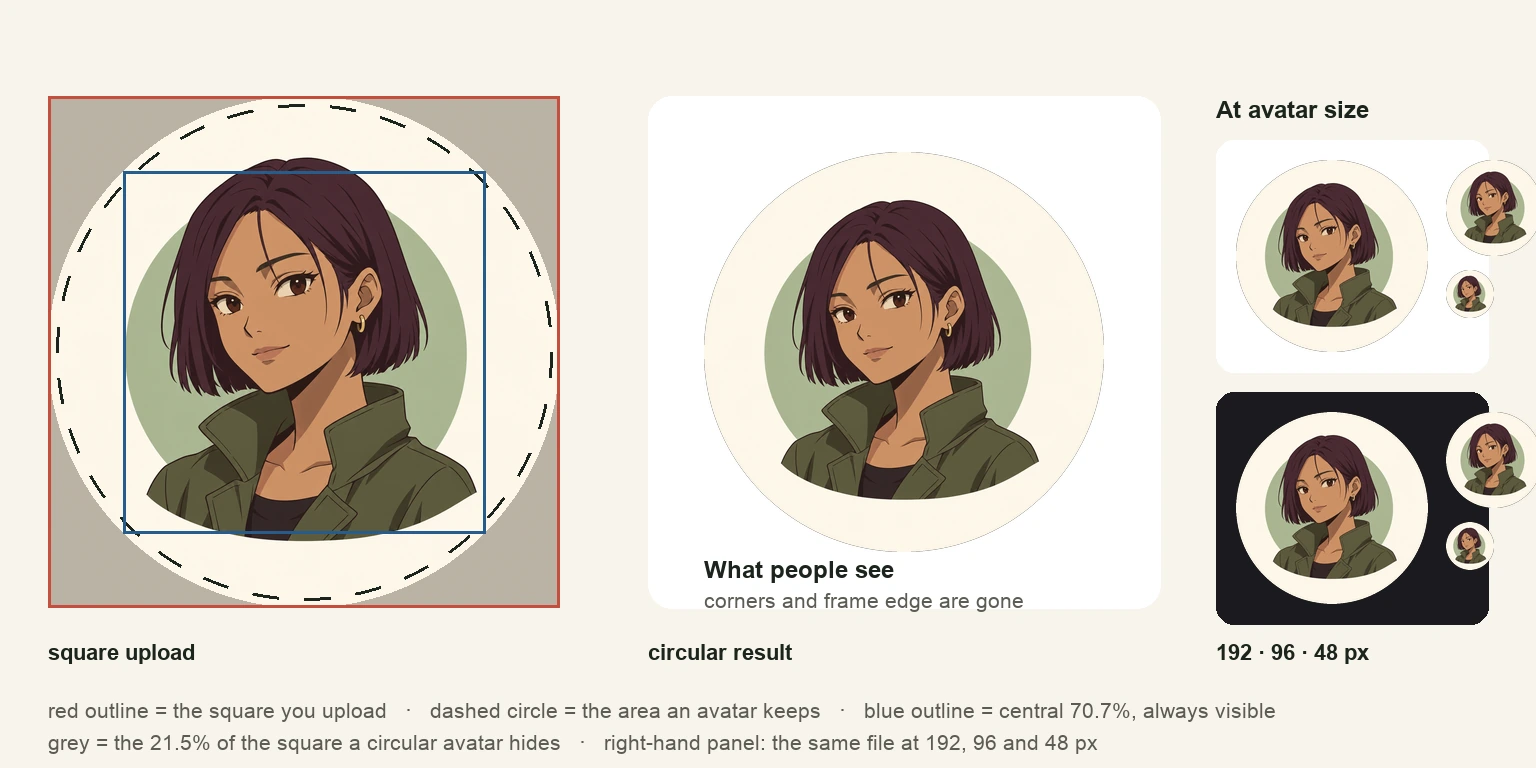
一张方图,三种读法。左:你上传的那个方形,虚线圈是头像会保留的范围,蓝方块是永远可见的那块。中:同一个文件显示出来的样子。右:同一个文件在 192、96 和 48 像素下,放在一浅一深两块底上的样子。插画为本文生成;那些叠加的框和那排尺寸是拿它拼的,不是生成的。
写提示词的时候,这五个数值得捏在手里:
- 头高占比。 从头发顶端到下巴,大约占方形高度的 55–65%。低于 45%,脸就变成了一个细节;高于 75%,头发开始碰到圆的边。
- 顶部留白。 头发上方空出 8–12% 的高度。刘海被压到贴边,小尺寸下看着就是个失误。
- 眼睛位置。 眼睛放在头部垂直中线略上方,并且让两只眼睛都落在中间那 70% 的方块里。
- 边缘反差。 要求一到两个颜色的平涂背景。渐变和花哨背景会让圆的边缘发毛,看起来像一张没剪好的贴纸。
- 线宽。 在 1024 像素的画面上,大约 15–20 像素宽的线,缩到 96 还活着;发丝级的细节和一根根睫毛不行,到了头像尺寸就变成一团灰噪点。还能留下来的,是一处焦点细节——一只耳环、一道疤、一个高光。
七段提示词,每段只管一件事
下面这些都是完整、能直接照抄的提示词,不是提纲。每段后面只跟一件事:它负责的那个变量。本文连到的两个 Ottermind 页面,给的都是一个提示词框,转换工具那边还可以再附一张可选的照片——没有风格下拉菜单,所以风格只能写在字里。
1. 锁住长相
这张图必须是你本人的时候,用这一段。它把「不许变」和「可以变」分开写清,这也是事后唯一能拿来判断一次转换的依据。
把附图的人像转成动漫插画。必须保持不变:脸型和下颌线、发际线与发尾长度、眼型与双眼皮折痕、眉毛角度、鼻子长度、嘴巴宽度、耳环和肤色。只改画法:把照片细节换成一条粗细均匀的干净描线,皮肤用两个平涂色阶加一档阴影,头发画成整块平涂加三四缕线条,不要碎发,不要渐变,不要高光塑料感,不要油画质感。保持同样的头部角度、同样的表情和同样的衣领。背景换成从衣服上取的一个平涂色。方形构图,头发到下巴的头高约占画面高度的六成,四边留白均匀,任何东西都不碰到边缘。不要文字,不要标识,不要水印。这段控制的是:哪些特征承载身份,以及你放出去多大自由。结果不对,要改的是这一段,不是风格。
2. 赛璐璐版
要缩得很小还读得出来的东西,从这一段开始最干净:一条描线、平涂、不上光。上面那张裁切图里的插画,就是按这一段生成的。
动漫风格插画,原创角色:一位年轻女性,齐下巴的深梅紫色波波头,发尾平切,额前横着一缕细发,暖调小麦色皮肤,戴一只小小的金圈耳环,穿橄榄绿外套,立领。身体略朝左,头肩构图,表情平静,带着很淡的笑意,眼睛睁开,看向观者。居中方形构图,头部约占画面高度的一半,四边留白均匀,素净的奶油色背景,肩后一个平涂的鼠尾草绿圆。当代动漫赛璐璐:一条粗细均匀、落笔肯定的深棕色描线,平涂上色,皮肤两个色阶加一档阴影,不要渐变,不要高光,不要油画质感,不要 3D 渲染味。不要文字,不要标识,不要水印,不要边框。这段控制的是:画法系统——线条、色阶数量,以及那份「不要」清单。前后几次尝试把这一段原样留着,去改别处。
3. 复古赛璐璐变体
角色和构图跟第 2 段一样,只换掉风格那一句。整段粘进去就行,没有要你填的地方。
动漫风格插画,原创角色:一位年轻女性,齐下巴的深梅紫色波波头,发尾平切,额前横着一缕细发,暖调小麦色皮肤,戴一只小小的金圈耳环,穿橄榄绿外套,立领。身体略朝左,头肩构图,表情平静,带着很淡的笑意,眼睛睁开,看向观者。居中方形构图,头部约占画面高度的一半,四边留白均匀,素净的奶油色背景,肩后一个平涂的鼠尾草绿圆。1990 年代复古电视动画赛璐璐:描线更细、有收笔的粗细变化,配色略微发灰发旧,两颊各一点暖色腮红,轻微的胶片颗粒,眼神更柔,皮肤上不要渐变,不要高光,不要现代数字的发光感。不要文字,不要标识,不要水印,不要边框。这段控制的是:时代质感和配色。下面那组对比里,中间那格就是它。
4. 原画质感变体
第三套画法:墨线加绘画式的明暗,而不是平涂。这是动画里「原画(key animation)」那一档的质感,角色和构图同样一个字不动。
动漫风格插画,原创角色:一位年轻女性,齐下巴的深梅紫色波波头,发尾平切,额前横着一缕细发,暖调小麦色皮肤,戴一只小小的金圈耳环,穿橄榄绿外套,立领。身体略朝左,头肩构图,表情平静,带着很淡的笑意,眼睛睁开,看向观者。居中方形构图,头部约占画面高度的一半,四边留白均匀,素净的奶油色背景,肩后一个平涂的鼠尾草绿圆。现代原画质感:清晰、粗细有变化的墨线,几笔肯定到位的长线,明暗用三层柔和的绘画色阶,右上方一道冷色轮廓光,头发画成一根根分明的墨线,大面积平涂里不要渐变,不要塑料感的 3D 光泽。不要文字,不要标识,不要水印,不要边框。这段控制的是:线条变化和上明暗的方式。这个版本拿去印刷、做大幅头图,比平涂赛璐璐更扛得住;但缩到头像尺寸,它掉细节也掉得最多。
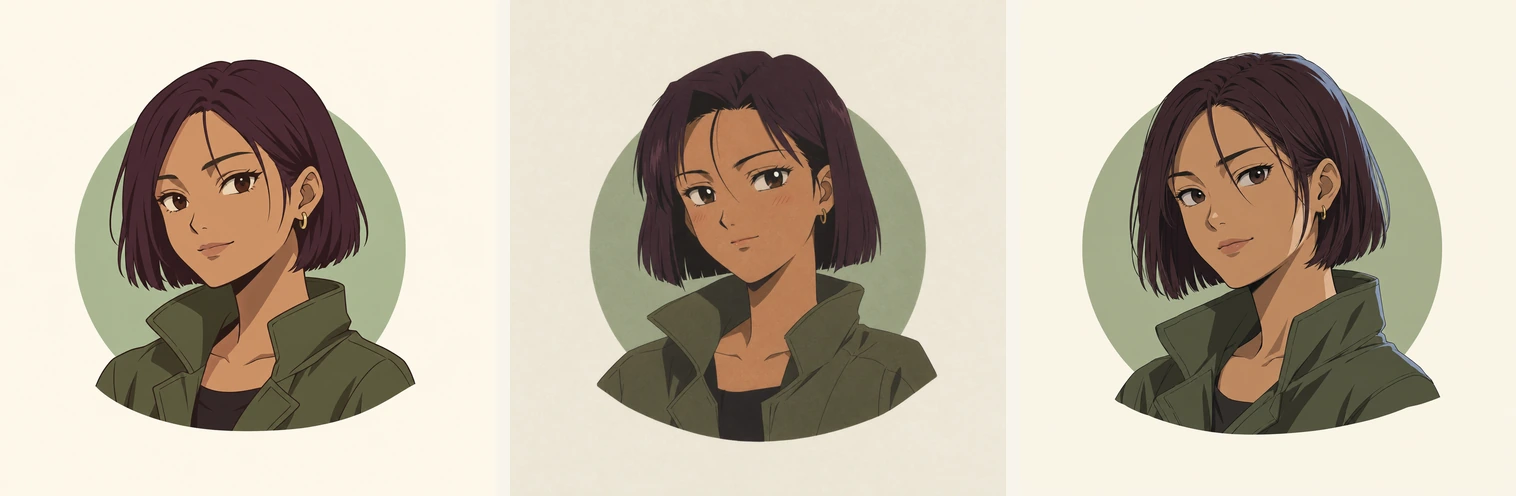
一个写出来的角色,三套画法。左:第 2 段的赛璐璐。中:第 3 段,复古变体。右:第 4 段,原画变体。三段用的是同一份角色与构图段落,只换了风格那一句——所以姿势和配色守住了,动的是线和明暗。为本文生成,不是产品截图。
5. 圆形安全构图修正
一张你满意的图没过圆形这关时,跑这一段。它只改构图,角色留得住。
把同一个角色重新构成方形头像。头发顶端到下巴的高度占画面高度的六成,头发顶端落在上边缘下方 10% 的位置。脸对准垂直中轴,眼睛在头部中线略上方。肩膀只从下方两角进入画面,不要手,不要道具,不要有手臂横过画面。背景:肩后一个平涂色,其余部分第二个平涂色,两者之间一条干净的边。任何边缘 15% 以内都不放重要的东西。保留现有的线条风格、配色和发型,不要改。不要文字,不要标识,不要水印。这段控制的是:头高占比、留白和背景复杂度——一张好图是变成好头像还是坏头像,就靠这三个变量。
6. 小尺寸表情修正
脸丢掉表情,比丢掉形状要早得多。这一段只改那些在 96 像素下还读得出来的东西。
同一个角色,同样的构图,同样的风格。只改表情:眉毛内侧微微抬起,眼睛完全睁开,每只虹膜两侧都留出清楚的白色,每只虹膜左上方一个小高光,嘴巴闭上,嘴角持平,不要下垂。头部角度、头发、配色和背景都保持不变。睫毛简化成每只眼睛三笔短线,去掉虹膜里所有的细线。不要文字,不要标识。这段控制的是:眉毛、眼睛张开的程度和嘴型——小尺寸下承载情绪的三个特征——顺带管了眼睛里那点细节预算。
7. 成套的一对
两个账号,一种样子。诀窍不在把提示词写得更好,而在于把风格段和构图段一字不改地留着,只换画面里的人。
动漫风格插画,第二个原创角色,按一张已有的人像配套做出来。风格相同:当代动漫赛璐璐,一条粗细均匀、落笔肯定的深棕色描线,平涂上色,皮肤两个色阶加一档阴影,不要渐变,不要高光,不要油画质感。构图相同:居中方形构图,头发到下巴的头高约占画面高度的六成,头发顶端在上边缘下方 10%,眼睛在头部中线略上方,四边留白均匀,素净的奶油色背景,肩后一个平涂的鼠尾草绿圆,任何边缘 15% 以内都不放重要的东西。角色:一位年轻男性,两侧推短的深色短发,方框眼镜,炭灰色高领毛衣,身体略朝右,表情平静,露出一只耳环。不要文字,不要标识,不要水印,不要边框。这段控制的是:两次独立生成之间的一致性。一对没配上,原因几乎总是风格那段被重写了一遍,而不是被抄了过去。
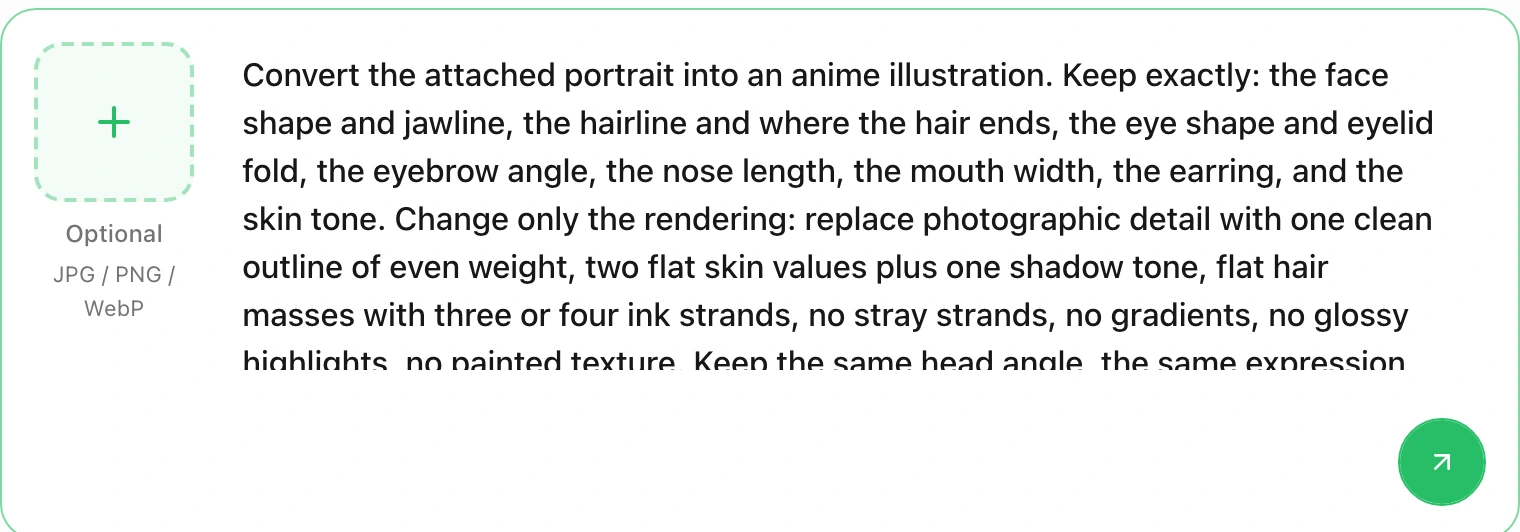
按下上面那个按钮之后,本页输入框里就是这段保真提示词。框会随文字长高,长到上限就开始滚动,所以最后一行是切断的;可选附件在左边,填入不等于发送。本页截图,摄于 2026 年 11 月 14 日——这是请求的准备,不是生成出来的结果。
从一张照片,到发出去的头像
- 先打开平台自己的上传页。 接受的格式、它做的裁切、图片出现在哪、以多大尺寸出现,各家都不一样,唯一算数的是那个实时上传页。旧教程里的截图经常已经过期。
- 挑转换用的源图。 一个人,脸大致朝着镜头,光均匀,没有东西挡着眼睛或嘴,头部周围留够空间。一张裁过的合影,或者一道很重的滤镜,损失掉的长相不是任何提示词能补回来的。
- 写好锁长相那一段,然后用同一份提示词出三到五个版本。 同一份提示词的五个变体叫对比。五份不同的提示词是抽奖,出了差别你也不知道是哪句造成的。
- 先按原尺寸判,再按 96 像素判。 原尺寸回答「人和风格对不对」;96 像素回答「它在一串评论里还读得出来是张脸吗」。两道都得查,而且它们失败的方式不一样。
- 每次只改一个变量。 先眼睛,再构图,然后背景。一次改两处,你就复现不出自己喜欢的那一版。
- 重构图,别裁。 圆里脸太小,就要一个头更大的新构图。拿宽图裁一裁去迁就圆形,既浪费分辨率,通常还把头顶切了。
- 设上去,然后在原位看一遍,浅色和深色界面各看一次。在编辑器里显得安静的奶油色背景,碰上浅色主题可能就没了。
- 把提示词留着。 连同工具名和日期一起粘进一条笔记。这是让下一张对得上的唯一可靠办法。
会错在哪,怎么修
| 你看到的 | 为什么会这样 | 怎么修 |
|---|---|---|
| 圆里那张脸很小 | 构图是按信息流做的,不是按头像做的 | 跑第 5 段的构图修正;不要靠裁 |
| 头发融进背景里 | 两个明暗值太接近,或者头后面是渐变 | 要一个平涂背景色,让它跟头发在明度上拉开,而不是在色相上 |
| 小尺寸下眼睛看着是空的 | 虹膜里没有细节,或者细节太多 | 用第 6 段:清楚的虹膜、一个高光、三笔睫毛 |
| 看着像一张通用的 AI 动漫脸 | 提示词里没有点名任何一处能区分人的特征 | 加一处具体特征——一道疤、一颗缺牙、一只耳环、一撮不对称的刘海——再把配色点出来 |
| 看着像某个已有的角色 | 提示词里出现了作品、公司或画师的名字,或者用了模型默认值 | 描述特征,不要点作品名;永远不要要求一个授权角色 |
| 第二版跟第一版完全不像 | 一次改了好几句 | 把风格段和构图段冻住,只动一个从句 |
| 皮肤像塑料 | 动漫提示词里写了「高细节」「8K」「照片级皮肤」 | 要求两个平涂色阶加一档阴影,不要高光 |
| 缩小之后描线没了 | 线宽低于画面短边约 1.5% | 在文字里把线宽写大;按 96 像素复查 |
| 复现不出来 | 提示词根本没存过 | 把那段提示词、工具和日期跟文件放在一起 |
权利、肖像,以及两种不要下的结论
这一段是生成器页面全都跳过的,而它比任何风格技巧都更要紧。
图库下载不等于可以随便用。 下载按钮不是授权书。壁纸站和头像站把原创、同人搬运和转载混在一起,其中不少并不持有它正在分发的那份权利。账号是个人号,实际风险不大;可这个头像一旦挨着生意、产品或者付费推广,同一张图就变成一件来源说不清的商业素材。先读站点条款;答案不清楚,就把这张图当参考,别当素材库。
画一个已知角色,是演绎作品。 给自己做一张,常见,也很少有人追究;这不等于你有授权,也不会因为是生成器画出来的就变成有授权。如果你需要一个能商用的动漫长相,就要求一个原创角色——上面几段提示词都是这么写的——或者用你委托创作、并且有书面约定的画。
你自己的照片,也得有别人的同意。 如果你转换的照片里有别人,或者拿别人的照片给人做个礼物,你需要的是对方点头,不只是他发在 Instagram 上的那张图。
两种不要下的结论。 第一是归属:各家工具的条款对「你在输出里拿到什么权利」写得不一样,也没有哪家能保证不存在一张相似的图。去查你实际用的那个工具的现行条款;这一页不做任何法律结论。第二是长相:一张脸的类型化版本是一种解读,不是保证。Ottermind 自己的照片转动漫工具页就直说了——结果可能仍然认得出,但不承诺精确保持身份,因为动漫化本来就会改比例、改线条、改明暗。
还有一条边界,值得说白。没有哪个生成器能替你定这几件事:某种动漫长相是不是「对的」;一个仿某家公司作品的风格,那家公司认不认;或者某个平台会不会把你的头像当成冒充。这些是关于人和平台的判断,不是关于提示词的判断。
在 Ottermind 里,这件事落在哪
Ottermind 在这件事上有两个入口,都是「提示词加参考图」的工具,各自回答这件事的一半。
- 照片转动漫工具 收一张照片和一段文字方向——线宽、明暗、配色、情绪、场景——回给你一个类型化的解读,你能拿原图对照,再改。头像必须像某个真人的时候,走这条。它自己的页面写得很清楚:认得出是大概率,但不保证。
- 照片头像生成器 围绕的正是本文花最多篇幅的那个决定:先说清这张图要去哪,再定风格和裁切,然后在小圆形裁切里按主页尺寸看一眼,再决定用不用它。
两个页面都不承诺固定的尝试次数、固定的生成时长,或者某个输出分辨率;这些取决于你的账号和当下的产品形态,在生成的地方看。从落地页进 Studio 的那条流程接受 PNG、JPEG 或 WebP 参考图,把你的提示词和附件交给 Ottermind Studio——改稿的对话在那里发生;营销页本身不生成任何东西。
如果你已经知道自己要什么样子、只差构图,上面那段构图修正就是最短的路:把第 5 段粘进任一工具,把现有的图当参考图。
延伸阅读
- Q 版(Chibi)怎么画:头身比、提示词,以及出图后怎么验 — 头像要做成矮圆的小身子而不是一张人像,那篇的头身比规则会取代这里的裁切规则。
- AI 圣诞照片 — 同一套照片转换的纪律,用在一张节日人像上,包括怎么在重度改风格里保住一张脸。
- 白底 — 想要干净的纯色背景垫在头后面,这是修掉圆形边缘发毛最快的办法。
- 海报创意 — 头像要是成套物料里的一件,那篇的六格提示词就是规划其余几件的地方。
