提示词指南
动态分镜:让分镜的时间卡在声音上
动态分镜(animatic)是配上声音、按最终长度排好时间的分镜。下方输入框里就是本页开头那条「锁死镜头」提示词——已经填好,你可以读、改,或者直接发送。
可选
JPG / PNG / WebP
这是 Ottermind 的输入框,不是剪辑时间线。提示词已经填好;发送是另一个动作,之后会进入 Studio 继续。
2026年11月16日 · 约 11 分钟
动态分镜(animatic)就是把你的分镜按成片真正会跑的长度放一遍,底下垫着声音。 分镜画面保持不动,或者只动到刚够提示镜头和动作的程度;叙事靠剪切、靠停顿、靠声音撑着。维基百科那条定义至今仍是行业在用的:一串静态图像,通常取自分镜,与粗配的台词或粗混的音轨同步播放。它不需要好看。它只需要长度对——不长不短——并且落在声音落下的地方。
这一步最常犯的错是顺序,不是品味。人们先把分镜画面做成动画——一格一段素材,每段都打扮得漂漂亮亮——然后才把这些素材丢进时间线,发现整段长了 20 秒,或者发现自己花一小时做出来的那个镜头无事可做,因为它原本要服务的那句台词被剪掉了。另一种错更隐蔽:一段生成出来动得很顺的素材,在审片会上会被读成“完成了”,于是一屋子人开始讨论这个镜头好不好看,而不是这个镜头该不该存在。动态分镜是一件量时间的工具。你为让它看起来像成片而加的每一样东西,都在让它作为量时间工具变得更差。
本文的准备方式: 文中资料均于 2026 年 11 月 16 日核对:维基百科的分镜(Storyboard)条目(Animatics 与 Photomatic 两节,包括拼贴样片,以及“分镜常常在剪辑软件里用简单的推拉摇移动起来”这条说明)、维基百科的Leica 卷条目(在配音录制完成之后拼装的故事卷),以及 StudioBinder 上 Brent Dunham 的动态分镜指南,2025 年 3 月 5 日发布(定义、分镜与动态分镜的区别,以及《阿拉丁》(Aladdin)那个走到动态分镜阶段才被砍掉的另一版结局)。关于 Ottermind 图生视频流程的描述来自 Ottermind 自己的工具页。文中的时间表、剪辑率算术和工作表,是从“怎么测量一段序列”推出来的,不是引自某个已发布的标准。本文没有在 Ottermind 里跑过任何生成,也没有把任何输出当作实测结果。封面与分镜配图是 AI 生成的插图;时间线示意图依据本文自己的数字绘制。
动态分镜是什么,以及它最容易和哪四样东西搞混
区分这些概念是有用的,因为它们各自敲定的是不同的决定;拿一个的标准去判另一个,审片就是这么走偏的。
| 文档 | 它敲定什么 | 不该拿什么标准判它 |
|---|---|---|
| 分镜 | 构图、调度和镜头顺序,一格一格地定 | 时长。没人派时长之前,它就没有时长可言 |
| 动态分镜 | 时长、剪切节奏,以及整段配上声音能不能读通 | 完成度。它本来就该看起来像临时件 |
| 动作测试 | 某一个具体动作成不成立——一个走路循环、一次搬抬、一个转身 | 整段。一条干净的动作测试照样可以待在一场时间糟糕的戏里 |
| 预演 | 机位、调度,以及一个镜头在物理上可不可行,多用于实拍或视效 | 角色表演 |
| 成片动画 | 上面全部,再加上表演、重量感和渲染出来的工艺 | 什么都不该——它就是交付物 |
有两条行业习惯值得在动手之前知道。在动画里,动态分镜通常来得足够晚,配音已经存在:Leica 卷(故事卷)——迪士尼那边对同一个东西的老叫法——是在配音演员录完之后拼起来的,用的是录好的台词加一批音效。在广告里,动态分镜是一条便宜的测试广告片;它的近亲拼贴样片(rip-o-matic),是从现成的电影、电视剧或广告里剪出来,模仿待提案那条片子的样子。两个习惯指向同一件事:动态分镜围绕的是已经存在、或者做起来便宜的声音,不是还不存在的动画。
StudioBinder 那篇指南把这步存在的理由说得很直:动画里你是一边“拍”一边“剪”,所以关于时间的决定等不到进剪辑机房那一天——实拍能等,动画不能。他们的例子是《阿拉丁》(Aladdin)的另一个结局,它是在动态分镜阶段被砍掉的,而不是等动画做完。维基百科从另一头给出同一个经济学论证:传统动画里几分钟的银幕时间就是几个月的工作量,动画做完之后再剪掉的每一场,成本都只能认赔。
这一步的全部理由就这一句。动态分镜的存在,是为了让一个值一个月画稿的决定,用一支铅笔、一条时间线和一轨临时音乐,在一个下午里做掉。
让整段能被讨论的四个数
量不出来的动态分镜,是争不出结果的。“感觉有点慢”能终结一场审片;“第四个镜头停了九秒,只扛一句台词”就能让人有东西可剪。这四个数从任何一段拼好的序列里几分钟就能拉出来,而且各说各的事。
| 数 | 怎么量 | 一段正常工作的序列长什么样 | 它解释的失败 |
|---|---|---|---|
| 镜头长度 | 时间线里每条素材的时长,以秒计 | 每个镜头的长度和扛它的东西相称——一句台词、一个动作、一个眼神 | 每个镜头一样长:这段序列是配了音的幻灯片 |
| 剪辑率 | 剪辑点数量除以时长,再乘六十 | 一个你为这个片型选过的数——讲解片和追逐戏的节拍本来就不一样 | 一个没人决定过的数:一头是乱切,一头是空场 |
| 首尾停顿 | 每个镜头头尾与相邻帧完全相同的帧数 | 两端至少留几帧静止,让剪切有地方落 | 第一帧上运动已经起来了,或者一路跑过最后一帧:接缝处会看得见地跳一下 |
| 声音锚点 | 镜头内部的声音事件——一句台词的收尾、一记关门、一次撞击——以及它们落在哪一帧 | 每个要紧的镜头至少有一个锚点,画面接得住它 | 动作落在那句它回应的台词之后,读起来就是一个迟了半拍、业余的剪切 |
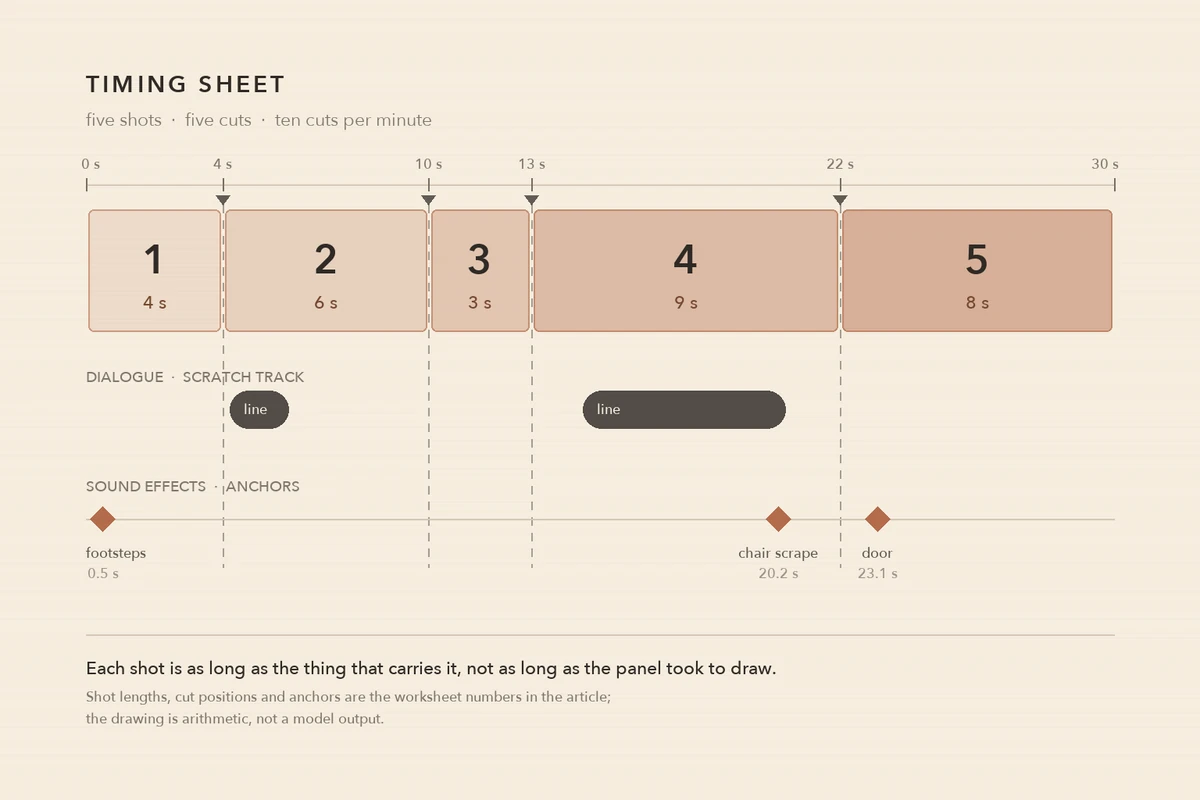
同样是下面工作表里那五个镜头、那几个剪切点和锚点,这里画一遍,让四个数有个形状。台词条标出一句话正在说出口的位置;菱形是可以落剪的锚点。依据本文自己的算术绘制,全程没有模型参与:这是一张关于决定的图,不是某一帧生成画面。
镜头长度是大家最容易跳过的那一个,因为它感觉像创作决定,而不像测量。它两样都是。在渲染任何东西之前,先给每一格派一个长度,把数字写下来,再拿你实际拼出来的东西去对。两者之间的差额,就是返工待的地方。
剪辑率是给整段做现实检查最省事的一项。一条 30 秒、5 个镜头的动态分镜,跑出来是每分钟 10 个剪辑点;一条 90 秒的产品讲解片,每分钟 20 个剪辑点,和同样长度、每分钟 8 个的那条,完全是两种东西。哪个都不算错。你没选过的那个数才错,因为它通常意味着这些画面是照着画稿原来的长度被丢进来的。
首尾停顿和声音锚点,决定整段是“能改”还是只是“能看”。如果一个镜头的首帧和末帧已经在运动,每次剪切都会跳一下,而该修的地方不在剪辑里——在镜头里。
七条提示词,每条只管一个变量
下面这些提示词是按“一格分镜画面加一段文字指令”写的,也正是 Ottermind 的图生视频流程的做法:你给的参考图提供第一状态和样子,你的文字提供运动、镜头和终点。每条提示词只改上表里的一个属性。主体随你换,结构性的那句话留着。
在它们之前还有一句:最基础的动态分镜根本不需要生成任何运动。维基百科提到,分镜常常是在剪辑软件里用简单的推拉摇移动起来的,而那至今仍是测一次剪切最便宜的办法。只有当运动本身就是你要拿到审片会上去问的那个问题时,才去生成运动。
1. 锁死的分镜画面
控制的是:镜头漂移,也就是这一格还是不是你画的那一帧。
把附上的分镜画面当作整个画面使用。镜头固定在三脚架上:不推、不摇、不变焦、没有视差、没有手持晃动。只有烟囱冒出的烟在动,缓慢向左飘。其余一切——屋顶、窗框、线条的粗细——都保持画稿原样。这个镜头停四秒,结尾回到开头的构图。把第一帧和最后一帧拿来比。如果构图挪了哪怕几个像素,就说明关于镜头的那句话输给了模型加运动的默认习惯,而你整段里每一次剪切都会跟着一起漂。
2. 声明长度
控制的是:镜头时长,也就是你要写进工作表里的那个数。
这是一条四秒的镜头,每秒 24 帧。第一秒时角色把箱子抬起来;到第三秒时箱子已经在架子上;从第三秒到第四秒,除了角色的呼吸,什么都不动。箱子放上架子之后不要再加任何动作。数一下素材的实际长度,找到动作落地的那一帧。如果模型两秒就做完了,然后一直在自行加戏,说明关于动作的那句话太含糊——说清什么停下来,什么时候停。
3. 从一格画面推进去
控制的是:强调。它让你不用画第二张,就拿到一个更近的构图。
从附上的整格画面开始。缓慢向角色的双手推进,直到双手占到画面大约三分之一,到第三秒镜头结束时停在这个构图上。画面缩放时,保持画稿的线条粗细、纸张质感和颜色不变。不要有新物体进画。检查画还是不是画。如果推进把这一格重绘成了一张照片,说明“保持线条粗细”那句话被忽略了——而正确答案是在你的剪辑软件里做一个静态推进,它不花钱,也不会漂。
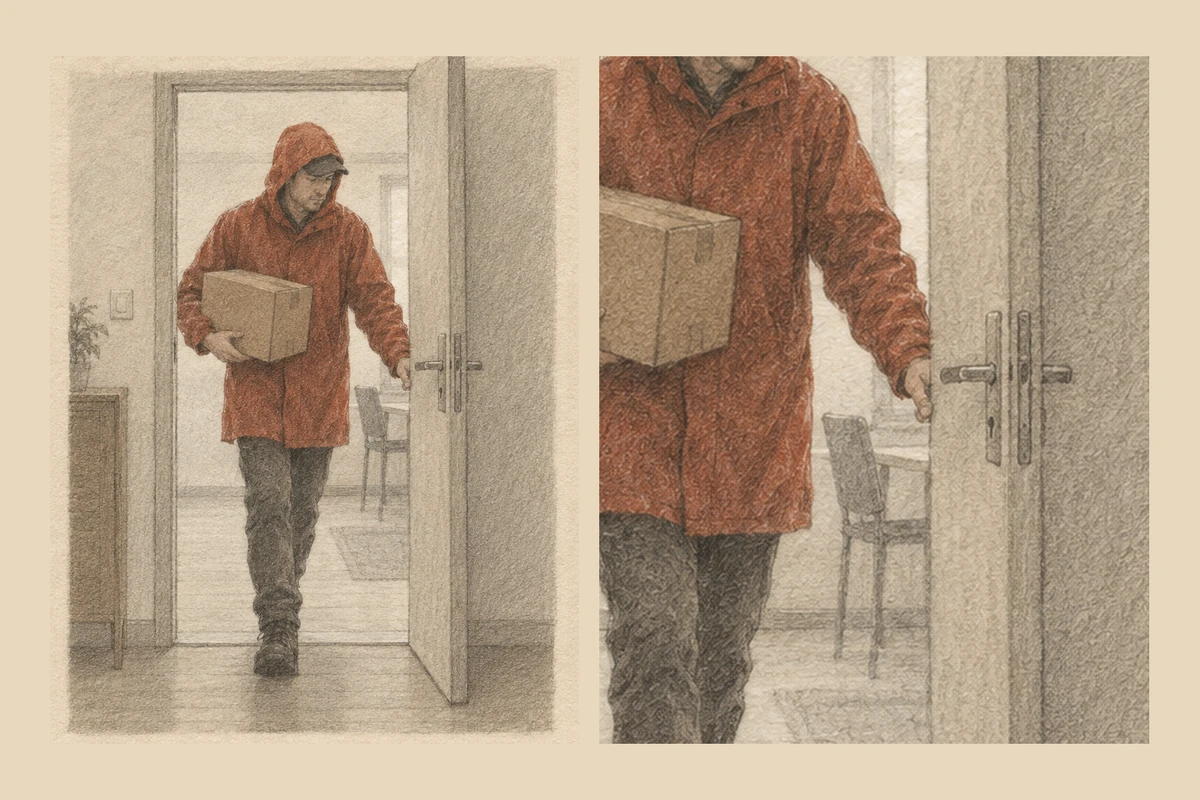
一次什么都没重画的推进:左边是画稿,右边是同一张画裁切、放大到双手和门把手上——没有第二次生成,没有新的线条粗细。这是剪辑师不用模型就能做的唯一一种镜头运动,在运动本身成为问题之前,它就该是你的默认做法。本文用图像模型生成的概念图;两个构图来自同一张图,不是两次生成。
4. 一套人物,用同一段话描述
控制的是:一整段序列里的身份漂移,也就是让动态分镜没法用的那种失败。
和参考图同一个角色:高个子快递员,铁锈红雨衣,深色长裤,左胯挂着帆布包,黑色短发,不戴帽子。每一格都保持他的脸、外套颜色和包在同一侧。同一个房间,同一束从左来的窗光,同样低饱和的色调。只有他走路的方向变。检查包在哪一侧、外套什么颜色、发际线什么样——三个很便宜的破绽。如果其中任何一样变了,问题不在描述本身,而在于描述在每条提示词之间一个词一个词地变了。把那句人物描述原样贴进这段序列的每一条提示词里。
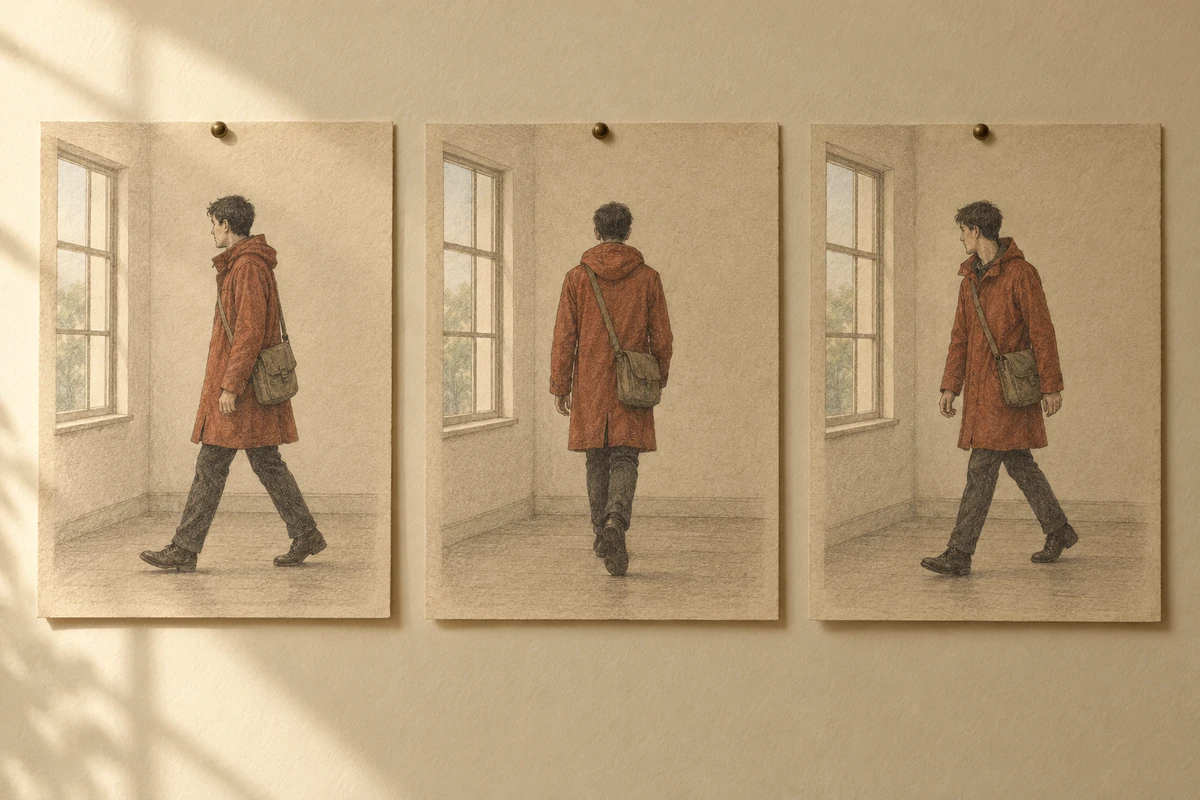
三格,一套人物,一个房间。包在哪一侧、外套什么颜色,是观众用来判断这是同一场戏还是三场戏的两个细节。本文用图像模型生成的概念图;它展示的是提示词必须自己说清的那种一致性,不是一次实测过的多镜头生成。
5. 运动预算
控制的是:形变,也就是这一格有多少内容允许模型自己重编。
只有窗外的雨和杯子里冒的热气在动。桌子、杯子、两把椅子和桌上的纸完全静止——同样的形状,同样的位置,同样的影子。不要增加或删除任何物体。不要重画他身后海报上的字。点名说不许变的东西,而不是索要一致性。一张受保护物体清单是可以逐条核对的;“保持一致”只是一个愿望。
6. 一个声音锚点
控制的是:动作落在那句台词的什么位置——把声音垫在画面底下,全部意义就在这里。
门在台词最后一个字说出口的同一刻关上。角色在镜头开头进画,走到桌前,门在第四秒末尾合上——不早,也不晚。最后半秒保持门是关着的。带着波形放一遍,把门碰到画面的那一帧标出来。如果门落在那句台词之后半拍,这个镜头就会显得迟,画得再好也一样。
7. 留出可剪的头尾
控制的是:你在剪辑上的余量,也就是下一个镜头能不能压到这个镜头上。
让镜头结束在一帧静止画面上:从角色停稳的那一刻起,最后半秒保持这个姿势不动,镜头锁死。不要淡出,不要漂移,也不要在结尾开始一个新动作。比对最后 6 帧。如果它们完全相同,你就可以把剪切叠上去、往任意一头修剪、重新排整段的时间,而不用重新渲染一遍。
那个按钮会把第一条提示词填进本页顶部的输入框。它只是填:什么都不发出去,在你到 Studio 里继续之前也不会生成任何东西。这层分离在这里比平时更要紧,因为这几条提示词里的参考图是占位的——必须进去的是你那一格。
把时间这一遍写下来
我们没有可以下载的动态分镜模板,这页也不会假装有。那些卖模板的人真正卖的是一张表;有用的部分是你在表格里填进去的那套算术。下面把同一件事写成文字,数字是加得上的。
| 镜头 | 画面 | 长度(秒) | 扛这个镜头的东西 | 入点 / 出点 | 声音锚点 |
|---|---|---|---|---|---|
| 1 | 街道全景,快递员从左入画 | 4 | 走进画面这一段 | 直切入;在他第一步走出画时剪 | 脚步声从 0.5 秒起 |
| 2 | 门口,双手特写 | 6 | 台词:“我不会收回” | 在“收回”的尾音上剪 | 台词在 5.6 秒收尾 |
| 3 | 室内,箱子放上架子 | 3 | 两人之间那一眼 | 早切,压在上一句台词上 | 静音;停住本身就是重点 |
| 4 | 双人镜头,争吵 | 9 | 争吵的转折 | 在椅子刮地声上剪 | 椅子刮地在 7.2 秒 |
| 5 | 全景,门已关上 | 8 | 余波 | 保持;淡出是另一个决定 | 门在 1.1 秒关上 |
| 合计 | 30 | 5 个剪辑点 → 每分钟 10 个 |
三条规则让这张工作表真的起作用。
长度属于扛这个镜头的东西,不属于这格画得多好。 第三个镜头是 3 秒,因为那一眼就是这一拍的全部;第四个是 9 秒,因为争吵那一场得拐弯。如果你说不出是什么在扛这个镜头,那就是发现——不是格式问题。
在声音事件上剪,不在画面节拍上剪。 动态分镜里的画面按设计就是临时的;成片真正会有的,是那条声音。把锚点写进那一行,再核对它落在哪一帧。
写下合计。 30 秒、5 个剪辑点,是一句可以被反驳的话。一堆画面不是。
AI 在这一步帮得上什么,帮不到什么
图生视频在这里确实有用,用处有三个:分镜画不出来的运动(一个需要有重量感的镜头运动,一扇必须卡着台词关上的门)、同一格画面的几种覆盖方案好让在场的人比较构图,以及给那些读不了铅笔稿的客户看的、配过一遍声画的版本。Ottermind 的图生视频流程会把参考图和运动指令带进 Studio,它的 AI 视频生成器负责的是还没有分镜画面、场景得从零描述的情况。
它停下的地方有四处,每一处都值得在审片会上说出来。
它不替你决定时间。 不管那句台词需不需要 6 秒,模型都会很乐意给你 4 秒。镜头长度是你的决定,渲染前写下来,渲染后去核对。
它给你运动的样子,不是表演出来的时间。 手绘的动态分镜能把动画师对一个表情的时间感显出来——反应之前那一停,转身时多出来的那两帧。生成出来的一条素材,是对你描述过的动作做插值。它可以是漂亮的,同时完全没有表演,因为没有人表演它。
它不是帧级精确的。 一条就是一条。把生成的素材在时间线上拉长去填一个格子,改变的是动作的速度,也就改变了表演——而表演正是你要测的那样东西。要么按长度重新生成,要么修剪,不要用变速。
它能让整段看起来足够像成片,于是审片被跳过。 这一条最贵。一条精致的素材会招来“这个挺好看”,而当时真正有用的意见是“这个镜头长了 2 秒”。先静音看一遍,再只听声音看一遍,最后声画一起看。
还有两条边界属于制片,不属于工具。拼贴样片是从现成的电影、电视剧或广告里拼的,临时音轨通常只是一段代用的音乐;两者除了在当次审片的房间里放一遍之外,都没有做过任何授权清理。而动态分镜不是成片动画,不管生成的画面多好看——成片的工艺是画、是表演、是渲染,这三样都不在这一步发生。
这页不确定的地方就说不确定:那四个数是测量上的定义,不是行业标准;至于 Ottermind 出的素材有多贴近导演的意图,除了你写下的那些指令之外,本文不作任何声称。这件事没有为本文做过基准测试。
出问题的时候,改哪句话
| 审片时你看到的 | 实际在发生什么 | 能修好它的那句话 |
|---|---|---|
| 每个镜头都差不多长 | 画面是照着画稿原来的长度丢进去的;没人派过时长 | 渲染之前,按工作表给每个镜头派长度 |
| 整段在往一边漂 | 没有锁镜头那句话,或者它被埋在主体描述后面 | 把“镜头固定在三脚架上”放最前面,再说清什么在动 |
| 角色在两格之间变了个人 | 人物描述每次都被重写了一遍 | 把同一句固定的人物描述贴进这段序列的每一条提示词里 |
| 剪切感觉迟 | 动作落在它回应的那个声音之后 | 点明锚点,以及它必须落在第几秒;把那一帧标出来 |
| 剪切在接缝处跳 | 没有首尾停顿;首帧和末帧上运动已经在跑 | 要求头尾各留静止;剪之前先比首帧和末帧 |
| 一推进,画变成了照片 | 模型重绘了这一格,而不是缩放它 | 在提示词里保住线条粗细和纸张质感,或者干脆在剪辑软件里推 |
| 一屋子人夸好看,没人剪 | 动态分镜太像成片,判不动了 | 静音看,再只听声音,最后声画一起 |
| 素材长度不对,被拉长了 | 格子是在渲染之后才定的 | 按格子长度生成,或者修剪这条素材;永远不要变速 |
从扛着那句台词的那一格开始
挑一格——就是带台词的那一格——先给它一个长度,再给它运动。把那个数写下来。然后用“锁死镜头”那条提示词,按这个长度渲染一条,垫到临时音轨底下,关掉声音看一遍,再关掉画面听一遍。如果这个镜头两遍都活下来了,说明时间在起作用,运动只是装饰。如果它只有声画一起才成立,那你对这个镜头学到了点东西——而这正是这一步的意义。
当你需要一格更干净的画面才能拿它当参考图时,先用 AI 图像生成 生成一格。如果问题具体出在两个姿势之间的运动,补间 把间距、弧线和停顿讲得比这里能塞下的更细。图生视频提示词教程 讲的是这几条提示词默认你已掌握的那套运动说法,Seedance 视频案例 则展示时间谈定之后,多镜头序列是怎么拼起来的。
如果你更想把那些重复的一遍交给机器——同一条锁死镜头的渲染,来 40 次——什么是 AI 智能体 讲的是把这种循环交给系统、而不是交给人的那类工作流。它单独成篇是有原因的:动态分镜的决定还在你手里。
值得回答的动态分镜问题
动态分镜不就是把分镜存成视频文件吗?
不是。没人派时长之前,分镜没有时长可言,而动态分镜的全部内容,就是这些时长指派。画面可以和分镜一模一样,动态分镜照样可以是错的,因为剪切节奏、停顿和声音,是分镜从来不必做的决定。
动态分镜应该多长?
和成片一样长,精确到秒。这就是这一步的意义:30 秒的档位必须由一条 30 秒的动态分镜来填,否则这个差额会在后面被发现,代价是十倍。更长的片子,一段一段地做,不要想一次把整部都攥在手里。
做之前必须先有声音吗?
你需要一个可以对时间的东西。动画里通常是录好的配音加几段音效,Leica 卷就是用这些拼起来的;广告里可以是一轨临时音乐。一条无声的动态分镜照样能测剪切,但它测不了一次剪切“落没落住”,因为“落住”说的是画面和声音之间的关系。
AI 能把我的分镜变成动态分镜吗?
它能把每一格变成一段会动的镜头,对镜头运动和环境运动来说这是一条实打实的捷径。它不会替你派时长、排剪切顺序,也不会告诉你哪一格是多余的。做好自己拼、自己排时间的准备——模型提供素材,不提供决定。
动态分镜和预演差在哪?
预演关心的是一个镜头的机位、调度和物理可行性,多用于实拍或视效,而且经常在 3D 里做。动态分镜关心的是时长和节奏,通常是画出来的。实拍项目可能两样都要;2 分钟的讲解片通常只要后一样。
拼贴样片是同一回事吗?
它是广告里的一种变体:从现成的电影、电视剧或广告里剪出来的动态分镜,用来模仿待提案那条片子的样子。时间的逻辑一样,版权状况不一样——它是提案工具,不是交付物。
